LLMs especializados vs. de uso geral para centrais de atendimento





Um LLM de uso geral é o ponto de partida mais seguro para a maioria das centrais de atendimento. Um LLM especializado conquista seu espaço quando um tipo de chamada tem alto volume e um modelo genérico continua falhando sempre da mesma forma mensurável: primeiras palavras lentas, chamadas de ferramenta erradas ou respostas que soam como uma página da web lida em voz alta. Nenhum vence por categoria. O modelo a escolher é aquele que passa nas suas próprias chamadas, execução após execução, a um custo por minuto que você consegue prever.
Este guia é para o líder responsável pela linha telefônica. A Retell AI publica este guia e tem interesse nos dois lados. Sua plataforma oferece modelos de uso geral da OpenAI, da Anthropic e do Google, e ela também desenvolve o seu próprio: o Tell-1, o LLM próprio da Retell, feito para chamadas de central de atendimento. O Tell-1 ocupa o 1º lugar geral no benchmark público da Retell, o Retell vCX Benchmark (consultado em 13 de novembro de 2026). Trate-o como qualquer benchmark de fornecedor: um motivo para entrar na sua lista de finalistas e, depois, algo a verificar nas suas próprias chamadas.
O que uma chamada de central de atendimento exige de um modelo de linguagem?
Uma chamada de central de atendimento pede cinco coisas ao modelo em cada turno: seguir um script longo, chamar ferramentas corretamente, soar natural quando falado, responder rápido e continuar acessível em grande volume.
- Scripts longos. O prompt do agente contém as etapas, as políticas e as exceções de um tipo de chamada, e o modelo precisa aplicar a regra certa em cada turno. No benchmark Multi-IF, todos os 14 modelos avaliados falharam em mais instruções a cada turno adicional.
- Chamadas de ferramenta. Agendamentos, consultas e transferências passam por ferramentas, e uma chamada errada altera um registro real. O artigo do tau-bench de 2024 constatou que agentes com chamada de função construídos sobre um dos principais modelos de uso geral tiveram sucesso em menos de 50% das tarefas de atendimento ao cliente, e passaram nas oito tentativas repetidas de uma tarefa de varejo menos de 25% das vezes.
- Fala natural. A resposta é ouvida, não lida. Listas e símbolos que funcionam na tela soam errados em uma voz sintética.
- Velocidade. As pessoas deixam intervalos curtos entre os turnos. Uma revisão de pesquisas sobre alternância de turnos estima o intervalo típico em cerca de 200 milissegundos. O modelo é uma etapa entre a última palavra de quem liga e a primeira palavra do agente, então o tempo que ele leva antes de começar a responder é percebido como silêncio.
- Custo em escala. Cada turno envia de volta ao modelo o script e toda a conversa até ali. Os provedores dão desconto nessa entrada repetida (o guia de prompt caching da OpenAI indica até 95% de desconto na entrada em cache), mas no volume de uma central de atendimento uma pequena diferença por minuto vira uma linha do orçamento.
Onde os LLMs de uso geral se encaixam em uma central de atendimento?
Os LLMs de uso geral se encaixam melhor onde as chamadas variam: muitos tipos de chamada, muitos idiomas e perguntas que ninguém previu no script. Eles são treinados de forma ampla e vendidos por vários provedores, então uma equipe pode trocar de modelo conforme suas necessidades mudam.
Eles também exigem menos trabalho personalizado do que muitos compradores imaginam. O guia de otimização de modelos da OpenAI descreve um ciclo de avaliações e engenharia de prompt, com fine-tuning adicionado "para alguns casos de uso". Boa parte do que mantém um agente no script está no prompt, no fluxo da chamada e nas ferramentas, e esse trabalho é aproveitado quando o modelo muda.
As limitações aparecem no telefone. Modos de raciocínio que pensam antes de responder aumentam o atraso até a primeira palavra. Modelos ajustados para chat escrito precisam de prompts para manter as respostas curtas e fáceis de falar. E quem define o calendário é o provedor: a política de descontinuação da OpenAI dá aviso prévio de pelo menos 6 meses antes de aposentar um modelo de disponibilidade geral, e o agente então precisa ser verificado no substituto. Para uma visão modelo a modelo, veja qual LLM deve alimentar seu agente de voz com IA.
O que muda com um LLM especializado ou com fine-tuning?
Um LLM especializado tira o comportamento do prompt e o coloca no treinamento do modelo. Em vez de instruir um modelo genérico a falar de forma breve, seguir as políticas e chamar ferramentas no momento certo, o fornecedor treina com exemplos exatamente disso, muitas vezes em um modelo menor. Três termos costumam ser confundidos:
- Um LLM de domínio específico ou vertical é treinado ou ajustado por um fornecedor para um setor ou função e oferecido a todos os seus clientes.
- Um modelo com fine-tuning é um modelo base treinado adicionalmente em um conjunto de dados mais restrito, muitas vezes o seu próprio. O verbete do glossário sobre fine-tuning de modelos de IA explica o funcionamento.
- Um LLM personalizado geralmente significa qualquer modelo que você mesmo conecta a uma plataforma, com ou sem ajuste.
O guia de precisão de LLMs da OpenAI aponta dois motivos para fazer fine-tuning: melhorar a precisão em uma tarefa específica e melhorar a eficiência, ou seja, obter a mesma precisão com menos tokens ou com um modelo menor. Nas chamadas, isso pode significar seguir o script com mais consistência, prompts mais curtos e um custo por minuto menor.
A ideia não é nova. A Observe.AI anunciou um Contact Center LLM em junho de 2023, que ela descreve como um modelo de 30 bilhões de parâmetros treinado em um conjunto de dados de domínio específico com centenas de milhões de interações com clientes. Os ganhos de precisão desse anúncio vêm dos benchmarks iniciais do próprio fornecedor. Isso é normal na categoria, e é por isso que a sua própria avaliação importa mais do que qualquer anúncio.
Quais são os trade-offs entre os dois?
Os trade-offs são aprisionamento ao fornecedor, cobertura e esforço de avaliação, e cada um deles vale nos dois sentidos.
| Fator | LLM de uso geral | LLM especializado ou com fine-tuning |
|---|---|---|
| Melhor uso | Tipos de chamada variados, muitos idiomas, perguntas fora do script | Um tipo de chamada de alto volume com regras estáveis |
| Comportamento com script e ferramentas | Definido pelo prompt e pelo fluxo da chamada | Incorporado no treinamento, então é preciso menos prompt |
| Velocidade e custo por minuto | Depende do tamanho do modelo e do modo de raciocínio | Pode ser menor quando o modelo é menor |
| Aprisionamento ao fornecedor | Vários provedores, cada um aposentando modelos no seu próprio cronograma | Muitas vezes um único fornecedor ou plataforma |
| Cobertura | Ampla | Mais restrita fora dos dados de treinamento |
| Evidências disponíveis | Benchmarks públicos, poucos deles com chamadas telefônicas | Muitas vezes o benchmark do próprio fornecedor |
| Esforço de avaliação | Uma nova verificação sempre que um modelo é aposentado | Uma verificação antes da adoção e após cada novo treinamento |
Aprisionamento ao fornecedor. Um modelo especializado muitas vezes é vendido por um único fornecedor, às vezes dentro de uma única plataforma. Pergunte se você pode trocar de modelo sem reconstruir o agente e se os prompts, fluxos e casos de teste continuam sendo seus. Os modelos de uso geral carregam uma versão mais discreta do mesmo risco quando um provedor aposenta uma versão.
Cobertura. Um modelo treinado com chamadas de agendamento em inglês pode ser mais fraco em espanhol, ou em uma contestação de cobrança que nunca viu. Peça resultados por idioma e por tipo de chamada, não uma média.
Esforço de avaliação. Benchmarks públicos raramente medem chamadas telefônicas, e um benchmark de fornecedor é uma evidência escolhida por quem vende. Se você fizer fine-tuning do seu próprio modelo, o esforço aumenta. O guia de precisão da OpenAI diz que os exemplos de treinamento "devem representar exatamente o que o modelo verá no mundo real" e recomenda um conjunto de validação separado para detectar overfitting.
Como avaliar qualquer um dos modelos nas suas próprias chamadas?
Avalie os dois da mesma forma: cenários fixos extraídos das suas próprias chamadas, avaliados com critérios de aprovação por escrito, executados mais de uma vez e, depois, uma divisão do tráfego real.
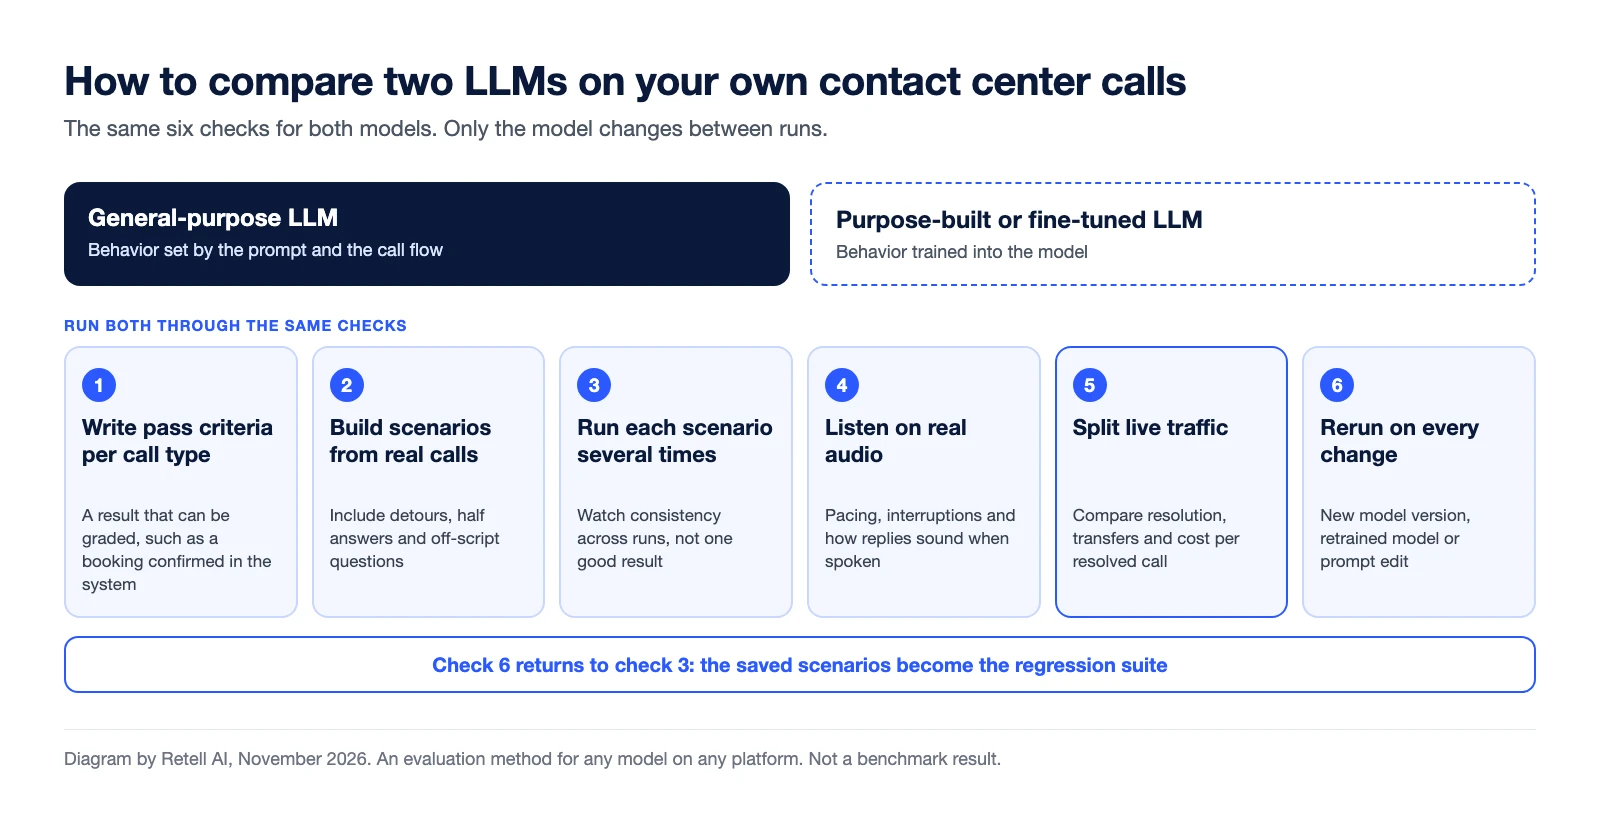
- Escreva critérios de aprovação por tipo de chamada. "Compromisso agendado no sistema de agendamento e confirmado para quem ligou" pode ser avaliado. "Pareceu bom" não pode.
- Crie cenários a partir de chamadas reais. Inclua os desvios: quem liga e muda de ideia, faz uma pergunta fora do script ou dá uma resposta pela metade.
- Execute cada cenário várias vezes em cada modelo. Os autores do tau-bench propuseram uma métrica pass^k para medir a confiabilidade em tentativas repetidas.
- Ouça em áudio real. Resultados em texto não captam o ritmo, as interrupções e como uma resposta soa quando falada.
- Divida o tráfego real. Envie uma parcela das chamadas para cada opção e compare resolução, transferências e custo por chamada resolvida.
- Execute de novo a cada mudança. Uma nova versão do modelo, um modelo retreinado e uma edição no prompt exigem a mesma suíte.
Na Retell, os testes de simulação avaliam cada execução como aprovada ou reprovada com base em critérios de sucesso, os testes em lote executam novamente os casos salvos como uma suíte de regressão, e os testes A/B dividem o tráfego de chamadas entre agentes por porcentagem. A documentação diz que você pode trocar de modelo depois sem reescrever seu prompt. Se você usar seu próprio modelo, os testes de simulação e em lote não se aplicam, e a forma de verificá-lo é com chamadas web e telefônicas. Para o piloto mais amplo, veja como avaliar uma plataforma de agentes de voz com IA antes de entrar em produção.
Onde o Tell-1 se encaixa nessa comparação?
O Tell-1, o LLM próprio da Retell, é um modelo especializado para chamadas de central de atendimento, então todos os trade-offs deste guia se aplicam a ele. Veja como ele se posiciona em cada um, com a fonte de cada número.
- Scripts, ferramentas e fala. No Retell vCX Benchmark, o Tell-1 tem média de 94,45 e ocupa o 1º lugar geral. Por suíte, ele marca 88,6% em seguimento de instruções (2º lugar), 97,2% em fundamentação (2º lugar), 95,4% em chamadas de ferramenta (5º lugar) e 96,6% em fala coloquial (1º lugar), todos consultados em 13 de novembro de 2026. É a Retell que conduz esse benchmark, então use-o como este guia sugere: como um motivo para entrar na lista de finalistas.
- Velocidade. Ele tem a menor latência mediana do ranking, de 76 ms (consultado em 13 de novembro de 2026). Esse é o número do modelo no benchmark, não o tempo de resposta de ponta a ponta de uma chamada.
- Custo. O benchmark o lista a 3,5 centavos por minuto. Esse é apenas o custo do LLM, não o preço de uma chamada, e algumas configurações de uso geral no ranking custam menos. Os preços da Retell começam a partir de $0,07 por minuto.
- Como funciona. O modelo começa a responder e continua raciocinando enquanto as primeiras palavras são reproduzidas. O artigo técnico, Retell LLM: Interleaved Reasoning for Real-Time Voice Agents, relata cerca de 200 tokens de raciocínio no meio da resposta, em média, e descreve as três etapas de treinamento por trás disso.
- Aprisionamento ao fornecedor. O Tell-1 é oferecido dentro da Retell. Ele fica no mesmo seletor de modelos que os modelos da OpenAI, da Anthropic e do Google, e a documentação da Retell diz que você pode trocar de modelo depois sem reescrever seu prompt, então escolhê-lo não fecha as portas para os outros.
- Cobertura. Um modelo feito para chamadas é mais restrito por natureza. Teste o Tell-1 nos seus próprios idiomas e tipos de chamada antes de depender dele, e mantenha um modelo de uso geral para qualquer tipo de chamada em que ele fique em segundo lugar.
- Avaliação. As seis verificações acima se aplicam sem alterações. Como o Tell-1 é um modelo gerenciado pela Retell, os testes de simulação e em lote funcionam com ele, e uma divisão A/B pode enviar o mesmo tráfego para duas cópias de um agente que diferem apenas no modelo.
O resumo justo: o Tell-1 é a opção especializada para colocar na sua lista de finalistas se você usa a Retell, e os modelos de uso geral ao lado dele são o grupo de controle. Veja o Tell-1 para os detalhes do produto.
Perguntas frequentes
O que é um LLM especializado?
Um LLM especializado é um modelo de linguagem treinado ou ajustado para uma função, como atender chamadas de central de atendimento, em vez de uso geral. Ele também é chamado de LLM de domínio específico ou vertical. Um grande modelo de linguagem de uso geral é adaptado à função por meio de prompts e ferramentas.
LLMs especializados são mais precisos do que LLMs de uso geral?
Na função para a qual foram treinados, podem ser. Fora dela, muitas vezes não. A maioria das comparações publicadas vem do fornecedor que criou o modelo, então teste os dois nos seus próprios cenários.
Uma central de atendimento precisa treinar o próprio LLM?
Normalmente, não. O guia de otimização da OpenAI começa com avaliações e engenharia de prompt e adiciona fine-tuning apenas para alguns casos de uso. Treinar o seu próprio modelo também significa ser responsável pelos dados de treinamento e por um conjunto de validação separado.
Um LLM personalizado é o mesmo que um modelo com fine-tuning?
Nem sempre. Na maioria das plataformas de voz, um LLM personalizado é qualquer modelo que você mesmo hospeda e conecta, que pode ou não ter passado por fine-tuning. A opção de LLM Personalizado da Retell conecta seu próprio modelo por WebSocket enquanto a Retell cuida da telefonia, da transcrição e da alternância de turnos.
Uma central de atendimento pode usar mais de um LLM?
Sim. Na Retell, cada agente tem sua própria configuração de modelo, e a documentação de configurações de LLM descreve um fallback rápido que executa um modelo reserva junto com o principal.
O Tell-1 é um LLM especializado?
Sim. O Tell-1 é o LLM próprio da Retell, criado para chamadas de central de atendimento. Ele ocupa o 1º lugar geral no Retell vCX Benchmark, com média de 94,45 (consultado em 13 de novembro de 2026). Ele é uma das opções no seletor de modelos da Retell, ao lado de modelos de uso geral da OpenAI, da Anthropic e do Google.
Compare modelos nas suas próprias chamadas antes de se comprometer
A Retell é uma plataforma de agentes de voz com IA para centrais de atendimento. Cada agente tem um seletor de modelos, e a página de preços lista modelos da OpenAI, da Anthropic e do Google, além de uma opção personalizada para um modelo que você hospeda. O Tell-1, o LLM próprio da Retell, está no mesmo seletor. As pessoas mais próximas dos seus clientes podem trocar o modelo, executar de novo a suíte de testes e dividir o tráfego por conta própria. Diferente de trabalhar com um fornecedor de IA gerenciada, essa mudança não vira um ticket, uma fila ou mais um SOW. Os preços são baseados no uso, a partir de $0,07 por minuto na página de preços. Traga um tipo de chamada e seus próprios critérios de aprovação, e faça um piloto com chamadas reais antes de assinar qualquer coisa.
Veja quanto seu negócio poderia economizar ao migrar para agentes de voz com IA.
Resultado do ROI
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Estimate your monthly voice AI cost
Read Other Blogs


Revolucione sua operação de chamadas com a Retell


