Benchmarks de agentes de IA explicados para agentes de voz





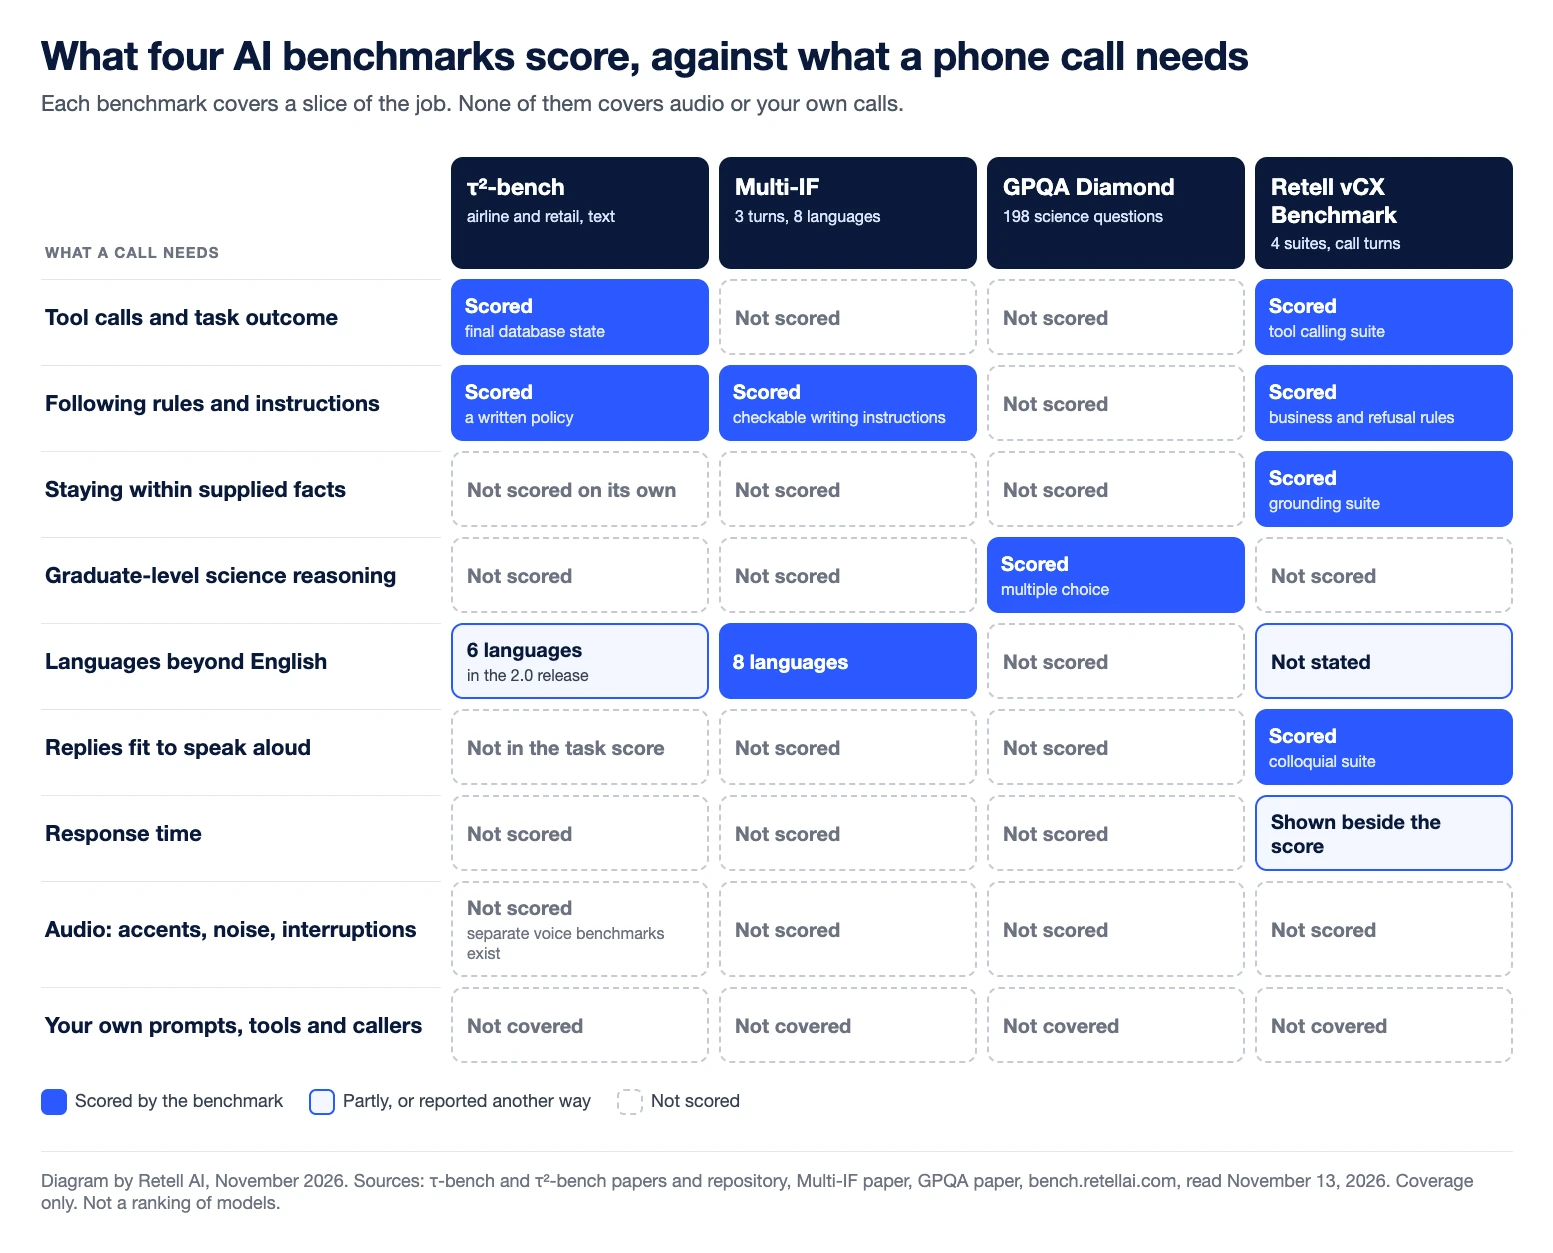
Um benchmark de agentes de IA é um conjunto fixo de tarefas com uma regra de pontuação, usado para comparar modelos no mesmo trabalho. Para agentes de voz com IA, quatro valem a pena conhecer: o τ²-bench (tau2-bench), para uso de ferramentas sob uma política; o Multi-IF, para seguir instruções ao longo dos turnos; o GPQA Diamond, para raciocínio difícil; e o Retell vCX Benchmark, para chamadas de central de atendimento. Cada um mede apenas uma fatia do que acontece em uma ligação.
Este guia explica o que cada benchmark testa, como é pontuado e o que a nota não revela. A Retell AI publica este guia e também publica um dos quatro benchmarks, o vCX Benchmark. As notas mudam a cada lançamento de modelo, por isso cada seção traz o link para a fonte com os resultados atuais.
O que é um benchmark de agentes de IA?
Um benchmark de agentes de IA dá a todos os modelos as mesmas tarefas e o mesmo avaliador e, em seguida, informa com que frequência o modelo acerta a tarefa. O significado de uma nota depende da tarefa, de quem ou do que faz o outro lado da conversa e de como se decide uma aprovação.
Os avaliadores são de três tipos. Uma verificação de estado compara o resultado das ações do agente com um resultado correto conhecido, como um banco de dados após um reembolso. Uma verificação de regra executa um script sobre a resposta. Um modelo juiz avalia a resposta com base em uma rubrica. As verificações de estado e de regra são reproduzíveis, mas limitadas. Os modelos juízes conseguem avaliar tom e significado, mas têm seus próprios pontos cegos.
O que os quatro benchmarks medem, lado a lado?
Eles cobrem habilidades diferentes, e apenas o vCX Benchmark é construído a partir de chamadas telefônicas. A tabela resume cada um com base em seu artigo, repositório ou ranking, consultados em 13 de novembro de 2026.
| Benchmark | Publicado por | Qual é a tarefa | Como é pontuado | O que fica de fora para quem compra voz |
|---|---|---|---|---|
| τ²-bench, aviação e varejo | Sierra | Atender um cliente simulado em uma conversa por texto, usando ferramentas e seguindo uma política escrita | 0 ou 1 por conversa: o banco de dados final deve corresponder ao alvo e as informações exigidas devem ser fornecidas | Áudio, tempo de resposta, sua própria política e suas ferramentas |
| Multi-IF | Meta | Seguir instruções de escrita verificáveis ao longo de três turnos, em oito idiomas | Média de quatro índices de acurácia, por instrução e por conversa, nos critérios estrito e flexível | Ferramentas, scripts longos, fala |
| GPQA Diamond | Pesquisadores da NYU, da Cohere e da Anthropic | Responder a 198 questões científicas de múltipla escolha escritas por especialistas | Percentual de questões respondidas corretamente, com 25% como acerto ao acaso | Conversa, ferramentas, instruções, velocidade |
| Retell vCX Benchmark | Retell AI | Lidar com turnos de chamadas de central de atendimento em quatro conjuntos de testes | Taxa de aprovação por conjunto, com média em uma única nota | Áudio, seus próprios tipos de chamada, resultados em uma chamada completa |
O que o τ²-bench mede nos domínios de aviação e varejo?
O τ²-bench mede se um agente consegue concluir uma tarefa de atendimento ao cliente por meio de conversa, seguindo uma política escrita e chamando as ferramentas certas. Um modelo de linguagem faz o papel do cliente, e o agente trabalha sobre um banco de dados simulado de pedidos ou reservas. O artigo original do τ-bench criou os dois domínios com 115 tarefas de varejo e 50 tarefas de aviação. O artigo do τ²-bench reutiliza versões verificadas de ambos e adiciona um domínio de telecomunicações.
A pontuação é rigorosa. Segundo as notas de avaliação no repositório, a recompensa de cada tarefa é o produto de suas verificações. Por padrão, são uma verificação de banco de dados, que compara o banco de dados final com o estado-alvo, e uma verificação de comunicação, que confirma que o agente forneceu ao cliente as informações exigidas. Qualquer sequência de chamadas de ferramentas que chegue ao estado final correto é aprovada.
Dois números relatados importam. O pass^1 é o percentual de tarefas resolvidas em uma única tentativa. O pass^k é o percentual resolvido em todas as k tentativas repetidas, uma métrica que o artigo original introduziu para captar a consistência. Esse artigo de 2024 relatou que até os principais agentes com chamada de funções da época tiveram sucesso em menos da metade das tarefas, com pass^8 abaixo de 25% no varejo.
O que ele não revela para quem compra voz: as notas em texto de aviação e varejo vêm de conversas digitadas, sem áudio, sem interrupções e sem relógio. As políticas e ferramentas são as do próprio benchmark. O cliente simulado também é um modelo, e os autores do τ²-bench mediram taxas de erro do simulador de 40% no varejo e 47% na aviação, com 12% e 13% graves o suficiente para bloquear a tarefa. O mesmo repositório agora inclui benchmarks de voz separados, e sua versão 2.0 adiciona seis idiomas e informa que suas notas não são comparáveis com o ranking 1.x. Verifique de qual versão vem uma nota citada.
O que o Multi-IF mede?
O Multi-IF mede se um modelo continua seguindo instruções à medida que a conversa avança e se isso se mantém fora do inglês. O artigo do Multi-IF, da Meta, amplia um teste anterior de turno único, o IFEval, para 4.501 conversas de três turnos cada, em oito idiomas: inglês, francês, russo, hindi, italiano, português, espanhol e chinês.
As instruções são escritas para que possam ser verificadas, como a proibição de vírgulas ou a regra de responder em letras maiúsculas. A nota principal é a média de quatro índices de acurácia. A acurácia por instrução conta cada instrução isoladamente. A acurácia por conversa conta uma conversa apenas se todas as instruções até aquele turno tiverem sido seguidas. Cada uma é relatada sob um critério estrito e um flexível.
A principal conclusão do artigo é o motivo pelo qual esse benchmark importa para agentes de voz por telefone: todos os 14 modelos testados falharam com mais frequência a cada turno adicionado. Um modelo caiu de 0,877 no primeiro turno para 0,707 no terceiro. Um agente que segue uma regra no início da chamada e a abandona algumas trocas depois falha da mesma forma.
O que ele não revela para quem compra voz: as instruções são restrições de formatação e escrita sobre texto, como tamanho, pontuação e palavras-chave. Não são regras de negócio. Não há ferramentas, três turnos é pouco perto de uma chamada real e nada é falado em voz alta.
O que o GPQA Diamond mede?
O GPQA Diamond mede se um modelo consegue responder a perguntas científicas muito difíceis que uma busca na web não resolve. O artigo do GPQA descreve 448 questões de múltipla escolha de biologia, física e química, escritas e validadas por pessoas que têm ou estão cursando doutorado. O Diamond é o subconjunto de 198 questões em que ambos os validadores especialistas acertaram e a maioria dos não especialistas errou.
A pontuação é a acurácia simples. Cada questão tem quatro opções, então o chute aleatório alcança 25%. No conjunto completo, os especialistas chegaram a 65% e não especialistas qualificados com acesso irrestrito à web chegaram a 34%.
O que ele não revela para quem compra voz: quase tudo sobre uma chamada. Não há conversa, nenhuma instrução a seguir, nenhuma ferramenta e nenhum limite de tempo. É um indicador indireto da profundidade de raciocínio. Com 198 questões, pequenas diferenças entre modelos também são evidências fracas, e os autores citam o tamanho reduzido do conjunto de dados como uma limitação.
O que o Retell vCX Benchmark mede?
O Retell vCX Benchmark mede como os modelos lidam com turnos de chamadas de central de atendimento em quatro conjuntos de testes. O ranking ao vivo, consultado em 13 de novembro de 2026, os descreve assim:
- Seguimento de instruções: se o modelo respeita restrições de papel, regras de negócio e regras de recusa.
- Fundamentação: se as respostas se mantêm dentro do prompt, das ferramentas e do contexto recuperado.
- Chamada de ferramentas: se o modelo seleciona a ação certa e passa argumentos válidos.
- Coloquial: se as respostas soam naturais, concisas e seguras para serem faladas em voz alta.
Cada conjunto informa uma taxa de aprovação sobre aproximadamente 1.000 casos ou mais, e a nota geral é a média dos quatro. Nessa data, o ranking listava 62 entradas de 45 modelos e mostrava a latência mediana e o custo por minuto ao lado de cada nota.
A nota metodológica publicada é o post sobre o vCX-Hard, que cobre os dois primeiros conjuntos de testes, fundamentação e chamada de ferramentas. Os casos foram extraídos de chamadas em produção, com amostragem entre organizações para que nenhum cliente individual predomine. Um painel de modelos juízes pontua cada caso com base em uma rubrica e em uma solução de referência. Esse post trata a classificação, mais do que o número exato, como o sinal relevante.
O que ele não revela para quem compra voz: é um benchmark de fornecedor, e o fornecedor tem uma entrada. O Tell-1, modelo próprio da Retell, ocupa o 1º lugar geral no Retell vCX Benchmark (em novembro de 2026). Os casos vêm do tráfego da Retell, então seus tipos de chamada podem estar pouco representados ou ausentes. Os quatro conjuntos pontuam respostas e chamadas de ferramentas, portanto erros de reconhecimento de fala, interrupções e se uma chamada inteira termina resolvida ficam de fora. Modelos juízes também podem errar.
Qual é a nota do Tell-1 nesses quatro benchmarks?
O Tell-1, LLM próprio da Retell, é um exemplo prático de leitura conjunta dos quatro. A Retell informa as notas de benchmarks públicos abaixo em seu post técnico sobre o Retell LLM, e os números do vCX vêm do ranking ao vivo, consultado em 13 de novembro de 2026.
| Benchmark | Nota do Tell-1 | Tamanho da execução | Quem executou |
|---|---|---|---|
| τ²-bench aviação | 72,0 | 50 tarefas | Retell |
| τ²-bench varejo | 78,0 | 50 tarefas | Retell |
| Multi-IF | 82,1 | 504 conversas | Retell |
| GPQA Diamond | 83,5 | 198 questões × 3 | Retell |
| Retell vCX Benchmark | Média de 94,45, 1º lugar geral entre 62 configurações de modelo | Quatro conjuntos, cerca de 1.000 casos cada | Retell |
Leia esses números como as seções acima sugerem. Cada linha é uma execução da própria Retell, pontuada de 0 a 100 com a mesma decodificação gulosa (greedy) em todas as vezes, e a Retell afirma que nenhum dos benchmarks foi usado no treinamento. A execução do Multi-IF cobre 504 das 4.501 conversas do benchmark e as execuções do τ²-bench cobrem 50 tarefas por domínio, portanto não são diretamente comparáveis com os números dos artigos originais ou de outros rankings.
No vCX, as notas por conjunto variam: 96,6% em coloquial (1º lugar), 97,2% em fundamentação (2º lugar), 88,6% em seguimento de instruções (2º lugar) e 95,4% em chamada de ferramentas (5º lugar). Outros modelos lideram três dos quatro conjuntos. A mesma cautela vale aqui como para qualquer modelo: esses números garantem ao Tell-1 um lugar na lista de finalistas, e um teste com suas próprias chamadas decide o resto.
O que as notas de benchmark deixam de fora para quem compra um agente de voz com IA?
As notas de benchmark deixam de fora a plataforma em torno do modelo e as condições das suas próprias chamadas. Uma ligação adiciona reconhecimento de fala, alternância de turnos, síntese de voz, telefonia e latência em cada etapa. Nenhum dos quatro benchmarks, na forma descrita aqui, pontua esses aspectos.
Os resultados podem variar conforme a plataforma, mesmo quando o agente é idêntico. Em um estudo da Cekura, fornecedora de testes, um mesmo agente foi implantado sem alterações em seis plataformas de voz, e as notas dos fluxos de trabalho variaram de 65,2% a 95,7%. O resumo da Retell sobre esse estudo do Medicare aborda o método e a divulgação de conflito de interesse que se aplica a ele.
Como quem compra deve usar as notas de benchmark?
Use as notas de benchmark para montar uma lista de finalistas e decida com base nas suas próprias chamadas. Uma ordem sensata:
- Associe o benchmark ao risco: resultados de uso de ferramentas se uma ação errada for a falha mais cara, seguimento de instruções se o agente precisar manter um script longo.
- Verifique a versão, a data e quem executou o teste.
- Prefira números de tentativas repetidas, como o pass^k, quando forem informados.
- Recrie o teste com seus próprios cenários e considere um cenário aprovado somente quando todas as execuções repetidas forem aprovadas.
Na Retell, os testes de simulação permitem que uma IA faça o papel de quem liga enquanto critérios de sucesso classificam cada execução como aprovada ou reprovada, e os testes em lote reexecutam casos salvos após cada alteração no prompt. Após o lançamento, o QA com IA pontua uma amostra de chamadas reais em métricas como alucinação e uso de ferramentas, e o teste A/B divide o tráfego real entre dois agentes. Para a escolha do modelo, veja qual LLM deve alimentar seu agente de voz com IA. Para o processo de compra, veja como avaliar uma plataforma de agentes de voz com IA.
Um benchmark mostra quais modelos merecem um teste. Um piloto com chamadas reais mostra qual deles colocar em produção. A Retell é uma plataforma de agentes de voz com IA para centrais de atendimento, com preços a partir de $0,07 por minuto, para que você possa comprovar o resultado nas suas próprias chamadas antes de assinar qualquer coisa.
Perguntas frequentes
Qual é a diferença entre pass^1 e pass^k?
O pass^1 é o percentual de tarefas que um agente resolve em uma única tentativa. O pass^k é o percentual que ele resolve em todas as k tentativas repetidas da mesma tarefa. O pass^k é sempre igual ou menor que o pass^1, e a diferença mostra o quanto o agente é consistente.
O τ-bench é o mesmo que o τ²-bench?
Não. O τ-bench é o benchmark original de 2024, com domínios de aviação e varejo. O τ²-bench é a continuação de 2025 do mesmo grupo, que mantém versões verificadas desses dois domínios e adiciona um domínio de telecomunicações em que o cliente simulado também usa ferramentas.
Por que um teste científico como o GPQA Diamond é usado para comparar modelos para conversas com clientes?
O GPQA Diamond é usado como medida geral da capacidade de raciocínio. Ele não diz nada diretamente sobre conversas, ferramentas ou fala. Leia-o como uma verificação da profundidade de raciocínio e confie nos benchmarks de tarefas para o restante.
Qual benchmark importa mais para um agente de voz com IA?
Nenhum deles isoladamente. Uso de ferramentas sob uma política, seguimento de instruções ao longo dos turnos e fundamentação são os que mais se aproximam do trabalho de uma central de atendimento, então o τ²-bench, o Multi-IF e o vCX Benchmark são os mais adequados. Um teste avaliado com seus próprios cenários de chamada importa mais do que qualquer um deles.
Qual foi a nota do Tell-1 no τ²-bench, no Multi-IF e no GPQA Diamond?
A Retell informa 72,0 no τ²-bench aviação, 78,0 no τ²-bench varejo, 82,1 no Multi-IF e 83,5 no GPQA Diamond para o Tell-1, cada uma de 0 a 100. São execuções da própria Retell com 50 tarefas por domínio do τ²-bench, 504 conversas do Multi-IF e as 198 questões do GPQA Diamond.
Veja quanto seu negócio poderia economizar ao migrar para agentes de voz com IA.
Resultado do ROI
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Estimate your monthly voice AI cost
Read Other Blogs


Revolucione sua operação de chamadas com a Retell


