Specialbyggede vs. generelle LLM'er til kontaktcentre





En generel LLM er det sikreste udgangspunkt for de fleste kontaktcentre. En specialbygget LLM gør sig fortjent til sin plads, når én opkaldstype kører med høj volumen, og en generel model bliver ved med at fejle på samme målbare måde: langsomme første ord, forkerte værktøjskald eller svar, der lyder som en webside læst højt. Ingen af dem vinder i kraft af kategorien. Den model, du skal vælge, er den, der består dine egne opkald – gang på gang – til en pris pr. minut, du kan budgettere med.
Denne guide er til den leder, der står til ansvar for telefonlinjen. Retell AI udgiver guiden og har interesser på begge sider. Platformen tilbyder generelle modeller fra OpenAI, Anthropic og Google, og Retell bygger også sin egen: Tell-1, den LLM, som Retell selv har udviklet til opkald i kontaktcentre. Tell-1 ligger samlet nr. 1 på den offentlige benchmark fra Retell, Retell vCX Benchmark (aflæst 13. november 2026). Behandl den som enhver anden leverandørbenchmark: en grund til at sætte modellen på shortlisten og derefter noget, du tjekker på dine egne opkald.
Hvad kræver et opkald i et kontaktcenter af en sprogmodel?
Et opkald i et kontaktcenter kræver fem ting af modellen i hver tur: følge et langt script, kalde værktøjer korrekt, lyde naturlig, når svaret bliver talt, svare hurtigt og forblive overkommelig i pris ved høj volumen.
- Lange scripts. Agentens prompt indeholder trin, politikker og undtagelser for en opkaldstype, og modellen skal anvende den rigtige regel i hver tur. I Multi-IF-benchmarken fejlede alle 14 evaluerede modeller flere instruktioner for hver ekstra tur.
- Værktøjskald. Bookinger, opslag og viderestillinger kører gennem værktøjer, og et forkert kald ændrer en rigtig post. tau-bench-artiklen fra 2024 fandt, at agenter med funktionskald bygget på en førende generel model kun lykkedes med under 50 % af opgaverne inden for kundeservice, og at de bestod alle otte gentagne forsøg på en detailopgave mindre end 25 % af tiden.
- Naturlig tale. Svaret bliver hørt, ikke læst. Lister og symboler, der fungerer på en skærm, lyder forkert i en syntetisk stemme.
- Hastighed. Folk efterlader korte pauser mellem turene. En gennemgang af forskning i turtagning anslår den typiske pause til omkring 200 millisekunder. Modellen er ét led mellem den opkaldendes sidste ord og agentens første, så den tid, den bruger, før den begynder at svare, høres som stilhed.
- Pris ved høj volumen. Hver tur sender scriptet og samtalen indtil nu tilbage til modellen. Udbydere giver rabat på det gentagne input (OpenAIs guide til prompt caching angiver cachet input med op til 95 % rabat), men ved kontaktcentervolumen bliver en lille forskel pr. minut til en post i budgettet.
Hvor passer generelle LLM'er ind i et kontaktcenter?
Generelle LLM'er passer bedst, hvor opkaldene varierer: mange opkaldstyper, mange sprog og spørgsmål, som ingen har skrevet script til. De er trænet bredt og sælges af flere udbydere, så et team kan skifte model, efterhånden som behovene ændrer sig.
De kræver også mindre specialarbejde, end mange købere tror. OpenAIs guide til modeloptimering beskriver en løkke af evals og prompt engineering, hvor finjustering tilføjes "for nogle use cases". Meget af det, der holder en agent på scriptet, ligger i prompten, opkaldsflowet og værktøjerne, og det arbejde kan tages med, når modellen skiftes ud.
Begrænsningerne viser sig i telefonen. Ræsonnementstilstande, der tænker, før de svarer, giver forsinkelse før det første ord. Modeller, der er tunet til skriftlig chat, skal promptes for at holde svarene korte og egnede til tale. Og udbyderen bestemmer kalenderen: OpenAIs udfasningspolitik giver mindst 6 måneders varsel, før en generelt tilgængelig model trækkes tilbage, og derefter skal agenten tjekkes på erstatningen. Se hvilken LLM der bør drive din AI-stemmeagent for et overblik model for model.
Hvad ændrer en specialbygget eller finjusteret LLM?
En specialbygget LLM flytter adfærd ud af prompten og ind i modellens træning. I stedet for at instruere en generel model i at tale kort, følge politikker og kalde værktøjer på det rigtige tidspunkt træner leverandøren på eksempler på netop det – ofte på en mindre model. Tre begreber bliver ofte blandet sammen:
- En domænespecifik eller vertikal LLM er trænet eller tunet af en leverandør til én branche eller opgave og tilbydes til alle leverandørens kunder.
- En finjusteret model er en basismodel, der er trænet videre på et smallere datasæt, ofte dit eget. Ordlisteopslaget om finjustering af AI-modeller gennemgår mekanikken.
- En tilpasset LLM betyder som regel enhver model, du selv tilslutter en platform, finjusteret eller ej.
OpenAIs guide til LLM-nøjagtighed giver to grunde til at finjustere: at forbedre nøjagtigheden på en bestemt opgave og at forbedre effektiviteten, altså samme nøjagtighed med færre tokens eller fra en mindre model. I opkald kan det betyde mere stabil overholdelse af scriptet, kortere prompts og en lavere pris pr. minut.
Idéen er ikke ny. Observe.AI lancerede en Contact Center LLM i juni 2023, som virksomheden beskriver som en model med 30 milliarder parametre, trænet på et domænespecifikt datasæt med hundredvis af millioner kundeinteraktioner. Nøjagtighedsforbedringerne i lanceringen stammer fra leverandørens egne indledende benchmarks. Det er normalt for kategorien, og det er derfor, din egen evaluering betyder mere end nogen lancering.
Hvad er afvejningerne mellem de to?
Afvejningerne handler om lock-in, dækning og evalueringsbyrde, og hver af dem skærer begge veje.
| Faktor | Generel LLM | Specialbygget eller finjusteret LLM |
|---|---|---|
| Passer bedst til | Varierede opkaldstyper, mange sprog, spørgsmål uden script | Én opkaldstype med høj volumen og stabile regler |
| Adfærd med script og værktøjer | Styres af prompten og opkaldsflowet | Indtrænet, så der kræves mindre prompt |
| Hastighed og pris pr. minut | Afhænger af modelstørrelse og ræsonnementstilstand | Kan være lavere, når modellen er mindre |
| Lock-in | Flere udbydere, der hver udfaser modeller efter egen tidsplan | Ofte én leverandør eller én platform |
| Dækning | Bred | Smallere uden for træningsdataene |
| Tilgængelig dokumentation | Offentlige benchmarks, få af dem på telefonopkald | Ofte leverandørens egen benchmark |
| Evalueringsbyrde | Et nyt tjek, hver gang en model udfases | Et tjek før indførelse og efter hver gentræning |
Lock-in. En specialbygget model sælges ofte af én leverandør, nogle gange inde i én platform. Spørg, om du kan skifte model uden at genopbygge agenten, og om prompts, flows og testcases forbliver dine. Generelle modeller bærer en mere stille udgave af samme risiko, når en udbyder udfaser en version.
Dækning. En model, der er trænet på engelske opkald om aftaler, kan være svagere på spansk eller i en faktureringstvist, den aldrig har set. Bed om resultater pr. sprog og pr. opkaldstype, ikke et gennemsnit.
Evalueringsbyrde. Offentlige benchmarks måler sjældent telefonopkald, og en leverandørbenchmark er dokumentation udvalgt af sælgeren. Hvis du finjusterer din egen model, vokser byrden. OpenAIs guide til nøjagtighed siger, at træningseksempler "skal repræsentere præcis det, modellen vil se i den virkelige verden", og anbefaler et hold-out-sæt til at opdage overfitting.
Hvordan evaluerer du begge modeller på dine egne opkald?
Evaluer begge på samme måde: faste scenarier hentet fra dine egne opkald, bedømt ud fra skriftlige beståelseskriterier, kørt mere end én gang og derefter en opdeling af live-trafik.
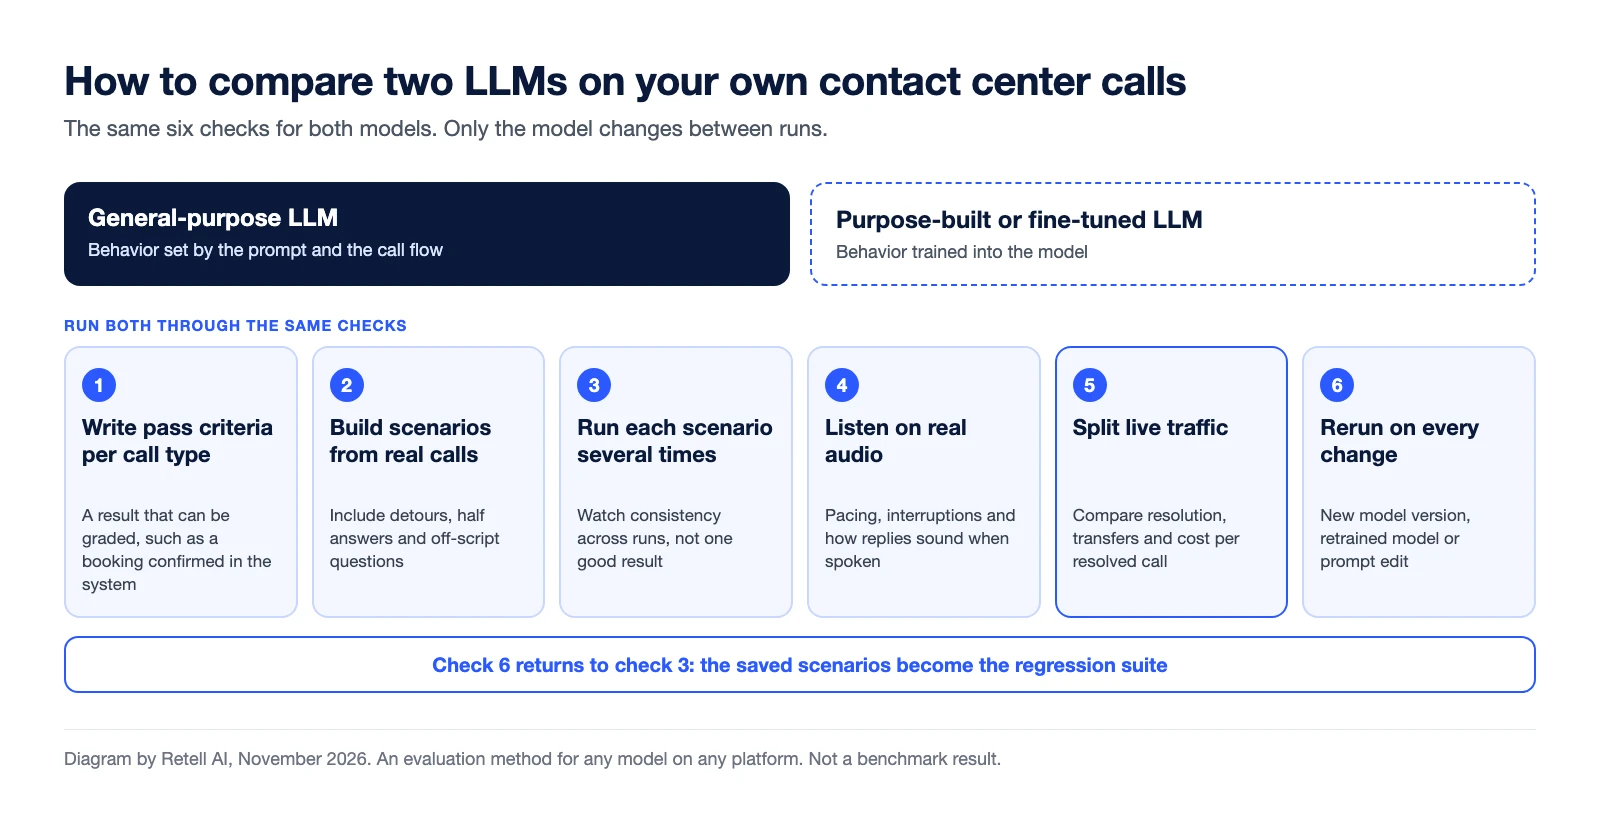
- Skriv beståelseskriterier pr. opkaldstype. "Aftalen er booket i bookingsystemet og bekræftet over for den, der ringer" kan bedømmes. "Lød godt" kan ikke.
- Byg scenarier ud fra rigtige opkald. Medtag afstikkerne: kunden, der skifter mening, stiller et spørgsmål uden for scriptet eller kun giver et halvt svar.
- Kør hvert scenarie flere gange på hver model. Forfatterne bag tau-bench foreslog en pass^k-metrik til at måle pålidelighed over gentagne forsøg.
- Lyt på rigtig lyd. Tekstresultater overser tempo, afbrydelser og hvordan et svar lyder, når det bliver talt.
- Opdel live-trafik. Send en andel af opkaldene til hver mulighed, og sammenlign løsningsgrad, viderestillinger og pris pr. løst opkald.
- Kør igen ved hver ændring. En ny modelversion, en gentrænet model og en ændring i prompten kræver alle den samme testsuite.
På Retell bedømmer simuleringstest hver kørsel som bestået eller ikke bestået ud fra succeskriterier, batchtests kører de gemte cases igen som en regressionssuite, og A/B-test fordeler opkaldstrafikken mellem agenter efter procentsats. Dokumentationen siger, at du kan skifte model senere uden at omskrive din prompt. Hvis du bruger din egen model, gælder simulering og batchtests ikke, og web- og telefonopkald er måden at tjekke den på. Se sådan evaluerer du en platform til AI-stemmeagenter, før du går live for det bredere pilotprojekt.
Hvor passer Tell-1 ind i denne sammenligning?
Tell-1, den LLM, som Retell selv har udviklet, er en specialbygget model til opkald i kontaktcentre, så alle afvejninger i denne guide gælder for den. Her kan du se, hvor den står på hver enkelt, med kilden til hvert tal.
- Scripts, værktøjer og tale. På Retell vCX Benchmark har Tell-1 et gennemsnit på 94,45 og ligger samlet nr. 1. Pr. testsuite scorer den 88,6 % på instruktionsfølgning (nr. 2), 97,2 % på grounding (nr. 2), 95,4 % på værktøjskald (nr. 5) og 96,6 % på dagligdags tale (nr. 1), alt aflæst 13. november 2026. Retell driver selv benchmarken, så brug den, som denne guide foreslår: som en grund til at sætte modellen på shortlisten.
- Hastighed. Den har den laveste medianlatens på listen, 76 ms (aflæst 13. november 2026). Det er modellens tal i benchmarken, ikke den samlede svartid i et opkald.
- Pris. Benchmarken angiver den til 3,5 cent pr. minut. Det er kun LLM-delen, ikke prisen for et opkald, og nogle generelle konfigurationer på listen koster mindre. Priserne hos Retell starter fra $0,07 pr. minut.
- Sådan virker den. Modellen begynder sit svar og bliver ved med at ræsonnere, mens de første ord afspilles. Det tekniske indlæg, Retell LLM: Interleaved Reasoning for Real-Time Voice Agents, rapporterer i gennemsnit omkring 200 ræsonnementstokens midt i svaret og beskriver de tre træningsfaser bag.
- Lock-in. Tell-1 tilbydes i Retell. Den findes i samme modelvælger som modeller fra OpenAI, Anthropic og Google, og dokumentationen fra Retell siger, at du kan skifte model senere uden at omskrive din prompt, så valget af Tell-1 lukker ikke for de andre.
- Dækning. En model bygget til opkald er smallere af design. Kør Tell-1 på dine egne sprog og opkaldstyper, før du forlader dig på den, og behold en generel model til enhver opkaldstype, hvor Tell-1 kommer ind på andenpladsen.
- Evaluering. De seks tjek ovenfor gælder uændret. Fordi Tell-1 er en model, som Retell administrerer, fungerer simulering og batchtests med den, og en A/B-opdeling kan sende den samme trafik til to kopier af en agent, der kun adskiller sig i model.
Den fair opsummering: Tell-1 er den specialbyggede mulighed, du bør sætte på din shortlist, hvis du kører på Retell, og de generelle modeller ved siden af er kontrolgruppen. Se Tell-1 for produktdetaljer.
Ofte stillede spørgsmål
Hvad er en specialbygget LLM?
En specialbygget LLM er en sprogmodel, der er trænet eller tunet til én opgave, fx at håndtere opkald i kontaktcentre, i stedet for generel brug. Den kaldes også en domænespecifik eller vertikal LLM. En generel stor sprogmodel tilpasses opgaven gennem prompts og værktøjer.
Er specialbyggede LLM'er mere nøjagtige end generelle LLM'er?
På den opgave, de er trænet til, kan de være det. Uden for den er de det ofte ikke. De fleste offentliggjorte sammenligninger kommer fra den leverandør, der har bygget modellen, så kør begge på dine egne scenarier.
Skal et kontaktcenter træne sin egen LLM?
Som regel ikke. OpenAIs optimeringsguide starter med evals og prompt engineering og tilføjer kun finjustering til nogle use cases. Træner du din egen, skal du også eje træningsdataene og et hold-out-sæt.
Er en tilpasset LLM det samme som en finjusteret model?
Ikke altid. På de fleste stemmeplatforme er en tilpasset LLM enhver model, du selv hoster og tilslutter, og den kan være finjusteret eller ej. Muligheden for tilpasset LLM hos Retell forbinder din egen model via en WebSocket, mens Retell håndterer telefoni, transskription og turtagning.
Kan et kontaktcenter bruge mere end én LLM?
Ja. På Retell har hver agent sin egen modelindstilling, og dokumentationen om LLM-indstillinger beskriver en hurtig fallback, der kører en backupmodel side om side med den primære.
Er Tell-1 en specialbygget LLM?
Ja. Tell-1 er den LLM, som Retell selv har udviklet til opkald i kontaktcentre. Den ligger samlet nr. 1 på Retell vCX Benchmark med et gennemsnit på 94,45 (aflæst 13. november 2026). Den er én mulighed i modelvælgeren hos Retell, ved siden af generelle modeller fra OpenAI, Anthropic og Google.
Sammenlign modeller på dine egne opkald, før du forpligter dig
Retell er en platform til AI-stemmeagenter i kontaktcentre. Hver agent har en modelvælger, og prissiden viser modeller fra OpenAI, Anthropic og Google sammen med en tilpasset mulighed til en model, du selv hoster. Tell-1, den LLM, som Retell selv har udviklet, findes i samme vælger. De medarbejdere, der er tættest på dine kunder, kan selv skifte model, køre testsuiten igen og opdele trafikken. I modsætning til når du arbejder med en administreret AI-leverandør, bliver den ændring ikke til en ticket, en kø eller endnu en SOW. Prisen er forbrugsbaseret, fra $0,07 pr. minut på prissiden. Tag én opkaldstype og dine egne beståelseskriterier med, og kør en pilot på rigtige opkald, før du skriver under på noget.
See how much your business could save by switching to AI-powered voice agents.
ROI Result
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Estimate your monthly voice AI cost
Read Other Blogs


Revolutionér din callcenter-drift med Retell


