AI-agent-benchmarks forklaret for AI-stemmeagenter





En AI-agent-benchmark er et fast sæt opgaver med en scoringsregel, der bruges til at sammenligne modeller på det samme arbejde. For AI-stemmeagenter er fire værd at kende: τ²-bench (tau2-bench) til værktøjsbrug under en politik, Multi-IF til at følge instruktioner over flere replikskifter, GPQA Diamond til svær ræsonnering og Retell vCX Benchmark til opkald i kontaktcentre. Hver af dem måler kun en enkelt del af det, der sker under et opkald.
Denne guide forklarer, hvad hver benchmark tester, hvordan den scores, og hvad scoren ikke fortæller dig. Retell AI udgiver denne guide og udgiver også en af de fire benchmarks, vCX Benchmark. Scorerne ændrer sig med hver ny modeludgivelse, så hvert afsnit linker til den kilde, der har de aktuelle resultater.
Hvad er en AI-agent-benchmark?
En AI-agent-benchmark giver alle modeller de samme opgaver og den samme bedømmer og rapporterer derefter, hvor ofte modellen løser opgaven korrekt. Hvad en score betyder, afhænger af opgaven, af hvem eller hvad der spiller den anden part i samtalen, og af hvordan det afgøres, om en opgave er bestået.
Der findes tre slags bedømmere. Et tilstandstjek sammenligner resultatet af agentens handlinger med et kendt korrekt resultat, fx en database efter en refusion. Et regeltjek kører et script mod svaret. En dommermodel bedømmer svaret ud fra en rubrik. Tilstands- og regeltjek kan gentages, men er snævre. Dommermodeller kan bedømme tone og betydning, men har deres egne blinde vinkler.
Hvad måler de fire benchmarks, side om side?
De dækker forskellige færdigheder, og kun vCX Benchmark er bygget på telefonopkald. Tabellen opsummerer hver af dem ud fra deres artikel, repository eller leaderboard, læst den 13. november 2026.
| Benchmark | Udgivet af | Hvad opgaven er | Hvordan den scores | Hvad den udelader for en køber af stemmeløsninger |
|---|---|---|---|---|
| τ²-bench, flyselskab og detailhandel | Sierra | Betjen en simuleret kunde i en tekstsamtale ved hjælp af værktøjer og efter en skriftlig politik | 0 eller 1 pr. samtale: den endelige database skal matche måltilstanden, og de påkrævede oplysninger skal være givet | Lyd, svartid, din egen politik og dine egne værktøjer |
| Multi-IF | Meta | Følg kontrollerbare skriveinstruktioner over tre replikskifter på otte sprog | Gennemsnit af fire nøjagtighedstal, pr. instruktion og pr. samtale, strengt og lempeligt | Værktøjer, lange scripts, mundtlig levering |
| GPQA Diamond | Forskere fra NYU, Cohere og Anthropic | Besvar 198 multiple choice-spørgsmål inden for naturvidenskab, skrevet af eksperter | Andel korrekt besvarede spørgsmål, hvor 25% svarer til tilfældigt gæt | Samtale, værktøjer, instruktioner, hastighed |
| Retell vCX Benchmark | Retell AI | Håndter replikskifter i kontaktcenteropkald på tværs af fire testsuiter | Beståelsesrate pr. suite, samlet som gennemsnit i én score | Lyd, dine egne opkaldstyper, resultater for et helt opkald |
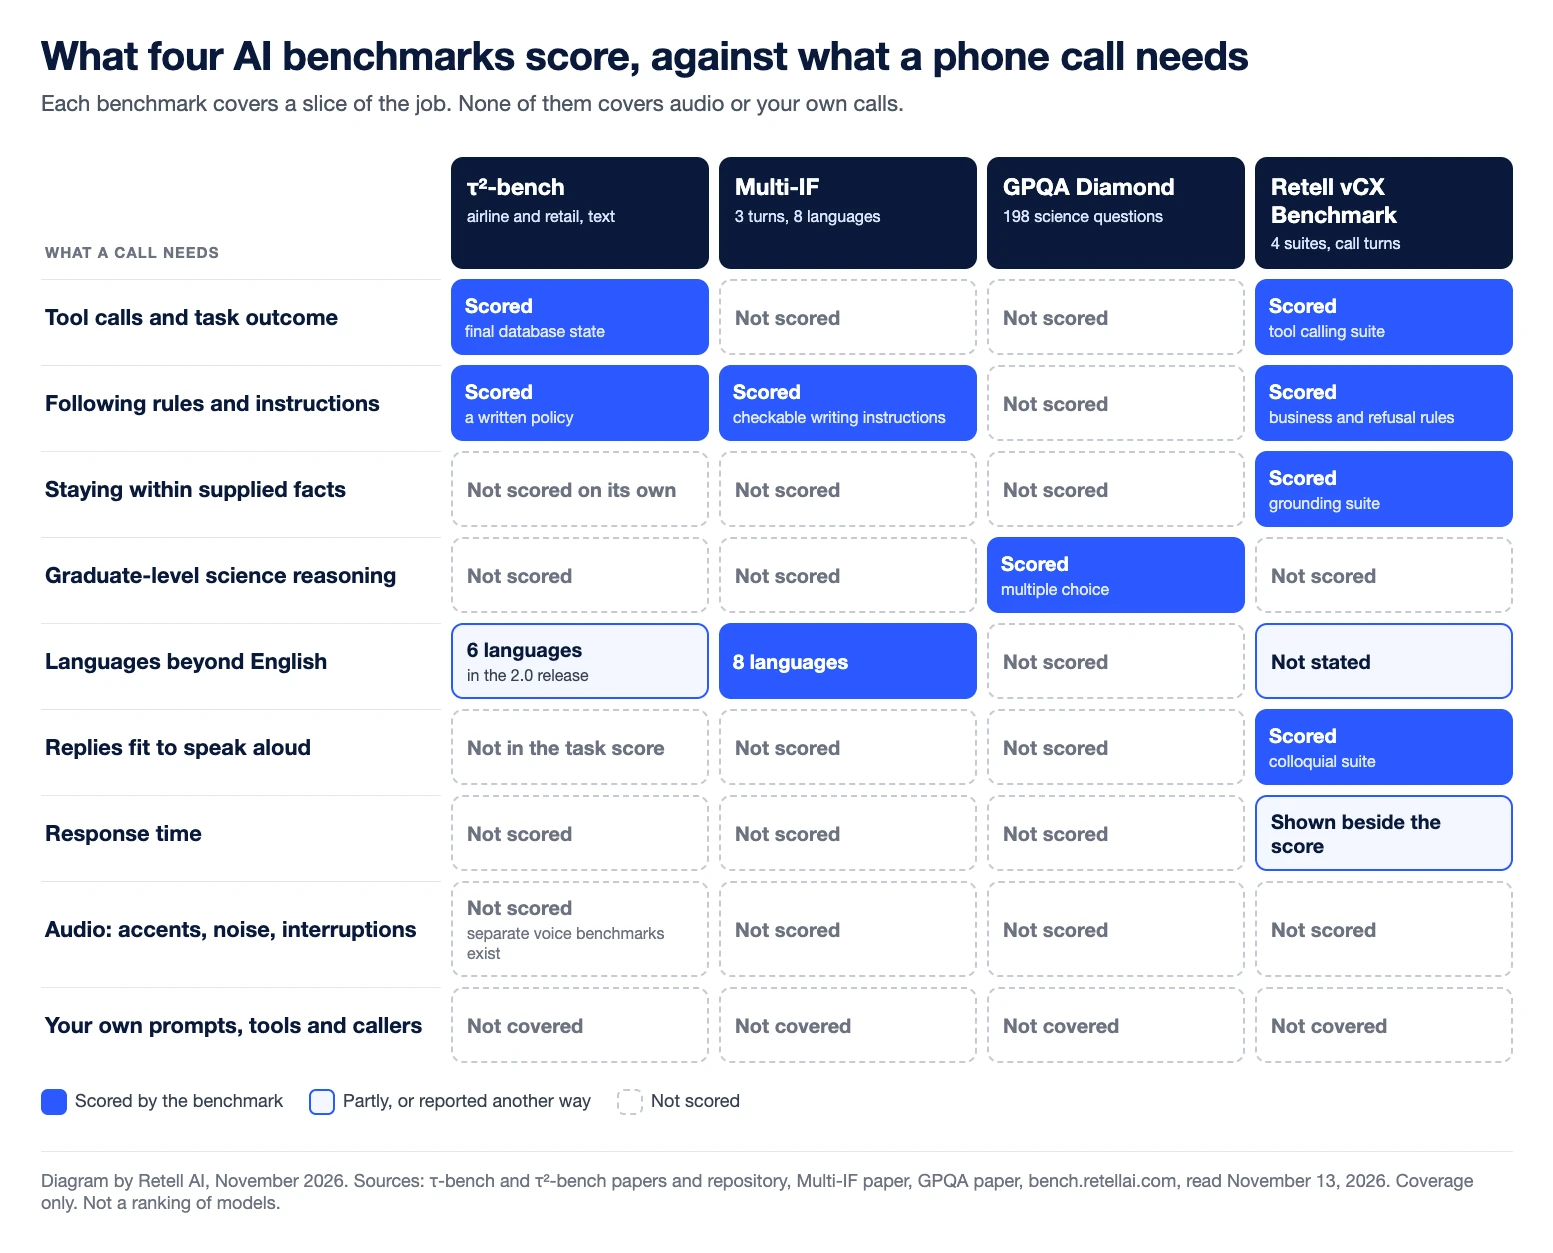
Hvad måler τ²-bench i sine domæner for flyselskab og detailhandel?
τ²-bench måler, om en agent kan gennemføre en kundeserviceopgave via samtale, mens den følger en skriftlig politik og kalder de rigtige værktøjer. En sprogmodel spiller kunden, og agenten arbejder mod en simuleret database med ordrer eller reservationer. Den oprindelige τ-bench-artikel byggede de to domæner med 115 detailopgaver og 50 flyselskabsopgaver. τ²-bench-artiklen genbruger verificerede versioner af begge og tilføjer et telekomdomæne.
Scoringen er streng. Ifølge evalueringsnoterne i repositoriet er hver opgaves belønning produktet af dens tjek. Som standard er det et databasetjek, der sammenligner den endelige database med måltilstanden, og et kommunikationstjek, der bekræfter, at agenten gav kunden de påkrævede oplysninger. Enhver sekvens af værktøjskald, der når den rigtige sluttilstand, består.
To rapporterede tal er vigtige. Pass^1 er andelen af opgaver, der løses i ét enkelt forsøg. Pass^k er andelen, der løses i alle k gentagne forsøg – en metrik, som den oprindelige artikel introducerede for at måle konsistens. Artiklen fra 2024 rapporterede, at selv datidens førende function calling-agenter lykkedes med færre end halvdelen af opgaverne, med pass^8 under 25% inden for detailhandel.
Hvad den ikke fortæller en køber af stemmeløsninger: tekstscorerne for flyselskab og detailhandel kommer fra skrevne samtaler uden lyd, uden afbrydelser og uden tidspres. Politikkerne og værktøjerne er benchmarkens egne. Den simulerede kunde er også en model, og τ²-bench-forfatterne målte fejlrater for simulatoren på 40% i detailhandel og 47% i flyselskab, hvoraf 12% og 13% var alvorlige nok til at blokere opgaven. Samme repository indeholder nu separate stemmebenchmarks, og 2.0-udgivelsen tilføjer seks sprog og oplyser, at scorerne ikke kan sammenlignes med 1.x-leaderboardet. Tjek, hvilken version en citeret score stammer fra.
Hvad måler Multi-IF?
Multi-IF måler, om en model bliver ved med at følge instruktioner, efterhånden som en samtale skrider frem, og om det også holder uden for engelsk. Multi-IF-artiklen fra Meta udvider en tidligere test med ét replikskifte, IFEval, til 4.501 samtaler med tre replikskifter hver på otte sprog: engelsk, fransk, russisk, hindi, italiensk, portugisisk, spansk og kinesisk.
Instruktionerne er skrevet, så de kan verificeres, fx et forbud mod kommaer eller en regel om at svare med store bogstaver. Hovedscoren er et gennemsnit af fire nøjagtighedstal. Nøjagtighed på instruktionsniveau tæller hver instruktion for sig. Nøjagtighed på samtaleniveau tæller kun en samtale med, hvis alle instruktioner frem til det pågældende replikskifte blev fulgt. Hver rapporteres under et strengt og et lempeligt kriterium.
Artiklens hovedfund er grunden til, at denne benchmark er vigtig for telefonagenter: hver eneste af de 14 testede modeller fejlede oftere for hvert ekstra replikskifte. En model faldt fra 0,877 i første replikskifte til 0,707 i det tredje. En agent, der følger en regel i starten af et opkald og glemmer den et par udvekslinger senere, fejler på samme måde.
Hvad den ikke fortæller en køber af stemmeløsninger: instruktionerne er formaterings- og skrivebegrænsninger på tekst, fx længde, tegnsætning og nøgleord. De er ikke forretningsregler. Der er ingen værktøjer, tre replikskifter er kort sammenlignet med et rigtigt opkald, og intet bliver sagt højt.
Hvad måler GPQA Diamond?
GPQA Diamond måler, om en model kan besvare meget svære naturvidenskabelige spørgsmål, som en websøgning ikke løser. GPQA-artiklen beskriver 448 multiple choice-spørgsmål inden for biologi, fysik og kemi, skrevet og valideret af personer, der har eller er i gang med en ph.d. Diamond er delmængden på 198 spørgsmål, hvor begge ekspertvalidatorer svarede korrekt, og de fleste ikke-eksperter ikke gjorde.
Scoringen er ren nøjagtighed. Hvert spørgsmål har fire svarmuligheder, så tilfældigt gæt giver 25%. På hele sættet nåede eksperter 65%, og dygtige ikke-eksperter med ubegrænset internetadgang nåede 34%.
Hvad den ikke fortæller en køber af stemmeløsninger: næsten alt om et opkald. Der er ingen samtale, ingen instruktion at følge, intet værktøj og ingen tidsgrænse. Den er en indikator for ræsonneringsdybde. Med 198 spørgsmål er små forskelle mellem modeller desuden svag evidens, og forfatterne nævner selv datasættets lille størrelse som en begrænsning.
Hvad måler Retell vCX Benchmark?
Retell vCX Benchmark måler, hvordan modeller håndterer replikskifter i kontaktcenteropkald på tværs af fire testsuiter. Ifølge live-leaderboardet, læst den 13. november 2026, er de:
- Instruktionsfølgning: om modellen overholder rollebegrænsninger, forretningsregler og regler for afvisning.
- Grounding: om svarene holder sig inden for prompten, værktøjerne og den hentede kontekst.
- Værktøjskald: om modellen vælger den rigtige handling og sender gyldige argumenter.
- Dagligsprog: om svarene lyder naturlige, er præcise og er sikre at sige højt.
Hver suite rapporterer en beståelsesrate over cirka 1.000 eller flere cases, og den samlede score er gennemsnittet af de fire. Leaderboardet viste 62 indgange på tværs af 45 modeller på den dato og viser median-latens og pris pr. minut ved siden af hver score.
Den publicerede metodebeskrivelse er indlægget om vCX-Hard, som dækker de to første testsæt, grounding og værktøjskald. Cases blev udvundet fra opkald i produktion og udvalgt på tværs af organisationer, så ingen enkelt kunde dominerer. Et panel af dommermodeller scorer hver case ud fra en rubrik og en referenceløsning. Indlægget betragter rangeringen, mere end det præcise tal, som signalet.
Hvad den ikke fortæller en køber af stemmeløsninger: det er en leverandørbenchmark, og leverandøren deltager selv. Tell-1, den model som Retell selv har udviklet, ligger samlet nr. 1 på Retell vCX Benchmark (pr. november 2026). Cases stammer fra trafik hos Retell, så dine opkaldstyper kan være sparsomt repræsenteret eller helt fraværende. De fire suiter scorer svar og værktøjskald, så fejl i talegenkendelse, afbrydelser og om et helt opkald ender med at være løst, ligger uden for dem. Dommermodeller kan også tage fejl.
Hvordan scorer Tell-1 på disse fire benchmarks?
Tell-1, den LLM som Retell selv har udviklet, er et konkret eksempel på, hvordan man læser de fire sammen. Retell rapporterer de offentlige benchmarkscorer nedenfor i sit tekniske indlæg om Retell LLM, og vCX-tallene kommer fra live-leaderboardet, læst den 13. november 2026.
| Benchmark | Tell-1-score | Kørslens omfang | Hvem kørte den |
|---|---|---|---|
| τ²-bench flyselskab | 72,0 | 50 opgaver | Retell |
| τ²-bench detailhandel | 78,0 | 50 opgaver | Retell |
| Multi-IF | 82,1 | 504 samtaler | Retell |
| GPQA Diamond | 83,5 | 198 spørgsmål × 3 | Retell |
| Retell vCX Benchmark | 94,45 i gennemsnit, samlet nr. 1 ud af 62 modelkonfigurationer | Fire suiter, ca. 1.000 cases hver | Retell |
Læs dem, som afsnittene ovenfor foreslår. Hver række er en kørsel udført af Retell selv, scoret ud af 100 med den samme greedy decoding hver gang, og Retell oplyser, at ingen af benchmarkene blev brugt i træningen. Multi-IF-kørslen dækker 504 af benchmarkens 4.501 samtaler, og τ²-bench-kørslerne dækker 50 opgaver pr. domæne, så de kan ikke sammenlignes direkte med tallene i de oprindelige artikler eller på andre leaderboards.
På vCX varierer suitescorerne: 96,6% på dagligsprog (nr. 1), 97,2% på grounding (nr. 2), 88,6% på instruktionsfølgning (nr. 2) og 95,4% på værktøjskald (nr. 5). Andre modeller fører i tre af de fire suiter. Det samme forbehold gælder her som for enhver model: disse tal giver Tell-1 en plads på en shortliste, og en test på dine egne opkald afgør resten.
Hvad udelader benchmarkscorer for en køber af AI-stemmeagenter?
Benchmarkscorer udelader platformen omkring modellen og forholdene i dine egne opkald. Et telefonopkald tilføjer talegenkendelse, turtagning, talesyntese, telefoni og latens i hvert led. Ingen af de fire benchmarks scorer disse i den form, der er beskrevet her.
Resultaterne kan variere fra platform til platform, selv når agenten er identisk. I en undersøgelse fra testleverandøren Cekura blev én agent implementeret uændret på seks stemmeplatforme, og workflowscorerne lå mellem 65,2% og 95,7%. Opsummeringen fra Retell af Medicare-undersøgelsen beskriver metoden og den interesseerklæring, der gælder for den.
Hvordan bør en køber bruge benchmarkscorer?
Brug benchmarkscorer til at lave en shortliste, og træf derefter beslutningen ud fra dine egne opkald. En fornuftig rækkefølge:
- Match benchmarken til risikoen: resultater for værktøjsbrug, hvis en forkert handling er den dyre fejl, og instruktionsfølgning, hvis agenten skal holde et langt script.
- Tjek versionen, datoen og hvem der kørte testen.
- Foretræk tal fra gentagne forsøg som pass^k, når de er rapporteret.
- Genskab testen med dine egne scenarier, og tæl kun et scenarie som bestået, når alle gentagne kørsler består.
Hos Retell lader simuleringstest en AI spille opkalderen, mens succeskriterier bedømmer hver kørsel som bestået eller ikke bestået, og batchtests kører gemte cases igen efter hver ændring af prompten. Efter lancering scorer AI QA et udsnit af rigtige opkald på mål som hallucinationer og værktøjsbrug, og A/B-test fordeler live-trafik mellem to agenter. Om valg af model kan du læse hvilken LLM der bør drive din AI-stemmeagent. Om købsprocessen kan du læse hvordan du evaluerer en platform til AI-stemmeagenter.
En benchmark fortæller dig, hvilke modeller der fortjener en test. En pilot på rigtige opkald fortæller dig, hvilken du skal bruge. Retell er en platform til AI-stemmeagenter for kontaktcentre med priser fra $0,07 pr. minut, så du kan afprøve den på dine egne opkald, før du skriver under på noget.
Ofte stillede spørgsmål
Hvad er forskellen på pass^1 og pass^k?
Pass^1 er andelen af opgaver, som en agent løser i ét enkelt forsøg. Pass^k er andelen, den løser i hvert eneste af k gentagne forsøg på samme opgave. Pass^k er altid lig med eller lavere end pass^1, og forskellen viser, hvor konsistent agenten er.
Er τ-bench det samme som τ²-bench?
Nej. τ-bench er den oprindelige benchmark fra 2024 med domæner for flyselskab og detailhandel. τ²-bench er opfølgeren fra 2025 fra samme gruppe, som bevarer verificerede versioner af de to domæner og tilføjer et telekomdomæne, hvor den simulerede kunde også bruger værktøjer.
Hvorfor bruges en naturvidenskabelig test som GPQA Diamond til at sammenligne modeller til kundesamtaler?
GPQA Diamond bruges som et generelt mål for ræsonneringsevne. Den siger intet direkte om samtaler, værktøjer eller tale. Læs den som et tjek af ræsonneringsdybde, og støt dig til opgavebaserede benchmarks for resten.
Hvilken benchmark er vigtigst for en AI-stemmeagent?
Ingen af dem alene. Værktøjsbrug under en politik, instruktionsfølgning over flere replikskifter og grounding ligger tættest på arbejdet i et kontaktcenter, så τ²-bench, Multi-IF og vCX Benchmark passer bedst. En bedømt test på dine egne opkaldsscenarier betyder mere end nogen af dem.
Hvordan scorede Tell-1 på τ²-bench, Multi-IF og GPQA Diamond?
Retell rapporterer 72,0 på τ²-bench flyselskab, 78,0 på τ²-bench detailhandel, 82,1 på Multi-IF og 83,5 på GPQA Diamond for Tell-1, hver ud af 100. Det er kørsler udført af Retell selv på 50 opgaver pr. τ²-bench-domæne, 504 Multi-IF-samtaler og de 198 spørgsmål i GPQA Diamond.
See how much your business could save by switching to AI-powered voice agents.
ROI Result
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Estimate your monthly voice AI cost
Read Other Blogs


Revolutionér din callcenter-drift med Retell


