GPT-Live-1: como funciona o modelo de voz full-duplex da OpenAI em chamadas telefônicas




O GPT-Live-1 é o modelo de voz full-duplex da OpenAI. Ele ouve e fala ao mesmo tempo, lida sozinho com interrupções e repassa o raciocínio e o uso de ferramentas a um modelo de backend separado. A OpenAI o lançou na API em 10 de setembro de 2026, depois da estreia no modo de voz do ChatGPT, e ele está disponível nos agentes de voz por telefone da Retell AI desde 2 de novembro de 2026. Este guia explica como ele funciona, quanto custa na API, onde se encaixa em chamadas telefônicas e como configurá-lo em um agente da Retell.
A Retell AI publica este guia e oferece o GPT-Live-1 como um dos modelos da sua plataforma de agentes de voz.
GPT-Live-1 em resumo
| GPT-Live-1 | |
|---|---|
| Desenvolvedora | OpenAI |
| ID do modelo | gpt-live-1 |
| Tipo | Modelo de voz full-duplex que delega o raciocínio e o uso de ferramentas a um modelo ou agente de backend |
| Entrada e saída | Entrada de áudio e texto, saída de áudio e texto |
| Endpoint da API | Sessões Live (v1/live/sessions), via WebRTC, WebSockets ou telefonia e SIP |
| Preço na API | $0,05 por minuto de sessão de voz, cobrado por segundo. O modelo de backend e o uso de ferramentas são cobrados à parte. |
| Concorrência | 50 sessões no nível Build, 300 no Launch e 500 no Grow. Não disponível no nível Free. |
| Janela de contexto | 128.000 tokens |
| Versão mais recente | O GPT-Live-1.1 foi lançado no ChatGPT, no Codex e no dots em 15 de outubro de 2026, com chegada à API anunciada para breve. Ainda não estava na API em 5 de novembro. |
Fontes: página do modelo GPT-Live-1, guia do Live, guia de conversas Live, changelog da API e post de lançamento da OpenAI; GPT-Live-1.1 a partir de um post no fórum de desenvolvedores da OpenAI. Consultado em 5 de novembro de 2026.
Como funciona o full duplex
A maioria dos agentes de voz alterna os turnos de uma de duas formas. Um agente em cascata transcreve o que a pessoa diz, envia o texto a um modelo de linguagem e depois converte a resposta em fala. Um modelo speech-to-speech, como o gpt-realtime-2.1 da OpenAI, faz as três etapas dentro de um único modelo.
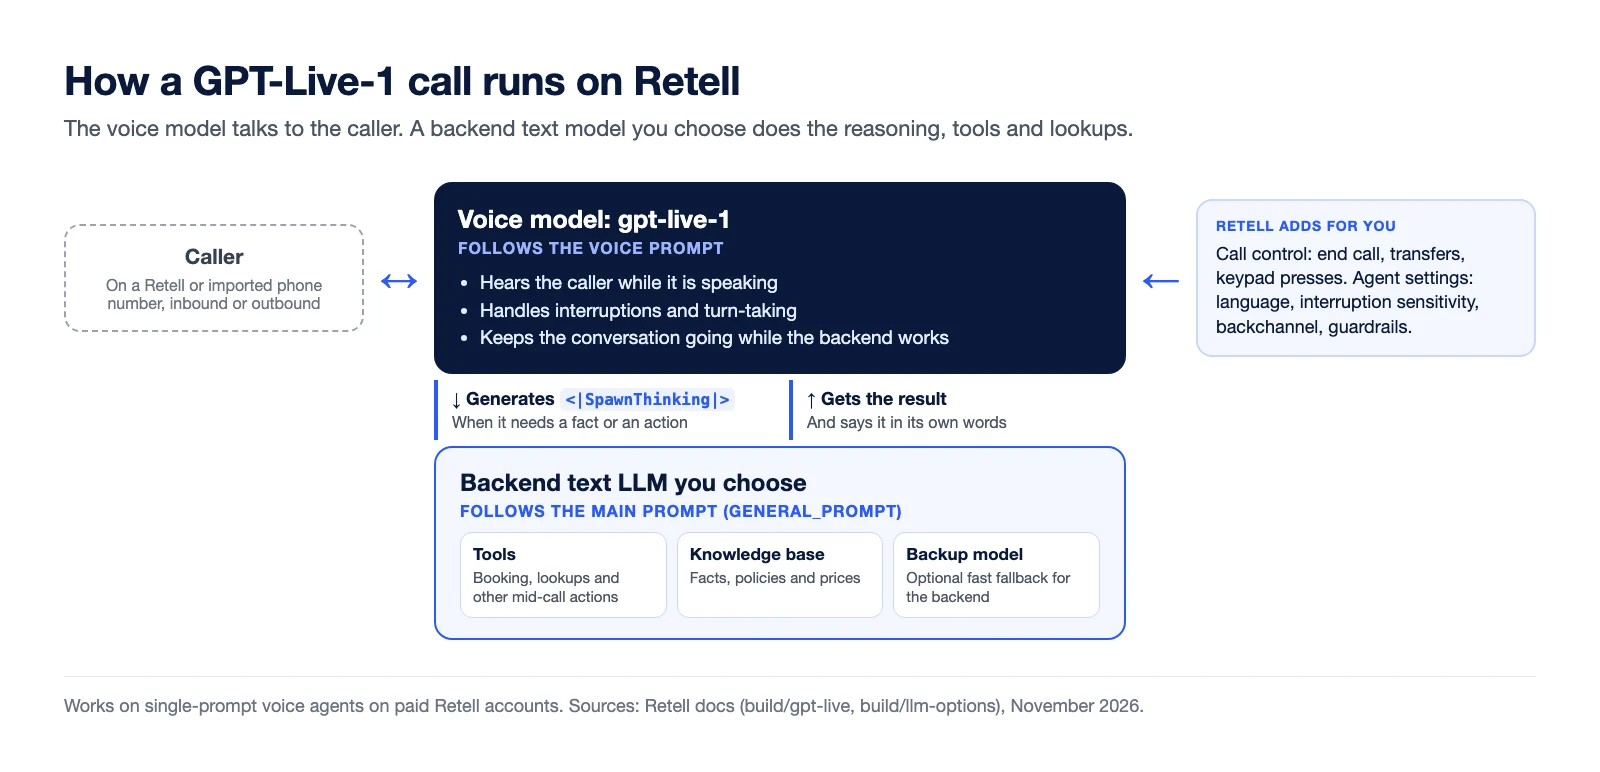
O GPT-Live-1 divide o trabalho de outra forma. O modelo de voz conduz a conversa: ele ouve a pessoa enquanto fala, lida com interrupções e pausas e decide o que dizer em seguida. Quando precisa de uma informação ou de uma ação, ele solicita trabalho ao backend gerando um token especial, <|SpawnThinking|>. O backend pode ser um modelo, um agente ou um serviço; na Retell, é um modelo de texto escolhido por você, que executa as ferramentas e a base de conhecimento do agente. O backend devolve o resultado, e o modelo de voz o comunica com as próprias palavras. O trabalho do backend pode continuar rodando mesmo quando a pessoa interrompe.
Os próprios números da OpenAI defendem essa divisão. Nos gráficos do post de lançamento na API, o GPT-Live-1 com o GPT-6 Astra em esforço de raciocínio médio como backend conclui 86,2% das tarefas de voz do Tau3 (atendimento ao cliente de companhias aéreas, varejo e telecom) na primeira tentativa, contra 45,7% do GPT-Realtime-2.1. No Full Duplex Bench, a OpenAI informa latência de alternância de turnos de 0,798 segundo para o GPT-Live-1, contra 1,41 segundo para o GPT-Realtime-2.1. Esses são resultados da OpenAI, não medições da Retell.
Cascata, speech-to-speech ou full duplex?
A Retell oferece as três formas de rodar um agente de voz. Cada uma se adapta a um tipo de chamada.
| Cascata | Speech-to-speech | Full duplex (GPT-Live-1) | |
|---|---|---|---|
| Como funciona um turno | Transcrição, depois um LLM de texto, depois text-to-speech | Um único modelo ouve o áudio e responde em áudio | Um modelo de voz fala enquanto um LLM de texto de backend cuida do raciocínio e das ferramentas |
| Exemplos na Retell | GPT 5.6 Terra, Claude 5 Sonnet, Gemini 3.5 Flash | gpt-realtime-2.1, grok-voice-3.0 | gpt-live-1 com um LLM de texto de backend |
| Prompts | Um | Um | Dois: um prompt de voz e o prompt do backend |
| Modelo de backup fast-fallback | Compatível | Não compatível | Aplica-se ao modelo de backend |
| Ideal para | Fluxos de conversa e lógica rígida de várias etapas | Chamadas rápidas e naturais que seguem basicamente um prompt | Chamadas naturais que também executam ações durante a chamada |
Para a opção speech-to-speech da xAI, veja como rodar um agente de voz por telefone com o Grok Voice. Para um panorama mais amplo de modelos, confira nosso comparativo de APIs de IA speech-to-speech para chamadas telefônicas.
Onde o GPT-Live-1 se encaixa em chamadas telefônicas
O GPT-Live-1 se destaca em agentes de prompt único que executam ações durante a chamada, como agendar um compromisso ou consultar um pedido, situações em que o intervalo de resposta de um agente em cascata fica perceptível. Enquanto o backend agenda ou consulta algo, o modelo de voz mantém a conversa em vez de pausar com uma frase de preenchimento.
Na Retell, ele tem limites claros:
- Somente agentes de voz de prompt único. Ele não está disponível para fluxos de conversa, agentes multiprompt, agentes de transferência ou agentes de chat. Para esses casos, use um modelo em cascata ou speech-to-speech.
- Algumas ferramentas não são compatíveis. Troca de agente, transferência assistida (em ponte) e cancelamento de transferência são rejeitados ao salvar. A transferência de chamadas simples, o encerramento de chamada e o pressionamento de dígito funcionam normalmente.
- Somente contas pagas. Assim como os modelos speech-to-speech, o GPT-Live-1 não faz parte do teste gratuito.
- Sem troca por chamada. Uma substituição de agente em uma chamada específica não consegue mudar um agente para o GPT-Live-1.
Como configurar o GPT-Live-1 em um agente de voz por telefone da Retell
O GPT-Live-1 é configurado pela API da Retell, em um Retell LLM.
- Crie um Retell LLM com model_config definido como tipo duplex, gpt-live-1 como modelo principal e o modelo de texto que você quiser como backend.
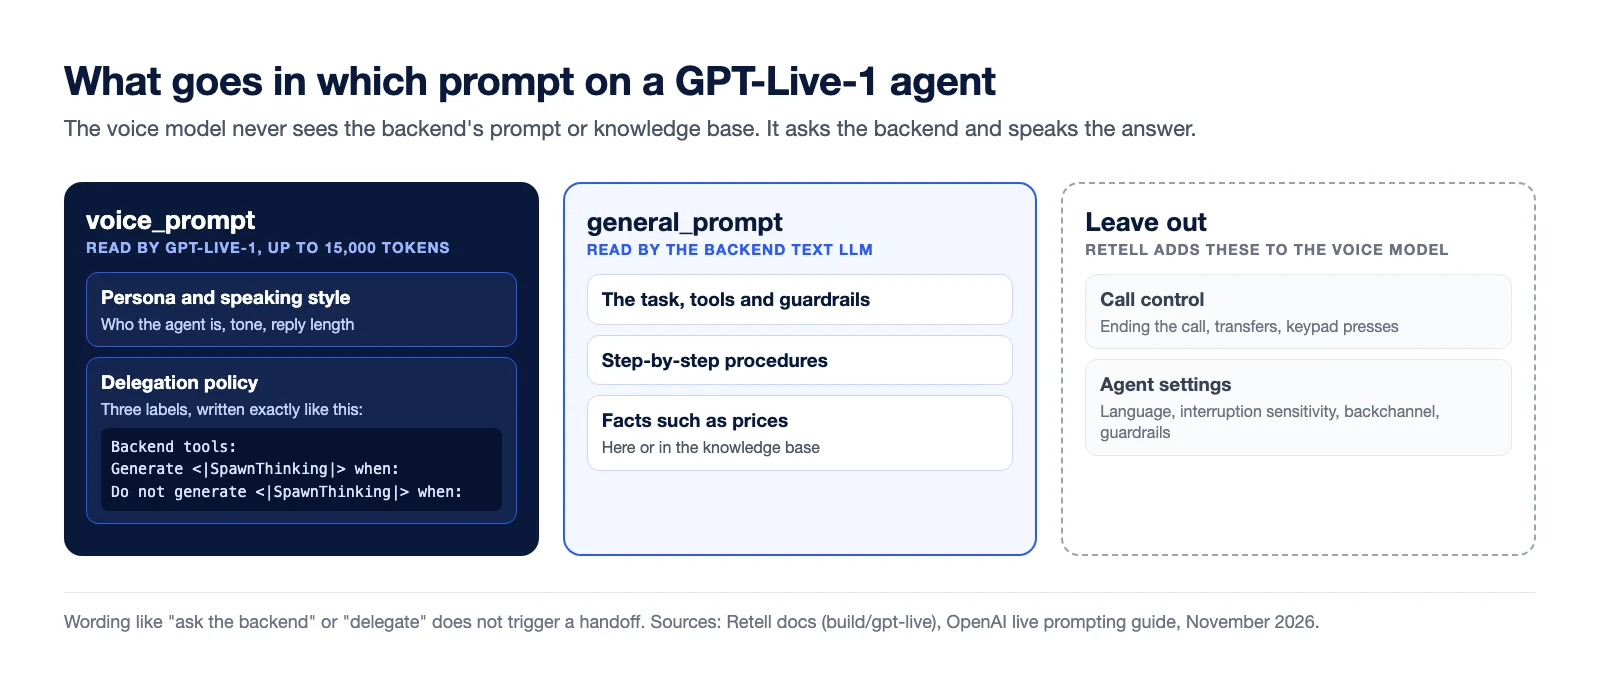
- Escreva dois prompts. general_prompt é o prompt do backend: a tarefa, as ferramentas e os guardrails. voice_prompt diz ao modelo de voz como falar e quando repassar o trabalho ao backend. Ele pode ter até 15.000 tokens.
- Vincule o LLM a um agente de voz como seu mecanismo de resposta, da mesma forma que qualquer outro Retell LLM.
- Conecte um número de telefone e receba chamadas ou faça chamadas ativas.
Veja uma requisição adaptada da documentação da Retell, para o agente de uma clínica odontológica:
curl --request POST "https://api.retellai.com/create-retell-llm" \
  --header "Authorization: Bearer $RETELL_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "general_prompt": "You are the backend for a dental clinic phone agent. Collect the caller name and date of birth, then use the booking tool to find and confirm an appointment. Keep names, numbers, and dates exact.",
    "voice_prompt": "You are a warm, efficient front-desk agent for Bright Smile Dental. Keep replies short and natural, and ask one question at a time.\n\nDelegation policy:\nBackend tools:\n- Appointments: find open times and book, change, or cancel appointments.\n\nGenerate <|SpawnThinking|> when:\n- The caller wants to book, change, or cancel an appointment.\n\nDo not generate <|SpawnThinking|> when:\n- You need a brief clarification to understand the request.",
    "model_config": {
      "type": "duplex",
      "primary": { "model": "gpt-live-1" },
      "backend": { "model": "gpt-4.1" }
    }
  }'
Todos os detalhes dos campos estão no guia de configuração do GPT Live.
Como escrever o prompt de voz
O prompt de voz é onde a maioria dos agentes com GPT-Live-1 erra. O modelo só repassa trabalho ao backend quando gera <|SpawnThinking|>, então as regras de repasse precisam usar exatamente essa expressão. Formulações como "ask the backend" ou "delegate" não acionam o repasse. O guia de prompting da OpenAI também alerta que uma promessa falada como "estou verificando isso" não significa que o trabalho do backend começou.
Escreva o prompt de voz em duas partes:
- Persona e estilo de fala. Quem é o agente e como ele fala, como o tom e o tamanho das respostas.
- Uma política de delegação com três rótulos, mantidos exatamente como escritos: "Backend tools:" lista o que o backend pode fazer, uma capacidade por linha. "Generate <|SpawnThinking|> when:" lista quando repassar o trabalho. "Do not generate <|SpawnThinking|> when:" lista o que responder diretamente.
Mantenha as definições de ferramentas, os procedimentos passo a passo e informações como preços no prompt do backend e na base de conhecimento. O modelo de voz não os vê; ele consulta o backend e comunica a resposta com as próprias palavras. A Retell também adiciona ao modelo de voz, por você, as instruções de controle de chamada (encerrar a chamada, transferências, toques no teclado) e as configurações do agente, então deixe isso de fora.
O que é mantido das configurações do seu agente
A maioria das configurações de agente da Retell continua valendo. O modelo de voz respeita o idioma do agente, a sensibilidade a interrupções, a responsividade, o backchannel, a velocidade da voz, a pronúncia, as palavras-chave reforçadas e os guardrails. A detecção de caixa postal, URA, não perturbe e retorno de chamada passa pelo backend, e a configuração da mensagem de boas-vindas continua definindo quem fala primeiro.
Duas coisas funcionam de forma diferente. A configuração "falar durante a execução" de cada ferramenta é ignorada, porque o modelo de voz continua falando enquanto o backend trabalha, e o agente sempre fala depois que uma ferramenta termina. As variáveis dinâmicas no prompt de voz são preenchidas uma única vez, no início da chamada.
Quanto custa o GPT-Live-1
Na API da OpenAI, uma sessão de voz do GPT-Live-1 custa $0,05 por minuto, cobrada por segundo e sem arredondamento para o minuto seguinte. O modelo de backend e suas ferramentas são cobrados à parte, nas tarifas normais.
Na Retell, o modelo de voz é cobrado por minuto de chamada, e o LLM de texto de backend é cobrado à parte pelo próprio uso. As tarifas atuais estão na página de preços. Um detalhe importa em chamadas longas: a Retell reduz a cobrança dos modelos em longos períodos de silêncio, mas os modelos de voz full-duplex continuam sendo cobrados nesses períodos.
Perguntas frequentes
O que é o GPT-Live-1?
O GPT-Live-1 é o modelo de voz full-duplex da OpenAI para conversas em tempo real. Ele ouve e fala ao mesmo tempo, lida com interrupções e delega o raciocínio e o uso de ferramentas a um modelo ou agente de backend escolhido por você.
O GPT-Live-1 está disponível na API?
Sim. O GPT-Live-1 ficou disponível de forma geral na API da OpenAI em 10 de setembro de 2026, no endpoint de sessões Live. O GPT-Live-1.1, uma versão mais recente com mais vozes e melhor desempenho em idiomas além do inglês, foi lançado no ChatGPT, no Codex e no dots em 15 de outubro de 2026, com chegada à API anunciada para breve.
Quanto custa o GPT-Live-1?
A OpenAI cobra $0,05 por minuto por uma sessão de voz do GPT-Live-1, cobrada por segundo. O modelo de backend e o uso de ferramentas são cobrados à parte, nas tarifas normais.
O GPT-Live-1 funciona em chamadas telefônicas?
Sim. A OpenAI oferece conexões de telefonia e SIP para sessões Live. Na Retell, um agente com GPT-Live-1 é um agente de voz como qualquer outro, então você o conecta a um número de telefone para chamadas recebidas e realizadas, e tanto a transferência de chamadas simples quanto o pressionamento de dígito funcionam.
Qual é a diferença entre o GPT-Live-1 e o gpt-realtime?
Os modelos gpt-realtime são speech-to-speech: um único modelo ouve, raciocina, chama ferramentas e fala, na Realtime API da OpenAI. O GPT-Live-1 roda em um endpoint separado de sessões Live, mantém a voz no próprio modelo e envia o raciocínio e as ferramentas a um backend. A OpenAI relata maior taxa de conclusão de tarefas para o GPT-Live-1 combinado com um backend robusto, além de alternância de turnos mais rápida.
O GPT-Live-1 funciona com fluxos de conversa na Retell?
Não. Na Retell, o GPT-Live-1 funciona apenas em agentes de voz de prompt único. Fluxos de conversa e agentes multiprompt precisam de um modelo em cascata ou speech-to-speech.
Teste o GPT-Live-1 nas suas próprias chamadas
Se o seu agente executa ações durante a chamada e as pausas incomodam você, vale a pena fazer um piloto com o GPT-Live-1. Siga o guia de configuração, conecte um número na Retell e compare-o com o seu modelo atual em chamadas reais antes de fazer a troca.
Veja quanto seu negócio poderia economizar ao migrar para agentes de voz com IA.
Resultado do ROI
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Um número de telefone de demonstração do consultório da Retell Clinic
What results look like with Retell AI


Estimate your monthly voice AI cost
Read Other Blogs
Revolucione sua operação de chamadas com a Retell


