O que times de produto buscam em uma plataforma de IA de voz




Uma plataforma de IA de voz é o software que um time de produto usa para construir, conectar, testar e operar agentes de voz com IA em chamadas telefônicas e web. Líderes de produto e engenharia raramente escolhem uma plataforma a partir de uma demonstração. Eles constroem o mesmo agente em cada plataforma da lista final e verificam quatro coisas na prática: quão rápido o primeiro agente funcional fica pronto, até onde vão a API e as ferramentas de fluxo de trabalho, quanto tempo quem liga espera por uma resposta e o que muda quando um piloto passa a receber tráfego de produção.
Este guia é um plano para essa comparação prática. A Retell AI publica este guia e é uma das plataformas que times de produto comparam, ao lado de Vapi, ElevenLabs e Bland. O que dizemos sobre as outras três vem da documentação de cada fornecedor, consultada em 10 de novembro de 2026 e com links. Não fizemos chamadas de teste para este guia, então ele não traz notas nem ranking. O que dizemos sobre a Retell vem da documentação pública da Retell, incluindo os limites que essa documentação informa.
O que um time de produto verifica que uma demonstração não mostra?
Uma demonstração mostra uma chamada boa. Uma comparação prática mostra o que seus próprios engenheiros conseguem construir, conectar e medir. Dê a um engenheiro o mesmo tipo de chamada em todas as plataformas, um caso real, como agendar compromissos usando sua API de agendamento, e registre os mesmos quatro resultados em cada uma.
| O que verificar | O que seu time faz | O que anotar |
|---|---|---|
| Facilidade de construção | Construir o agente, de uma conta vazia até a primeira chamada, sem ajuda do fornecedor | Horas até a primeira chamada funcional e cada ponto em que vocês travaram |
| Profundidade de API e fluxos de trabalho | Chamar sua própria API durante uma chamada, receber eventos de chamada, criar o agente via código | Quais etapas exigiram uma solução alternativa |
| Latência de resposta | Fazer pelo menos 20 chamadas e extrair o tempo de cada turno | Mediana e percentil 95, com a definição que o fornecedor usa |
| Do piloto à escala | Ler os limites, o comportamento em falhas e os controles de lançamento antes de precisar deles | Limites padrão, o que acontece ao atingi-los e o que determina o custo |
Quão rápido seu time consegue construir o primeiro agente funcional?
Meça o tempo de uma conta vazia até uma chamada que seu engenheiro mostraria a um colega e anote cada ponto em que foi preciso pedir ajuda ao fornecedor. Uma resposta encontrada na documentação conta como autoatendimento.
Duas coisas determinam esse tempo na maioria das plataformas. A primeira é quanta estrutura você precisa desenhar antes que o agente consiga conversar. A documentação da Retell recomenda começar com um agente de prompt único e migrar para um fluxo de conversa, que divide a tarefa em nós com instruções próprias, só quando um prompt único não atender mais aos seus requisitos. A mesma página é direta sobre a troca: "O fluxo de conversa não é automaticamente mais confiável."
A segunda é quão cedo você consegue ouvir o agente e identificar os erros dele. A visão geral de testes da Retell lista quatro métodos: chat de texto no LLM Playground, casos de teste de simulação salvos, chamadas pelo navegador "sem um número de telefone" e chamadas telefônicas reais. Inclua as chamadas de teste no orçamento. Na Retell, os testes são cobrados com as mesmas tarifas da produção. Para um passo a passo completo de uma primeira construção, veja como construir um agente de voz com IA.
A facilidade de construção também depende do que a plataforma opera por você. A documentação da Retell diz que ela "opera as camadas de telefonia, fala e modelo de linguagem, para que você configure o agente em vez de conectar provedores." Seu time controla o comportamento do agente sem manter a infraestrutura por trás dele. Se essa troca faz sentido para você é uma decisão à parte, abordada em construir ou comprar agentes de voz com IA.
Até onde vão a API e as ferramentas de fluxo de trabalho?
Profundidade suficiente significa duas coisas: seus engenheiros conseguem fazer via código o que fizeram no dashboard, e o agente consegue acessar seus sistemas durante uma chamada sem um projeto de middleware. Verifique cinco áreas em todas as plataformas.
- SDKs e cobertura da API. Pergunte se toda ação do dashboard tem um endpoint. A Retell publica SDKs oficiais para Node.js e Python, descritos como clientes tipados com cobertura completa dos endpoints de voz e chat.
- Chamar sua API durante uma chamada. Uma função personalizada da Retell envia uma requisição GET, POST, PUT, PATCH ou DELETE ao seu endpoint e aguarda a resposta. O timeout vai de 1 a 600 segundos, com padrão de 120. As requisições não são repetidas, a menos que você defina um número de tentativas. Pergunte a cada fornecedor o que quem liga ouve enquanto uma requisição lenta é executada.
- Eventos de chamada. Os webhooks da Retell enviam os eventos call_started, call_ended e call_analyzed ao seu servidor. Cada um tem timeout de 10 segundos e é repetido até 3 vezes. Um cabeçalho de assinatura permite verificar o remetente.
- MCP nas duas direções. Um agente da Retell pode chamar as ferramentas de um servidor MCP remoto durante uma chamada ao vivo. O próprio servidor MCP da Retell permite que clientes como Cursor e Claude Code construam e gerenciem agentes pela API.
- Seu próprio modelo e sua própria operadora. Com um LLM Personalizado, a Retell gerencia a chamada e abre um WebSocket com seu servidor para cada chamada. A documentação recomenda os tipos de agente nativos para a maioria dos agentes e diz que, com um LLM Personalizado, você assume a latência, a disponibilidade e o tratamento de reconexões. Para linhas telefônicas, a telefonia personalizada se conecta por SIP trunking elástico ou discando para uma URI SIP.
Verifique também as conexões prontas. A visão geral de integrações da Retell lista 11 provedores entre CRM, suporte, agenda e base de conhecimento. Qualquer coisa fora dessa lista passa por uma função personalizada, MCP ou um webhook.
Como você deve medir a latência de resposta?
Meça nas suas próprias chamadas, turno a turno, e reporte percentis junto com a definição usada. Um número de latência sem ponto de início e de fim não pode ser comparado com o número de outro fornecedor.
A documentação da Retell define a latência ponta a ponta como o tempo entre o momento em que o usuário para de falar e o momento em que o agente começa a responder. Com base nessa definição, a documentação afirma que a plataforma "atinge latência a partir de 600ms." Leia "a partir de" como um piso. Seu número depende do modelo, do prompt e das configurações que você escolher.
Para obter seus próprios números, extraia-os por chamada. A Get Call API da Retell retorna um objeto de latência com os percentis 50, 90, 95 e 99 do valor ponta a ponta e também de transcrição, LLM, texto para fala e recuperação na base de conhecimento. A mesma página informa um limite: o valor ponta a ponta não inclui o trajeto de rede do servidor da Retell até o dispositivo do usuário. Para chamadas web e dentro de apps, meça também o tempo de resposta no cliente.
Quando um número estiver alto, analise a configuração antes de culpar a plataforma. O guia de solução de problemas de latência da Retell aponta a escolha do modelo de LLM e o tamanho do prompt como as duas causas mais comuns, diz que prompts acima de cerca de 8.000 tokens ficam visivelmente mais lentos e recomenda manter a latência estimada abaixo de 1,5 segundo. Peça a todos os fornecedores o mesmo detalhamento por componente.
Velocidade é apenas um dos fatores de uma boa chamada. Latência em IA de voz: causas, medição e impacto em quem liga explica de onde vem o atraso e quando uma resposta mais rápida piora a chamada. Para resultados de benchmark publicados dessas quatro plataformas, veja Retell AI vs Bland AI vs Vapi vs ElevenLabs.
O que muda entre um piloto e a escala de produção?
Três coisas mudam: os limites que você encontra, o que quem liga vivencia quando algo falha e como as mudanças chegam às chamadas ao vivo. Leia as respostas de cada fornecedor antes de o piloto terminar.
- Concorrência. Pergunte qual é o limite padrão e o que acontece ao atingi-lo. Na Retell, um workspace com pagamento conforme o uso tem 20 chamadas simultâneas por padrão, e você pode aumentar o limite pelo dashboard. No limite, uma nova chamada recebida aguarda uma vaga. Após cerca de 40 segundos, ela é transferida para um número de fallback, se você tiver definido um; caso contrário, a chamada é encerrada. Uma chamada realizada acima do limite é rejeitada, a menos que você ative o burst de concorrência, que adiciona uma sobretaxa por minuto.
- Disponibilidade e fallbacks. A visão geral de confiabilidade da Retell informa uma garantia de mais de 99,9% de disponibilidade e traz o link de uma página de status pública. Ela lista fallback de LLM e novas tentativas como recursos nativos, além de um modo Backup que desvia novas chamadas recebidas para um número de fallback enquanto você investiga um problema.
- Controle de lançamentos. Versões, tags de staging, execuções em lote a partir do seu pipeline de CI e divisões percentuais de tráfego determinam a segurança com que uma mudança é lançada. Esse assunto tem um guia próprio: o padrão de compra de IA de voz.
- Revisão de segurança. Comece durante o piloto. A página de segurança e conformidade da Retell diz que ela está em conformidade com HIPAA e GDPR e tem certificação SOC 2 Tipo 1 e Tipo 2, além de oferecer um BAA em autoatendimento.
- Fatores de custo. O preço da Retell é baseado no uso, a partir de $0,07 por minuto, conforme a página de preços. A tarifa depende da voz, do modelo e da telefonia escolhidos, e algumas opções de latência custam mais do que a tarifa padrão do modelo. Como funciona o preço baseado no uso explica cada parte.
Para desenhar o piloto, como avaliar uma plataforma de agentes de voz antes de entrar em produção mostra quais chamadas incluir e o que medir, e da demonstração de IA de voz à produção aborda os primeiros 30 dias.
Como Vapi, ElevenLabs, Bland e Retell se descrevem?
A documentação de cada fornecedor descreve uma plataforma para construir, implantar e monitorar agentes de voz, com uma forma de começar baseada em prompt e uma opção mais estruturada. A tabela cita a própria documentação de cada fornecedor, consultada em 10 de novembro de 2026.
| Plataforma | Como a própria documentação a descreve | Opções de construção citadas na documentação |
|---|---|---|
| Retell AI | "Uma plataforma para construir, testar, implantar e monitorar agentes de voz e chat com IA, com telefonia, prompts, ferramentas e análises integrados" (documentação da Retell) | Agentes de prompt único e agentes de fluxo de conversa |
| Vapi | "A plataforma para desenvolvedores construírem agentes de IA de voz" (documentação da Vapi) | Assistants, que usam um único prompt de sistema com ferramentas e saídas estruturadas, e Squads, que executam vários assistants com transferências que preservam o contexto. Você escolhe os provedores de fala para texto, LLM e texto para fala |
| ElevenLabs | O ElevenAgents oferece "modelos expressivos e ricos em voz, ferramentas para desenvolvedores construírem agentes multimodais e ferramentas para monitorar e avaliar o desempenho dos agentes em escala" (documentação da ElevenLabs) | Um kit de ferramentas para desenvolvedores, um dashboard ou um construtor visual de fluxos de trabalho, com SDKs para React, Swift, Kotlin, React Native e Unity |
| Bland | "Tudo o que você precisa para construir, monitorar e aprimorar agentes de IA de voz na Bland" (documentação da Bland) | Um construtor de agentes em que "a maioria dos agentes começa como um prompt único" e os pathways adicionam estrutura onde a conversa precisa |
As descrições são parecidas, então lê-las não vai fazer a escolha por você. As quatro verificações são feitas com o seu tipo de chamada e os seus sistemas. Para detalhes lado a lado, a Retell publica comparativos com a Vapi, a ElevenLabs e a Bland, além de um guia de alternativas à Vapi.
Como fazer a comparação de forma justa?
Mantenha tudo constante, exceto a plataforma. Use um tipo de chamada, um engenheiro, um roteiro de comportamento de quem liga e uma ficha de avaliação, e preencha os mesmos campos para todos os fornecedores.
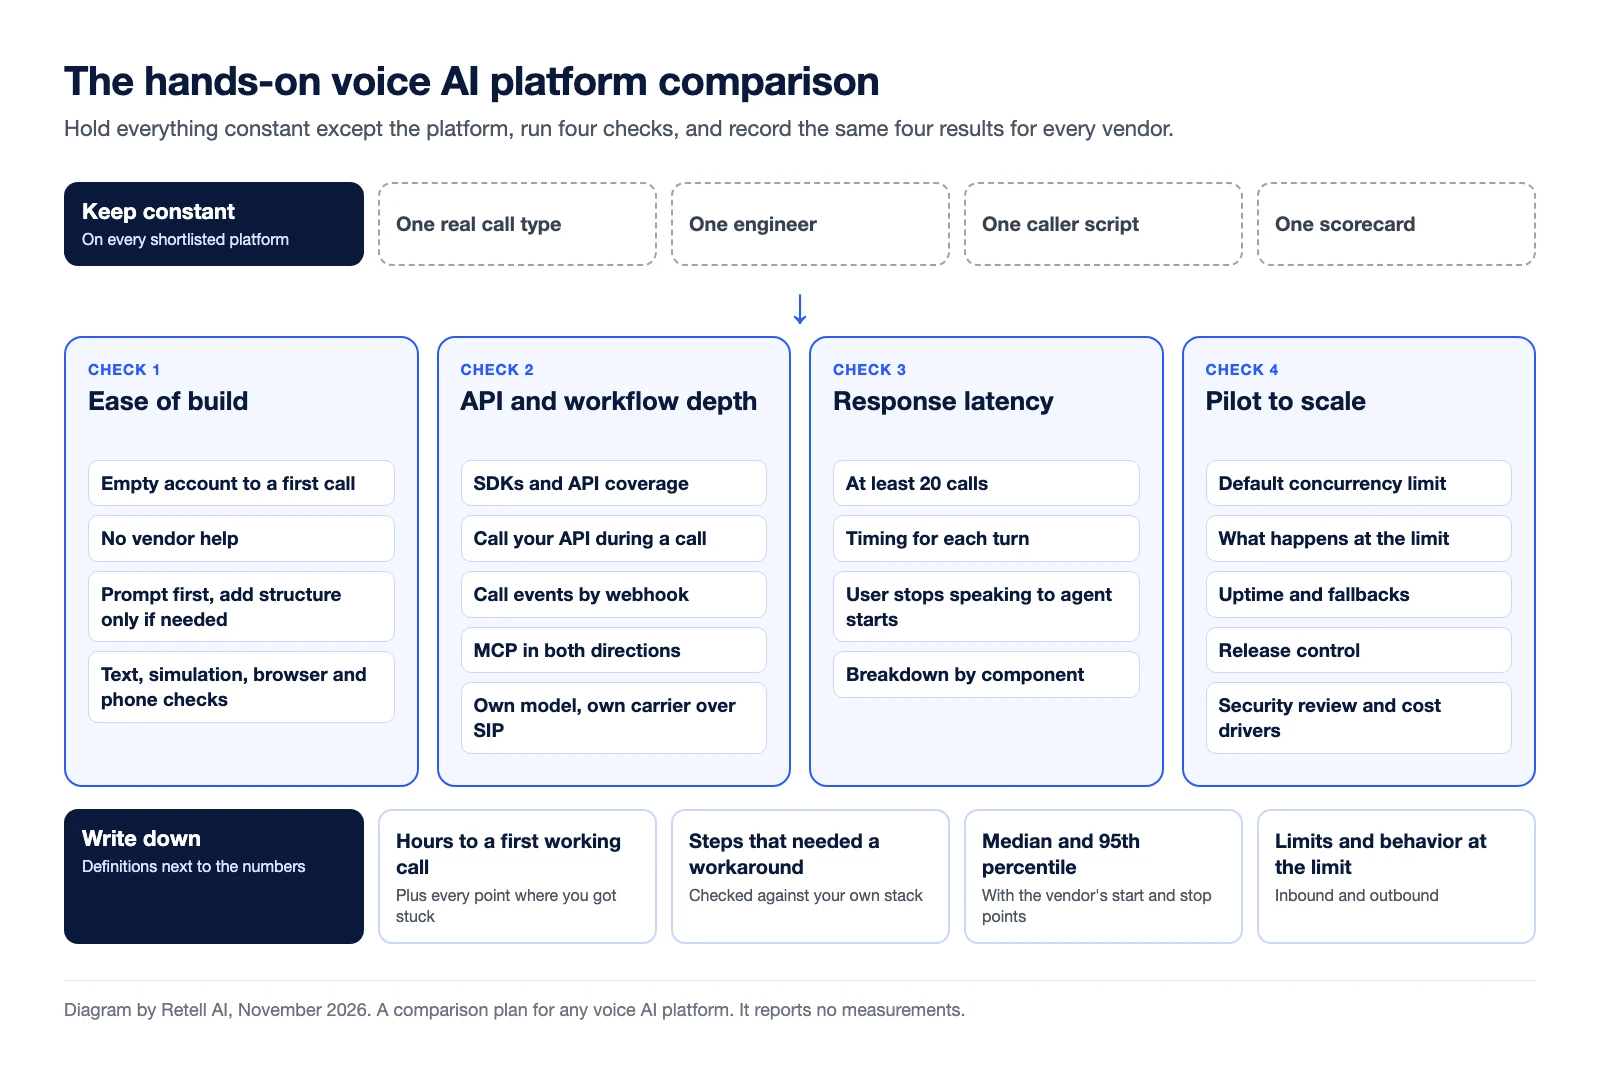
Escreva o roteiro de quem liga antes de qualquer pessoa começar a construir. Inclua uma interrupção, uma correção, uma pergunta que o agente deve recusar e uma solicitação que precise da sua API. Depois, compare os quatro resultados lado a lado, com as definições de cada fornecedor ao lado dos números dele.
Alguém precisa ser responsável pelo agente depois que a escolha for feita. Muitos times atribuem essa função a um engenheiro de CX, também chamado de engenheiro de automação de CX ou engenheiro interno de implantação: o responsável interno que encontra chamadas mal conduzidas, constrói correções, valida e implanta essas correções. Se você já tem essa pessoa, inclua-a na comparação. O que o patrocinador executivo precisa da plataforma e do fornecedor é abordado em o que líderes de CX precisam de agentes de voz com IA.
Perguntas frequentes
O que um time de produto deve buscar em uma plataforma de IA de voz?
Quatro coisas, todas verificadas na prática: quão rápido seu próprio engenheiro consegue construir um primeiro agente funcional, até onde vão a API, os webhooks e as ferramentas de fluxo de trabalho, quanto tempo quem liga espera por uma resposta nas suas próprias chamadas e como são os limites e o comportamento em falhas no volume de produção. Faça as mesmas verificações em todas as plataformas da lista final.
Como comparar plataformas de IA de voz na prática?
Escolha um tipo de chamada real, dê a um engenheiro a mesma construção em cada plataforma e faça as mesmas chamadas roteirizadas em cada uma. Registre as horas até a primeira chamada funcional, as etapas que exigiram solução alternativa, a mediana e o percentil 95 do tempo de resposta e os limites padrão. Mantenha as definições de cada fornecedor ao lado dos números dele.
Qual é uma boa latência de resposta para um agente de voz com IA?
Depende do modelo, do prompt e das configurações, então meça nas suas próprias chamadas. A documentação da Retell informa latência a partir de 600ms, medida do momento em que o usuário para de falar até o agente começar a responder, e recomenda manter a latência estimada abaixo de 1,5 segundo. Compare percentis entre fornecedores apenas quando os pontos de início e fim forem os mesmos.
É preciso ter engenheiros para construir um agente de voz com IA?
Não para um primeiro agente. O guia de início rápido da Retell vai de um template a uma chamada telefônica no dashboard. Os engenheiros entram quando o agente precisa chamar sua API durante uma chamada, enviar eventos de chamada aos seus sistemas ou se conectar à sua própria operadora via SIP. Essas são as partes que um time de produto deve construir durante a comparação.
Quantas chamadas simultâneas uma plataforma de IA de voz consegue atender?
Depende do plano e do fornecedor. Na Retell, um workspace com pagamento conforme o uso tem 20 chamadas simultâneas por padrão, e o limite pode ser aumentado pelo dashboard. Pergunte a cada fornecedor o que acontece com uma chamada recebida e com uma chamada realizada quando o limite é atingido.
Faça as quatro verificações nas suas próprias chamadas
A Retell é uma plataforma de agentes de voz com IA para centrais de atendimento, com agentes de prompt único e de fluxo de conversa, SDKs tipados, funções personalizadas, webhooks, MCP, telefonia personalizada e dados de latência por chamada. Mais de 4.000 clientes fazem mais de 100 milhões de chamadas por mês na Retell, que atingiu $100M em receita anualizada em novembro de 2026. O preço é baseado no uso, a partir de $0,07 por minuto, conforme a página de preços. Construa o mesmo agente que você construiu em outras plataformas, teste-o nas suas próprias chamadas e compare os números antes de assinar qualquer coisa.
Veja quanto seu negócio poderia economizar ao migrar para agentes de voz com IA.
Resultado do ROI
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Estimate your monthly voice AI cost
Read Other Blogs
Revolucione sua operação de chamadas com a Retell


