Claude Fable 5.2 til stemmeagenter: Hvor den passer ind, og hvor den ikke gør




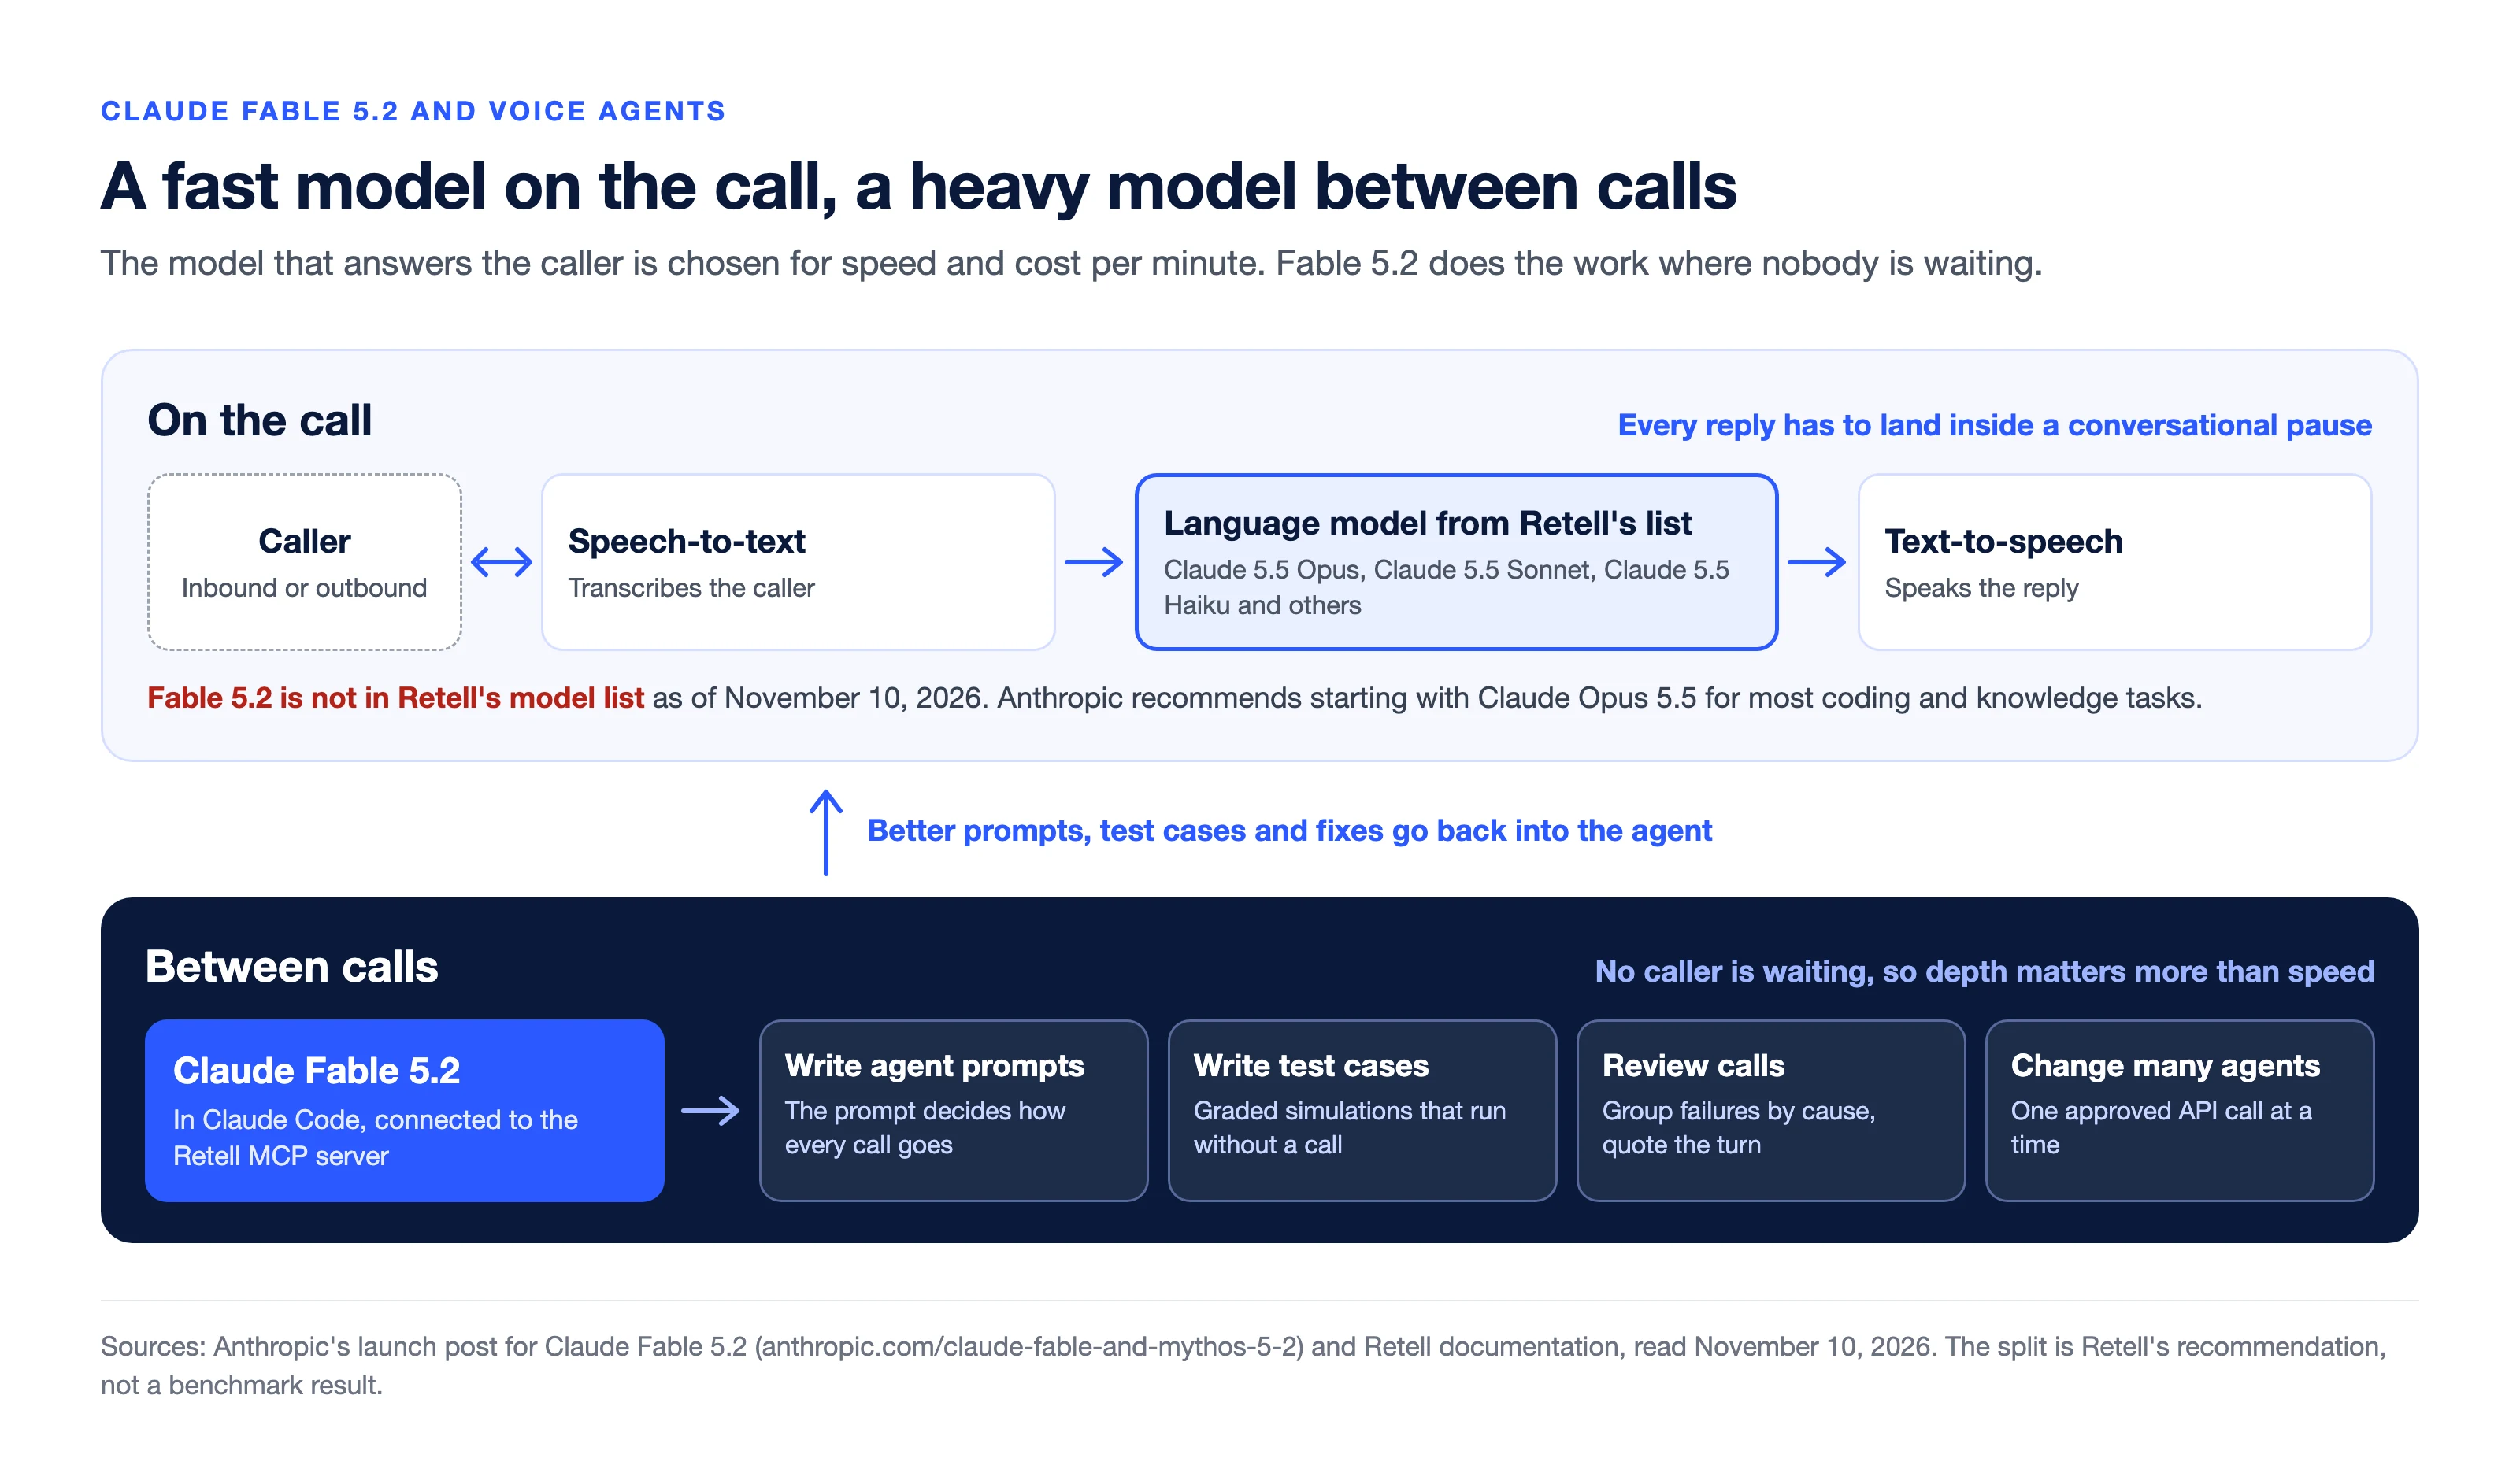
Claude Fable 5.2 er en stærk model til at bygge, teste og gennemgå stemmeagenter, men et dårligt standardvalg til at besvare den, der ringer. Anthropic udgav den den 9. november 2026 til det, virksomheden kalder det mest ambitiøse, åbne tekniske arbejde, og anbefaler at starte med Claude Opus 5.5 til de fleste kode- og vidensopgaver. I et telefonopkald tikker uret for hvert svar, så den model, der taler, bør vælges efter hastighed og pris pr. minut. Det er i arbejdet, hvor ingen venter i røret, at Fable 5.2 tjener sig hjem.
Retell AI udgiver denne guide og tilbyder Claude-modeller, dog ikke Fable 5.2, på sin platform til AI-stemmeagenter.
Claude Fable 5.2 i overblik
| Claude Fable 5.2 | |
|---|---|
| Udvikler | Anthropic |
| Udgivet | 9. november 2026 |
| Model-ID | claude-fable-5-2 |
| Positionering | Bygget til det mest ambitiøse, åbne tekniske arbejde. Anthropic anbefaler at starte med Claude Opus 5.5 til de fleste kode- og vidensopgaver. |
| API-pris | $8 pr. million input-tokens og $40 pr. million output-tokens |
| Hastighed | Genererer output op til 30% hurtigere end Claude Fable 5.1. En valgfri hurtig tilstand (fast mode) gør tokengenereringen op til 2,5 gange hurtigere til $16 pr. million input-tokens og $80 pr. million output-tokens. |
| Tilgængelighed | Alle platforme, herunder Amazon Web Services, Google Cloud og Microsoft Azure |
| Claude Mythos 5.2 | Den samme underliggende model uden visse sikkerhedsforanstaltninger inden for cybersikkerhed og biologi, tilgængelig for godkendte organisationer |
| På Retell AI | Ikke på Retells modelliste pr. 10. november 2026 |
Kilde: Anthropics lanceringsindlæg om Claude Fable 5.2 og Claude Mythos 5.2, læst 10. november 2026. Tilgængelighed på Retell ifølge Retells API-reference og prisside, læst samme dag.
Hvorfor Fable 5.2 ikke er modellen i opkaldet
En stemmeagent skal svare inden for en naturlig pause i samtalen. I en kaskadeagent går hver tur gennem tale-til-tekst, en sprogmodel og tekst-til-tale, og sprogmodellens tid til de første ord, der kan udtales, er en af de forsinkelser, den, der ringer, hører. Det er ikke påvist, at en model, der er positioneret til langt, åbent arbejde, kan holde det tempo.
Tre ting fra Anthropics lanceringsindlæg former vores syn:
- Anbefalingen. "Til de fleste kode- og vidensopgaver anbefaler vi, at brugerne starter med Claude Opus 5.5, vores stærkeste model til daglig brug."
- Prisen. Fable 5.2 koster $8 pr. million input-tokens og $40 pr. million output-tokens, hvilket Anthropic præsenterer som en lavere pris end før. Vores vurdering er, at den stadig passer bedre til arbejde, hvor svaret er værd at vente og betale for, end til et telefonopkald, der afregnes pr. minut.
- Tavsheden om stemme. Indlægget nævner ikke stemmeagenter, samtaler i realtid eller kundeservice. Det rapporterer resultater inden for kodning, videnskab, computerbrug og forretningsworkflows.
Indlægget siger dog, at Fable 5.2 genererer output op til 30% hurtigere end Fable 5.1 og tilbyder en hurtig tilstand. Det angiver ingen tid til første svar for en samtaletur, og Retell har ikke målt den. Vi vil ikke påstå, at den er for langsom til et opkald. Men der er ikke offentliggjort dokumentation for, at den er det rigtige valg til et.
Der er også et praktisk svar. Retells modelliste til stemmeagenter omfatter Claude 5.5 Opus, Claude 5.5 Sonnet og Claude 5.5 Haiku. Den omfatter ikke Fable 5.2.
Hvor Fable 5.2 hjælper et stemmeteam
Det meste af det arbejde, der gør en stemmeagent god, sker, når ingen er på linjen. Her er en model, der kan holde fast i en lang, rodet opgave og gøre den færdig, nyttig.
| Opgave | Fable 5.2's rolle | Sådan når den Retell |
|---|---|---|
| Besvare den, der ringer, tur for tur | Ikke i dag. Brug en model fra Retells liste | Vælges i agentens modelvælger |
| Skrive og omskrive agentprompts | Passer godt. Prompten afgør, hvordan hvert opkald forløber | Claude Code via Retell MCP-serveren |
| Skrive en regressionssuite | Passer godt. Den kan omsætte fejlmønstre til bedømte testcases | Opretter simuleringstestcases via API'et |
| Gennemgå opkald i stor skala | Passer godt. Den kan gruppere fejl efter årsag og citere turen | Lister opkald og læser hvert opkalds transskription, latens og analyse efter opkald |
| Ændre mange agenter på én gang | Passer godt. Langt arbejde i flere trin på tværs af et workspace | Læser og opdaterer agenter ét godkendt kald ad gangen |
| Spille den, der ringer, i en simulering | Ikke i dag. Den simulerede opkalder kører på en model, du vælger i Retell | Indstilles på testcasen |
Anthropic beskriver selv denne arbejdsdeling. Lanceringsindlægget siger, at Fable 5.2 kan spille rollen som Advisor eller som Orchestrator, der uddelegerer enklere opgaver til mindre modeller. En stemmestak er netop det mønster med en telefon tilknyttet: en hurtig model håndterer hver tur, og en tungere model arbejder på prompts, test og gennemgang mellem opkaldene.
Den praktiske version finder du i sådan bygger du en stemmeagent med Claude Code og Claude Fable 5.2.
Hvad hvis du alligevel vil have Fable 5.2 i opkaldet?
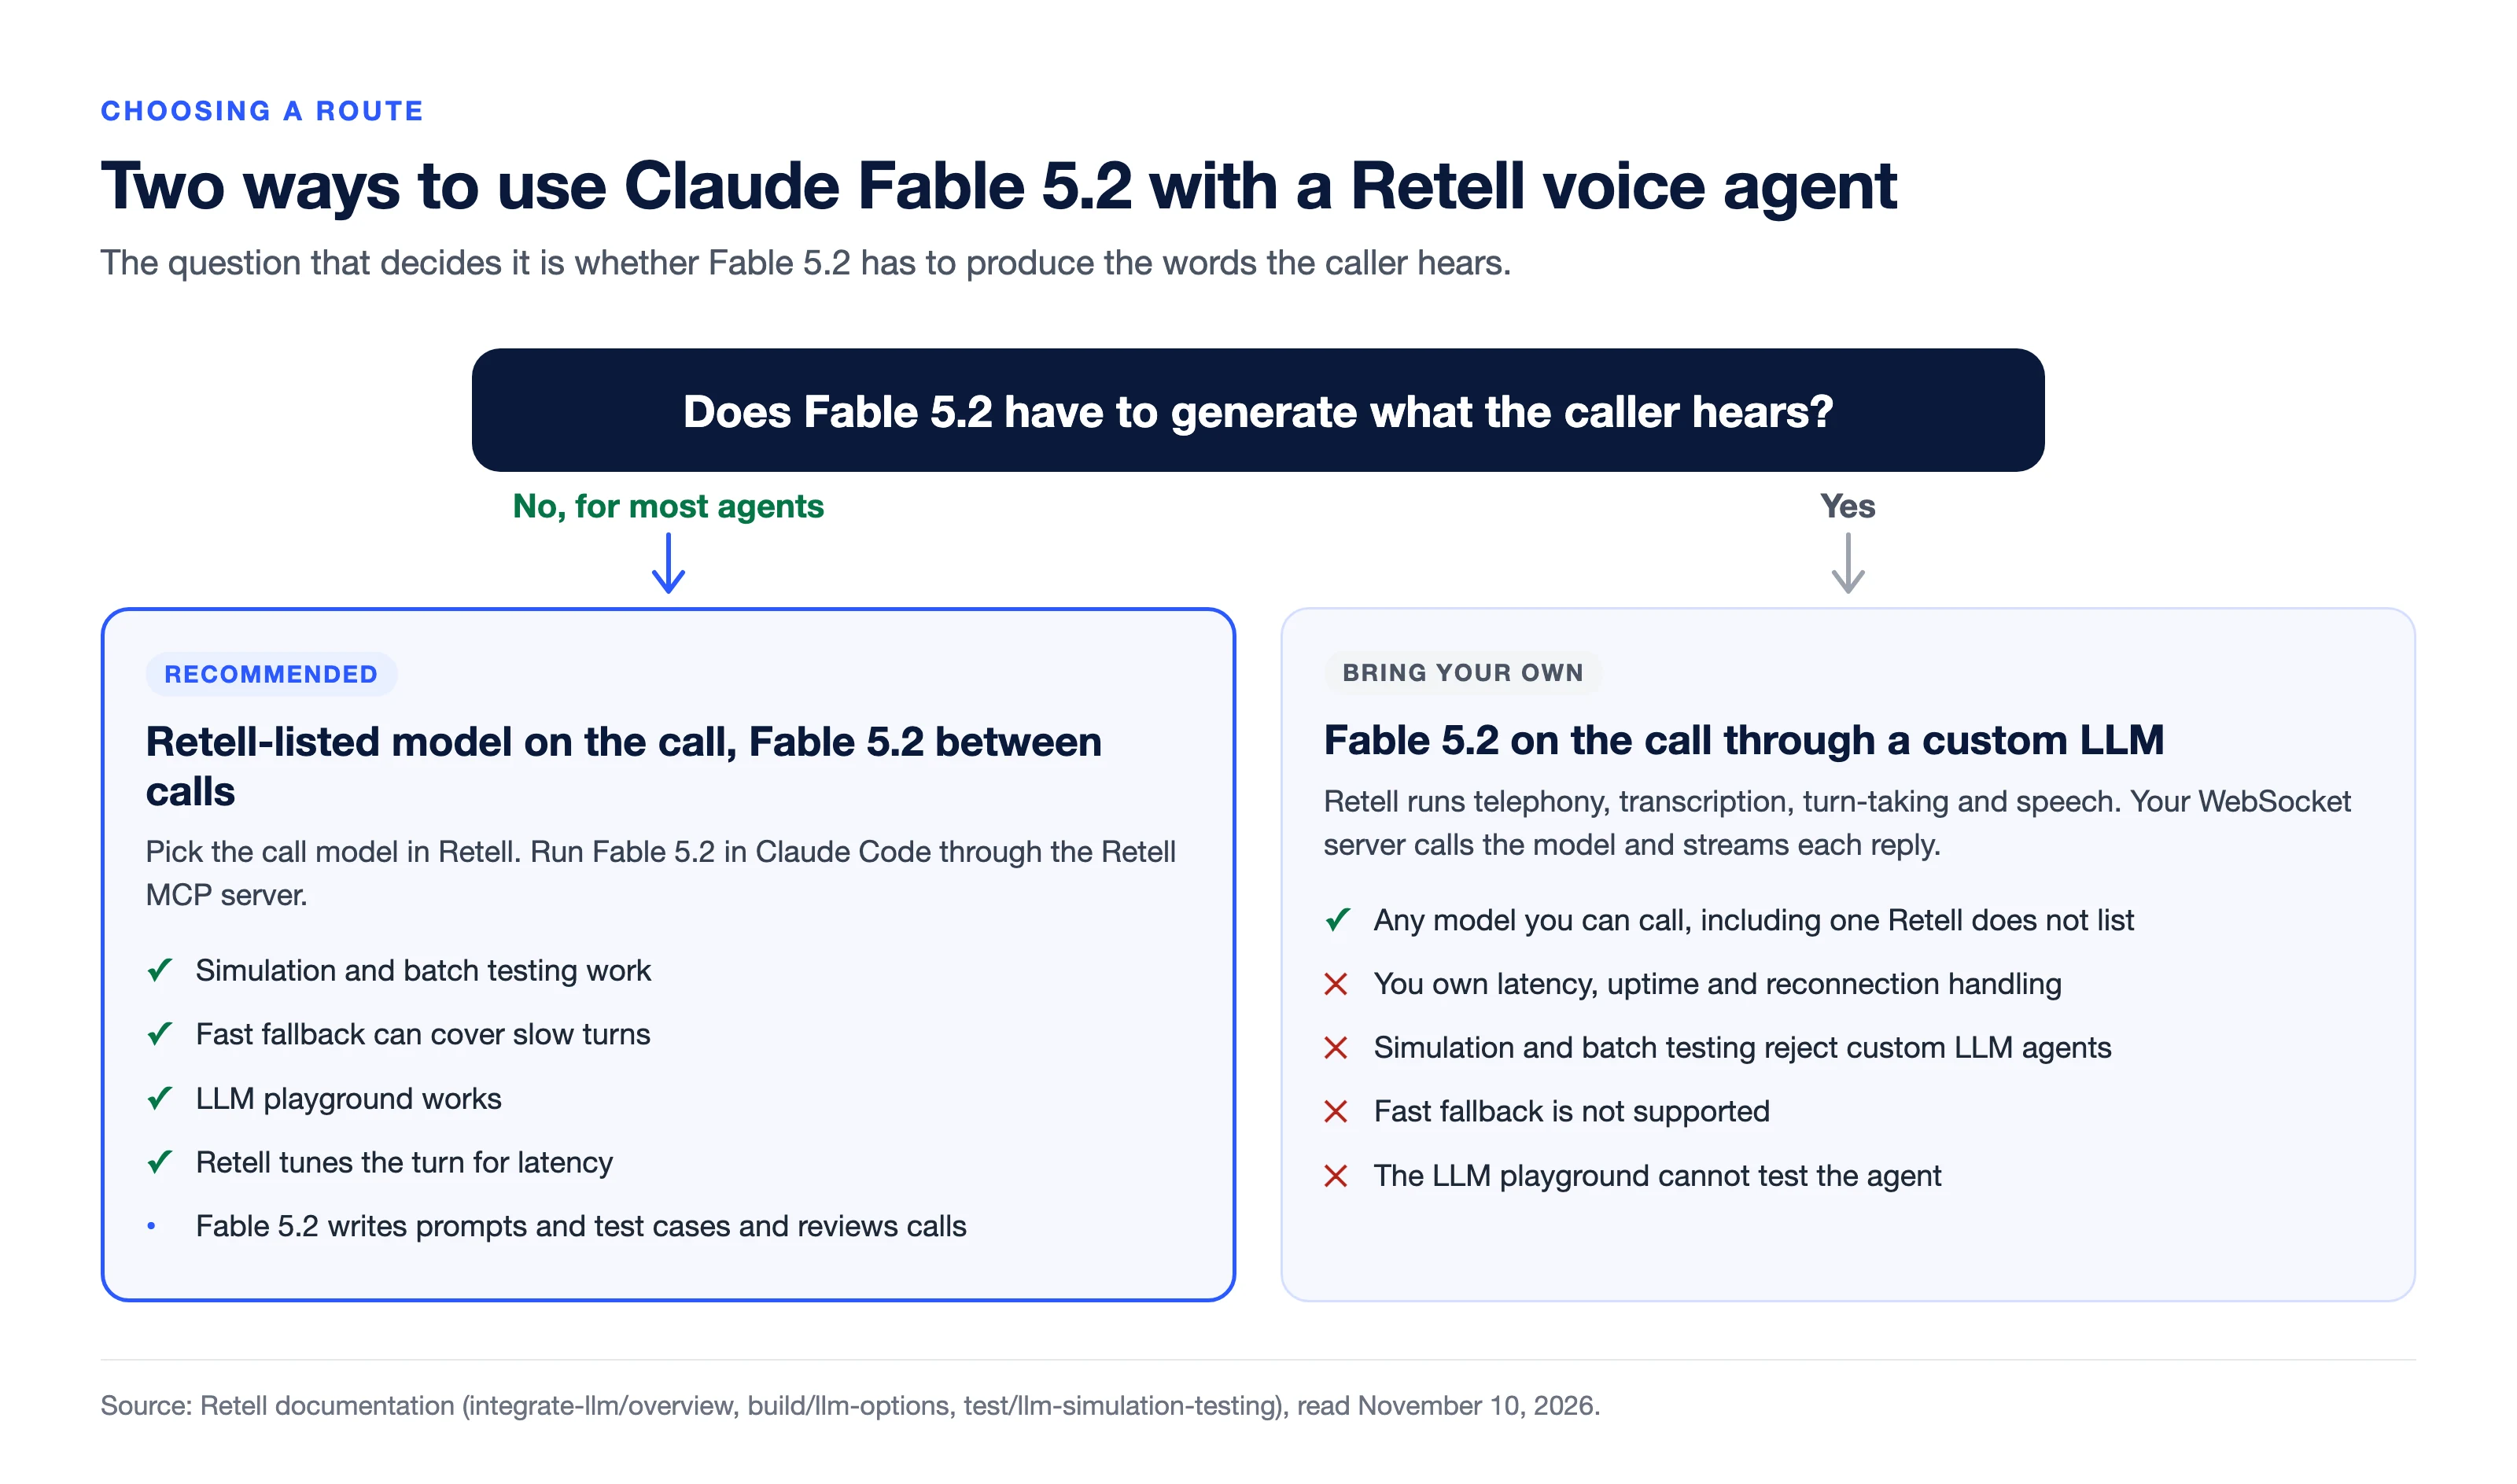
Du kan selv tilføje den. Med Retells tilpasset LLM-mulighed kan du køre din egen model bag en stemmeagent: Retell håndterer telefoni, transskription, turtagning og talesyntese og åbner en WebSocket til din server for hvert opkald. Din server kalder den model, du vælger, og streamer det, agenten skal sige, tilbage.
Den vej har omkostninger, som Retells dokumentation gør rede for. Du påtager dig ansvaret for latens, oppetid og håndtering af genforbindelse. LLM-playground kan ikke teste en agent med tilpasset LLM, og simulerings- og batchtest afviser dem, så web- og telefonopkald er den eneste måde at teste på. Fast fallback, som kører en backupmodel sideløbende med den primære, så et langsomt svar ikke holder samtalen tilbage, understøtter ikke agenter med tilpasset LLM. Retell anbefaler single-prompt- eller conversation flow-agenter til de fleste agenter.
Sådan vælger du den model, der besvarer opkaldet
Vælg ikke modellen i opkaldet ud fra et lanceringsindlæg, heller ikke dette. Vælg den ud fra dine egne opkald.
- Start med Retells modelliste. Det er den, platformens funktioner til test, fallback og analyse er bygget op omkring.
- Mål latens pr. opkald. Retells Call History viser end-to-end-latens for hvert opkald, og Get Call API returnerer en opdeling, der omfatter sprogmodellens tid til den første del, der kan udtales.
- Kør den samme simuleringssuite mod hver kandidat. En model, der er hurtigere, men fejler dine cases om viderestilling eller oplysningspligt, er ikke hurtigere på nogen måde, der betyder noget.
- Tilføj en backup til langsomme ture. Fast fallback starter den primære model og en backupmodel samtidig og lader backuppen tage over, hvis den primære ikke er begyndt at svare i tide.
Vores bredere guide til at vælge en LLM til stemmeagenter dækker afvejningerne mellem modelfamilier. Om OpenAIs fuld-duplex-stemmemodel kan du læse sådan fungerer GPT-Live-1 i telefonopkald. Retells egen LLM, Tell-1, er endnu en kandidat til de test; Tell-1-siden viser dens benchmarkscorer.
Ofte stillede spørgsmål
Kan jeg bruge Claude Fable 5.2 til en stemmeagent?
Ikke som en model på Retells liste pr. 10. november 2026. Retells modelliste omfatter Claude 5.5 Opus, Claude 5.5 Sonnet og Claude 5.5 Haiku. Du kan køre Fable 5.2 bag en Retell-agent via muligheden for tilpasset LLM, hvor din egen server genererer hvert svar, eller bruge den uden for opkaldet til at bygge og gennemgå agenter.
Er Claude Fable 5.2 hurtig nok til live telefonopkald?
Anthropic har ikke offentliggjort et tal, der besvarer det. Lanceringsindlægget siger, at Fable 5.2 genererer output op til 30% hurtigere end Fable 5.1 og har en hurtig tilstand, der gør tokengenereringen op til 2,5 gange hurtigere, men angiver ingen tid til første svar for samtaler. Mål det på dine egne opkald, før du stoler på det.
Hvad koster Claude Fable 5.2?
Anthropic tager $8 pr. million input-tokens og $40 pr. million output-tokens. Hurtig tilstand koster $16 pr. million input-tokens og $80 pr. million output-tokens.
Hvad er forskellen på Claude Fable 5.2 og Claude Mythos 5.2?
Ifølge Anthropic er de den samme underliggende model. Fable har sikkerhedsforanstaltninger inden for cybersikkerhed og biologi, så den kan tilbydes alle brugere. Mythos 5.2 kører uden visse af disse foranstaltninger og er kun tilgængelig for godkendte organisationer.
Hvilken Claude-model bør en stemmeagent bruge?
Vælg blandt de Claude-modeller, din stemmeplatform tilbyder, og beslut ud fra målt latens og beståelsesrate, ikke ud fra hvilken model der er nyest. Anthropic anbefaler selv at starte med Claude Opus 5.5 til de fleste kode- og vidensopgaver.
Hvad er Claude Fable 5.2 god til inden for stemme-AI?
Arbejdet mellem opkaldene: at skrive agentprompts, generere testcases, gennemgå opkaldstransskriptioner i stor skala og foretage ændringer på tværs af mange agenter. Claude Code kan gøre alt det mod et Retell-workspace via Retells MCP-server.
Sæt Fable 5.2 i arbejde mellem opkaldene
Hold en hurtig model i opkaldet, og giv den tunge model arbejdet omkring det. Forbind Claude Code til Retell MCP-serveren, lad den skrive en testsuite til en agent, du allerede kører i Retell, og se, hvad den finder i dine egne opkald.
See how much your business could save by switching to AI-powered voice agents.
ROI Result
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Estimate your monthly voice AI cost
Read Other Blogs



Revolutionér din callcenter-drift med Retell


