LLM specializzati vs LLM generalisti per i contact center





Per la maggior parte dei contact center, un LLM generalista è il punto di partenza più sicuro. Un LLM specializzato si guadagna il suo posto quando un singolo tipo di chiamata ha volumi elevati e un modello generalista continua a sbagliare sempre nello stesso modo misurabile: prime parole lente, chiamate agli strumenti errate o risposte che sembrano una pagina web letta ad alta voce. Nessuno dei due vince per categoria. Il modello da scegliere è quello che supera le prove sulle tue chiamate, esecuzione dopo esecuzione, con un costo al minuto che puoi prevedere.
Questa guida è pensata per chi risponde della linea telefonica. Retell AI pubblica questa guida e ha interessi in entrambi i campi. La sua piattaforma offre modelli generalisti di OpenAI, Anthropic e Google, e ne sviluppa uno proprio: Tell-1, l'LLM di Retell, creato per le chiamate dei contact center. Tell-1 è al primo posto nella classifica generale del benchmark pubblico di Retell, il Retell vCX Benchmark (consultato il 13 novembre 2026). Trattalo come qualsiasi benchmark di un fornitore: un motivo per inserirlo nella rosa dei candidati, poi qualcosa da verificare sulle tue chiamate.
Cosa richiede una chiamata di contact center a un modello linguistico?
Una chiamata di contact center chiede al modello cinque cose a ogni turno: seguire uno script lungo, chiamare correttamente gli strumenti, risultare naturale quando parla, rispondere in fretta e restare economico su larga scala.
- Script lunghi. Il prompt dell'agente contiene i passaggi, le policy e le eccezioni di un tipo di chiamata, e il modello deve applicare la regola giusta a ogni turno. Nel benchmark Multi-IF, tutti i 14 modelli valutati hanno mancato più istruzioni a ogni turno aggiuntivo.
- Chiamate agli strumenti. Prenotazioni, ricerche e trasferimenti passano attraverso strumenti, e una chiamata sbagliata modifica un record reale. Lo studio tau-bench del 2024 ha rilevato che gli agenti basati su function calling costruiti su un importante modello generalista riuscivano in meno del 50% dei compiti di assistenza clienti, e superavano tutte e otto le prove ripetute di un compito retail meno del 25% delle volte.
- Parlato naturale. La risposta viene ascoltata, non letta. Elenchi e simboli che funzionano su uno schermo suonano sbagliati con una voce sintetica.
- Velocità. Tra un turno e l'altro le persone lasciano pause brevi. Una rassegna della ricerca sul turn-taking colloca la pausa tipica intorno ai 200 millisecondi. Il modello è uno degli stadi tra l'ultima parola di chi chiama e la prima dell'agente, quindi il tempo che impiega prima di iniziare una risposta si sente come silenzio.
- Costo su larga scala. A ogni turno lo script e la conversazione fino a quel momento vengono rinviati al modello. I provider scontano questo input ripetuto (la guida al prompt caching di OpenAI indica l'input in cache con uno sconto fino al 95%), ma con i volumi di un contact center una piccola differenza al minuto diventa una voce di budget.
Dove trovano spazio gli LLM generalisti in un contact center?
Gli LLM generalisti danno il meglio dove le chiamate variano: molti tipi di chiamata, molte lingue e domande che nessuno ha previsto nello script. Sono addestrati su un'ampia gamma di dati e venduti da diversi provider, quindi un team può cambiare modello man mano che le sue esigenze cambiano.
Richiedono anche meno lavoro personalizzato di quanto molti acquirenti pensino. La guida all'ottimizzazione dei modelli di OpenAI descrive un ciclo di valutazioni e prompt engineering, con il fine-tuning aggiunto «per alcuni casi d'uso». Gran parte di ciò che mantiene un agente sullo script risiede nel prompt, nel flusso di chiamata e negli strumenti, e questo lavoro resta valido quando il modello cambia.
I limiti emergono al telefono. Le modalità di ragionamento che pensano prima di rispondere aggiungono ritardo prima della prima parola. I modelli ottimizzati per la chat scritta hanno bisogno di prompt specifici per mantenere le risposte brevi e pronunciabili. E il calendario lo decide il provider: la policy di deprecazione di OpenAI garantisce almeno 6 mesi di preavviso prima di ritirare un modello disponibile al pubblico, e poi l'agente va verificato sul sostituto. Per un confronto modello per modello, leggi quale LLM dovrebbe alimentare il tuo agente vocale con IA.
Cosa cambia con un LLM specializzato o sottoposto a fine-tuning?
Un LLM specializzato sposta il comportamento dal prompt all'addestramento del modello. Invece di istruire un modello generalista a parlare in modo conciso, seguire le policy e chiamare gli strumenti al momento giusto, il fornitore lo addestra proprio su esempi di questo tipo, spesso partendo da un modello più piccolo. Tre termini vengono spesso confusi:
- Un LLM di dominio o verticale è addestrato o ottimizzato da un fornitore per un settore o una mansione specifici e offerto a tutti i suoi clienti.
- Un modello sottoposto a fine-tuning è un modello di base addestrato ulteriormente su un dataset più ristretto, spesso il tuo. La voce del glossario sul fine-tuning dei modelli di IA ne spiega il funzionamento.
- Un LLM personalizzato indica di solito qualsiasi modello che porti tu stesso su una piattaforma, ottimizzato o meno.
La guida all'accuratezza degli LLM di OpenAI indica due motivi per fare fine-tuning: migliorare l'accuratezza su un compito specifico e migliorare l'efficienza, cioè ottenere la stessa accuratezza con meno token o con un modello più piccolo. Nelle chiamate, questo può tradursi in un'aderenza allo script più costante, prompt più brevi e un costo al minuto inferiore.
L'idea non è nuova. Observe.AI ha annunciato un Contact Center LLM nel giugno 2023, che descrive come un modello da 30 miliardi di parametri addestrato su un dataset di dominio composto da centinaia di milioni di interazioni con i clienti. I miglioramenti di accuratezza riportati nell'annuncio provengono dai benchmark iniziali del fornitore stesso. È normale per la categoria, ed è per questo che la tua valutazione conta più di qualsiasi annuncio.
Quali sono i compromessi tra i due?
I compromessi riguardano il lock-in, la copertura e l'onere di valutazione, e ognuno vale in entrambe le direzioni.
| Fattore | LLM generalista | LLM specializzato o sottoposto a fine-tuning |
|---|---|---|
| Ideale per | Tipi di chiamata vari, molte lingue, domande fuori script | Un solo tipo di chiamata ad alto volume con regole stabili |
| Comportamento su script e strumenti | Definito dal prompt e dal flusso di chiamata | Integrato con l'addestramento, quindi serve meno prompt |
| Velocità e costo al minuto | Dipende dalle dimensioni del modello e dalla modalità di ragionamento | Può essere inferiore se il modello è più piccolo |
| Lock-in | Diversi provider, ognuno ritira i modelli secondo il proprio calendario | Spesso un solo fornitore o una sola piattaforma |
| Copertura | Ampia | Più ristretta al di fuori dei dati di addestramento |
| Evidenze disponibili | Benchmark pubblici, pochi dei quali sulle telefonate | Spesso il benchmark del fornitore stesso |
| Onere di valutazione | Una nuova verifica ogni volta che un modello viene ritirato | Una verifica prima dell'adozione e dopo ogni nuovo addestramento |
Lock-in. Un modello specializzato è spesso venduto da un solo fornitore, a volte all'interno di una sola piattaforma. Chiedi se puoi cambiare modello senza ricostruire l'agente e se prompt, flussi e casi di test restano tuoi. I modelli generalisti comportano una versione più discreta dello stesso rischio quando un provider ritira una versione.
Copertura. Un modello addestrato su chiamate in inglese per appuntamenti può essere più debole in spagnolo, o su una contestazione di fattura che non ha mai visto. Chiedi risultati per lingua e per tipo di chiamata, non una media.
Onere di valutazione. I benchmark pubblici misurano raramente le telefonate, e un benchmark del fornitore è un'evidenza scelta da chi vende. Se fai il fine-tuning di un tuo modello, l'onere cresce. La guida all'accuratezza di OpenAI afferma che gli esempi di addestramento «devono rappresentare esattamente ciò che il modello vedrà nel mondo reale» e consiglia un set di hold-out per rilevare l'overfitting.
Come valuti entrambi i modelli sulle tue chiamate?
Valutali entrambi allo stesso modo: scenari fissi tratti dalle tue chiamate, valutati in base a criteri di superamento scritti, eseguiti più volte, e poi una suddivisione del traffico reale.
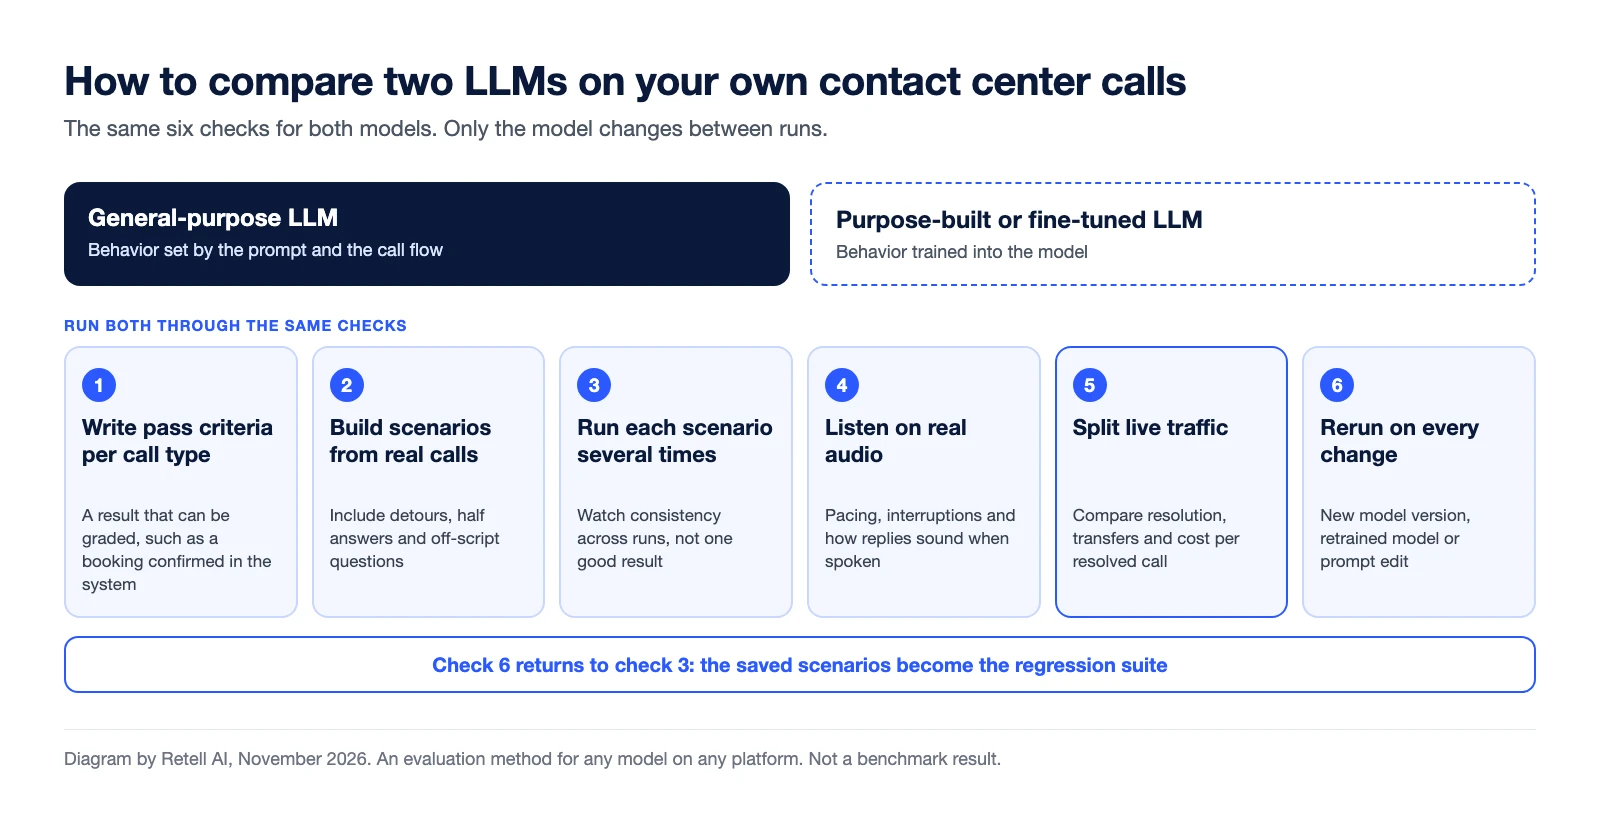
- Scrivi i criteri di superamento per tipo di chiamata. «Appuntamento prenotato nel sistema di pianificazione e confermato a chi chiama» si può valutare. «Suonava bene» no.
- Crea scenari da chiamate reali. Includi le deviazioni: chi chiama e cambia idea, fa una domanda fuori script o dà una risposta a metà.
- Esegui ogni scenario più volte su ciascun modello. Gli autori di tau-bench hanno proposto una metrica pass^k per misurare l'affidabilità su prove ripetute.
- Ascolta l'audio reale. I risultati testuali non colgono il ritmo, le interruzioni e il modo in cui una risposta suona quando viene pronunciata.
- Suddividi il traffico reale. Invia una quota di chiamate a ciascuna opzione e confronta risoluzione, trasferimenti e costo per chiamata risolta.
- Ripeti a ogni modifica. Una nuova versione del modello, un modello riaddestrato e una modifica al prompt richiedono tutti la stessa suite.
Su Retell, i test di simulazione valutano ogni esecuzione come superata o non superata in base a criteri di successo, i test in batch rieseguono i casi salvati come suite di regressione e l'A/B testing suddivide il traffico delle chiamate tra gli agenti in percentuale. La documentazione indica che puoi cambiare modello in seguito senza riscrivere il prompt. Se porti il tuo modello, i test di simulazione e i test in batch non si applicano, e per verificarlo devi usare chiamate web e telefoniche. Per il pilota più ampio, leggi come valutare una piattaforma di agenti vocali con IA prima di andare in produzione.
Dove si colloca Tell-1 in questo confronto?
Tell-1, l'LLM di Retell, è un modello specializzato per le chiamate dei contact center, quindi tutti i compromessi di questa guida valgono anche per lui. Ecco come si posiziona su ciascuno, con la fonte di ogni numero.
- Script, strumenti e parlato. Nel Retell vCX Benchmark, Tell-1 ottiene una media di 94,45 ed è al primo posto nella classifica generale. Per suite, ottiene l'88,6% nell'instruction following (2° posto), il 97,2% nel grounding (2° posto), il 95,4% nel tool calling (5° posto) e il 96,6% nel parlato colloquiale (1° posto), tutti dati consultati il 13 novembre 2026. Il benchmark è gestito da Retell, quindi usalo come suggerisce questa guida: come motivo per inserirlo nella rosa dei candidati.
- Velocità. Ha la latenza mediana più bassa della classifica, 76 ms (consultata il 13 novembre 2026). È il dato del modello nel benchmark, non il tempo di risposta end-to-end di una chiamata.
- Costo. Il benchmark lo indica a 3,5 centesimi al minuto. È solo la voce relativa all'LLM, non il prezzo di una chiamata, e alcune configurazioni generaliste in classifica costano meno. I prezzi di Retell partono da 0,07 $ al minuto.
- Come funziona. Il modello inizia la risposta e continua a ragionare mentre vengono riprodotte le prime parole. Il post tecnico, Retell LLM: Interleaved Reasoning for Real-Time Voice Agents, riporta in media circa 200 token di ragionamento a metà risposta e descrive le tre fasi di addestramento alla base.
- Lock-in. Tell-1 è offerto all'interno di Retell. Si trova nello stesso selettore dei modelli di OpenAI, Anthropic e Google, e la documentazione di Retell indica che puoi cambiare modello in seguito senza riscrivere il prompt, quindi sceglierlo non preclude le altre opzioni.
- Copertura. Un modello creato per le chiamate è, per natura, più ristretto. Prova Tell-1 sulle tue lingue e sui tuoi tipi di chiamata prima di affidarti a lui, e mantieni un modello generalista per qualsiasi tipo di chiamata in cui si classifica secondo.
- Valutazione. I sei controlli descritti sopra si applicano senza modifiche. Poiché Tell-1 è un modello gestito da Retell, i test di simulazione e i test in batch funzionano con lui, e una suddivisione A/B può inviare lo stesso traffico a due copie di un agente che differiscono solo per il modello.
In sintesi, in modo equo: se usi Retell, Tell-1 è l'opzione specializzata da inserire nella tua rosa di candidati, e i modelli generalisti accanto a lui fungono da gruppo di controllo. Consulta Tell-1 per i dettagli del prodotto.
Domande frequenti
Che cos'è un LLM specializzato?
Un LLM specializzato è un modello linguistico addestrato o ottimizzato per un compito specifico, come gestire le chiamate dei contact center, anziché per un uso generico. Viene chiamato anche LLM di dominio o verticale. Un modello linguistico di grandi dimensioni generalista viene invece adattato al compito tramite prompt e strumenti.
Gli LLM specializzati sono più accurati di quelli generalisti?
Nel compito per cui sono stati addestrati, possono esserlo. Al di fuori di esso, spesso no. La maggior parte dei confronti pubblicati proviene dal fornitore che ha creato il modello, quindi provali entrambi sui tuoi scenari.
Un contact center deve addestrare un proprio LLM?
Di solito no. La guida all'ottimizzazione di OpenAI parte dalle valutazioni e dal prompt engineering e aggiunge il fine-tuning solo per alcuni casi d'uso. Addestrare un proprio modello significa anche gestire i dati di addestramento e un set di hold-out.
Un LLM personalizzato è la stessa cosa di un modello sottoposto a fine-tuning?
Non sempre. Sulla maggior parte delle piattaforme vocali, un LLM personalizzato è qualsiasi modello che ospiti e colleghi tu stesso, che può essere o meno sottoposto a fine-tuning. L'opzione LLM personalizzato di Retell collega il tuo modello tramite WebSocket, mentre Retell gestisce telefonia, trascrizione e turn-taking.
Un contact center può usare più di un LLM?
Sì. Su Retell ogni agente ha la propria impostazione del modello, e la documentazione sulle impostazioni LLM descrive un fallback rapido che esegue un modello di backup insieme a quello principale.
Tell-1 è un LLM specializzato?
Sì. Tell-1 è l'LLM di Retell, creato per le chiamate dei contact center. È al primo posto nella classifica generale del Retell vCX Benchmark con una media di 94,45 (consultato il 13 novembre 2026). È una delle opzioni del selettore di modelli di Retell, accanto ai modelli generalisti di OpenAI, Anthropic e Google.
Confronta i modelli sulle tue chiamate prima di impegnarti
Retell è una piattaforma di agenti vocali con IA per i contact center. Ogni agente ha un selettore di modelli, e la pagina dei prezzi elenca i modelli di OpenAI, Anthropic e Google insieme a un'opzione personalizzata per un modello ospitato da te. Tell-1, l'LLM di Retell, si trova nello stesso selettore. Le persone più vicine ai tuoi clienti possono cambiare il modello, rieseguire la suite di test e suddividere il traffico in autonomia. A differenza di quando lavori con un fornitore di IA gestita, questa modifica non diventa un ticket, una coda o un altro SOW. I prezzi sono a consumo, a partire da 0,07 $ al minuto, come indicato nella pagina dei prezzi. Porta un tipo di chiamata e i tuoi criteri di superamento, ed esegui un pilota su chiamate reali prima di firmare qualsiasi cosa.
See how much your business could save by switching to AI-powered voice agents.
ROI Result
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Estimate your monthly voice AI cost
Read Other Blogs


Rivoluziona le tue operazioni di chiamata con Retell


