Benchmark degli agenti IA spiegati per gli agenti vocali





Un benchmark per agenti IA è un insieme fisso di task con una regola di punteggio, usato per confrontare i modelli sullo stesso lavoro. Per gli agenti vocali con IA, ce ne sono quattro da conoscere: τ²-bench (tau2-bench) per l'uso di strumenti nel rispetto di una policy, Multi-IF per il rispetto delle istruzioni su più turni, GPQA Diamond per il ragionamento complesso e il Retell vCX Benchmark per le chiamate da contact center. Ognuno misura una sola parte di ciò che accade durante una telefonata.
Questa guida spiega cosa testa ciascun benchmark, come viene assegnato il punteggio e cosa il punteggio non ti dice. Retell AI pubblica questa guida e pubblica anche uno dei quattro benchmark, il vCX Benchmark. I punteggi cambiano a ogni nuovo rilascio di modello, quindi ogni sezione rimanda alla fonte che riporta i risultati aggiornati.
Che cos'è un benchmark per agenti IA?
Un benchmark per agenti IA assegna a ogni modello gli stessi task e lo stesso valutatore, poi riporta quanto spesso il modello svolge correttamente il task. Il significato di un punteggio dipende dal task, da chi o cosa interpreta l'altra parte della conversazione e da come si stabilisce che un task è superato.
I valutatori sono di tre tipi. Un controllo dello stato confronta il risultato delle azioni dell'agente con un risultato corretto noto, come un database dopo un rimborso. Un controllo basato su regole esegue uno script sulla risposta. Un modello giudice valuta la risposta in base a una rubrica. I controlli dello stato e quelli basati su regole sono ripetibili ma limitati. I modelli giudice possono valutare tono e significato, ma hanno i propri punti ciechi.
Cosa misurano i quattro benchmark, a confronto?
Coprono competenze diverse e solo il vCX Benchmark è costruito a partire da telefonate. La tabella riassume ciascuno di essi sulla base del relativo paper, repository o leaderboard, consultati il 13 novembre 2026.
| Benchmark | Pubblicato da | In cosa consiste il task | Come viene assegnato il punteggio | Cosa tralascia per chi acquista agenti vocali |
|---|---|---|---|---|
| τ²-bench, airline e retail | Sierra | Servire un cliente simulato in una conversazione testuale, usando strumenti e seguendo una policy scritta | 0 o 1 per conversazione: il database finale deve corrispondere allo stato target e le informazioni richieste devono essere fornite | Audio, tempi di risposta, la tua policy e i tuoi strumenti |
| Multi-IF | Meta | Seguire istruzioni di scrittura verificabili per tre turni, in otto lingue | Media di quattro valori di accuratezza, per istruzione e per conversazione, con criterio rigoroso e flessibile | Strumenti, script lunghi, resa parlata |
| GPQA Diamond | Ricercatori di NYU, Cohere e Anthropic | Rispondere a 198 domande scientifiche a scelta multipla scritte da esperti | Percentuale di domande con risposta corretta, con il 25% come soglia casuale | Conversazione, strumenti, istruzioni, velocità |
| Retell vCX Benchmark | Retell AI | Gestire turni di chiamate da contact center in quattro suite | Tasso di superamento per suite, mediato in un unico punteggio | Audio, le tue tipologie di chiamata, risultati su una chiamata completa |
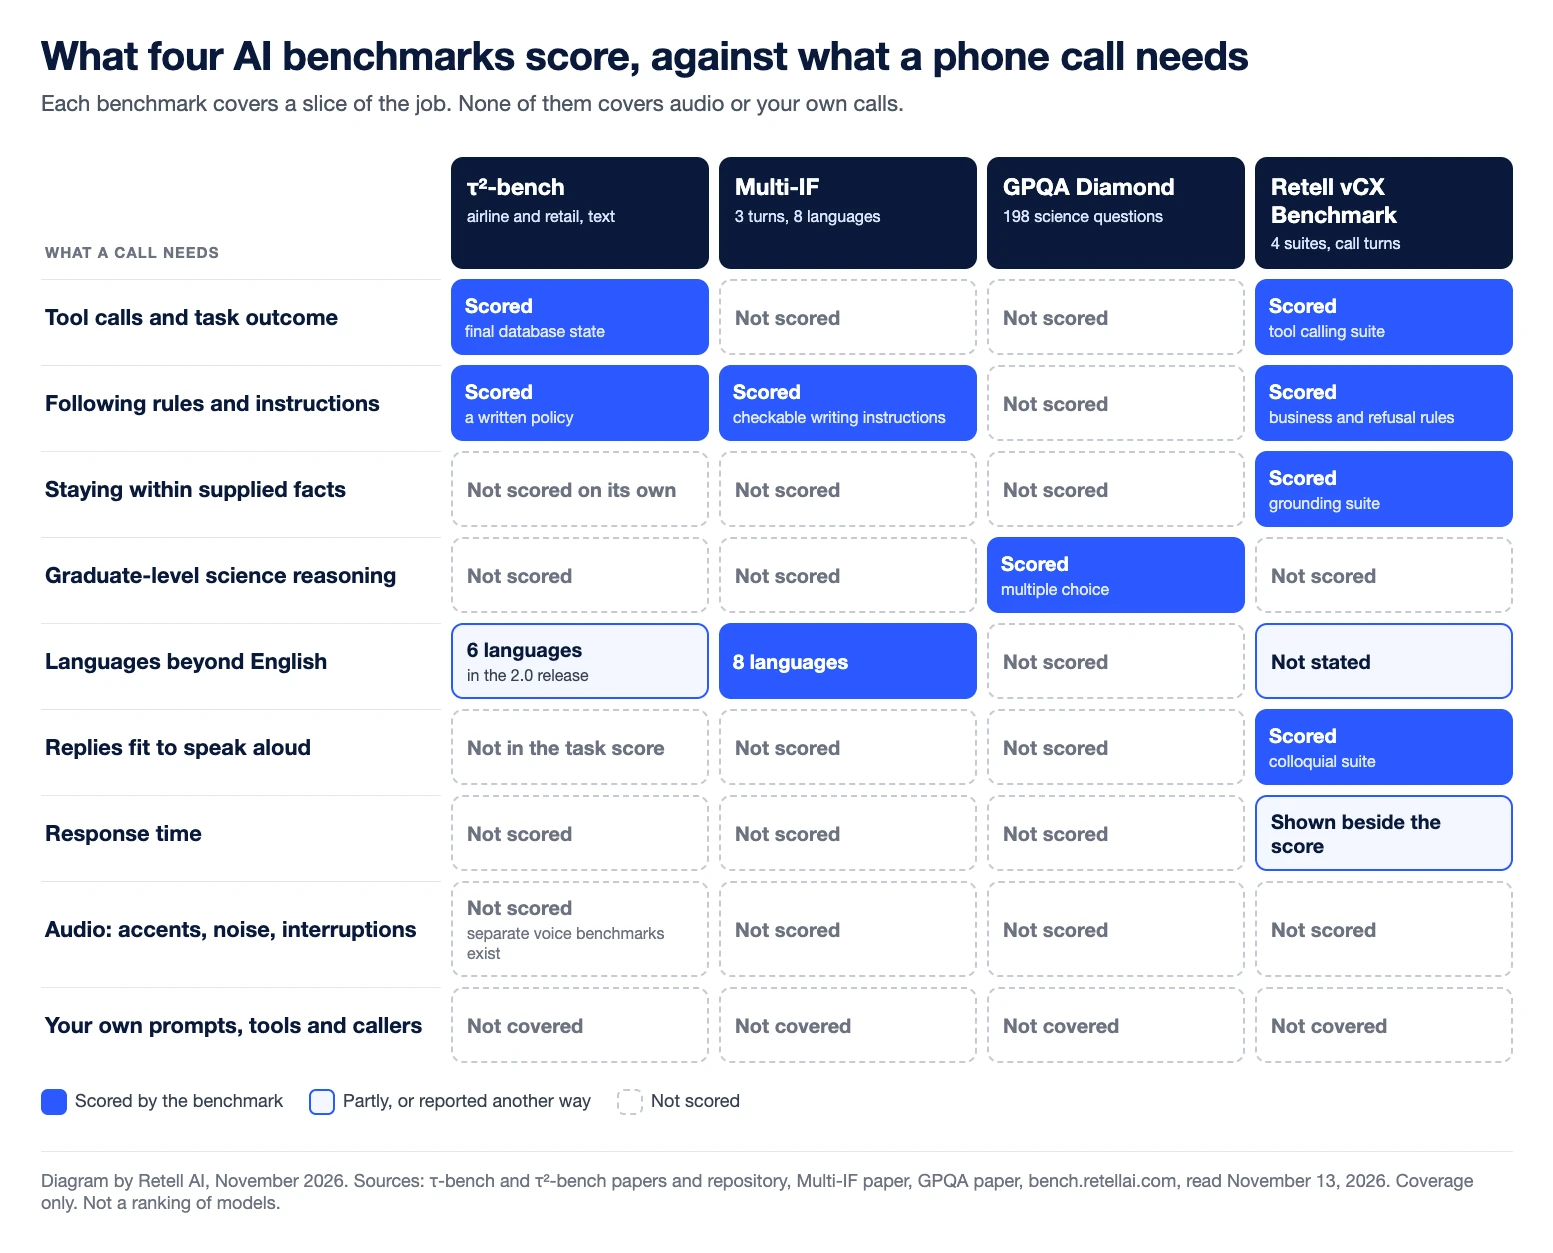
Cosa misura τ²-bench nei domini airline e retail?
τ²-bench misura se un agente riesce a portare a termine un task di assistenza clienti tramite conversazione, seguendo una policy scritta e chiamando gli strumenti giusti. Un modello linguistico interpreta il cliente e l'agente lavora su un database fittizio di ordini o prenotazioni. Il paper originale di τ-bench ha costruito i due domini con 115 task retail e 50 task airline. Il paper di τ²-bench riutilizza versioni verificate di entrambi e aggiunge un dominio telecom.
Il punteggio è rigoroso. Secondo le note di valutazione nel repository, la ricompensa di ogni task è il prodotto dei suoi controlli. Di default si tratta di un controllo del database, che confronta il database finale con lo stato target, e di un controllo della comunicazione, che conferma che l'agente abbia fornito al cliente le informazioni richieste. Qualsiasi sequenza di chiamate agli strumenti che raggiunga lo stato finale corretto supera il test.
Contano due valori riportati. Pass^1 è la percentuale di task risolti in un solo tentativo. Pass^k è la percentuale di task risolti in tutti i k tentativi ripetuti, una metrica introdotta dal paper originale per misurare la coerenza. Quel paper del 2024 riportava che anche i migliori agenti con function calling dell'epoca riuscivano in meno della metà dei task, con pass^8 sotto il 25% nel retail.
Cosa non dice a chi acquista agenti vocali: i punteggi testuali airline e retail derivano da conversazioni scritte, senza audio, senza interruzioni e senza vincoli di tempo. Policy e strumenti sono quelli del benchmark. Anche il cliente simulato è un modello e gli autori di τ²-bench hanno misurato tassi di errore del simulatore del 40% nel retail e del 47% nell'airline, di cui il 12% e il 13% abbastanza gravi da bloccare il task. Lo stesso repository ora include benchmark vocali separati e la sua release 2.0 aggiunge sei lingue e specifica che i suoi punteggi non sono confrontabili con la leaderboard 1.x. Verifica sempre da quale versione proviene un punteggio citato.
Cosa misura Multi-IF?
Multi-IF misura se un modello continua a seguire le istruzioni man mano che la conversazione procede e se ciò vale anche al di fuori dell'inglese. Il paper di Multi-IF di Meta estende un precedente test a turno singolo, IFEval, in 4.501 conversazioni di tre turni ciascuna in otto lingue: inglese, francese, russo, hindi, italiano, portoghese, spagnolo e cinese.
Le istruzioni sono scritte in modo da poter essere verificate, come il divieto di usare virgole o la regola di rispondere in maiuscolo. Il punteggio principale è la media di quattro valori di accuratezza. L'accuratezza a livello di istruzione conta ogni istruzione singolarmente. L'accuratezza a livello di conversazione conta una conversazione solo se ogni istruzione fino a quel turno è stata rispettata. Ciascuna viene riportata secondo un criterio rigoroso e uno flessibile.
La conclusione principale del paper è il motivo per cui questo benchmark conta per gli agenti telefonici: ciascuno dei 14 modelli testati ha sbagliato più spesso a ogni turno aggiunto. Un modello è sceso da 0,877 al primo turno a 0,707 al terzo. Un agente che rispetta una regola all'inizio di una chiamata e la abbandona qualche scambio dopo fallisce nello stesso modo.
Cosa non dice a chi acquista agenti vocali: le istruzioni sono vincoli di formattazione e di scrittura sul testo, come lunghezza, punteggiatura e parole chiave. Non sono regole di business. Non ci sono strumenti, tre turni sono pochi rispetto a una chiamata reale e nulla viene pronunciato ad alta voce.
Cosa misura GPQA Diamond?
GPQA Diamond misura se un modello sa rispondere a domande scientifiche molto difficili che una ricerca sul web non risolve. Il paper di GPQA descrive 448 domande a scelta multipla di biologia, fisica e chimica, scritte e validate da persone che hanno o stanno conseguendo un dottorato. Diamond è il sottoinsieme di 198 domande a cui entrambi i validatori esperti hanno risposto correttamente e la maggior parte dei non esperti no.
Il punteggio è la semplice accuratezza. Ogni domanda ha quattro opzioni, quindi tirando a indovinare si ottiene il 25%. Sull'insieme completo, gli esperti hanno raggiunto il 65% e i non esperti qualificati con accesso illimitato al web il 34%.
Cosa non dice a chi acquista agenti vocali: quasi tutto ciò che riguarda una chiamata. Non c'è conversazione, né istruzioni da seguire, né strumenti, né limiti di tempo. È un indicatore indiretto della profondità di ragionamento. Con 198 domande, anche le piccole differenze tra modelli sono prove deboli e gli autori indicano la ridotta dimensione del dataset come un limite.
Cosa misura il Retell vCX Benchmark?
Il Retell vCX Benchmark misura come i modelli gestiscono i turni delle chiamate da contact center in quattro suite. La leaderboard in tempo reale, consultata il 13 novembre 2026, le descrive così:
- Rispetto delle istruzioni: se il modello rispetta i vincoli di ruolo, le regole di business e le regole di rifiuto.
- Grounding: se le risposte restano entro il prompt, gli strumenti e il contesto recuperato.
- Chiamata agli strumenti: se il modello sceglie l'azione giusta e passa argomenti validi.
- Colloquialità: se le risposte suonano naturali, concise e sicure da pronunciare ad alta voce.
Ogni suite riporta un tasso di superamento su circa 1.000 casi o più e il punteggio complessivo è la media dei quattro. In quella data la leaderboard elencava 62 voci relative a 45 modelli e mostra latenza mediana e costo al minuto accanto a ciascun punteggio.
La nota metodologica pubblicata è il post su vCX-Hard, che copre i primi due set di test, grounding e chiamata agli strumenti. I casi sono stati estratti da chiamate in produzione, campionate tra diverse organizzazioni in modo che nessun singolo cliente prevalga. Un panel di modelli giudice valuta ogni caso in base a una rubrica e a una soluzione di riferimento. Quel post considera il segnale più nella classifica che nel numero esatto.
Cosa non dice a chi acquista agenti vocali: è un benchmark di un fornitore e il fornitore vi partecipa. Tell-1, il modello di Retell, è al n. 1 assoluto nel Retell vCX Benchmark (a novembre 2026). I casi provengono dal traffico di Retell, quindi le tue tipologie di chiamata potrebbero essere poco rappresentate o assenti. Le quattro suite valutano risposte e chiamate agli strumenti, quindi errori di riconoscimento vocale, interruzioni e l'effettiva risoluzione di un'intera chiamata restano esclusi. Anche i modelli giudice possono sbagliare.
Che punteggi ottiene Tell-1 su questi quattro benchmark?
Tell-1, l'LLM di Retell, è un esempio concreto di come leggere i quattro benchmark insieme. Retell riporta i punteggi dei benchmark pubblici qui sotto nel suo post tecnico su Retell LLM, mentre i valori vCX provengono dalla leaderboard in tempo reale, consultata il 13 novembre 2026.
| Benchmark | Punteggio di Tell-1 | Dimensione del test | Chi l'ha eseguito |
|---|---|---|---|
| τ²-bench airline | 72,0 | 50 task | Retell |
| τ²-bench retail | 78,0 | 50 task | Retell |
| Multi-IF | 82,1 | 504 conversazioni | Retell |
| GPQA Diamond | 83,5 | 198 domande × 3 | Retell |
| Retell vCX Benchmark | Media di 94,45, n. 1 assoluto su 62 configurazioni di modelli | Quattro suite, circa 1.000 casi ciascuna | Retell |
Leggili come suggeriscono le sezioni precedenti. Ogni riga è un test eseguito da Retell, con punteggio su 100 e la stessa decodifica greedy ogni volta, e Retell afferma che nessuno dei benchmark è stato usato per l'addestramento. Il test su Multi-IF copre 504 delle 4.501 conversazioni del benchmark e quelli su τ²-bench coprono 50 task per dominio, quindi non sono direttamente confrontabili con i valori dei paper originali o di altre leaderboard.
Su vCX i punteggi delle suite variano: 96,6% in colloquialità (posizione 1), 97,2% nel grounding (posizione 2), 88,6% nel rispetto delle istruzioni (posizione 2) e 95,4% nella chiamata agli strumenti (posizione 5). Altri modelli sono in testa in tre delle quattro suite. Vale la stessa cautela che per qualsiasi modello: questi numeri valgono a Tell-1 un posto in una shortlist, ma è una prova sulle tue chiamate a decidere il resto.
Cosa tralasciano i punteggi dei benchmark per chi acquista un agente vocale con IA?
I punteggi dei benchmark tralasciano la piattaforma intorno al modello e le condizioni delle tue chiamate. Una telefonata aggiunge riconoscimento vocale, gestione dei turni, sintesi vocale, telefonia e latenza in ogni fase. Nessuno dei quattro benchmark, nella forma descritta qui, li valuta.
I risultati possono variare in base alla piattaforma anche quando l'agente è identico. In uno studio del fornitore di soluzioni di test Cekura, un agente è stato distribuito senza modifiche su sei piattaforme vocali e i punteggi dei workflow andavano dal 65,2% al 95,7%. Il riepilogo di Retell di quello studio su Medicare illustra il metodo e la relativa dichiarazione di trasparenza.
Come dovresti usare i punteggi dei benchmark?
Usa i punteggi dei benchmark per creare una shortlist, poi decidi in base alle tue chiamate. Un ordine sensato:
- Abbina il benchmark al rischio: risultati sull'uso degli strumenti se un'azione sbagliata è l'errore più costoso, rispetto delle istruzioni se l'agente deve seguire uno script lungo.
- Verifica la versione, la data e chi ha eseguito il test.
- Preferisci i valori basati su prove ripetute, come pass^k, quando sono riportati.
- Ricostruisci il test sui tuoi scenari e considera uno scenario superato solo quando tutte le esecuzioni ripetute vanno a buon fine.
Su Retell, il test di simulazione fa interpretare il chiamante a un'IA mentre i criteri di successo valutano ogni esecuzione come superata o non superata, e i test in batch rieseguono i casi salvati dopo ogni modifica del prompt. Dopo il lancio, AI QA valuta un campione di chiamate reali su parametri come allucinazioni e uso degli strumenti, e l'A/B testing divide il traffico reale tra due agenti. Per la scelta del modello, scopri quale LLM scegliere per il tuo agente vocale con IA. Per il processo di acquisto, scopri come valutare una piattaforma di agenti vocali con IA.
Un benchmark ti dice quali modelli meritano una prova. Un progetto pilota su chiamate reali ti dice quale usare. Retell è una piattaforma di agenti vocali con IA per i contact center, con prezzi a partire da 0,07 $ al minuto, così puoi metterla alla prova sulle tue chiamate prima di firmare qualsiasi cosa.
Domande frequenti
Qual è la differenza tra pass^1 e pass^k?
Pass^1 è la percentuale di task che un agente risolve in un solo tentativo. Pass^k è la percentuale che risolve in ciascuno dei k tentativi ripetuti sullo stesso task. Pass^k è sempre uguale o inferiore a pass^1 e la differenza mostra quanto è coerente l'agente.
τ-bench è uguale a τ²-bench?
No. τ-bench è il benchmark originale del 2024 con i domini airline e retail. τ²-bench è il seguito del 2025 dello stesso gruppo, che mantiene versioni verificate di quei due domini e aggiunge un dominio telecom in cui anche il cliente simulato usa strumenti.
Perché un test scientifico come GPQA Diamond viene usato per confrontare modelli destinati alle conversazioni con i clienti?
GPQA Diamond viene usato come misura generale della capacità di ragionamento. Non dice nulla di diretto su conversazioni, strumenti o voce. Consideralo una verifica della profondità di ragionamento e affidati ai benchmark basati su task per il resto.
Quale benchmark conta di più per un agente vocale con IA?
Nessuno, da solo. L'uso di strumenti nel rispetto di una policy, il rispetto delle istruzioni su più turni e il grounding sono gli aspetti più vicini al lavoro di un contact center, quindi τ²-bench, Multi-IF e il vCX Benchmark sono i più pertinenti. Un test valutato sui tuoi scenari di chiamata conta più di ognuno di essi.
Che punteggi ha ottenuto Tell-1 su τ²-bench, Multi-IF e GPQA Diamond?
Retell riporta per Tell-1 72,0 su τ²-bench airline, 78,0 su τ²-bench retail, 82,1 su Multi-IF e 83,5 su GPQA Diamond, ciascuno su 100. Si tratta di test eseguiti da Retell su 50 task per dominio di τ²-bench, 504 conversazioni di Multi-IF e le 198 domande di GPQA Diamond.
See how much your business could save by switching to AI-powered voice agents.
ROI Result
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Estimate your monthly voice AI cost
Read Other Blogs


Rivoluziona le tue operazioni di chiamata con Retell


