Gespecialiseerde vs algemene LLM's voor contactcenters





Een algemene LLM is voor de meeste contactcenters het veiligere startpunt. Een gespecialiseerde LLM verdient zijn plek wanneer één gesprekstype in hoog volume loopt en een algemeen model steeds op dezelfde meetbare manier tekortschiet: trage eerste woorden, verkeerde toolaanroepen of antwoorden die klinken als een voorgelezen webpagina. Geen van beide wint per categorie. Het model dat je kiest, is het model dat slaagt op je eigen gesprekken, run na run, tegen kosten per minuut die je kunt voorspellen.
Deze gids is bedoeld voor de leidinggevende die verantwoordelijk is voor de telefoonlijn. Retell AI publiceert deze gids en heeft belang aan beide kanten. Het platform biedt algemene modellen van OpenAI, Anthropic en Google, en Retell bouwt ook een eigen model: Tell-1, de eigen LLM van Retell, gemaakt voor contactcentergesprekken. Tell-1 staat overall op #1 in de openbare benchmark van Retell, de Retell vCX Benchmark (geraadpleegd op 13 november 2026). Behandel die zoals elke benchmark van een leverancier: een reden om het model op je shortlist te zetten, en daarna iets om te controleren op je eigen gesprekken.
Wat vraagt een contactcentergesprek van een taalmodel?
Een contactcentergesprek vraagt bij elke beurt vijf dingen van een model: een lang script volgen, tools correct aanroepen, natuurlijk klinken wanneer het wordt uitgesproken, snel antwoorden en betaalbaar blijven bij grote volumes.
- Lange scripts. De prompt van de agent bevat de stappen, het beleid en de uitzonderingen voor een gesprekstype, en het model moet bij elke beurt de juiste regel toepassen. In de Multi-IF-benchmark faalden alle 14 geëvalueerde modellen op meer instructies met elke extra beurt.
- Toolaanroepen. Boekingen, opzoekingen en doorverbindingen lopen via tools, en een verkeerde aanroep wijzigt een echt record. Volgens het tau-bench-paper uit 2024 slaagden agents met function calling, gebouwd op een toonaangevend algemeen model, in minder dan 50% van de klantenservicetaken, en doorstonden ze minder dan 25% van de tijd alle acht herhaalde pogingen van een retailtaak.
- Natuurlijke spraak. Het antwoord wordt gehoord, niet gelezen. Lijsten en symbolen die op een scherm werken, klinken verkeerd in een synthetische stem.
- Snelheid. Mensen laten korte pauzes tussen beurten. Een overzicht van onderzoek naar beurtwisseling stelt de gebruikelijke pauze op ongeveer 200 milliseconden. Het model is één schakel tussen het laatste woord van de beller en het eerste woord van de agent, dus de tijd die het nodig heeft voordat het aan een antwoord begint, wordt als stilte gehoord.
- Kosten bij volume. Bij elke beurt gaan het script en het gesprek tot dan toe opnieuw naar het model. Providers geven korting op die herhaalde input (de prompt caching-gids van OpenAI vermeldt tot 95% korting op gecachete input), maar bij contactcentervolumes wordt een klein verschil per minuut een begrotingspost.
Waar passen algemene LLM's in een contactcenter?
Algemene LLM's passen het best waar gesprekken variëren: veel gesprekstypen, veel talen en vragen die niemand heeft gescript. Ze zijn breed getraind en worden door meerdere providers aangeboden, zodat een team van model kan wisselen als de behoeften veranderen.
Ze vragen ook minder maatwerk dan veel kopers denken. De gids voor modeloptimalisatie van OpenAI beschrijft een cyclus van evals en prompt engineering, met fine-tuning erbij "voor sommige use cases". Veel van wat een agent bij het script houdt, zit in de prompt, de gespreksflow en de tools, en dat werk neem je mee als het model verandert.
De beperkingen worden zichtbaar aan de telefoon. Redeneermodi die nadenken voordat ze antwoorden, zorgen voor vertraging vóór het eerste woord. Modellen die zijn afgestemd op geschreven chat, hebben prompting nodig om antwoorden kort en uitspreekbaar te houden. En de provider bepaalt de planning: het deprecation-beleid van OpenAI geeft minstens 6 maanden van tevoren bericht voordat een algemeen beschikbaar model wordt uitgefaseerd, en daarna moet de agent op de vervanger worden gecontroleerd. Voor een overzicht per model, zie welke LLM je AI-stemagent moet aandrijven.
Wat verandert een gespecialiseerde of gefinetunede LLM?
Een gespecialiseerde LLM verplaatst gedrag van de prompt naar de training van het model. In plaats van een algemeen model te instrueren om kort te spreken, beleid te volgen en op het juiste moment tools aan te roepen, traint de leverancier op voorbeelden van precies dat, vaak op een kleiner model. Drie begrippen worden vaak door elkaar gehaald:
- Een domeinspecifieke of verticale LLM wordt door een leverancier getraind of afgestemd op één branche of taak en aan al zijn klanten aangeboden.
- Een gefinetuned model is een basismodel dat verder is getraind op een smallere dataset, vaak die van jezelf. De woordenlijstpagina over fine-tuning van AI-modellen legt uit hoe dat werkt.
- Een custom LLM is meestal elk model dat je zelf naar een platform meebrengt, al dan niet gefinetuned.
De gids over LLM-nauwkeurigheid van OpenAI noemt twee redenen om te finetunen: de nauwkeurigheid op een specifieke taak verbeteren en de efficiëntie verbeteren, oftewel dezelfde nauwkeurigheid met minder tokens of met een kleiner model. Bij gesprekken kan dat stabielere scriptopvolging, kortere prompts en lagere kosten per minuut betekenen.
Het idee is niet nieuw. Observe.AI kondigde in juni 2023 een Contact Center LLM aan, dat het omschrijft als een model met 30 miljard parameters, getraind op een domeinspecifieke dataset van honderden miljoenen klantinteracties. De nauwkeurigheidswinst in die aankondiging komt uit de eigen eerste benchmarks van de leverancier. Dat is normaal in deze categorie, en precies daarom telt je eigen evaluatie zwaarder dan welke aankondiging ook.
Wat zijn de afwegingen tussen de twee?
De afwegingen zijn lock-in, dekking en evaluatielast, en elk ervan werkt in beide richtingen.
| Factor | Algemene LLM | Gespecialiseerde of gefinetunede LLM |
|---|---|---|
| Beste toepassing | Gevarieerde gesprekstypen, veel talen, ongescripte vragen | Eén gesprekstype met hoog volume en stabiele regels |
| Script- en toolgedrag | Bepaald door de prompt en de gespreksflow | Ingetraind, dus er is minder prompt nodig |
| Snelheid en kosten per minuut | Afhankelijk van modelgrootte en redeneermodus | Kan lager zijn als het model kleiner is |
| Lock-in | Meerdere providers, die elk modellen volgens hun eigen planning uitfaseren | Vaak één leverancier of één platform |
| Dekking | Breed | Smaller buiten de trainingsdata |
| Beschikbaar bewijs | Openbare benchmarks, waarvan weinig op telefoongesprekken | Vaak de eigen benchmark van de leverancier |
| Evaluatielast | Een hercontrole telkens wanneer een model wordt uitgefaseerd | Een controle vóór ingebruikname en na elke hertraining |
Lock-in. Een gespecialiseerd model wordt vaak door één leverancier verkocht, soms binnen één platform. Vraag of je van model kunt wisselen zonder de agent opnieuw te bouwen, en of de prompts, flows en testcases van jou blijven. Algemene modellen dragen een stillere versie van hetzelfde risico wanneer een provider een versie uitfaseert.
Dekking. Een model dat is getraind op Engelstalige afspraakgesprekken, kan zwakker zijn in het Spaans, of bij een factuurgeschil dat het nooit heeft gezien. Vraag om resultaten per taal en per gesprekstype, niet om een gemiddelde.
Evaluatielast. Openbare benchmarks meten zelden telefoongesprekken, en een benchmark van een leverancier is bewijs dat door de verkoper is gekozen. Als je je eigen model finetunet, wordt de last groter. Volgens de nauwkeurigheidsgids van OpenAI moeten trainingsvoorbeelden "exact weergeven wat het model in de echte wereld zal zien", en de gids raadt een hold-outset aan om overfitting op te sporen.
Hoe evalueer je beide modellen op je eigen gesprekken?
Evalueer beide op dezelfde manier: vaste scenario's uit je eigen gesprekken, beoordeeld aan de hand van vastgelegde slaagcriteria, meer dan eens uitgevoerd, en daarna een verdeling van live verkeer.
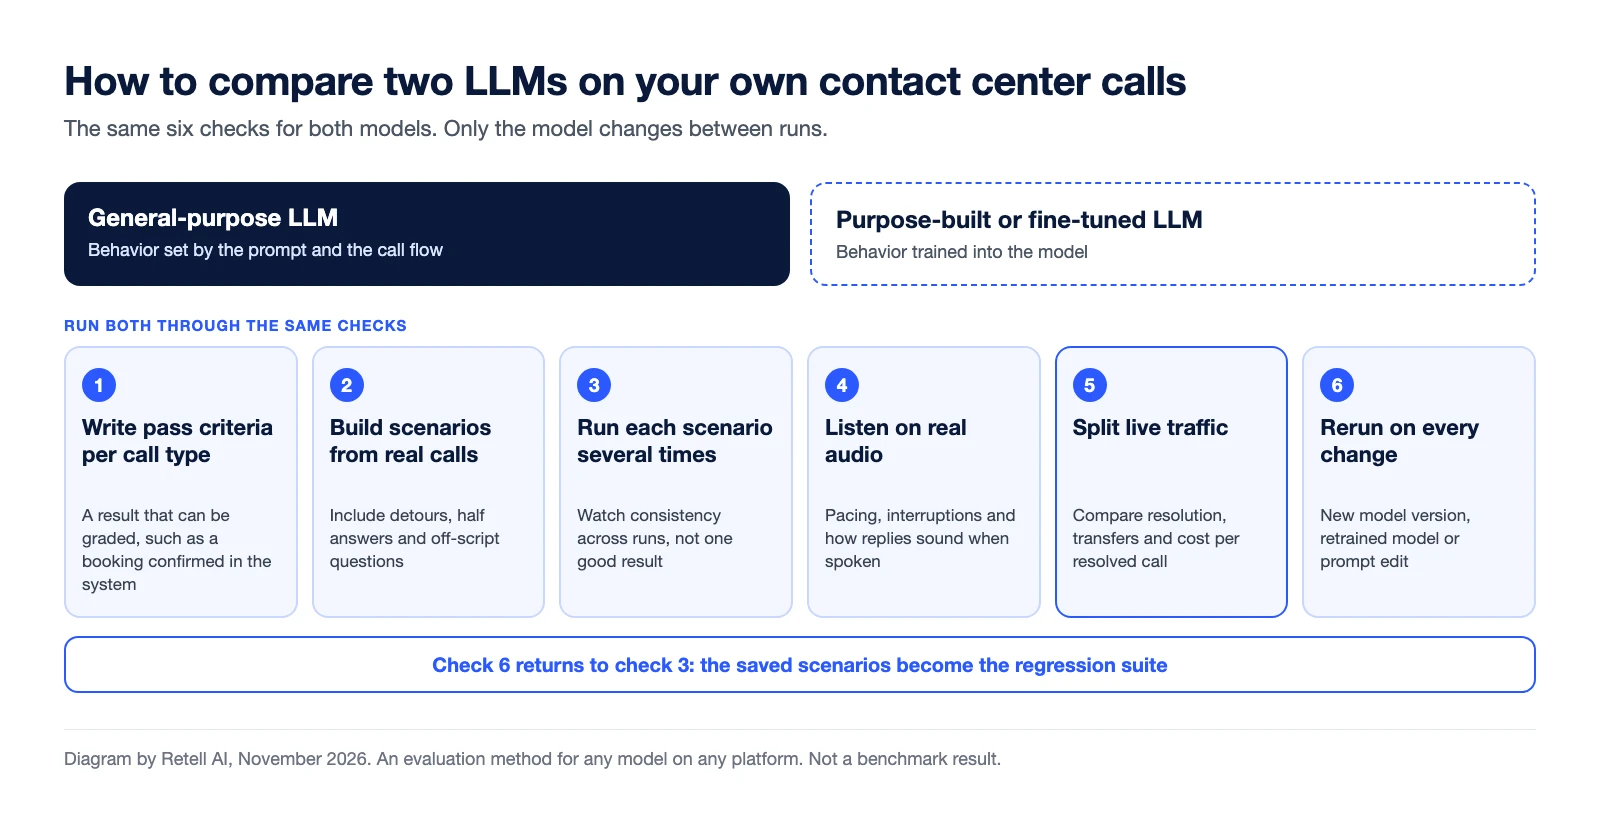
- Leg slaagcriteria per gesprekstype vast. "Afspraak geboekt in het planningssysteem en bevestigd aan de beller" is te beoordelen. "Klonk goed" niet.
- Bouw scenario's op basis van echte gesprekken. Neem de zijpaden mee: de beller die van gedachten verandert, een vraag buiten het script stelt of maar half antwoord geeft.
- Voer elk scenario meerdere keren uit op elk model. De auteurs van tau-bench stelden een pass^k-metriek voor om de betrouwbaarheid over herhaalde pogingen te meten.
- Luister naar echte audio. Tekstresultaten missen tempo, onderbrekingen en hoe een antwoord klinkt als het wordt uitgesproken.
- Verdeel live verkeer. Stuur een deel van de gesprekken naar elke optie en vergelijk oplossing, doorverbindingen en kosten per opgelost gesprek.
- Voer alles opnieuw uit bij elke wijziging. Een nieuwe modelversie, een opnieuw getraind model en een aangepaste prompt vragen allemaal om dezelfde suite.
Op Retell beoordelen simulatietests elke run als geslaagd of mislukt aan de hand van succescriteria, voeren batchtests de opgeslagen cases opnieuw uit als regressiesuite, en verdeelt A/B-testing het gespreksverkeer procentueel over agents. Volgens de documentatie kun je later van model wisselen zonder je prompt te herschrijven. Als je je eigen model meebrengt, zijn simulatie- en batchtests niet van toepassing en controleer je het via web- en telefoongesprekken. Voor de bredere pilot, zie hoe je een platform voor AI-stemagenten evalueert voordat je live gaat.
Waar past Tell-1 in deze vergelijking?
Tell-1, de eigen LLM van Retell, is een gespecialiseerd model voor contactcentergesprekken, dus elke afweging in deze gids geldt er ook voor. Zo scoort het op elk punt, met de bron voor elk getal.
- Scripts, tools en spraak. Op de Retell vCX Benchmark haalt Tell-1 gemiddeld 94,45 en staat het overall op #1. Per suite scoort het 88,6% op het volgen van instructies (plaats 2), 97,2% op grounding (plaats 2), 95,4% op toolaanroepen (plaats 5) en 96,6% op spreektaal (plaats 1), allemaal geraadpleegd op 13 november 2026. Retell voert die benchmark zelf uit, dus gebruik hem zoals deze gids aanraadt: als reden om het model op je shortlist te zetten.
- Snelheid. Het heeft de laagste mediane latency op het overzicht, namelijk 76 ms (geraadpleegd op 13 november 2026). Dat is het cijfer van het model in de benchmark, niet de end-to-end responstijd van een gesprek.
- Kosten. De benchmark vermeldt 3,5 cent per minuut. Dat is alleen de LLM-post, niet de prijs van een gesprek, en sommige algemene configuraties op het overzicht kosten minder. De prijzen van Retell beginnen vanaf $0,07 per minuut.
- Hoe het werkt. Het model begint aan zijn antwoord en blijft redeneren terwijl de eerste woorden worden afgespeeld. Het technische artikel Retell LLM: Interleaved Reasoning for Real-Time Voice Agents meldt gemiddeld zo'n 200 redeneertokens midden in een antwoord en beschrijft de drie trainingsfasen erachter.
- Lock-in. Tell-1 wordt binnen Retell aangeboden. Het staat in dezelfde modelkiezer als modellen van OpenAI, Anthropic en Google, en volgens de documentatie van Retell kun je later van model wisselen zonder je prompt te herschrijven, dus als je ervoor kiest, sluit je de andere niet uit.
- Dekking. Een model dat voor gesprekken is gebouwd, is bewust smaller. Test Tell-1 op je eigen talen en gesprekstypen voordat je erop vertrouwt, en houd een algemeen model aan voor elk gesprekstype waarop het als tweede eindigt.
- Evaluatie. De zes controles hierboven gelden onveranderd. Omdat Tell-1 een door Retell beheerd model is, werken simulatie- en batchtests ermee, en kan een A/B-verdeling hetzelfde verkeer naar twee kopieën van een agent sturen die alleen in model verschillen.
De eerlijke samenvatting: Tell-1 is de gespecialiseerde optie om op je shortlist te zetten als je op Retell draait, en de algemene modellen ernaast vormen de controlegroep. Bekijk Tell-1 voor de productdetails.
Veelgestelde vragen
Wat is een gespecialiseerde LLM?
Een gespecialiseerde LLM is een taalmodel dat is getraind of afgestemd op één taak, zoals het afhandelen van contactcentergesprekken, in plaats van op algemeen gebruik. Het wordt ook wel een domeinspecifieke of verticale LLM genoemd. Een algemeen groot taalmodel (LLM) wordt via prompts en tools aan de taak aangepast.
Zijn gespecialiseerde LLM's nauwkeuriger dan algemene LLM's?
Bij de taak waarvoor ze zijn getraind, kan dat. Daarbuiten vaak niet. De meeste gepubliceerde vergelijkingen komen van de leverancier die het model heeft gebouwd, dus test beide op je eigen scenario's.
Moet een contactcenter een eigen LLM trainen?
Meestal niet. De optimalisatiegids van OpenAI begint met evals en prompt engineering en voegt fine-tuning alleen toe voor sommige use cases. Zelf trainen betekent ook dat je eigenaar wordt van de trainingsdata en een hold-outset.
Is een custom LLM hetzelfde als een gefinetuned model?
Niet altijd. Op de meeste voiceplatforms is een custom LLM elk model dat je zelf host en koppelt, en dat al dan niet gefinetuned is. Met de Custom LLM-optie van Retell koppel je je eigen model via een WebSocket, terwijl Retell telefonie, transcriptie en beurtwisseling afhandelt.
Kan een contactcenter meer dan één LLM gebruiken?
Ja. Op Retell heeft elke agent een eigen modelinstelling, en de documentatie over LLM-instellingen beschrijft een snelle fallback die een back-upmodel naast het primaire model laat draaien.
Is Tell-1 een gespecialiseerde LLM?
Ja. Tell-1 is de eigen LLM van Retell, gebouwd voor contactcentergesprekken. Het staat overall op #1 in de Retell vCX Benchmark met een gemiddelde van 94,45 (geraadpleegd op 13 november 2026). Het is één optie in de modelkiezer van Retell, naast algemene modellen van OpenAI, Anthropic en Google.
Vergelijk modellen op je eigen gesprekken voordat je je vastlegt
Retell is een platform voor AI-stemagenten voor contactcenters. Elke agent heeft een modelkiezer, en de prijspagina vermeldt modellen van OpenAI, Anthropic en Google, plus een custom optie voor een model dat je zelf host. Tell-1, de eigen LLM van Retell, staat in dezelfde kiezer. De mensen die het dichtst bij je klanten staan, kunnen zelf het model wijzigen, de testsuite opnieuw uitvoeren en verkeer verdelen. Anders dan bij een managed AI-leverancier wordt die wijziging geen ticket, wachtrij of extra SOW. De prijzen zijn gebaseerd op gebruik, vanaf $0,07 per minuut op de prijspagina. Neem één gesprekstype en je eigen slaagcriteria mee, en voer een pilot uit op echte gesprekken voordat je iets ondertekent.
See how much your business could save by switching to AI-powered voice agents.
ROI Result
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Estimate your monthly voice AI cost
Read Other Blogs


Revolutioneer je belactiviteiten met Retell


