AI-agentbenchmarks uitgelegd voor AI-stemagenten





Een AI-agentbenchmark is een vaste set taken met een scoringsregel, waarmee je modellen op hetzelfde werk vergelijkt. Voor AI-stemagenten zijn er vier die je moet kennen: τ²-bench (tau2-bench) voor toolgebruik binnen een beleid, Multi-IF voor het opvolgen van instructies over meerdere beurten, GPQA Diamond voor moeilijk redeneerwerk en de Retell vCX Benchmark voor contactcentergesprekken. Elk ervan meet één onderdeel van wat er tijdens een telefoongesprek gebeurt.
Deze gids legt uit wat elke benchmark test, hoe er wordt gescoord en wat de score je niet vertelt. Retell AI publiceert deze gids en publiceert ook een van de vier benchmarks, de vCX Benchmark. Scores veranderen met elke nieuwe modelrelease, dus elke sectie linkt naar de bron met de actuele resultaten.
Wat is een AI-agentbenchmark?
Een AI-agentbenchmark geeft elk model dezelfde taken en dezelfde beoordelaar, en rapporteert vervolgens hoe vaak het model de taak goed uitvoert. Wat een score betekent, hangt af van de taak, van wie of wat de andere kant van het gesprek speelt en van hoe wordt bepaald of een taak geslaagd is.
Er zijn drie soorten beoordelaars. Een statuscontrole vergelijkt het resultaat van de acties van de agent met een bekend correct resultaat, zoals een database na een terugbetaling. Een regelcontrole voert een script uit op het antwoord. Een beoordelingsmodel beoordeelt het antwoord aan de hand van een rubric. Status- en regelcontroles zijn herhaalbaar maar beperkt. Beoordelingsmodellen kunnen toon en betekenis beoordelen, maar hebben hun eigen blinde vlekken.
Wat meten de vier benchmarks, naast elkaar gezet?
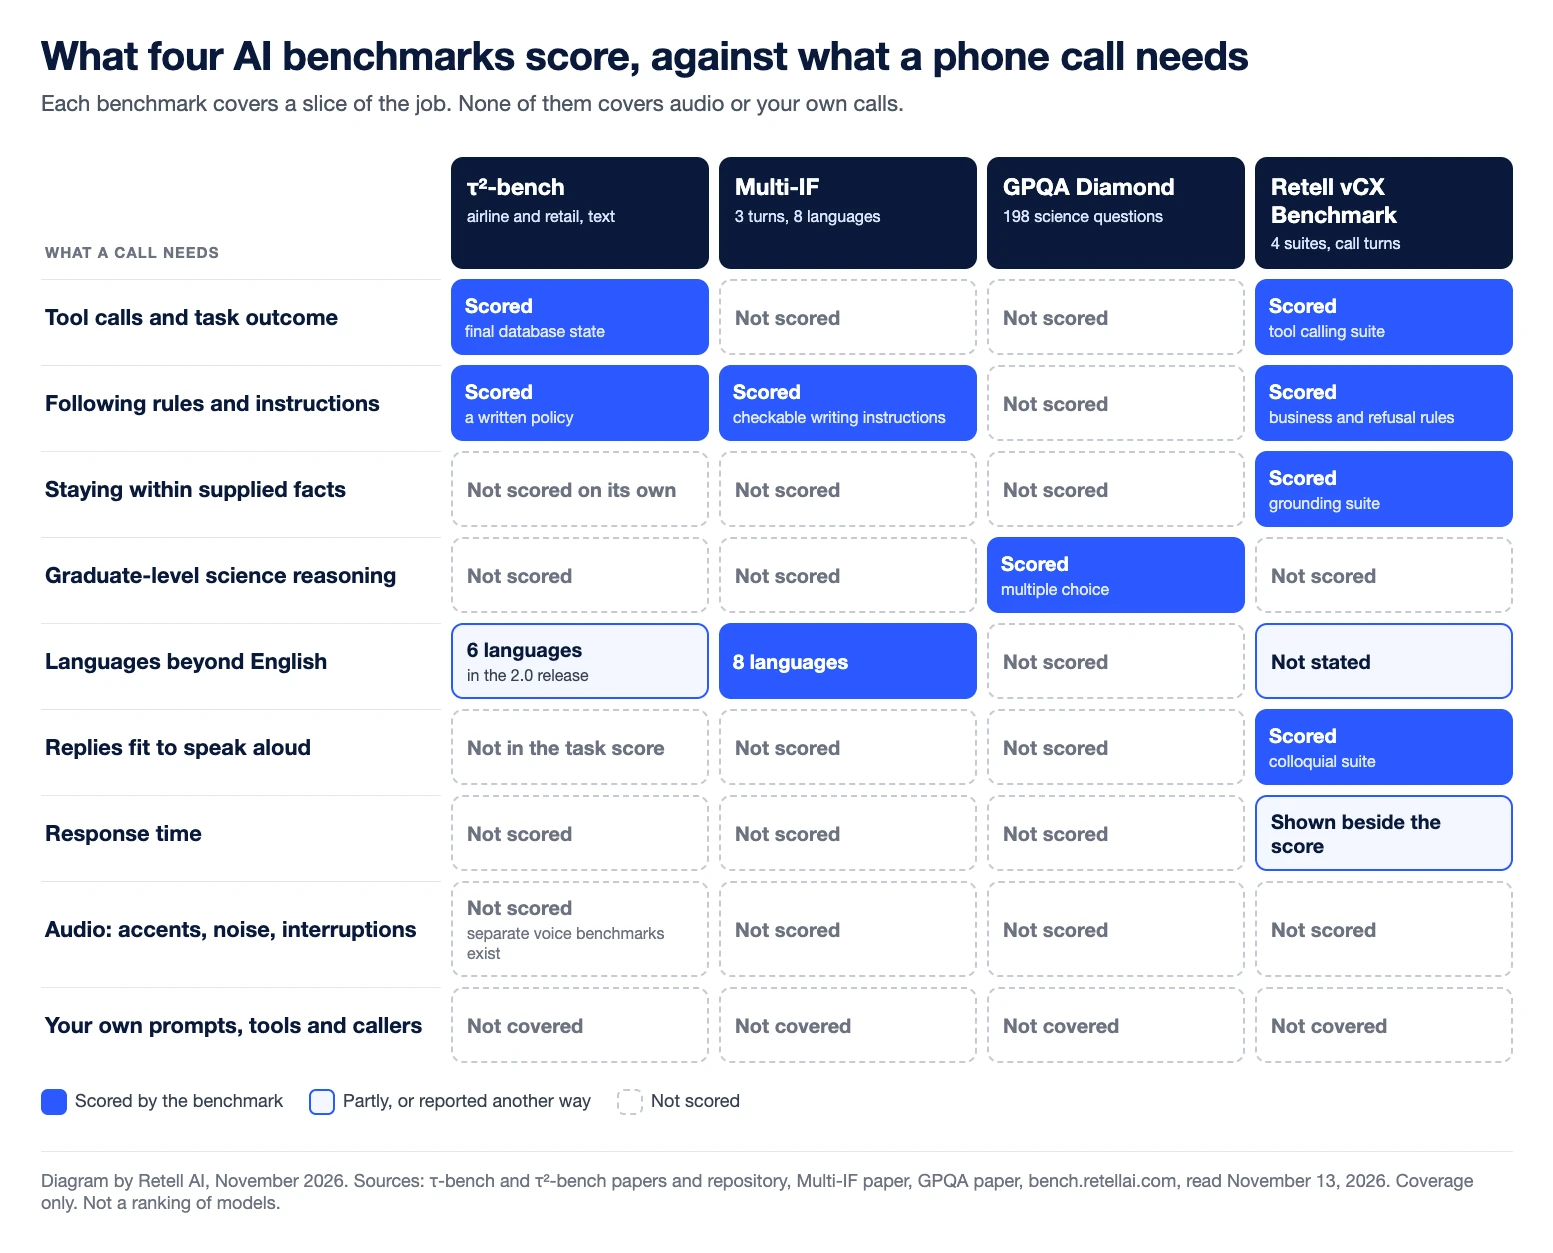
Ze bestrijken verschillende vaardigheden, en alleen de vCX Benchmark is opgebouwd uit telefoongesprekken. De tabel vat elke benchmark samen op basis van de paper, de repository of het leaderboard, geraadpleegd op 13 november 2026.
| Benchmark | Gepubliceerd door | Wat de taak is | Hoe er wordt gescoord | Wat het weglaat voor een koper van voice-AI |
|---|---|---|---|---|
| τ²-bench, airline en retail | Sierra | Een gesimuleerde klant helpen in een tekstgesprek, met tools en volgens een geschreven beleid | 0 of 1 per gesprek: de uiteindelijke database moet overeenkomen met het doel en de vereiste informatie moet zijn gegeven | Audio, responstijd, je eigen beleid en tools |
| Multi-IF | Meta | Controleerbare schrijfinstructies opvolgen over drie beurten, in acht talen | Gemiddelde van vier nauwkeurigheidscijfers, per instructie en per gesprek, strikt en ruim | Tools, lange scripts, gesproken weergave |
| GPQA Diamond | Onderzoekers van NYU, Cohere en Anthropic | 198 door experts geschreven meerkeuzevragen over wetenschap beantwoorden | Aandeel correct beantwoorde vragen, met 25% als kansniveau | Gesprek, tools, instructies, snelheid |
| Retell vCX Benchmark | Retell AI | Beurten in contactcentergesprekken afhandelen in vier suites | Slagingspercentage per suite, gemiddeld tot één score | Audio, je eigen gesprekstypen, resultaten over een volledig gesprek |
Wat meet τ²-bench in de domeinen airline en retail?
τ²-bench meet of een agent een klantenservicetaak via een gesprek kan afronden terwijl hij een geschreven beleid volgt en de juiste tools aanroept. Een taalmodel speelt de klant, en de agent werkt met een nagebootste database van bestellingen of reserveringen. De oorspronkelijke τ-bench-paper bouwde de twee domeinen op met 115 retailtaken en 50 airlinetaken. De τ²-bench-paper hergebruikt geverifieerde versies van beide en voegt een telecomdomein toe.
De scoring is streng. Volgens de evaluatienotities in de repository is de beloning van elke taak het product van de bijbehorende controles. Standaard zijn dat een databasecontrole, die de uiteindelijke database vergelijkt met de doelstatus, en een communicatiecontrole, die bevestigt dat de agent de klant de vereiste informatie heeft gegeven. Elke reeks toolaanroepen die de juiste eindstatus bereikt, slaagt.
Twee gerapporteerde getallen zijn belangrijk. Pass^1 is het aandeel taken dat in één poging wordt opgelost. Pass^k is het aandeel dat in alle k herhaalde pogingen wordt opgelost, een maatstaf die de oorspronkelijke paper introduceerde om consistentie te meten. Die paper uit 2024 meldde dat zelfs de toonaangevende function-calling-agents van dat moment minder dan de helft van de taken haalden, met pass^8 onder de 25% in retail.
Wat het een koper van voice-AI niet vertelt: de tekstscores voor airline en retail komen uit getypte gesprekken zonder audio, zonder onderbrekingen en zonder tijdsdruk. Het beleid en de tools zijn die van de benchmark zelf. De gesimuleerde klant is ook een model, en de auteurs van τ²-bench maten foutpercentages van de simulator van 40% in retail en 47% in airline, waarvan 12% en 13% ernstig genoeg om de taak te blokkeren. Dezelfde repository bevat inmiddels aparte voicebenchmarks, en de 2.0-release voegt zes talen toe en stelt dat de scores niet vergelijkbaar zijn met het 1.x-leaderboard. Controleer uit welke versie een geciteerde score komt.
Wat meet Multi-IF?
Multi-IF meet of een model instructies blijft opvolgen naarmate een gesprek vordert, en of dat ook buiten het Engels standhoudt. De Multi-IF-paper van Meta breidt een eerdere test met één beurt, IFEval, uit tot 4.501 gesprekken van elk drie beurten in acht talen: Engels, Frans, Russisch, Hindi, Italiaans, Portugees, Spaans en Chinees.
De instructies zijn zo geschreven dat ze te verifiëren zijn, zoals een verbod op komma's of een regel om in hoofdletters te antwoorden. De hoofdscore is het gemiddelde van vier nauwkeurigheidscijfers. Nauwkeurigheid op instructieniveau telt elke instructie afzonderlijk. Nauwkeurigheid op gespreksniveau telt een gesprek alleen mee als elke instructie tot en met die beurt is opgevolgd. Beide worden gerapporteerd volgens een strikt en een ruim criterium.
De belangrijkste bevinding van de paper is precies waarom deze benchmark ertoe doet voor telefoonagents: elk van de 14 geteste modellen faalde vaker met elke extra beurt. Eén model zakte van 0,877 in de eerste beurt naar 0,707 in de derde. Een agent die aan het begin van een gesprek een regel volgt en die een paar uitwisselingen later laat vallen, faalt op dezelfde manier.
Wat het een koper van voice-AI niet vertelt: de instructies zijn opmaak- en schrijfbeperkingen voor tekst, zoals lengte, interpunctie en trefwoorden. Het zijn geen bedrijfsregels. Er zijn geen tools, drie beurten is kort vergeleken met een echt gesprek, en er wordt niets hardop uitgesproken.
Wat meet GPQA Diamond?
GPQA Diamond meet of een model zeer moeilijke wetenschappelijke vragen kan beantwoorden die niet met een zoekopdracht op internet op te lossen zijn. De GPQA-paper beschrijft 448 meerkeuzevragen over biologie, natuurkunde en scheikunde, geschreven en gevalideerd door mensen die een PhD hebben of ermee bezig zijn. Diamond is de subset van 198 vragen die beide expertvalidators goed beantwoordden en de meeste niet-experts niet.
De scoring is simpelweg nauwkeurigheid. Elke vraag heeft vier opties, dus willekeurig gokken levert 25% op. Op de volledige set haalden experts 65% en ervaren niet-experts met onbeperkte internettoegang 34%.
Wat het een koper van voice-AI niet vertelt: bijna alles over een gesprek. Er is geen gesprek, geen instructie om op te volgen, geen tool en geen tijdslimiet. Het is een indicator voor redeneerdiepte. Met 198 vragen zijn kleine verschillen tussen modellen bovendien zwak bewijs, en de auteurs noemen de kleine omvang van de dataset zelf als beperking.
Wat meet de Retell vCX Benchmark?
De Retell vCX Benchmark meet hoe modellen beurten in contactcentergesprekken afhandelen in vier suites. Het live leaderboard, geraadpleegd op 13 november 2026, beschrijft ze als volgt:
- Instructies opvolgen: of het model rolbeperkingen, bedrijfsregels en weigeringsregels respecteert.
- Grounding: of antwoorden binnen de prompt, de tools en de opgehaalde context blijven.
- Toolaanroepen: of het model de juiste actie kiest en geldige argumenten doorgeeft.
- Spreektaal: of antwoorden natuurlijk, beknopt en veilig klinken om hardop uit te spreken.
Elke suite rapporteert een slagingspercentage over ongeveer 1.000 of meer cases, en de totaalscore is het gemiddelde van de vier. Het leaderboard telde op die datum 62 inzendingen verdeeld over 45 modellen en toont de mediane latency en de kosten per minuut naast elke score.
De gepubliceerde methodenotitie is de vCX-Hard-post, die de eerste twee testsets behandelt: grounding en toolaanroepen. De cases zijn verzameld uit productiegesprekken en gesampled over organisaties heen, zodat geen enkele klant domineert. Een panel van beoordelingsmodellen scoort elke case aan de hand van een rubric en een referentieoplossing. Die post ziet de rangschikking, meer dan het exacte getal, als het eigenlijke signaal.
Wat het een koper van voice-AI niet vertelt: het is een benchmark van een leverancier, en die leverancier doet zelf mee. Tell-1, het eigen model van Retell, staat op de Retell vCX Benchmark op #1 overall (per november 2026). De cases komen uit het verkeer van Retell, dus jouw gesprekstypen zijn mogelijk ondervertegenwoordigd of ontbreken. De vier suites scoren antwoorden en toolaanroepen, dus fouten in spraakherkenning, onderbrekingen en de vraag of een volledig gesprek wordt opgelost vallen erbuiten. Ook beoordelingsmodellen kunnen zich vergissen.
Hoe scoort Tell-1 op deze vier benchmarks?
Tell-1, de eigen LLM van Retell, is een uitgewerkt voorbeeld van hoe je de vier samen leest. Retell rapporteert de onderstaande publieke benchmarkscores in zijn technische post over Retell LLM, en de vCX-cijfers komen van het live leaderboard, geraadpleegd op 13 november 2026.
| Benchmark | Score Tell-1 | Omvang van de run | Uitgevoerd door |
|---|---|---|---|
| τ²-bench airline | 72,0 | 50 taken | Retell |
| τ²-bench retail | 78,0 | 50 taken | Retell |
| Multi-IF | 82,1 | 504 gesprekken | Retell |
| GPQA Diamond | 83,5 | 198 vragen × 3 | Retell |
| Retell vCX Benchmark | 94,45 gemiddeld, #1 overall van 62 modelconfiguraties | Vier suites, elk ongeveer 1.000 cases | Retell |
Lees deze cijfers zoals de secties hierboven aanraden. Elke rij is een eigen run van Retell, gescoord op 100 met telkens dezelfde greedy decoding, en volgens Retell is geen van de benchmarks gebruikt bij de training. De Multi-IF-run beslaat 504 van de 4.501 gesprekken van de benchmark en de τ²-bench-runs beslaan 50 taken per domein, dus ze zijn niet direct vergelijkbaar met cijfers uit de oorspronkelijke papers of op andere leaderboards.
Op vCX verschillen de suitescores: 96,6% voor spreektaal (plaats 1), 97,2% voor grounding (plaats 2), 88,6% voor instructies opvolgen (plaats 2) en 95,4% voor toolaanroepen (plaats 5). Andere modellen leiden in drie van de vier suites. Dezelfde voorzichtigheid geldt hier als voor elk ander model: deze cijfers leveren Tell-1 een plek op een shortlist op, en een test met je eigen gesprekken beslist de rest.
Wat laten benchmarkscores weg voor een koper van een AI-stemagent?
Benchmarkscores laten het platform rond het model en de omstandigheden van je eigen gesprekken buiten beschouwing. Een telefoongesprek voegt spraakherkenning, beurtwisseling, spraaksynthese, telefonie en latency in elke fase toe. Geen van de vier benchmarks, in de hier beschreven vorm, scoort die.
Resultaten kunnen per platform verschillen, zelfs als de agent identiek is. In een onderzoek van testleverancier Cekura werd één agent ongewijzigd op zes voiceplatforms uitgerold en liepen de workflowscores uiteen van 65,2% tot 95,7%. De samenvatting van Retell van dat Medicare-onderzoek behandelt de methode en de bijbehorende disclosure.
Hoe gebruik je als koper benchmarkscores?
Gebruik benchmarkscores om een shortlist samen te stellen en beslis daarna op basis van je eigen gesprekken. Een verstandige volgorde:
- Stem de benchmark af op het risico: resultaten voor toolgebruik als een verkeerde actie de kostbare fout is, instructies opvolgen als de agent een lang script moet volhouden.
- Controleer de versie, de datum en wie de test heeft uitgevoerd.
- Geef de voorkeur aan cijfers uit herhaalde pogingen, zoals pass^k, als die worden gerapporteerd.
- Bouw de test opnieuw op met je eigen scenario's en tel een scenario pas als geslaagd als alle herhaalde runs slagen.
Bij Retell laat simulatietesten een AI de beller spelen terwijl succescriteria elke run als geslaagd of mislukt beoordelen, en batchtests voeren opgeslagen cases opnieuw uit na elke promptwijziging. Na de lancering scoort AI QA een steekproef van echte gesprekken op criteria zoals hallucinaties en toolgebruik, en A/B-testen verdeelt live verkeer over twee agents. Voor de modelkeuze lees je welke LLM je AI-stemagent zou moeten aandrijven. Voor het aankoopproces lees je hoe je een platform voor AI-stemagenten evalueert.
Een benchmark vertelt je welke modellen een test verdienen. Een pilot met echte gesprekken vertelt je welk model je moet inzetten. Retell is een platform voor AI-stemagenten voor contactcenters, met prijzen vanaf $0,07 per minuut, zodat je het met je eigen gesprekken kunt bewijzen voordat je iets tekent.
Veelgestelde vragen
Wat is het verschil tussen pass^1 en pass^k?
Pass^1 is het aandeel taken dat een agent in één poging oplost. Pass^k is het aandeel dat hij oplost in elk van k herhaalde pogingen op dezelfde taak. Pass^k is altijd gelijk aan of lager dan pass^1, en het verschil laat zien hoe consistent de agent is.
Is τ-bench hetzelfde als τ²-bench?
Nee. τ-bench is de oorspronkelijke benchmark uit 2024 met de domeinen airline en retail. τ²-bench is het vervolg uit 2025 van dezelfde groep, dat geverifieerde versies van die twee domeinen behoudt en een telecomdomein toevoegt waarin de gesimuleerde klant ook tools gebruikt.
Waarom wordt een wetenschapstest als GPQA Diamond gebruikt om modellen voor klantgesprekken te vergelijken?
GPQA Diamond wordt gebruikt als algemene maatstaf voor redeneervermogen. Het zegt niets direct over gesprekken, tools of spraak. Lees het als een controle op redeneerdiepte en vertrouw voor de rest op taakbenchmarks.
Welke benchmark is het belangrijkst voor een AI-stemagent?
Geen enkele op zichzelf. Toolgebruik binnen een beleid, instructies opvolgen over meerdere beurten en grounding sluiten het best aan bij contactcenterwerk, dus τ²-bench, Multi-IF en de vCX Benchmark passen het best. Een beoordeelde test met je eigen gespreksscenario's weegt zwaarder dan elk van hen.
Hoe scoorde Tell-1 op τ²-bench, Multi-IF en GPQA Diamond?
Retell rapporteert voor Tell-1 72,0 op τ²-bench airline, 78,0 op τ²-bench retail, 82,1 op Multi-IF en 83,5 op GPQA Diamond, telkens op een schaal van 100. Dit zijn eigen runs van Retell op 50 taken per τ²-bench-domein, 504 Multi-IF-gesprekken en de 198 vragen van GPQA Diamond.
See how much your business could save by switching to AI-powered voice agents.
ROI Result
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Estimate your monthly voice AI cost
Read Other Blogs


Revolutioneer je belactiviteiten met Retell


