vCX-Hard: Benchmarking van toonaangevende AI-modellen op basis van echte contactcentergesprekken



Maak kennis met vCX-Hard, een benchmark van Retell die toonaangevende modellen rangschikt op basis van echte contactcentergesprekken. De benchmark meet twee eigenschappen die bepalen of een voice agent succesvol is: de waarheid onder ogen zien en de juiste actie ondernemen. vCX-Hard is gebouwd op eigen productiedata van gesprekken en evalueert de prestaties van modellen op de belangrijkste punten. Zelfs het beste model van vandaag haalt slechts ongeveer 88% van de lastigste situaties, en dat is precies waarom de juiste modelkeuze zo belangrijk is.
Waarom we dit hebben gebouwd
Klanten stellen ons vaker dan welke andere vraag ook: welk model moet ik gebruiken voor mijn spraakassistent? Lange tijd was het eerlijke interne antwoord: een naam en een schouderophaling. Voor een platform dat miljoenen echte klantgesprekken verwerkt, is dat niet voldoende.
Het succes van een callcentermedewerker hangt af van twee vaardigheden, en slechts twee:
- Blijf realistisch. Antwoord op basis van het daadwerkelijke beleid en de kennis van het bedrijf. Verzin nooit een tarief, een regel of een belofte.
- Handel correct. Gebruik het juiste instrument, met de juiste argumenten, op het juiste moment. Sla geen noodzakelijke stap over en onderneem geen actie waar niemand om gevraagd heeft.
Openbare benchmarks testen zelden beide aspecten tegelijk, en bijna nooit onder de omstandigheden van een live telefoongesprek. De data die dat wel kan, is moeilijk te verkrijgen. De gesprekslogboeken van één enkel bedrijf zijn niet divers genoeg om modellen met voldoende zekerheid te rangschikken. Retell beschikt over echt, divers productieverkeer uit vele sectoren en implementaties, met een volume dat nodig is om het ene model van het andere te onderscheiden. Dat is het essentiële ingrediënt voor een betrouwbare benchmark voor callcenters, en het is precies dat ingrediënt dat de meeste teams niet kunnen samenstellen.
Introductie van vCX-Hard
De naam zegt het al. De kleine letter v staat voor voice. CX staat voor customer experience, het dagelijkse werk van een callcentermedewerker. Hard is de methode: we beoordelen alleen op de moeilijkste momenten in het daadwerkelijke productieverkeer, de momenten waarop modellen echt uit elkaar vallen. Bij de volledige verdeling van productiegesprekken halen de meeste grensmodellen al 90 procent, wat je niets nuttigs vertelt. De moeilijkste momenten zijn waar een benchmark zijn waarde bewijst.
Elk geval is afkomstig uit daadwerkelijke productieaanroepen, niet handmatig geschreven of synthetisch gegenereerd. We beoordelen modellen op de twee assen die bepalend zijn voor een aanroep:
- Het percentage personen zonder hallucinaties. Hoe betrouwbaar de persoon in kwestie blijft en weigert dingen te verzinnen.
- Correctheidspercentage van toolaanroepen. Hoe betrouwbaar de agent de juiste acties selecteert en uitvoert.
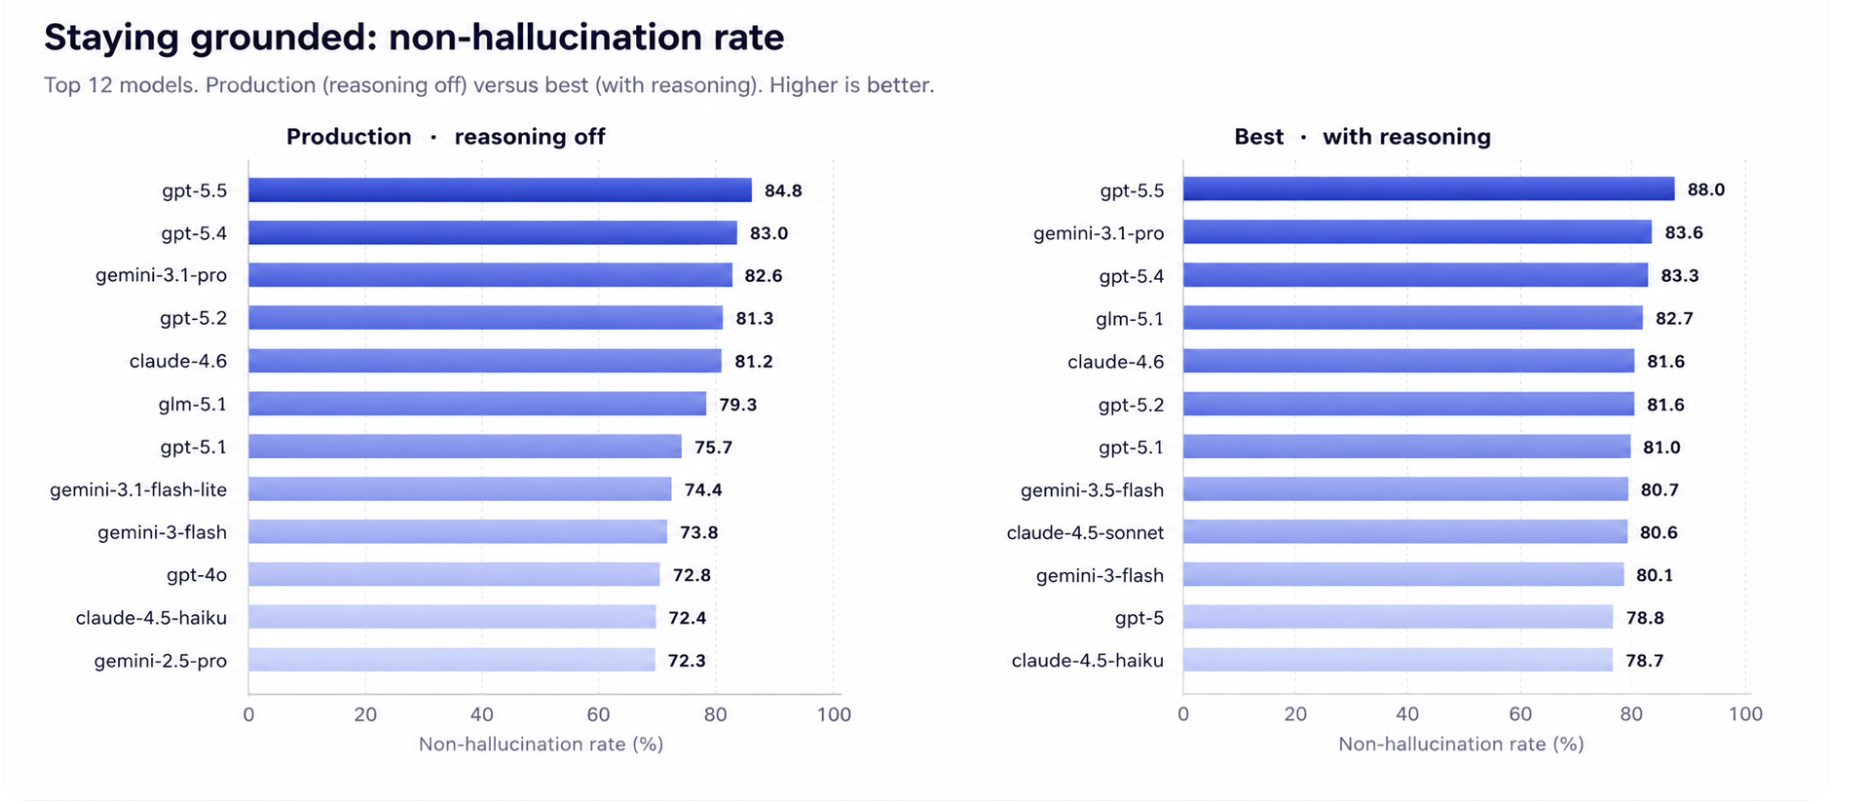
We hebben 50 configuraties van 27 modellen geëvalueerd. Omdat spraakagenten in productie draaien zonder redenering, vanwege de latentie, rapporteren we twee weergaven: productie (redenering uitgeschakeld, wat er gebeurt tijdens live gesprekken) en beste (gemiddelde redenering, een maximum voor wat redenering zou opleveren). GPT-5.5 scoort het beste in beide gevallen, met 84,8 procent niet-hallucinatie in productie en 88,0 procent in de beste configuratie. Geen enkel model is bijna volledig opgelost, en dat is precies de bedoeling.
Hoe we de dataset hebben samengesteld
We hebben het belverkeer in de productieomgeving tussen 6 februari en 1 mei 2026 geanalyseerd in periodes van 30 minuten, ongeveer elke 15 dagen. De steekproef was afkomstig van organisaties met meer dan 1000 oproepen in de voorgaande drie maanden. Cruciaal is dat we de steekproef op organisatieniveau hebben genomen, zodat een paar organisaties met een hoog belvolume de dataset niet domineren. Dit zorgt voor een brede spreiding over daadwerkelijke implementaties, in plaats van een scheve verdeling richting één specifieke klant.
Uit dat verkeer hebben we twee sets met lastige gevallen samengesteld: een set van 2075 gevallen met betrekking tot hallucinaties en een set van 1514 gevallen met betrekking tot gereedschapsoproepen. Elk geval wordt geanalyseerd via een meerstaps pipeline. Lichtgewicht pre-classificatiesystemen signaleren potentiële fouten (numerieke beweringen, momenten vóór de overdracht, gereedschapsfouten, herhaalde of ontbrekende oproepen), een LLM-classificatiesysteem bevestigt vervolgens of er daadwerkelijk een fout is opgetreden en labelt de categorie en ernst ervan, een tweede controleronde controleert de specifieke fout opnieuw en ten slotte wordt een correcte referentieoplossing gegenereerd voor beoordeling.
De classificatie van mislukkingen is op zichzelf al informatief. Wat hallucinaties betreft, is het dominante probleem niet exotisch. Agenten verzinnen of verdraaien beleid veel vaker dan wat dan ook.

Fouten bij het aanroepen van tools komen eveneens vaak voor. Van de 1514 gevallen zijn de twee grootste categorieën het missen van een noodzakelijke aanroep ( 897 ) en het uitvoeren van een onnodige aanroep ( 520 ). Het selecteren van de verkeerde tool komt vrijwel niet voor (2 gevallen). Met andere woorden, modellen kiezen zelden de verkeerde tool. Ze falen in hun beoordelingsvermogen: ze weten niet wanneer ze moeten handelen en wanneer ze moeten wachten.
Hoe wij beoordelen
De beoordeling vindt plaats via een LLM-raad: een panel van toonaangevende experts op het gebied van grensverleggende modellen. Zij beoordelen elke casus aan de hand van een beschrijvende rubriek en een gegenereerde referentieoplossing. Door meerdere deskundige beoordelaars in te zetten in plaats van één, wordt voorkomen dat de evaluatie de blinde vlekken van een individueel model overneemt, en worden meningsverschillen binnen het panel opgelost.
Omdat absolute scores variëren afhankelijk van de beoordelingscriteria en de juryleden, beschouwen we de rangschikking, en niet het exacte cijfer, als de indicator.
Waarom we de moeilijkste bochten beoordelen
De hoogste score ligt rond de 88 procent, en dat is bewust zo. Als we zouden beoordelen op basis van de volledige productieverdeling, zou bijna elk grensverleggend model boven de 90 procent uitkomen en zou het klassement nietszeggend zijn. Makkelijke keuzes zijn makkelijk voor iedereen.
vCX-Hard is dus gebouwd op de moeilijkste bochten, de momenten waarop modellen daadwerkelijk van elkaar afwijken. Zo werkt elke serieuze benchmark. Een wiskundige benchmark gebruikt wedstrijdproblemen, niet de rekenkundige bewerkingen die een doorsnee gebruiker invoert. Het doel is niet een flatterend getal. Het doel is een getal dat je kunt vergelijken tussen modellen, en in de loop van de tijd naarmate er nieuwe modellen op de markt komen.
Resultaten
We tonen elk klassement op twee manieren: in de praktijk, met de redeneerfunctie uitgeschakeld (wat gebruikt wordt bij live gesprekken), en optimaal, elk model met de sterkste redeneerfunctie ingesteld, wat de maximale prestaties laat zien. Zonder hallucinaties voert de GPT-5.5 beide aan. In de praktijk staan de GPT-5-serie en de gemini-3.1-pro bovenaan; het inschakelen van de redeneerfunctie zorgt ervoor dat dezelfde modellen een paar punten stijgen en de ranglijst daarachter opnieuw wordt samengesteld.
De correctheid van de tool-calls is waar de twee visies het meest uiteenlopen. Met redenering ingeschakeld, is GPT-5.5 de beste. Maar in de productieomgeving, waar het daadwerkelijk draait, daalt de tool-calling van GPT-5.5 van 88,3 naar 75,6 procent, en wordt gemini-3.1-pro met een duidelijke marge de beste tool-caller , met een score van 85,7 procent zonder redenering. Als uw agent redenering uitschakelt, is het sterkste model niet hetzelfde.
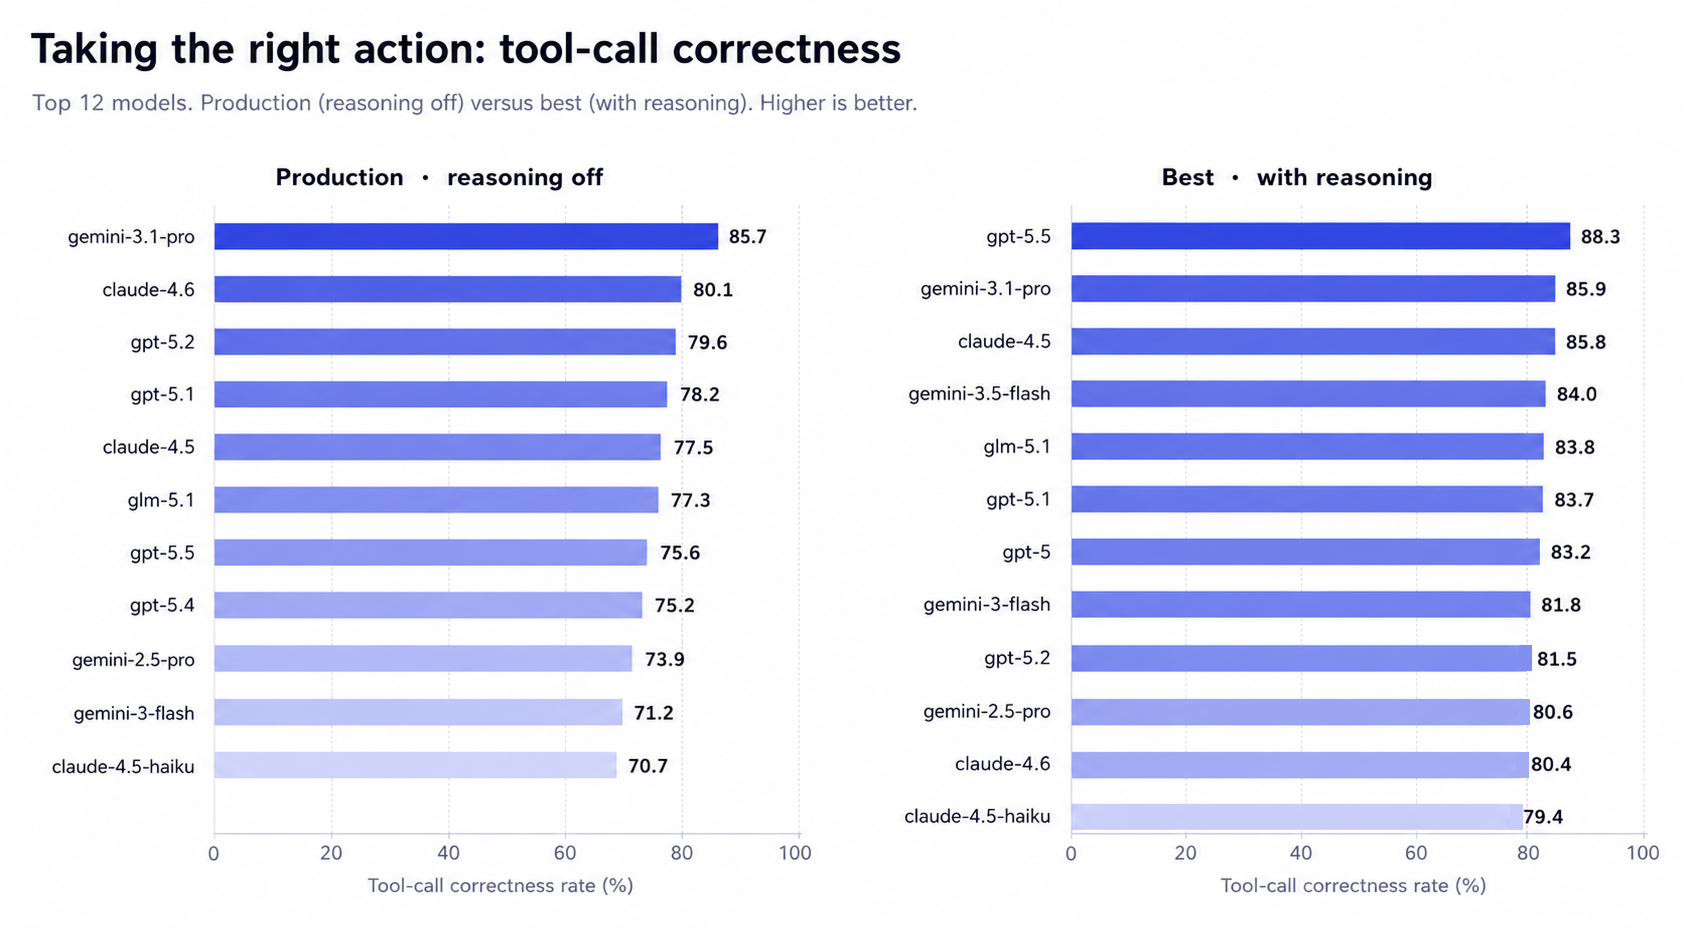
Drie patronen springen eruit in de hele collectie.
1. Redeneren is de kloof tussen de twee perspectieven. Het inschakelen van redeneren verhoogt de scores op bijna elk model, met gemiddeld ongeveer 5 punten voor niet-hallucinaties. GPT-5.5 stijgt van 84,8 naar 88,0 procent zodra het redeneert voordat het spreekt. De prijs hiervoor is latentie, en daarom laten de meeste productieagenten het uitgeschakeld, en daarom is het productieperspectief het perspectief waarop de planning gebaseerd moet zijn.

2. Aarding en actie zijn verschillende vaardigheden. De twee aspecten staan niet op gelijke voet. Een model dat sterk is in aarding kan middelmatig zijn in het aansturen van gereedschap, en omgekeerd. De GPT-5.4 scoort hoog op aarding, maar staat buiten de top tien op het gebied van gereedschapsaansturing, terwijl de Claude-4.5-Sonnet het tegenovergestelde is. De keuze voor een model komt er eigenlijk op neer welke tekortkoming uw klanten zich het minst kunnen veroorloven.
3. Geen enkel model is nog volledig veilig. Zelfs in de beste gevallen mist de leider nog steeds ongeveer één op de acht lastigste bochten op elke as, en in de praktijk zijn dat er nog meer. Het verschil tussen een benchmarkscore en een implementatie waarop je kunt vertrouwen, wordt precies bepaald door het werk dat het platform bovenop het model verricht.
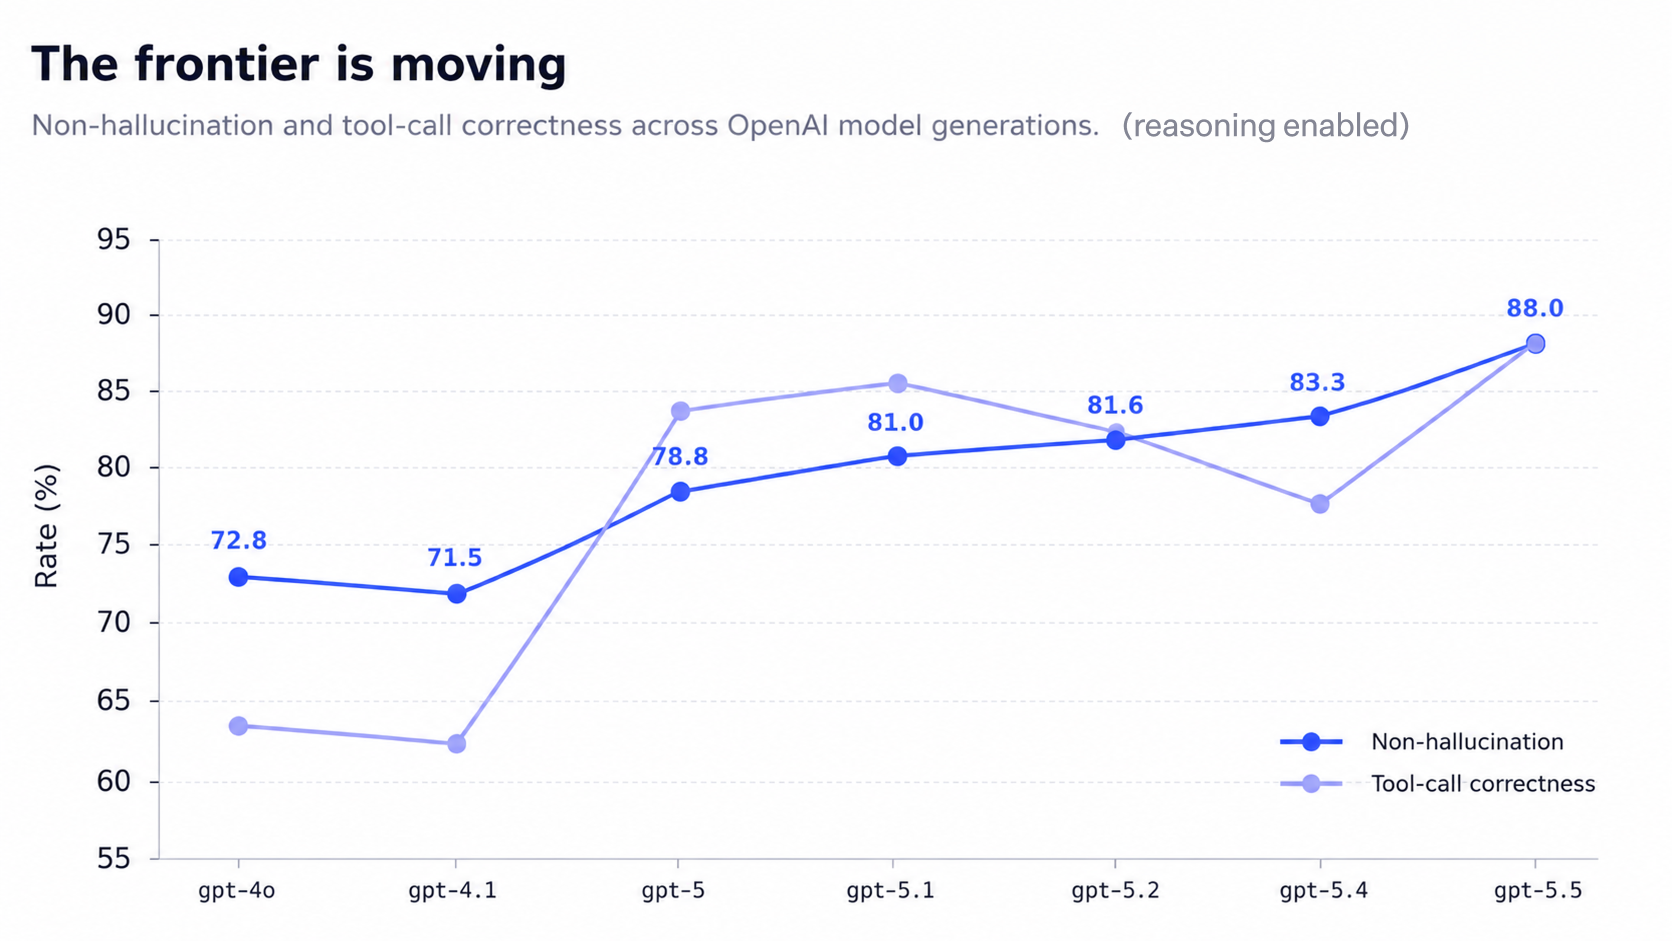
Als we naar de verschillende modelgeneraties kijken, zien we dat de ontwikkeling de goede kant op gaat. Van GPT-40 naar GPT-5.5 steeg het percentage niet-hallucinaties van 72,8 naar 88,0 procent, en de nauwkeurigheid van de tool-calling verbeterde op een vergelijkbare manier.
Volledig klassement
Productie (redenering uitgeschakeld, wat live draait) en beste (sterkste redeneringsinstelling) voor elk model, gesorteerd op productie zonder hallucinaties. Hoger is beter.
| Model | Niet-hallucinatie % | Tool-Call % | ||
|---|---|---|---|---|
| Prod (redenering uitgeschakeld) | Beste (met onderbouwing) | Prod (redenering uitgeschakeld) | Beste (met onderbouwing) | |
| gpt-5.5 | 84,8% | 88,0% | 75,6% | 88,3% |
| gpt-5.4 | 83,0% | 83,3% | 75,2% | 77,4% |
| gemini-3.1-pro | 82,6% | 83,6% | 85,7% | 85,9% |
| gpt-5.2 | 81,3% | 81,6% | 79,6% | 81,5% |
| Claude-4.6-sonnet | 81,2% | 81,6% | 80,1% | 80,4% |
| glm-5.1 | 79,3% | 82,7% | 77,3% | 83,8% |
| gpt-5.1 | 75,7% | 81,0% | 78,2% | 83,7% |
| gemini-3.1-flash-lite | 74,4% | 77,7% | 69,0% | 75,8% |
| gemini-3-flash | 73,8% | 80,1% | 71,2% | 81,8% |
| gpt-4o | 72,8% | 72,8% | 63,6% | 63,6% |
| claude-4.5-haiku | 72,4% | 78,7% | 70,7% | 79,4% |
| gemini-2.5-pro | 72,3% | 77,2% | 72,9% | 80,6% |
| gemini-3.5-flash | 72,0% | 80,7% | 69,2% | 84,0% |
| Claude - 4,5-sonnet | 71,5% | 80,6% | 77,5% | 85,8% |
| gpt-4.1 | 71,5% | 71,5% | 62,2% | 62,2% |
| gpt-5 | 71,2% | 78,8% | 68,9% | 83,2% |
| gpt-5.4-mini | 70,7% | 71,3% | 57,1% | 60,2% |
| gpt-5-mini | 69,4% | 75,2% | 70,6% | 75,6% |
| o4-mini | 67,9% | 67,9% | 73,9% | 73,9% |
| gpt-5.4-nano | 66,2% | 66,3% | 57,5% | 59,1% |
| grok-4.3 | 65,8% | 76,3% | 54,6% | 72,1% |
| kimi-k2.6 | 63,5% | 63,5% | 66,3% | 66,3% |
| o3-mini | 62,7% | 62,7% | 59,0% | 59,0% |
| gemini-2.5-flash-lite | 59,8% | 75,2% | 47,0% | 70,3% |
| kwik-2 | 56,7% | 61,9% | 52,2% | 55,9% |
| gpt-5-nano | 53,9% | 57,6% | 54,5% | 56,1% |
| deepseek-v4-pro | 49,8% | 55,6% | 58,9% | 64,5% |
Prod is elk model met de redeneerfunctie uitgeschakeld, of de laagst beschikbare instelling. Best is de sterkste redeneerfunctie. Modellen met overeenkomende kolommen (gpt-4o, gpt-4.1, kimi-k2.6, o4-mini, o3-mini) hadden slechts één instelling die werd geëvalueerd.
Van bevindingen tot productie
Een benchmark is alleen nuttig als deze je bouwproces verandert. De hiaten die vCX-Hard blootlegt, komen direct overeen met functionaliteiten in het Retell-platform, waardoor je deze niet hoeft mee te leveren.
- Per-node LLM: geen enkel model wint overal. Gronden en handelen zijn verschillende vaardigheden, en het beste model bij een moeilijke beurt is overbodig bij een gemakkelijke. Met Per-node LLM kunt u elke stap van een gesprek naar het juiste model leiden: uw sterkste model bij de moeilijkste beurten met de hoogste inzet, een sneller en goedkoper model bij begroetingen en bevestigingen. U betaalt alleen voor topnauwkeurigheid waar het ertoe doet .
- Praten tijdens het wachten: gesprekken met tools kosten tijd. Wanneer een agent tijdens een gesprek een API moet aanroepen of iets moet opzoeken, kan die heen-en-weergaande beweging een stilte op de lijn veroorzaken. Met 'praten tijdens het wachten' blijft de beller betrokken door middel van natuurlijke spraak terwijl het gesprek met de tool loopt, zodat de pauze nooit aanvoelt alsof de lijn stilvalt .
- Verankering in de kennisbasis: de meest voorkomende fout. Het fabriceren van beleid en het onjuist citeren van informatie uit de kennisbasis zijn de twee grootste categorieën van hallucinaties in de benchmark. Door de agent te verankeren in uw eigen kennisbasis blijven de antwoorden gekoppeld aan uw werkelijke beleid in plaats van aan de beste schatting van het model .
- Simulatietesten: de gevallen die deze benchmark niet kan detecteren. vCX-Hard draait op ons productieverkeer. Uw meest veeleisende vragen zijn uw eigen vragen. Met simulatietesten kunt u dezelfde soort evaluatie uitvoeren op uw eigen scenario's, zodat u een model kunt kiezen en afstemmen op de vragen die u daadwerkelijk ontvangt .
- AI QA: de benchmark beoordeelt modellen, AI QA beoordeelt uw gesprekken. vCX-Hard draait op een vaste set; uw productieomgeving verandert voortdurend. AI QA beoordeelt continu een steekproef van uw live gesprekken op dezelfde assen die hier van belang zijn: hallucinatie, kennisbankrecall en tool-call-nauwkeurigheid, plus aangepaste statistieken die u definieert voor wat als een goed gesprek wordt beschouwd.
De modelkeuze is de eerste stap. Het platform rondom het model is wat een benchmarkscore omzet in een implementatie waarop u kunt vertrouwen.
Beperkingen en wat volgt?
vCX-Hard is een vroege versie en heeft duidelijke beperkingen. De beoordeling is gebaseerd op een jury van LLM-leden, die hun eigen vooroordelen hebben. De casussen zijn geselecteerd op moeilijkheidsgraad, waardoor de scores de moeilijkste beurten weerspiegelen in plaats van de gemiddelde gesprekskwaliteit. Bovendien meet de benchmark twee specifieke faalmodi, niet de volledige ervaring van een gesprek, zoals toon, latentie of de afhandeling van onderbrekingen.
We zullen vCX-Hard blijven bijwerken naarmate er nieuwe modellen op de markt komen. Elke lancering roept bij elk team dat met spraakgestuurde systemen werkt dezelfde vraag op: er is een nieuw model, moeten we overstappen? vCX-Hard is ontworpen om die vraag te beantwoorden met actuele gegevens in plaats van een gok.
Waarom we dit delen
Benchmarks zijn er niet om cijfers er goed uit te laten zien. Ze dienen voor een eerlijke vergelijking. Wanneer een benchmark verzadigd raakt, ontwikkelt de markt een hogere lat. vCX-Hard is hoe we intern modellen selecteren en hoe we nu de vraag beantwoorden die klanten daadwerkelijk stellen, met bewijs in plaats van een merknaam. We zullen de lat steeds hoger leggen naarmate de modellen zich verder ontwikkelen.
See how much your business could save by switching to AI-powered voice agents.
ROI Result
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Een demodemonummer van Retell Clinic Office
What results look like with Retell AI
Estimate your monthly voice AI cost
Revolutioneer je belactiviteiten met Retell