Specialbyggda vs generella LLM:er för kontaktcenter





En generell LLM är den säkrare utgångspunkten för de flesta kontaktcenter. En specialbyggd LLM förtjänar sin plats när en samtalstyp har hög volym och en generell modell gång på gång missar på samma mätbara sätt: långsamma första ord, felaktiga verktygsanrop eller svar som låter som en webbsida som läses upp. Ingen av dem vinner per automatik. Rätt modell är den som klarar dina egna samtal, körning efter körning, till en kostnad per minut som du kan prognostisera.
Den här guiden är för dig som ansvarar för telefonlinjen. Retell AI publicerar guiden och har intressen på båda sidor. Plattformen erbjuder generella modeller från OpenAI, Anthropic och Google, och Retell bygger också en egen: Tell-1, den egna LLM:en från Retell, gjord för kontaktcentersamtal. Tell-1 rankas som nummer 1 totalt på det offentliga benchmarket från Retell, Retell vCX Benchmark (avläst 13 november 2026). Behandla det som vilket leverantörsbenchmark som helst: ett skäl att sätta modellen på kortlistan, och sedan något att kontrollera på dina egna samtal.
Vad kräver ett kontaktcentersamtal av en språkmodell?
Ett kontaktcentersamtal kräver fem saker av en modell i varje replik: följa ett långt manus, anropa verktyg korrekt, låta naturlig när svaret talas, svara snabbt och vara prisvärd i stor skala.
- Långa manus. Agentens prompt innehåller stegen, policyerna och undantagen för en samtalstyp, och modellen måste tillämpa rätt regel i varje replik. I Multi-IF-benchmarket misslyckades alla 14 utvärderade modeller med fler instruktioner för varje ny replik.
- Verktygsanrop. Bokningar, uppslag och överföringar går via verktyg, och ett felaktigt anrop ändrar en verklig post. tau-bench-studien från 2024 visade att agenter med funktionsanrop byggda på en ledande generell modell lyckades med färre än 50 % av kundtjänstuppgifterna och klarade alla åtta upprepade försök av en detaljhandelsuppgift i mindre än 25 % av fallen.
- Naturligt tal. Svaret hörs, det läses inte. Listor och symboler som fungerar på en skärm låter fel med en syntetisk röst.
- Hastighet. Människor lämnar korta pauser mellan replikerna. En översikt av forskningen om turtagning anger den typiska pausen till cirka 200 millisekunder. Modellen är ett steg mellan uppringarens sista ord och agentens första, så den tid den behöver innan den börjar svara hörs som tystnad.
- Kostnad i stor skala. Varje replik skickar manuset och hela konversationen hittills tillbaka till modellen. Leverantörerna ger rabatt på den upprepade indatan (OpenAI:s guide om prompt caching anger upp till 95 % rabatt på cachad indata), men med kontaktcentrets volymer blir en liten skillnad per minut en egen budgetpost.
Var passar generella LLM:er in i ett kontaktcenter?
Generella LLM:er passar bäst där samtalen varierar: många samtalstyper, många språk och frågor som ingen har skrivit manus för. De är brett tränade och säljs av flera leverantörer, så ett team kan byta modell när behoven förändras.
De kräver också mindre specialanpassning än många köpare tror. OpenAI:s guide om modelloptimering beskriver en loop av evals och prompt engineering, där finjustering läggs till ”för vissa användningsfall”. Mycket av det som håller en agent till manus finns i prompten, samtalsflödet och verktygen, och det arbetet följer med när modellen byts.
Begränsningarna syns i telefon. Resonerande lägen som tänker innan de svarar ger fördröjning före första ordet. Modeller som är anpassade för skriftlig chatt behöver promptas för att hålla svaren korta och lätta att säga högt. Och leverantören styr kalendern: OpenAI:s policy för utfasning ger minst 6 månaders varsel innan en allmänt tillgänglig modell tas ur drift, och agenten måste sedan kontrolleras på ersättaren. För en genomgång modell för modell, se vilken LLM som ska driva din AI-röstagent.
Vad förändrar en specialbyggd eller finjusterad LLM?
En specialbyggd LLM flyttar beteendet från prompten till modellens träning. I stället för att instruera en generell modell att tala kort, följa policyer och anropa verktyg vid rätt tillfälle tränar leverantören på exempel av just det, ofta på en mindre modell. Tre begrepp blandas ofta ihop:
- En domänspecifik eller vertikal LLM tränas eller finjusteras av en leverantör för en bransch eller uppgift och erbjuds till alla dess kunder.
- En finjusterad modell är en basmodell som tränats vidare på ett smalare dataset, ofta ditt eget. Ordlisteposten om finjustering av AI-modeller förklarar hur det fungerar.
- En anpassad LLM betyder oftast vilken modell som helst som du själv kopplar till en plattform, finjusterad eller inte.
OpenAI:s guide om LLM-noggrannhet anger två skäl att finjustera: att förbättra noggrannheten på en specifik uppgift och att förbättra effektiviteten, alltså samma noggrannhet med färre tokens eller från en mindre modell. I samtal kan det innebära att manuset följs stabilare, kortare promptar och lägre kostnad per minut.
Idén är inte ny. Observe.AI lanserade en Contact Center LLM i juni 2023, som företaget beskriver som en modell med 30 miljarder parametrar tränad på ett domänspecifikt dataset med hundratals miljoner kundinteraktioner. Noggrannhetsvinsterna i lanseringen bygger på leverantörens egna inledande benchmarks. Det är normalt i kategorin, och det är därför din egen utvärdering väger tyngre än något pressmeddelande.
Vilka är avvägningarna mellan de två?
Avvägningarna gäller inlåsning, täckning och utvärderingsbörda, och var och en slår åt båda hållen.
| Faktor | Generell LLM | Specialbyggd eller finjusterad LLM |
|---|---|---|
| Passar bäst för | Varierade samtalstyper, många språk, frågor utan manus | En samtalstyp med hög volym och stabila regler |
| Manus- och verktygsbeteende | Styrs av prompten och samtalsflödet | Inbyggt genom träning, så det behövs mindre prompt |
| Hastighet och kostnad per minut | Beror på modellstorlek och resonemangsläge | Kan vara lägre när modellen är mindre |
| Inlåsning | Flera leverantörer som fasar ut modeller enligt egna scheman | Ofta en enda leverantör eller plattform |
| Täckning | Bred | Smalare utanför träningsdatan |
| Belägg du kan få | Offentliga benchmarks, få av dem på telefonsamtal | Ofta leverantörens eget benchmark |
| Utvärderingsbörda | En ny kontroll varje gång en modell fasas ut | En kontroll före införandet och efter varje omträning |
Inlåsning. En specialbyggd modell säljs ofta av en enda leverantör, ibland inuti en enda plattform. Fråga om du kan byta modell utan att bygga om agenten, och om promptar, flöden och testfall förblir dina. Generella modeller bär en tystare variant av samma risk när en leverantör fasar ut en version.
Täckning. En modell som tränats på engelska bokningssamtal kan vara svagare på spanska, eller på en faktureringstvist som den aldrig har sett. Be om resultat per språk och per samtalstyp, inte ett genomsnitt.
Utvärderingsbörda. Offentliga benchmarks mäter sällan telefonsamtal, och ett leverantörsbenchmark är belägg som säljaren har valt ut. Om du finjusterar en egen modell växer bördan. OpenAI:s noggrannhetsguide säger att träningsexemplen ”måste exakt representera vad modellen kommer att se i verkligheten” och rekommenderar ett hold-out-set för att upptäcka överanpassning.
Hur utvärderar du någon av modellerna på dina egna samtal?
Utvärdera båda på samma sätt: fasta scenarier hämtade från dina egna samtal, bedömda mot skriftliga godkännandekriterier och körda mer än en gång, och sedan en uppdelning av live-trafiken.
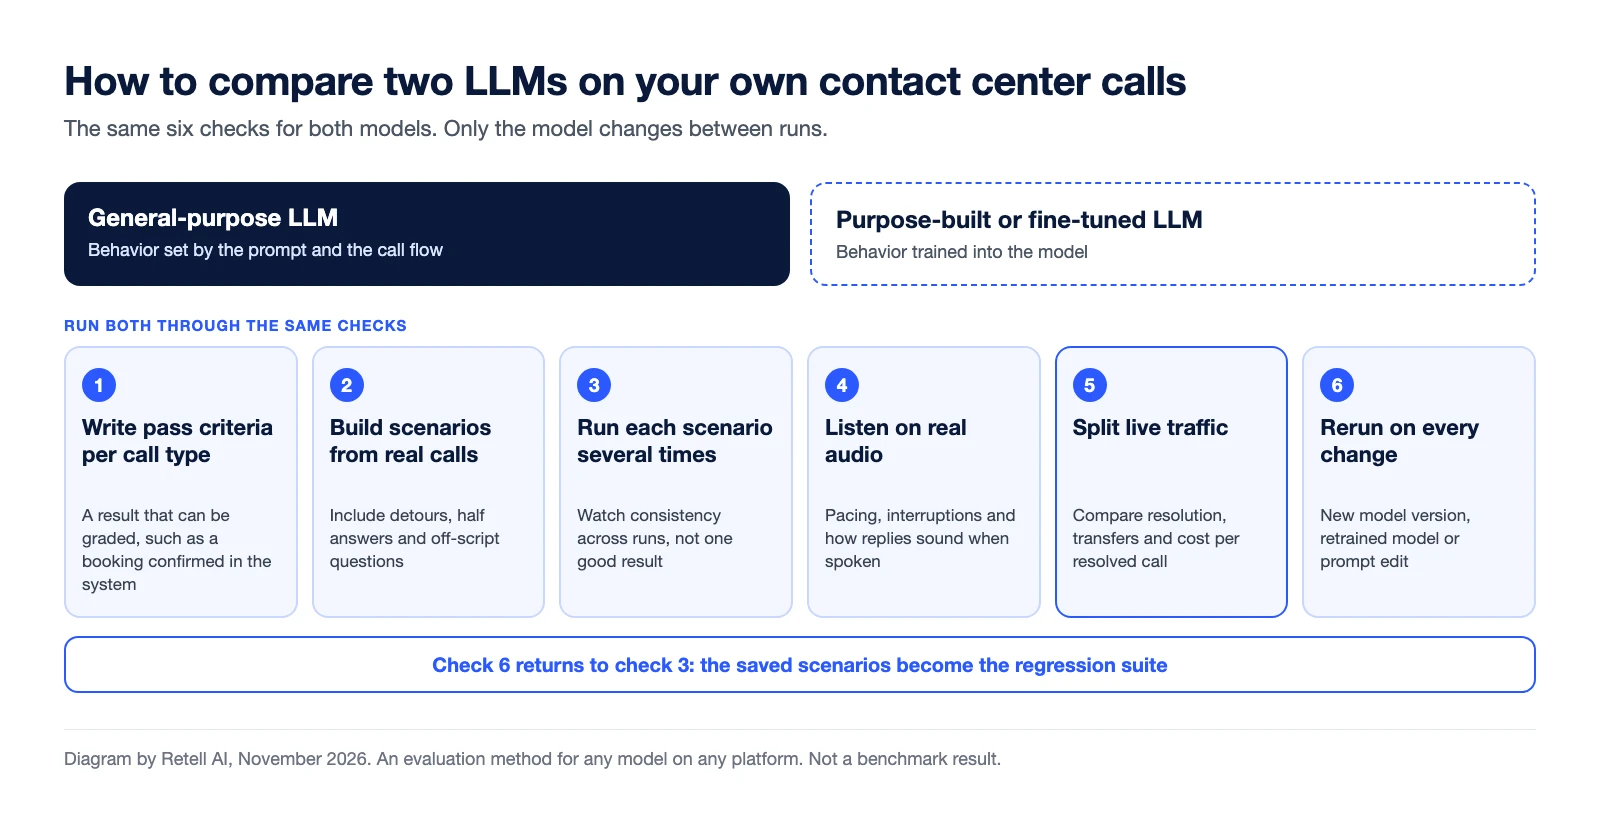
- Skriv godkännandekriterier per samtalstyp. ”Mötet bokat i bokningssystemet och bekräftat för uppringaren” går att bedöma. ”Lät bra” gör det inte.
- Bygg scenarier från riktiga samtal. Ta med avstickarna: uppringaren som ändrar sig, ställer en fråga utanför manus eller ger ett halvt svar.
- Kör varje scenario flera gånger på varje modell. Författarna bakom tau-bench föreslog måttet pass^k för att mäta tillförlitlighet över upprepade försök.
- Lyssna på riktigt ljud. Textresultat missar tempo, avbrott och hur ett svar låter när det sägs högt.
- Dela upp live-trafiken. Skicka en andel av samtalen till varje alternativ och jämför lösningsgrad, överföringar och kostnad per löst samtal.
- Kör om vid varje ändring. En ny modellversion, en omtränad modell och en ändrad prompt kräver alla samma testsvit.
I Retell bedömer simuleringstester varje körning som godkänd eller underkänd mot framgångskriterier, batchtester kör om de sparade fallen som en regressionssvit, och A/B-tester fördelar samtalstrafiken mellan agenter i procent. Enligt dokumentationen kan du byta modell senare utan att skriva om din prompt. Om du tar med din egen modell gäller inte simulerings- och batchtester, och då är webb- och telefonsamtal sättet att kontrollera den. För den bredare piloten, se hur du utvärderar en plattform för AI-röstagenter innan du går live.
Var passar Tell-1 in i den här jämförelsen?
Tell-1, den egna LLM:en från Retell, är en specialbyggd modell för kontaktcentersamtal, så varje avvägning i den här guiden gäller för den. Så här ligger den till på varje punkt, med källa för varje siffra.
- Manus, verktyg och tal. På Retell vCX Benchmark får Tell-1 ett snitt på 94,45 och rankas som nummer 1 totalt. Per svit får den 88,6 % på instruktionsföljning (plats 2), 97,2 % på grounding (plats 2), 95,4 % på verktygsanrop (plats 5) och 96,6 % på vardagligt tal (plats 1), allt avläst 13 november 2026. Retell driver själv benchmarket, så använd det som guiden föreslår: som ett skäl att sätta modellen på kortlistan.
- Hastighet. Den har lägst medianlatens på listan, 76 ms (avläst 13 november 2026). Det är modellens siffra i benchmarket, inte svarstiden från början till slut i ett samtal.
- Kostnad. Benchmarket anger den till 3,5 cent per minut. Det gäller bara LLM-posten, inte priset för ett samtal, och vissa generella konfigurationer på listan kostar mindre. Priserna hos Retell börjar från 0,07 $ per minut.
- Så fungerar den. Modellen börjar på sitt svar och fortsätter resonera medan de första orden spelas upp. Det tekniska inlägget, Retell LLM: Interleaved Reasoning for Real-Time Voice Agents, rapporterar i genomsnitt cirka 200 resonemangstokens mitt i svaret och beskriver de tre träningsstegen bakom modellen.
- Inlåsning. Tell-1 erbjuds i Retell. Den finns i samma modellväljare som modeller från OpenAI, Anthropic och Google, och enligt dokumentationen från Retell kan du byta modell senare utan att skriva om din prompt, så att välja den stänger inte dörren för de andra.
- Täckning. En modell byggd för samtal är smalare av design. Kör Tell-1 på dina egna språk och samtalstyper innan du förlitar dig på den, och behåll en generell modell för alla samtalstyper där Tell-1 kommer tvåa.
- Utvärdering. De sex kontrollerna ovan gäller oförändrade. Eftersom Tell-1 är en modell som hanteras av Retell fungerar simulerings- och batchtester med den, och en A/B-uppdelning kan skicka samma trafik till två kopior av en agent som bara skiljer sig åt i modell.
Den rättvisa sammanfattningen: Tell-1 är det specialbyggda alternativet att sätta på kortlistan om du kör på Retell, och de generella modellerna bredvid den är kontrollgruppen. Se Tell-1 för produktdetaljer.
Vanliga frågor
Vad är en specialbyggd LLM?
En specialbyggd LLM är en språkmodell som tränats eller finjusterats för en uppgift, till exempel att hantera kontaktcentersamtal, i stället för allmän användning. Den kallas också domänspecifik eller vertikal LLM. En generell stor språkmodell anpassas till uppgiften genom promptar och verktyg.
Är specialbyggda LLM:er mer exakta än generella LLM:er?
På den uppgift de tränats för kan de vara det. Utanför den ofta inte. De flesta publicerade jämförelser kommer från leverantören som byggt modellen, så kör båda på dina egna scenarier.
Behöver ett kontaktcenter träna en egen LLM?
Oftast inte. OpenAI:s optimeringsguide börjar med evals och prompt engineering och lägger bara till finjustering för vissa användningsfall. Att träna en egen innebär också att du äger träningsdatan och ett hold-out-set.
Är en anpassad LLM samma sak som en finjusterad modell?
Inte alltid. På de flesta röstplattformar är en anpassad LLM vilken modell som helst som du själv hostar och ansluter, och den kan vara finjusterad eller inte. Alternativet anpassad LLM i Retell ansluter din egen modell via en WebSocket medan Retell hanterar telefoni, transkribering och turtagning.
Kan ett kontaktcenter använda mer än en LLM?
Ja. I Retell har varje agent sin egen modellinställning, och dokumentationen om LLM-inställningar beskriver en snabb fallback som kör en reservmodell parallellt med den primära.
Är Tell-1 en specialbyggd LLM?
Ja. Tell-1 är den egna LLM:en från Retell, byggd för kontaktcentersamtal. Den rankas som nummer 1 totalt på Retell vCX Benchmark med ett snitt på 94,45 (avläst 13 november 2026). Den är ett alternativ i modellväljaren i Retell, bredvid generella modeller från OpenAI, Anthropic och Google.
Jämför modeller på dina egna samtal innan du bestämmer dig
Retell är en plattform för AI-röstagenter för kontaktcenter. Varje agent har en modellväljare, och prissidan listar modeller från OpenAI, Anthropic och Google tillsammans med ett anpassat alternativ för en modell som du hostar själv. Tell-1, den egna LLM:en från Retell, finns i samma väljare. De som står närmast dina kunder kan själva byta modell, köra om testsviten och dela upp trafiken. Till skillnad från när du arbetar med en leverantör av förvaltad AI blir den ändringen inte ett ärende, en kö eller ytterligare ett SOW. Prissättningen är användningsbaserad, från 0,07 $ per minut enligt prissidan. Ta med en samtalstyp och dina egna godkännandekriterier, och kör en pilot på riktiga samtal innan du skriver på något.
See how much your business could save by switching to AI-powered voice agents.
ROI Result
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Estimate your monthly voice AI cost
Read Other Blogs


Revolutionera din samtalsverksamhet med Retell


