AI-agentbenchmarks förklarade för AI-röstagenter





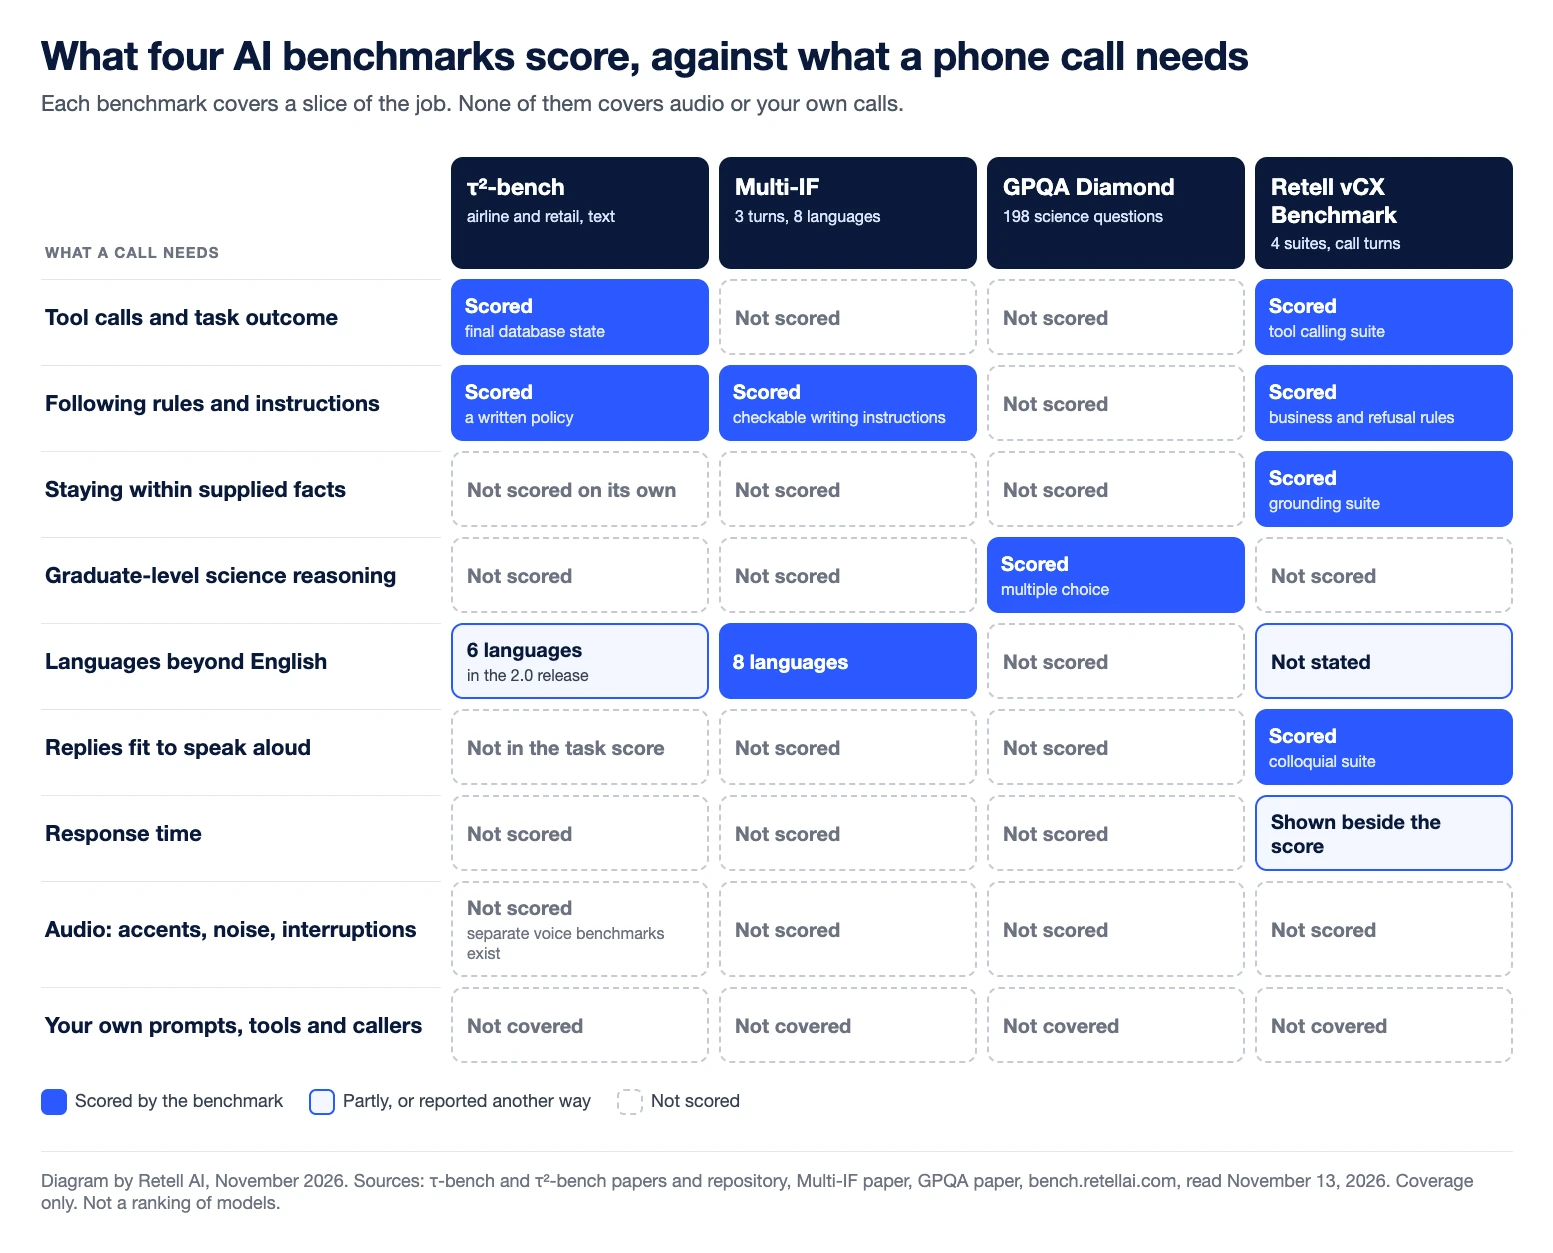
En benchmark för AI-agenter är en fast uppsättning uppgifter med en poängregel, som används för att jämföra modeller på samma arbete. För AI-röstagenter finns det fyra som är värda att känna till: τ²-bench (tau2-bench) för verktygsanvändning enligt en policy, Multi-IF för att följa instruktioner över flera repliker, GPQA Diamond för avancerat resonemang och Retell vCX Benchmark för samtal i kontaktcenter. Var och en mäter en enda del av det som händer i ett telefonsamtal.
Den här guiden förklarar vad varje benchmark testar, hur den poängsätts och vad poängen inte säger dig. Retell AI publicerar den här guiden och publicerar också en av de fyra benchmarkarna, vCX Benchmark. Poängen ändras med varje ny modellversion, så varje avsnitt länkar till källan med aktuella resultat.
Vad är en benchmark för AI-agenter?
En benchmark för AI-agenter ger alla modeller samma uppgifter och samma bedömare och rapporterar sedan hur ofta modellen löser uppgiften rätt. Vad en poäng betyder beror på uppgiften, på vem eller vad som spelar den andra parten i samtalet och på hur ett godkänt resultat avgörs.
Bedömare finns i tre varianter. En tillståndskontroll jämför resultatet av agentens åtgärder med ett känt korrekt resultat, till exempel en databas efter en återbetalning. En regelkontroll kör ett skript mot svaret. En domarmodell bedömer svaret mot en bedömningsmall. Tillstånds- och regelkontroller är upprepningsbara men snäva. Domarmodeller kan bedöma ton och innebörd, men de har sina egna blinda fläckar.
Vad mäter de fyra benchmarkarna, sida vid sida?
De täcker olika färdigheter, och endast vCX Benchmark bygger på telefonsamtal. Tabellen sammanfattar var och en utifrån dess forskningsrapport, repository eller topplista, läst den 13 november 2026.
| Benchmark | Publicerad av | Vad uppgiften är | Hur den poängsätts | Vad den missar för en köpare av röstlösningar |
|---|---|---|---|---|
| τ²-bench, flyg och detaljhandel | Sierra | Betjäna en simulerad kund i ett textsamtal med hjälp av verktyg och enligt en skriftlig policy | 0 eller 1 per samtal: den slutliga databasen måste matcha målet och obligatorisk information måste lämnas | Ljud, svarstid, din egen policy och dina egna verktyg |
| Multi-IF | Meta | Följa kontrollerbara skrivinstruktioner över tre repliker, på åtta språk | Genomsnitt av fyra träffsäkerhetsmått, per instruktion och per samtal, strikt och tolerant | Verktyg, långa manus, talat framförande |
| GPQA Diamond | Forskare vid NYU, Cohere och Anthropic | Besvara 198 flervalsfrågor inom naturvetenskap skrivna av experter | Andel korrekt besvarade frågor, där 25 % motsvarar slumpen | Samtal, verktyg, instruktioner, hastighet |
| Retell vCX Benchmark | Retell AI | Hantera repliker i kontaktcentersamtal i fyra testsviter | Andel godkända per svit, sammanvägt till en poäng | Ljud, dina egna samtalstyper, resultat för ett helt samtal |
Vad mäter τ²-bench i domänerna flyg och detaljhandel?
τ²-bench mäter om en agent kan slutföra en kundtjänstuppgift genom samtal, samtidigt som den följer en skriftlig policy och anropar rätt verktyg. En språkmodell spelar kunden, och agenten arbetar mot en simulerad databas med beställningar eller bokningar. Den ursprungliga τ-bench-rapporten byggde de två domänerna med 115 uppgifter inom detaljhandel och 50 uppgifter inom flyg. τ²-bench-rapporten återanvänder verifierade versioner av båda och lägger till en telekomdomän.
Poängsättningen är strikt. Enligt utvärderingsanteckningarna i repositoryt är varje uppgifts belöning produkten av dess kontroller. Som standard är det en databaskontroll, som jämför den slutliga databasen med måltillståndet, och en kommunikationskontroll, som bekräftar att agenten gav kunden den obligatoriska informationen. Varje sekvens av verktygsanrop som når rätt sluttillstånd blir godkänd.
Två rapporterade siffror är viktiga. Pass^1 är andelen uppgifter som löses på ett enda försök. Pass^k är andelen som löses i samtliga k upprepade försök, ett mått som den ursprungliga rapporten införde för att fånga konsekvens. Den rapporten från 2024 visade att även dåtidens ledande agenter med funktionsanrop lyckades med färre än hälften av uppgifterna, med pass^8 under 25 % inom detaljhandel.
Vad den inte säger en köpare av röstlösningar: textpoängen för flyg och detaljhandel kommer från skrivna samtal utan ljud, utan avbrott och utan tidsgräns. Policyerna och verktygen är benchmarkens egna. Den simulerade kunden är också en modell, och författarna bakom τ²-bench uppmätte felfrekvenser för simulatorn på 40 % inom detaljhandel och 47 % inom flyg, varav 12 % respektive 13 % var så allvarliga att de blockerade uppgiften. Samma repository innehåller nu separata röstbenchmarks, och version 2.0 lägger till sex språk och anger att poängen inte är jämförbara med topplistan för 1.x. Kontrollera vilken version en citerad poäng kommer från.
Vad mäter Multi-IF?
Multi-IF mäter om en modell fortsätter att följa instruktioner allteftersom ett samtal fortskrider, och om det håller även utanför engelska. Multi-IF-rapporten från Meta bygger ut ett tidigare test med en enda replik, IFEval, till 4 501 samtal med tre repliker vardera på åtta språk: engelska, franska, ryska, hindi, italienska, portugisiska, spanska och kinesiska.
Instruktionerna är skrivna så att de kan verifieras, till exempel ett förbud mot kommatecken eller en regel om att svara med versaler. Huvudpoängen är ett genomsnitt av fyra träffsäkerhetsmått. Träffsäkerhet på instruktionsnivå räknar varje instruktion för sig. Träffsäkerhet på samtalsnivå räknar ett samtal endast om varje instruktion fram till den repliken har följts. Båda rapporteras enligt ett strikt och ett tolerant kriterium.
Rapportens huvudsakliga resultat är anledningen till att den här benchmarken är viktig för telefonagenter: samtliga 14 testade modeller misslyckades oftare för varje ny replik. En modell sjönk från 0,877 i första repliken till 0,707 i den tredje. En agent som följer en regel i början av ett samtal och tappar den några repliker senare misslyckas på samma sätt.
Vad den inte säger en köpare av röstlösningar: instruktionerna är formaterings- och skrivbegränsningar för text, som längd, interpunktion och nyckelord. De är inte affärsregler. Det finns inga verktyg, tre repliker är kort jämfört med ett riktigt samtal, och ingenting läses upp.
Vad mäter GPQA Diamond?
GPQA Diamond mäter om en modell kan besvara mycket svåra naturvetenskapliga frågor som en webbsökning inte löser. GPQA-rapporten beskriver 448 flervalsfrågor inom biologi, fysik och kemi, skrivna och validerade av personer som har eller studerar till en doktorsexamen. Diamond är delmängden på 198 frågor där båda expertvaliderarna svarade rätt och de flesta icke-experter inte gjorde det.
Poängsättningen är ren träffsäkerhet. Varje fråga har fyra svarsalternativ, så slumpmässiga gissningar ger 25 %. På hela uppsättningen nådde experterna 65 % och kunniga icke-experter med obegränsad webbåtkomst 34 %.
Vad den inte säger en köpare av röstlösningar: nästan allt om ett samtal. Det finns inget samtal, ingen instruktion att följa, inget verktyg och ingen tidsgräns. Den är ett indirekt mått på resonemangsdjup. Med 198 frågor är små skillnader mellan modeller dessutom svaga belägg, och författarna anger datamängdens ringa storlek som en begränsning.
Vad mäter Retell vCX Benchmark?
Retell vCX Benchmark mäter hur modeller hanterar repliker i kontaktcentersamtal i fyra testsviter. Den aktuella topplistan, läst den 13 november 2026, beskriver dem så här:
- Instruktionsföljning: om modellen respekterar rollbegränsningar, affärsregler och regler för att avböja.
- Förankring: om svaren håller sig inom prompten, verktygen och den hämtade kontexten.
- Verktygsanrop: om modellen väljer rätt åtgärd och skickar giltiga argument.
- Vardagligt språk: om svaren låter naturliga, koncisa och säkra att läsa upp.
Varje svit rapporterar en andel godkända över ungefär 1 000 fall eller fler, och totalpoängen är genomsnittet av de fyra. Topplistan omfattade 62 poster för 45 modeller vid det datumet och visar medianlatens och kostnad per minut bredvid varje poäng.
Den publicerade metodbeskrivningen är inlägget om vCX-Hard, som täcker de två första testuppsättningarna, förankring och verktygsanrop. Fallen hämtades från produktionssamtal och valdes ut från olika organisationer så att ingen enskild kund dominerar. En panel av domarmodeller bedömer varje fall mot en bedömningsmall och en referenslösning. Inlägget betraktar rangordningen, snarare än den exakta siffran, som signalen.
Vad den inte säger en köpare av röstlösningar: det är en leverantörs benchmark, och leverantören har själv en post. Tell-1, Retells egen modell, ligger på plats 1 totalt i Retell vCX Benchmark (per november 2026). Fallen kommer från Retells trafik, så dina samtalstyper kan vara underrepresenterade eller saknas. De fyra sviterna poängsätter svar och verktygsanrop, så fel i taligenkänningen, avbrott och huruvida ett helt samtal slutar löst ligger utanför dem. Domarmodeller kan också ha fel.
Hur presterar Tell-1 på de här fyra benchmarkarna?
Tell-1, Retells egen LLM, är ett konkret exempel på hur man läser de fyra tillsammans. Retell redovisar de offentliga benchmarkpoängen nedan i sitt tekniska inlägg om Retell LLM, och vCX-siffrorna kommer från den aktuella topplistan, läst den 13 november 2026.
| Benchmark | Poäng för Tell-1 | Körningens omfattning | Vem som körde den |
|---|---|---|---|
| τ²-bench flyg | 72,0 | 50 uppgifter | Retell |
| τ²-bench detaljhandel | 78,0 | 50 uppgifter | Retell |
| Multi-IF | 82,1 | 504 samtal | Retell |
| GPQA Diamond | 83,5 | 198 frågor × 3 | Retell |
| Retell vCX Benchmark | 94,45 i genomsnitt, plats 1 totalt av 62 modellkonfigurationer | Fyra sviter, cirka 1 000 fall vardera | Retell |
Läs dem på det sätt som avsnitten ovan föreslår. Varje rad är Retells egen körning, poängsatt av 100 med samma giriga avkodning varje gång, och Retell uppger att ingen av benchmarkarna användes vid träningen. Multi-IF-körningen omfattar 504 av benchmarkens 4 501 samtal och τ²-bench-körningarna omfattar 50 uppgifter per domän, så de är inte direkt jämförbara med siffrorna i de ursprungliga rapporterna eller på andra topplistor.
I vCX skiljer sig poängen mellan sviterna: 96,6 % för vardagligt språk (plats 1), 97,2 % för förankring (plats 2), 88,6 % för instruktionsföljning (plats 2) och 95,4 % för verktygsanrop (plats 5). Andra modeller leder tre av de fyra sviterna. Samma försiktighet gäller här som för alla modeller: de här siffrorna ger Tell-1 en plats på en kortlista, och ett test på dina egna samtal avgör resten.
Vad missar benchmarkpoäng för dig som köper en AI-röstagent?
Benchmarkpoäng missar plattformen runt modellen och förutsättningarna i dina egna samtal. Ett telefonsamtal tillför taligenkänning, turtagning, talsyntes, telefoni och latens i varje steg. Ingen av de fyra benchmarkarna, i den form som beskrivs här, poängsätter något av detta.
Resultaten kan skilja sig mellan plattformar även när agenten är identisk. I en studie av testleverantören Cekura driftsattes en och samma agent oförändrad på sex röstplattformar, och arbetsflödespoängen varierade från 65,2 % till 95,7 %. Retells sammanfattning av Medicare-studien beskriver metoden och den redovisning av intressen som gäller för den.
Hur bör en köpare använda benchmarkpoäng?
Använd benchmarkpoäng för att ta fram en kortlista och fatta sedan beslutet utifrån dina egna samtal. En rimlig ordning:
- Matcha benchmarken mot risken: resultat för verktygsanvändning om en felaktig åtgärd är det kostsamma felet, instruktionsföljning om agenten måste hålla sig till ett långt manus.
- Kontrollera versionen, datumet och vem som körde testet.
- Föredra siffror från upprepade försök, som pass^k, när de redovisas.
- Bygg upp testet på nytt med dina egna scenarier, och räkna ett scenario som godkänt först när alla upprepade körningar blir godkända.
I Retell låter simuleringstester en AI spela uppringaren medan framgångskriterier bedömer varje körning som godkänd eller underkänd, och batchtester kör om sparade fall efter varje ändring av prompten. Efter lansering poängsätter AI QA ett urval av riktiga samtal på mått som hallucinationer och verktygsanvändning, och A/B-testning delar upp live-trafiken mellan två agenter. För val av modell, läs vilken LLM som ska driva din AI-röstagent. För köpprocessen, läs hur du utvärderar en plattform för AI-röstagenter.
En benchmark visar vilka modeller som förtjänar ett test. En pilot med riktiga samtal visar vilken du ska köra. Retell är en plattform för AI-röstagenter för kontaktcenter, med priser från 0,07 $ per minut, så att du kan pröva den på dina egna samtal innan du skriver på något.
Vanliga frågor
Vad är skillnaden mellan pass^1 och pass^k?
Pass^1 är andelen uppgifter som en agent löser på ett enda försök. Pass^k är andelen den löser i vart och ett av k upprepade försök på samma uppgift. Pass^k är alltid lika med eller lägre än pass^1, och skillnaden visar hur konsekvent agenten är.
Är τ-bench samma sak som τ²-bench?
Nej. τ-bench är den ursprungliga benchmarken från 2024 med domänerna flyg och detaljhandel. τ²-bench är uppföljaren från 2025 av samma grupp, som behåller verifierade versioner av de två domänerna och lägger till en telekomdomän där den simulerade kunden också använder verktyg.
Varför används ett naturvetenskapligt test som GPQA Diamond för att jämföra modeller för kundsamtal?
GPQA Diamond används som ett allmänt mått på resonemangsförmåga. Det säger inget direkt om samtal, verktyg eller tal. Se det som en kontroll av resonemangsdjup och förlita dig på uppgiftsbaserade benchmarks för resten.
Vilken benchmark är viktigast för en AI-röstagent?
Ingen av dem ensam. Verktygsanvändning enligt en policy, instruktionsföljning över flera repliker och förankring motsvarar arbetet i ett kontaktcenter bäst, så τ²-bench, Multi-IF och vCX Benchmark passar närmast. Ett bedömt test på dina egna samtalsscenarier är viktigare än någon av dem.
Hur presterade Tell-1 på τ²-bench, Multi-IF och GPQA Diamond?
Retell redovisar 72,0 på τ²-bench flyg, 78,0 på τ²-bench detaljhandel, 82,1 på Multi-IF och 83,5 på GPQA Diamond för Tell-1, var och en av 100. Det är Retells egna körningar på 50 uppgifter per τ²-bench-domän, 504 Multi-IF-samtal och de 198 frågorna i GPQA Diamond.
See how much your business could save by switching to AI-powered voice agents.
ROI Result
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Estimate your monthly voice AI cost
Read Other Blogs


Revolutionera din samtalsverksamhet med Retell


