نماذج LLM المتخصصة مقابل نماذج LLM العامة لمراكز التواصل





يُعدّ نموذج LLM العام نقطة البداية الأكثر أمانًا لمعظم مراكز التواصل. أما نموذج LLM المتخصص فيستحق مكانه حين يعمل نوع واحد من المكالمات بحجم كبير ويظل النموذج العام يُخفق بالطريقة نفسها القابلة للقياس: تأخر الكلمات الأولى، أو استدعاءات أدوات خاطئة، أو ردود تبدو كأنها صفحة ويب تُقرأ بصوت عالٍ. لا يتفوق أيٌّ منهما بحكم فئته. النموذج الذي ينبغي اختياره هو الذي ينجح في مكالماتك أنت، مرة تلو الأخرى، بتكلفة للدقيقة يمكنك التنبؤ بها.
هذا الدليل موجّه إلى القائد المسؤول عن خط الهاتف. تنشر منصّة Retell AI هذا الدليل، ولها مصلحة في الجانبين. إذ توفّر المنصّة نماذج عامة من OpenAI وAnthropic وGoogle، وتبني نموذجها الخاص: Tell-1، نموذج LLM الخاص بمنصّة Retell، المصمَّم لمكالمات مراكز التواصل. يحتل Tell-1 المرتبة الأولى إجمالًا في المعيار المرجعي العام لمنصّة Retell، وهو Retell vCX Benchmark (بتاريخ قراءة 13 نوفمبر 2026). تعامَل معه كأي معيار مرجعي يصدره مورّد: سببٌ لإدراجه في القائمة المختصرة، ثم أمرٌ ينبغي التحقق منه على مكالماتك.
ما الذي تتطلبه مكالمة مركز التواصل من النموذج اللغوي؟
تطلب مكالمة مركز التواصل من النموذج خمسة أمور في كل دور: اتباع نص طويل، واستدعاء الأدوات بشكل صحيح، والظهور بصوت طبيعي عند النطق، والإجابة بسرعة، والبقاء ضمن تكلفة معقولة على نطاق واسع.
- النصوص الطويلة. يتضمن الـprompt الخاص بالوكيل الخطوات والسياسات والاستثناءات لنوع المكالمة، وعلى النموذج تطبيق القاعدة الصحيحة في كل دور. وفي معيار Multi-IF، أخفقت جميع النماذج الـ14 التي جرى تقييمها في عدد أكبر من التعليمات مع كل دور إضافي.
- استدعاءات الأدوات. تتم الحجوزات وعمليات البحث والتحويلات عبر الأدوات، والاستدعاء الخاطئ يغيّر سجلًا حقيقيًا. ووجدت ورقة tau-bench الصادرة عام 2024 أن الوكلاء المعتمدين على استدعاء الدوال والمبنيين على نموذج عام رائد نجحوا في أقل من 50% من مهام خدمة العملاء فيها، واجتازوا جميع المحاولات الثماني المتكررة لمهمة بيع بالتجزئة في أقل من 25% من الحالات.
- الكلام الطبيعي. الرد يُسمع ولا يُقرأ. فالقوائم والرموز التي تصلح على الشاشة تبدو غير مناسبة بصوت اصطناعي.
- السرعة. يترك الناس فجوات قصيرة بين الأدوار. وتقدّر مراجعة لأبحاث تبادل الأدوار في الحديث الفجوة المعتادة بـنحو 200 ملّي ثانية. والنموذج مرحلة واحدة بين آخر كلمة للمتصل وأول كلمة للوكيل، لذا فإن الوقت الذي يستغرقه قبل بدء الرد يُسمع صمتًا.
- التكلفة على نطاق واسع. يُرسل كل دور النص والمحادثة حتى تلك اللحظة إلى النموذج مجددًا. ويخفض المزوّدون سعر هذا الإدخال المتكرر (إذ يذكر دليل prompt caching من OpenAI أن الإدخال المخزَّن مؤقتًا يحصل على خصم يصل إلى 95%)، لكن مع أحجام مراكز التواصل يتحول الفرق الصغير في الدقيقة إلى بند في الميزانية.
أين تناسب نماذج LLM العامة مراكز التواصل؟
تناسب نماذج LLM العامة على أفضل وجه الحالات التي تتنوع فيها المكالمات: أنواع كثيرة من المكالمات، ولغات عديدة، وأسئلة لم يُعدّ لها أحد نصًا. فهي مدرَّبة على نطاق واسع ويبيعها عدة مزوّدين، لذا يمكن للفريق تغيير النماذج مع تغيّر احتياجاته.
كما أنها تحتاج إلى عمل مخصّص أقل مما يفترضه كثير من المشترين. إذ يصف دليل تحسين النماذج من OpenAI حلقة من التقييمات (evals) وهندسة الـprompt، مع إضافة الضبط الدقيق «لبعض حالات الاستخدام». وكثير مما يُبقي الوكيل ملتزمًا بالنص يكمن في الـprompt وتدفق المكالمة والأدوات، وهذا العمل ينتقل معك عند تغيير النموذج.
تظهر الحدود على الهاتف. فأنماط الاستدلال التي تفكّر قبل الإجابة تضيف تأخيرًا قبل الكلمة الأولى. والنماذج المضبوطة للمحادثة المكتوبة تحتاج إلى توجيه عبر الـprompt لإبقاء الردود قصيرة وقابلة للنطق. والمزوّد هو من يحدد الجدول الزمني: إذ تمنح سياسة الإيقاف لدى OpenAI إشعارًا قبل 6 أشهر على الأقل من سحب أي نموذج متاح للعموم، وبعدها يجب التحقق من الوكيل على النموذج البديل. وللاطلاع على مقارنة لكل نموذج على حدة، راجع أي نموذج LLM ينبغي أن يشغّل وكيلك الصوتي بالذكاء الاصطناعي.
ما الذي يغيّره نموذج LLM المتخصص أو المضبوط بدقة؟
ينقل نموذج LLM المتخصص السلوك من الـprompt إلى تدريب النموذج. فبدلًا من توجيه نموذج عام إلى التحدث بإيجاز واتباع السياسة واستدعاء الأدوات في اللحظة المناسبة، يدرّب المورّد النموذج على أمثلة لذلك تحديدًا، وغالبًا على نموذج أصغر. وثمة ثلاثة مصطلحات يُخلط بينها كثيرًا:
- نموذج LLM الخاص بمجال معيّن أو القطاعي يدرّبه مورّد أو يضبطه لقطاع أو وظيفة واحدة ويقدّمه لجميع عملائه.
- النموذج المضبوط بدقة هو نموذج أساسي خضع لتدريب إضافي على مجموعة بيانات أضيق، غالبًا ما تكون بياناتك أنت. ويشرح مدخل المسرد حول الضبط الدقيق لنماذج الذكاء الاصطناعي آليات ذلك.
- نموذج LLM المخصّص يعني عادةً أي نموذج تجلبه بنفسك إلى منصّة ما، سواء كان مضبوطًا أم لا.
يقدّم دليل دقة نماذج LLM من OpenAI سببين للضبط الدقيق: تحسين الدقة في مهمة محددة، وتحسين الكفاءة، أي تحقيق الدقة نفسها بعدد أقل من الـtokens أو باستخدام نموذج أصغر. وفي المكالمات، قد يعني ذلك اتباعًا أكثر ثباتًا للنص، وprompts أقصر، وتكلفة أقل للدقيقة.
الفكرة ليست جديدة. فقد أعلنت Observe.AI عن Contact Center LLM في يونيو 2023، وتصفه بأنه نموذج يضم 30 مليار معامل ومدرَّب على مجموعة بيانات خاصة بالمجال تضم مئات الملايين من تفاعلات العملاء. وتستند مكاسب الدقة الواردة في ذلك الإعلان إلى معايير أولية أجراها المورّد بنفسه. وهذا أمر معتاد في هذه الفئة، ولهذا السبب يكتسب تقييمك الخاص أهمية تفوق أي إعلان.
ما المفاضلات بين الخيارين؟
تتمثل المفاضلات في الارتباط بمورّد واحد، والتغطية، وعبء التقييم، وكلٌّ منها يعمل في الاتجاهين.
| العامل | نموذج LLM العام | نموذج LLM المتخصص أو المضبوط بدقة |
|---|---|---|
| الأنسب لـ | أنواع مكالمات متنوعة، ولغات عديدة، وأسئلة خارج النص | نوع واحد من المكالمات بحجم كبير وقواعد مستقرة |
| سلوك النص والأدوات | يحدده الـprompt وتدفق المكالمة | مُضمَّن بالتدريب، لذا يلزم prompt أقل |
| السرعة والتكلفة للدقيقة | تعتمد على حجم النموذج ونمط الاستدلال | قد تكون أقل حين يكون النموذج أصغر |
| الارتباط بمورّد واحد | عدة مزوّدين، يسحب كلٌّ منهم النماذج وفق جدوله الخاص | غالبًا مورّد واحد أو منصّة واحدة |
| التغطية | واسعة | أضيق خارج بيانات التدريب |
| الأدلة المتاحة لك | معايير مرجعية عامة، قليل منها يخص المكالمات الهاتفية | غالبًا المعيار المرجعي الخاص بالمورّد |
| عبء التقييم | إعادة فحص كلما سُحب نموذج | فحص قبل الاعتماد وبعد كل إعادة تدريب |
الارتباط بمورّد واحد. غالبًا ما يبيع النموذجَ المتخصص مورّدٌ واحد، وأحيانًا داخل منصّة واحدة. اسأل عمّا إذا كان بإمكانك تبديل النماذج دون إعادة بناء الوكيل، وعمّا إذا كانت الـprompts والتدفقات وحالات الاختبار تظل ملكًا لك. وتحمل النماذج العامة صورة أخفّ من الخطر نفسه حين يسحب المزوّد إصدارًا ما.
التغطية. قد يكون النموذج المدرَّب على مكالمات المواعيد باللغة الإنجليزية أضعف بالإسبانية، أو في نزاع على فاتورة لم يصادفه من قبل. اطلب النتائج حسب اللغة وحسب نوع المكالمة، لا متوسطًا عامًا.
عبء التقييم. نادرًا ما تقيس المعايير المرجعية العامة المكالمات الهاتفية، والمعيار المرجعي للمورّد دليلٌ اختاره البائع. وإذا ضبطت نموذجك الخاص بدقة، يزداد العبء. إذ ينص دليل الدقة من OpenAI على أن أمثلة التدريب «يجب أن تمثّل تمامًا ما سيراه النموذج في العالم الحقيقي»، ويوصي بمجموعة بيانات محجوزة (hold-out) لاكتشاف الإفراط في التخصيص (overfitting).
كيف تقيّم أيًّا من النموذجين على مكالماتك؟
قيّم كليهما بالطريقة نفسها: سيناريوهات ثابتة مستمدة من مكالماتك، تُقيَّم وفق معايير نجاح مكتوبة، وتُشغَّل أكثر من مرة، ثم تقسيم لحركة المكالمات الحية.
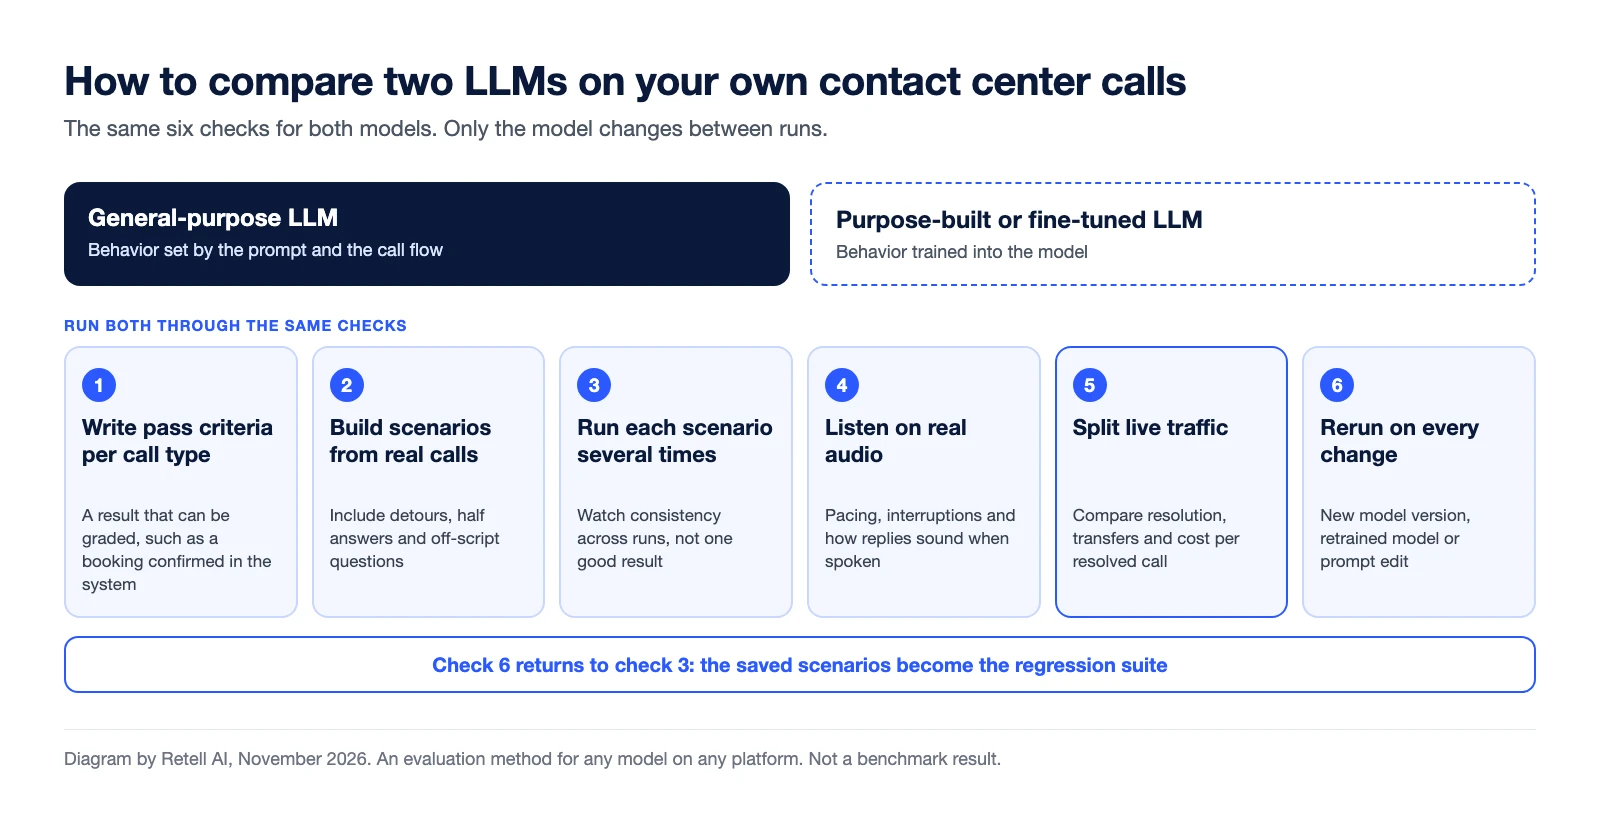
- اكتب معايير النجاح لكل نوع مكالمة. يمكن تقييم «حُجز الموعد في نظام الجدولة وتم تأكيده للمتصل». أما «بدا جيدًا» فلا يمكن.
- ابنِ سيناريوهات من مكالمات حقيقية. ضمّنها الانعطافات: المتصل الذي يغيّر رأيه، أو يطرح سؤالًا خارج النص، أو يقدّم نصف إجابة.
- شغّل كل سيناريو عدة مرات على كل نموذج. اقترح مؤلفو tau-bench مقياس pass^k لقياس الموثوقية عبر المحاولات المتكررة.
- استمع إلى صوت حقيقي. تغفل النتائج النصية الإيقاع والمقاطعات وكيف يبدو الرد عند نطقه.
- قسّم حركة المكالمات الحية. أرسل حصة من المكالمات إلى كل خيار، وقارن معدل الحل والتحويلات والتكلفة لكل مكالمة محلولة.
- أعِد التشغيل عند كل تغيير. إصدار نموذج جديد، ونموذج أُعيد تدريبه، وتعديل في الـprompt، كلها تستدعي مجموعة الاختبارات نفسها.
على منصّة Retell، يقيّم اختبار المحاكاة كل تشغيل بالنجاح أو الإخفاق وفق معايير النجاح، وتعيد الاختبارات المجمّعة تشغيل الحالات المحفوظة كمجموعة اختبارات انحدار، ويقسّم اختبار A/B حركة المكالمات بين الوكلاء بنسب مئوية. وتذكر الوثائق أنه يمكنك تبديل النماذج لاحقًا دون إعادة كتابة الـprompt. وإذا جلبت نموذجك الخاص، فلا تنطبق اختبارات المحاكاة والاختبارات المجمّعة، وتكون مكالمات الويب والهاتف هي وسيلة فحصه. وللاطلاع على التجربة الأوسع، راجع كيفية تقييم منصّة وكلاء صوتيين بالذكاء الاصطناعي قبل الإطلاق.
أين يقع Tell-1 في هذه المقارنة؟
Tell-1، نموذج LLM الخاص بمنصّة Retell، هو نموذج متخصص لمكالمات مراكز التواصل، لذا تنطبق عليه كل مفاضلة في هذا الدليل. وإليك موقعه في كلٍّ منها، مع مصدر كل رقم.
- النصوص والأدوات والكلام. في Retell vCX Benchmark، يبلغ متوسط Tell-1 94.45 ويحتل المرتبة الأولى إجمالًا. وحسب كل مجموعة اختبارات، يسجّل 88.6% في اتباع التعليمات (المرتبة 2)، و97.2% في الاستناد إلى المصادر (grounding) (المرتبة 2)، و95.4% في استدعاء الأدوات (المرتبة 5)، و96.6% في الكلام العامّي (المرتبة 1)، وكلها بتاريخ قراءة 13 نوفمبر 2026. تُشغّل منصّة Retell هذا المعيار المرجعي، لذا استخدمه كما يقترح هذا الدليل: سببًا لإدراجه في القائمة المختصرة.
- السرعة. لديه أدنى زمن استجابة وسيط في اللوحة، عند 76 ms (بتاريخ قراءة 13 نوفمبر 2026). وهذا رقم النموذج في المعيار المرجعي، وليس زمن الاستجابة الكامل للمكالمة من طرف إلى طرف.
- التكلفة. يدرجه المعيار المرجعي بسعر 3.5 سنت للدقيقة. وهذا بند LLM فقط، وليس سعر المكالمة، كما أن بعض إعدادات النماذج العامة في اللوحة تكلّف أقل. وتبدأ أسعار منصّة Retell من $0.07 للدقيقة.
- آلية العمل. يبدأ النموذج رده ويواصل الاستدلال أثناء تشغيل الكلمات الأولى. ويذكر المقال التقني Retell LLM: Interleaved Reasoning for Real-Time Voice Agents نحو 200 token استدلال في منتصف الرد في المتوسط، ويصف مراحل التدريب الثلاث التي يقوم عليها.
- الارتباط بمورّد واحد. يُقدَّم Tell-1 داخل منصّة Retell. ويوجد في أداة اختيار النماذج نفسها مع نماذج من OpenAI وAnthropic وGoogle، وتذكر وثائق منصّة Retell أنه يمكنك تبديل النماذج لاحقًا دون إعادة كتابة الـprompt، لذا فإن اختياره لا يغلق الباب أمام النماذج الأخرى.
- التغطية. النموذج المبني للمكالمات أضيق نطاقًا بحكم تصميمه. شغّل Tell-1 على لغاتك وأنواع مكالماتك قبل الاعتماد عليه، واحتفظ بنموذج عام لأي نوع مكالمة يأتي فيه Tell-1 في المرتبة الثانية.
- التقييم. تنطبق الفحوصات الستة أعلاه دون تغيير. ولأن Tell-1 نموذج تديره منصّة Retell، فإن اختبارات المحاكاة والاختبارات المجمّعة تعمل معه، ويمكن لتقسيم A/B إرسال حركة المكالمات نفسها إلى نسختين من الوكيل لا تختلفان إلا في النموذج.
الخلاصة المنصفة: Tell-1 هو الخيار المتخصص الذي ينبغي إدراجه في قائمتك المختصرة إذا كنت تعمل على منصّة Retell، والنماذج العامة المتاحة بجانبه هي المجموعة الضابطة. راجع Tell-1 لتفاصيل المنتج.
الأسئلة الشائعة
ما نموذج LLM المتخصص؟
نموذج LLM المتخصص هو نموذج لغوي مدرَّب أو مضبوط لأداء مهمة واحدة، مثل التعامل مع مكالمات مراكز التواصل، بدلًا من الاستخدام العام. ويُسمّى أيضًا نموذج LLM خاصًا بمجال معيّن أو قطاعيًا. أما النموذج اللغوي الكبير العام فيُكيَّف للمهمة عبر الـprompts والأدوات.
هل نماذج LLM المتخصصة أدق من نماذج LLM العامة؟
في المهمة التي دُرّبت عليها، قد تكون كذلك. أما خارجها، فغالبًا لا. ومعظم المقارنات المنشورة تأتي من المورّد الذي بنى النموذج، لذا شغّل كليهما على سيناريوهاتك الخاصة.
هل يحتاج مركز التواصل إلى تدريب نموذج LLM خاص به؟
عادةً لا. يبدأ دليل التحسين من OpenAI بالتقييمات وهندسة الـprompt، ولا يضيف الضبط الدقيق إلا لبعض حالات الاستخدام. كما أن تدريب نموذجك الخاص يعني امتلاك بيانات التدريب ومجموعة بيانات محجوزة.
هل نموذج LLM المخصّص هو نفسه النموذج المضبوط بدقة؟
ليس دائمًا. في معظم المنصات الصوتية، نموذج LLM المخصّص هو أي نموذج تستضيفه وتربطه بنفسك، وقد يكون مضبوطًا بدقة أو لا. ويربط خيار نموذج LLM المخصّص في منصّة Retell نموذجك الخاص عبر WebSocket، بينما تتولى منصّة Retell الاتصالات الهاتفية والنسخ وتبادل الأدوار.
هل يمكن لمركز التواصل استخدام أكثر من نموذج LLM؟
نعم. على منصّة Retell، لكل وكيل إعداد النموذج الخاص به، وتصف وثائق إعدادات LLM آلية fallback سريعة تشغّل نموذجًا احتياطيًا إلى جانب النموذج الأساسي.
هل Tell-1 نموذج LLM متخصص؟
نعم. Tell-1 هو نموذج LLM الخاص بمنصّة Retell، المبني لمكالمات مراكز التواصل. ويحتل المرتبة الأولى إجمالًا في Retell vCX Benchmark بمتوسط 94.45 (بتاريخ قراءة 13 نوفمبر 2026). وهو خيار واحد ضمن أداة اختيار النماذج في منصّة Retell، إلى جانب نماذج عامة من OpenAI وAnthropic وGoogle.
قارن النماذج على مكالماتك قبل الالتزام
تُعدّ منصّة Retell منصّةً لوكلاء صوتيين بالذكاء الاصطناعي مخصّصة لمراكز التواصل. لكل وكيل أداة لاختيار النموذج، وتعرض صفحة الأسعار نماذج من OpenAI وAnthropic وGoogle إلى جانب خيار مخصّص لنموذج تستضيفه بنفسك. ويوجد Tell-1، نموذج LLM الخاص بمنصّة Retell، في أداة الاختيار نفسها. ويمكن للأشخاص الأقرب إلى عملائك تغيير النموذج وإعادة تشغيل مجموعة الاختبارات وتقسيم حركة المكالمات بأنفسهم. وعلى عكس العمل مع مورّد ذكاء اصطناعي مُدار، لا يتحول هذا التغيير إلى تذكرة أو قائمة انتظار أو SOW جديد. والتسعير قائم على الاستخدام، بدءًا من $0.07 للدقيقة على صفحة الأسعار. اختر نوع مكالمة واحدًا ومعايير النجاح الخاصة بك، وشغّل تجربة على مكالمات حقيقية قبل أن توقّع على أي شيء.
See how much your business could save by switching to AI-powered voice agents.
ROI Result
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Estimate your monthly voice AI cost
Read Other Blogs


أحدث ثورة في مركز الاتصال لديك مع Retell


