شرح معايير تقييم الوكلاء الصوتيين بالذكاء الاصطناعي





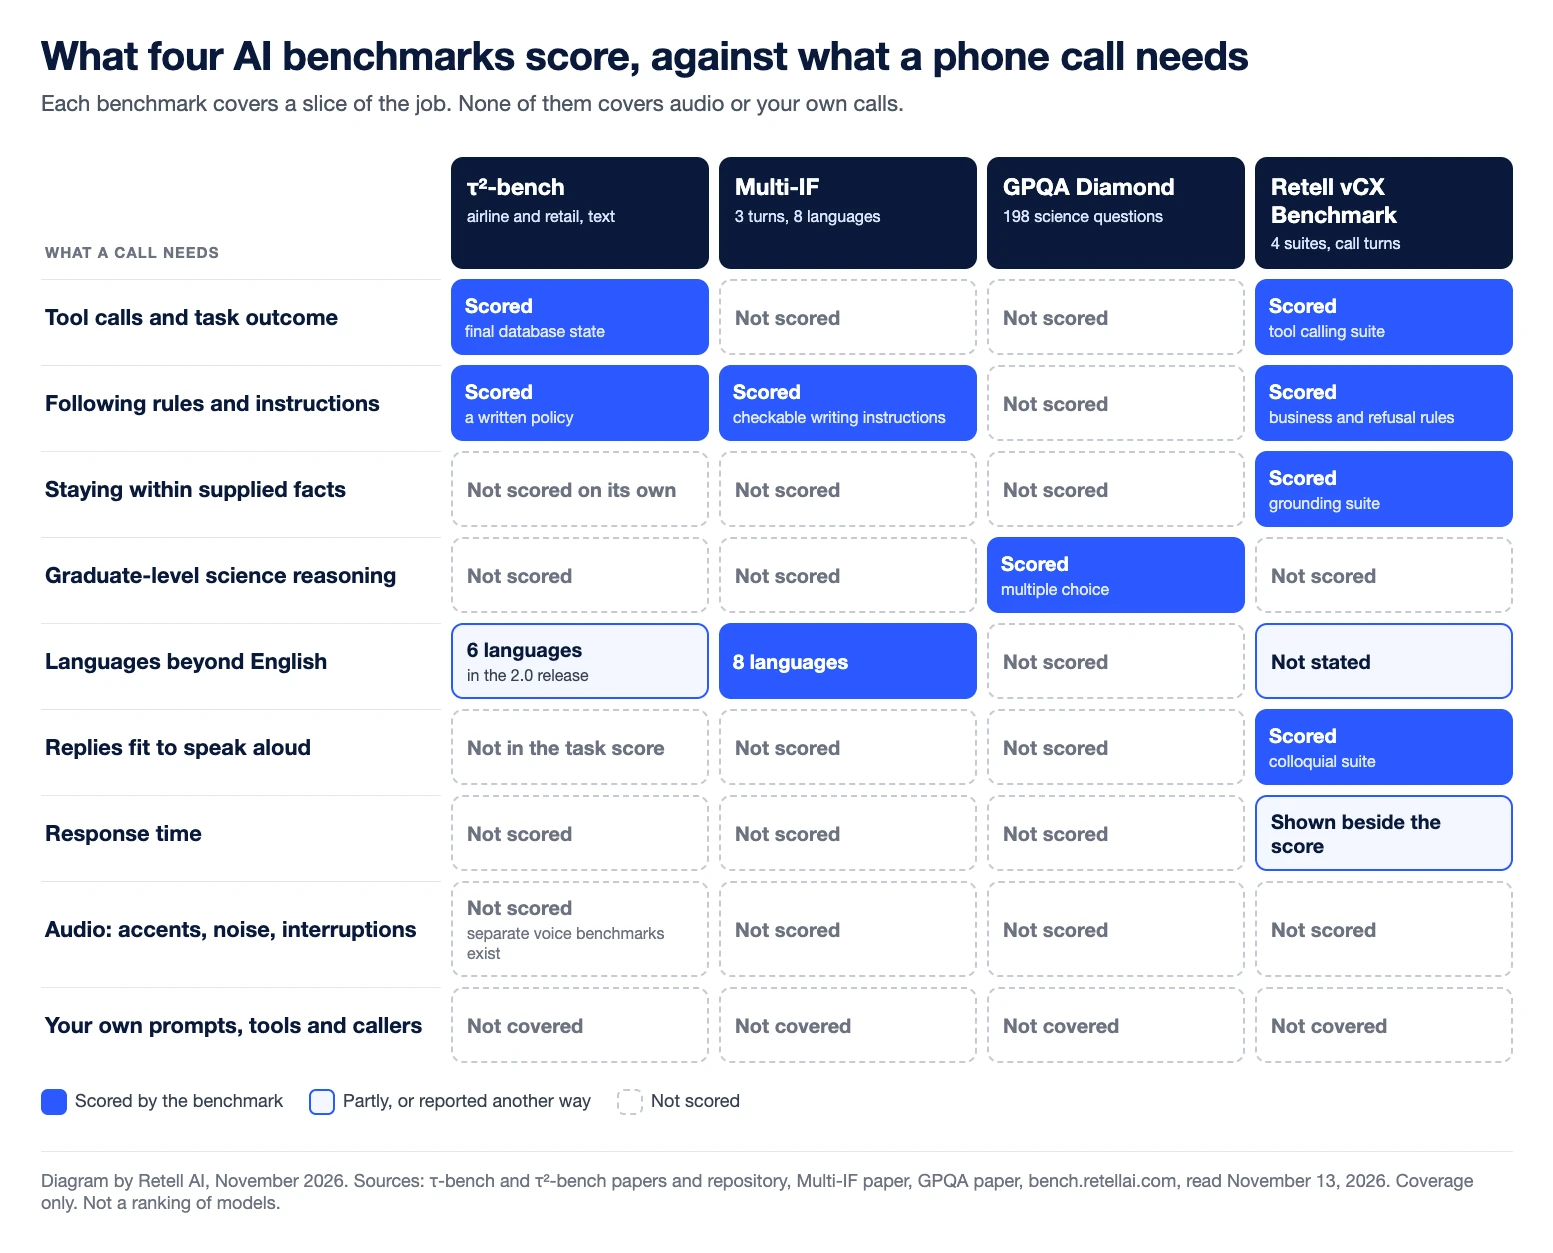
معيار تقييم وكلاء الذكاء الاصطناعي (Benchmark) هو مجموعة ثابتة من المهام مقترنة بقاعدة تقييم، تُستخدم لمقارنة النماذج على العمل نفسه. وبالنسبة إلى الوكلاء الصوتيين بالذكاء الاصطناعي، هناك أربعة معايير جديرة بالمعرفة: τ²-bench (tau2-bench) لاستخدام الأدوات وفق سياسة محددة، وMulti-IF لاتباع التعليمات عبر أدوار المحادثة، وGPQA Diamond للاستدلال المعقّد، وRetell vCX Benchmark لمكالمات مراكز التواصل. ويقيس كل منها جانبًا واحدًا فقط مما يجري خلال المكالمة الهاتفية.
يشرح هذا الدليل ما يختبره كل معيار، وكيف تُحتسب نتيجته، وما الذي لا تخبرك به هذه النتيجة. تنشر منصّة Retell AI هذا الدليل، كما تنشر أحد المعايير الأربعة، وهو vCX Benchmark. وتتغيّر النتائج مع كل إصدار جديد للنماذج، لذا يتضمن كل قسم رابطًا إلى المصدر الذي يعرض أحدث النتائج.
ما هو معيار تقييم وكلاء الذكاء الاصطناعي؟
يمنح معيار التقييم كل نموذج المهام نفسها والمُقيِّم نفسه، ثم يبيّن عدد المرات التي ينجز فيها النموذج المهمة بشكل صحيح. ويتوقف معنى النتيجة على طبيعة المهمة، وعلى من يؤدي دور الطرف الآخر في المحادثة أو ما يؤديه، وعلى طريقة تحديد النجاح.
تنقسم أدوات التقييم إلى ثلاثة أنواع. يقارن فحص الحالة نتيجة إجراءات الوكيل بنتيجة صحيحة معروفة، مثل حالة قاعدة البيانات بعد عملية استرداد مبلغ. ويُشغّل فحص القواعد نصًا برمجيًا على الرد. أما النموذج الحَكَم فيُقيّم الرد وفق معايير تقييم محددة. فحوص الحالة والقواعد قابلة للتكرار لكنها ضيقة النطاق، بينما تستطيع النماذج الحَكَم تقييم النبرة والمعنى، لكن لها نقاط عمياء خاصة بها.
ما الذي تقيسه المعايير الأربعة عند مقارنتها جنبًا إلى جنب؟
تغطي هذه المعايير مهارات مختلفة، وvCX Benchmark هو الوحيد المبني على مكالمات هاتفية. يلخّص الجدول كل معيار استنادًا إلى ورقته البحثية أو مستودعه أو لوحة صدارته، وفق ما اطُّلع عليه في 13 نوفمبر 2026.
| معيار التقييم | الجهة الناشرة | طبيعة المهمة | طريقة التقييم | ما يُغفله لمشتري الحلول الصوتية |
|---|---|---|---|---|
| τ²-bench، قطاعا الطيران والتجزئة | Sierra | خدمة عميل مُحاكى في محادثة نصية، باستخدام الأدوات واتباع سياسة مكتوبة | 0 أو 1 لكل محادثة: يجب أن تطابق قاعدة البيانات النهائية الحالة المستهدفة وأن تُقدَّم المعلومات المطلوبة | الصوت، وزمن الاستجابة، وسياستك وأدواتك الخاصة |
| Multi-IF | Meta | اتباع تعليمات كتابية قابلة للتحقق عبر ثلاثة أدوار، بثماني لغات | متوسط أربعة مقاييس للدقة، على مستوى التعليمة وعلى مستوى المحادثة، وفق معيار صارم وآخر مرن | الأدوات، والنصوص الطويلة، والأداء المنطوق |
| GPQA Diamond | باحثون من NYU وCohere وAnthropic | الإجابة عن 198 سؤالًا علميًا متعدد الخيارات كتبها خبراء | نسبة الأسئلة المُجاب عنها بشكل صحيح، مع 25% كنسبة للتخمين العشوائي | المحادثة، والأدوات، والتعليمات، والسرعة |
| Retell vCX Benchmark | Retell AI | التعامل مع أدوار المحادثة في مكالمات مراكز التواصل عبر أربع مجموعات اختبار | معدل النجاح لكل مجموعة، ثم يُحسب متوسطها في نتيجة واحدة | الصوت، وأنواع مكالماتك الخاصة، والنتائج على مستوى المكالمة الكاملة |
ما الذي يقيسه τ²-bench في قطاعي الطيران والتجزئة؟
يقيس τ²-bench قدرة الوكيل على إنجاز مهمة خدمة عملاء عبر المحادثة مع اتباع سياسة مكتوبة واستدعاء الأدوات الصحيحة. يؤدي نموذج لغوي دور العميل، بينما يعمل الوكيل على قاعدة بيانات تجريبية للطلبات أو الحجوزات. وقد بنت الورقة البحثية الأصلية لـ τ-bench القطاعين بواقع 115 مهمة للتجزئة و50 مهمة للطيران. وتعيد الورقة البحثية لـ τ²-bench استخدام نسخ مُتحقَّق منها من كليهما، وتضيف قطاع الاتصالات.
التقييم صارم. ووفقًا لـملاحظات التقييم في المستودع، فإن مكافأة كل مهمة هي حاصل ضرب نتائج فحوصها. وبشكل افتراضي، تتمثل هذه الفحوص في فحص لقاعدة البيانات يقارن قاعدة البيانات النهائية بالحالة المستهدفة، وفحص للتواصل يتأكد من أن الوكيل قدّم للعميل المعلومات المطلوبة. وأي تسلسل من استدعاءات الأدوات يصل إلى الحالة النهائية الصحيحة يُعدّ ناجحًا.
هناك رقمان مهمّان. يمثّل Pass^1 نسبة المهام المُنجزة من المحاولة الأولى. ويمثّل Pass^k نسبة المهام المُنجزة في جميع المحاولات المتكررة البالغ عددها k، وهو مقياس قدّمته الورقة الأصلية لرصد مدى الاتساق. وقد أفادت تلك الورقة الصادرة عام 2024 بأن حتى أفضل الوكلاء القائمين على استدعاء الدوال في ذلك الوقت نجحوا في أقل من نصف المهام، مع pass^8 دون 25% في قطاع التجزئة.
ما لا يخبر به مشتري الحلول الصوتية: تأتي النتائج النصية لقطاعي الطيران والتجزئة من محادثات مكتوبة بلا صوت ولا مقاطعات ولا قيود زمنية. كما أن السياسات والأدوات خاصة بالمعيار نفسه. والعميل المُحاكى هو أيضًا نموذج، وقد قاس مؤلفو τ²-bench معدلات خطأ المُحاكي فبلغت 40% في التجزئة و47% في الطيران، منها 12% و13% أخطاء جسيمة بما يكفي لتعطيل المهمة. ويتضمن المستودع نفسه الآن معايير صوتية منفصلة، ويضيف إصداره 2.0 ست لغات ويشير إلى أن نتائجه غير قابلة للمقارنة مع لوحة صدارة الإصدار 1.x. لذا تحقّق من الإصدار الذي تستند إليه أي نتيجة مُقتبسة.
ما الذي يقيسه Multi-IF؟
يقيس Multi-IF مدى استمرار النموذج في اتباع التعليمات مع تقدّم المحادثة، وما إذا كان ذلك ينطبق خارج اللغة الإنجليزية. وتوسّع الورقة البحثية لـ Multi-IF الصادرة عن Meta اختبارًا سابقًا أحادي الدور يُدعى IFEval، ليشمل 4,501 محادثة من ثلاثة أدوار لكل منها بثماني لغات: الإنجليزية والفرنسية والروسية والهندية والإيطالية والبرتغالية والإسبانية والصينية.
صِيغت التعليمات بحيث يمكن التحقق منها، مثل حظر استخدام الفواصل أو اشتراط الإجابة بأحرف كبيرة. وتمثّل النتيجة الرئيسية متوسط أربعة مقاييس للدقة. تحتسب الدقة على مستوى التعليمة كل تعليمة على حدة، بينما لا تحتسب الدقة على مستوى المحادثة أي محادثة إلا إذا اتُّبعت كل التعليمات حتى ذلك الدور. ويُبلَّغ عن كل منهما وفق معيار صارم وآخر مرن.
النتيجة الرئيسية للورقة هي سبب أهمية هذا المعيار للوكلاء الهاتفيين: فقد تزايدت إخفاقات كل نموذج من النماذج الأربعة عشر المُختبرة مع كل دور إضافي. إذ تراجع أحد النماذج من 0.877 في الدور الأول إلى 0.707 في الدور الثالث. والوكيل الذي يتبع قاعدة في بداية المكالمة ثم يتخلى عنها بعد بضعة تبادلات يُخفق بالطريقة نفسها.
ما لا يخبر به مشتري الحلول الصوتية: التعليمات هي قيود تنسيق وكتابة على النص، مثل الطول وعلامات الترقيم والكلمات المفتاحية، وليست قواعد عمل. ولا توجد أدوات، كما أن ثلاثة أدوار تُعدّ قصيرة مقارنةً بمكالمة حقيقية، ولا يُنطق أي شيء بصوت عالٍ.
ما الذي يقيسه GPQA Diamond؟
يقيس GPQA Diamond قدرة النموذج على الإجابة عن أسئلة علمية بالغة الصعوبة لا يحلّها البحث على الويب. وتصف الورقة البحثية لـ GPQA مجموعة من 448 سؤالًا متعدد الخيارات في الأحياء والفيزياء والكيمياء، كتبها وتحقّق منها أشخاص حاصلون على الدكتوراه أو يدرسون للحصول عليها. وDiamond هي المجموعة الفرعية المكوّنة من 198 سؤالًا أجاب عنها كلا المُحقِّقَين الخبيرين بشكل صحيح، بينما أخفق فيها معظم غير الخبراء.
التقييم يعتمد على الدقة البسيطة. لكل سؤال أربعة خيارات، لذا يحقق التخمين العشوائي 25%. وعلى المجموعة الكاملة، بلغ الخبراء 65%، وبلغ غير الخبراء المهرة الذين أُتيح لهم الوصول غير المقيّد إلى الويب 34%.
ما لا يخبر به مشتري الحلول الصوتية: كل ما يتعلق بالمكالمة تقريبًا. فلا محادثة ولا تعليمات يجب اتباعها ولا أدوات ولا قيود زمنية. إنه مؤشر غير مباشر على عمق الاستدلال. ومع 198 سؤالًا فقط، تُعدّ الفروق الصغيرة بين النماذج دليلًا ضعيفًا، وقد ذكر المؤلفون صغر حجم مجموعة البيانات ضمن القيود.
ما الذي يقيسه Retell vCX Benchmark؟
يقيس Retell vCX Benchmark كيفية تعامل النماذج مع أدوار المحادثة في مكالمات مراكز التواصل عبر أربع مجموعات اختبار. وتصفها لوحة الصدارة المباشرة، وفق ما اطُّلع عليه في 13 نوفمبر 2026، على النحو التالي:
- اتباع التعليمات: مدى التزام النموذج بقيود الدور وقواعد العمل وقواعد الرفض.
- الالتزام بالمعلومات (Grounding): مدى بقاء الإجابات ضمن حدود الـ prompt والأدوات والسياق المُسترجَع.
- استدعاء الأدوات: مدى اختيار النموذج للإجراء الصحيح وتمريره وسائط صالحة.
- الأسلوب العامّي (Colloquial): مدى كون الردود طبيعية وموجزة وآمنة للنطق بصوت عالٍ.
تُبلّغ كل مجموعة عن معدل نجاح يستند إلى نحو 1,000 حالة أو أكثر، والنتيجة الإجمالية هي متوسط المجموعات الأربع. وقد أدرجت لوحة الصدارة 62 إدخالًا تشمل 45 نموذجًا في ذلك التاريخ، وتعرض بجانب كل نتيجة متوسط زمن الاستجابة والتكلفة لكل دقيقة.
ملاحظة المنهجية المنشورة هي منشور vCX-Hard، الذي يغطي أول مجموعتي اختبار، وهما الالتزام بالمعلومات واستدعاء الأدوات. استُخرجت الحالات من مكالمات حقيقية في بيئة الإنتاج، وأُخذت عيّناتها من مؤسسات متعددة بحيث لا يهيمن عليها عميل واحد. وتقيّم لجنة من النماذج الحَكَم كل حالة وفق معايير تقييم وحلّ مرجعي. ويَعُدّ ذلك المنشور الترتيب، أكثر من الرقم الدقيق، هو المؤشر الحقيقي.
ما لا يخبر به مشتري الحلول الصوتية: إنه معيار صادر عن مزوّد، وللمزوّد إدخال فيه. إذ يحتل Tell-1، النموذج الخاص بمنصّة Retell، المرتبة الأولى إجمالًا في Retell vCX Benchmark (حتى نوفمبر 2026). وتأتي الحالات من حركة مرور Retell، لذا قد تكون أنواع مكالماتك ممثّلة بشكل محدود أو غائبة تمامًا. كما تقيّم المجموعات الأربع الردود واستدعاءات الأدوات، وبالتالي فإن أخطاء التعرّف على الكلام والمقاطعات ومدى انتهاء المكالمة كاملةً بحلّ المشكلة تقع خارج نطاقها. كما أن النماذج الحَكَم قد تُخطئ أيضًا.
ما نتائج Tell-1 في هذه المعايير الأربعة؟
يُعدّ Tell-1، نموذج LLM الخاص بمنصّة Retell، مثالًا تطبيقيًا على قراءة المعايير الأربعة معًا. تُعلن منصّة Retell نتائج المعايير العامة أدناه في منشورها التقني حول Retell LLM، بينما تأتي أرقام vCX من لوحة الصدارة المباشرة، وفق ما اطُّلع عليه في 13 نوفمبر 2026.
| معيار التقييم | نتيجة Tell-1 | حجم الاختبار | الجهة المنفّذة |
|---|---|---|---|
| τ²-bench، قطاع الطيران | 72.0 | 50 مهمة | Retell |
| τ²-bench، قطاع التجزئة | 78.0 | 50 مهمة | Retell |
| Multi-IF | 82.1 | 504 محادثات | Retell |
| GPQA Diamond | 83.5 | 198 سؤالًا × 3 | Retell |
| Retell vCX Benchmark | متوسط 94.45، المرتبة الأولى إجمالًا من بين 62 إعدادًا للنماذج | أربع مجموعات اختبار، نحو 1,000 حالة لكل منها | Retell |
اقرأ هذه النتائج بالطريقة التي تقترحها الأقسام السابقة. فكل صف هو اختبار أجرته منصّة Retell بنفسها، مُقيَّم من 100 باستخدام فك الترميز الجشع (greedy decoding) نفسه في كل مرة، وتؤكد المنصّة أن أيًّا من هذه المعايير لم يُستخدم في التدريب. ويغطي اختبار Multi-IF عدد 504 من أصل 4,501 محادثة في المعيار، وتغطي اختبارات τ²-bench عدد 50 مهمة لكل قطاع، لذا فهي غير قابلة للمقارنة المباشرة مع الأرقام الواردة في الأوراق البحثية الأصلية أو في لوحات الصدارة الأخرى.
وفي vCX، تتفاوت نتائج المجموعات: 96.6% في الأسلوب العامّي (المرتبة 1)، و97.2% في الالتزام بالمعلومات (المرتبة 2)، و88.6% في اتباع التعليمات (المرتبة 2)، و95.4% في استدعاء الأدوات (المرتبة 5). وتتصدّر نماذج أخرى ثلاثًا من المجموعات الأربع. وينطبق هنا الحذر نفسه الذي ينطبق على أي نموذج: تمنح هذه الأرقام Tell-1 مكانًا في القائمة المختصرة، بينما يحسم تجريبه على مكالماتك الخاصة بقية القرار.
ما الذي تُغفله نتائج معايير التقييم لمشتري الوكلاء الصوتيين بالذكاء الاصطناعي؟
تُغفل نتائج معايير التقييم المنصّة المحيطة بالنموذج وظروف مكالماتك الخاصة. فالمكالمة الهاتفية تضيف التعرّف على الكلام، وتبادل الأدوار، وتحويل النص إلى كلام، والاتصالات الهاتفية، وزمن الاستجابة في كل مرحلة. ولا يقيّم أيٌّ من المعايير الأربعة، بالصيغة الموصوفة هنا، هذه الجوانب.
قد تختلف النتائج باختلاف المنصّة حتى عندما يكون الوكيل نفسه. ففي دراسة أجرتها Cekura، وهي شركة متخصصة في الاختبارات، نُشر وكيل واحد دون أي تعديل على ست منصّات صوتية، وتراوحت نتائج سير العمل بين 65.2% و95.7%. ويغطي ملخّص Retell لدراسة Medicare تلك المنهجية والإفصاح المتعلق بها.
كيف ينبغي للمشتري استخدام نتائج معايير التقييم؟
استخدم نتائج معايير التقييم لإعداد قائمة مختصرة، ثم اتخذ قرارك بناءً على مكالماتك الخاصة. إليك ترتيبًا منطقيًا:
- طابِق المعيار مع المخاطر: نتائج استخدام الأدوات إذا كان الإجراء الخاطئ هو الإخفاق المُكلف، واتباع التعليمات إذا كان على الوكيل الالتزام بنص طويل.
- تحقّق من الإصدار والتاريخ والجهة التي أجرت الاختبار.
- فضّل الأرقام المستندة إلى محاولات متكررة مثل pass^k عند توفرها.
- أعِد بناء الاختبار على سيناريوهاتك الخاصة، ولا تعتبر السيناريو ناجحًا إلا إذا نجحت جميع مرات تشغيله المتكررة.
على منصّة Retell، يتيح اختبار المحاكاة للذكاء الاصطناعي أداء دور المتصل بينما تُقيّم معايير النجاح كل تشغيل بالنجاح أو الإخفاق، وتُعيد الاختبارات المجمّعة تشغيل الحالات المحفوظة بعد كل تغيير في الـ prompt. وبعد الإطلاق، تُقيّم ميزة AI QA عيّنة من المكالمات الحقيقية وفق مقاييس مثل الهلوسة واستخدام الأدوات، بينما يوزّع اختبار A/B حركة المرور المباشرة بين وكيلين. ولاختيار النموذج، اطّلع على أيّ نموذج LLM ينبغي أن يُشغّل وكيلك الصوتي بالذكاء الاصطناعي. ولعملية الشراء، اطّلع على كيفية تقييم منصّة وكلاء صوتيين بالذكاء الاصطناعي.
يخبرك معيار التقييم بالنماذج التي تستحق التجربة، بينما يخبرك التشغيل التجريبي على مكالمات حقيقية بالنموذج الذي ينبغي اعتماده. منصّة Retell AI هي منصّة وكلاء صوتيين بالذكاء الاصطناعي لمراكز التواصل، بأسعار تبدأ من $0.07 للدقيقة، لذا يمكنك إثبات جدواها على مكالماتك الخاصة قبل توقيع أي التزام.
الأسئلة الشائعة
ما الفرق بين pass^1 وpass^k؟
يمثّل Pass^1 نسبة المهام التي يُنجزها الوكيل من المحاولة الأولى. ويمثّل Pass^k نسبة المهام التي يُنجزها في كل محاولة من المحاولات المتكررة البالغ عددها k على المهمة نفسها. ويكون Pass^k دائمًا مساويًا لـ pass^1 أو أقل منه، وتكشف الفجوة بينهما مدى اتساق أداء الوكيل.
هل τ-bench هو نفسه τ²-bench؟
لا. τ-bench هو المعيار الأصلي الصادر عام 2024 بقطاعي الطيران والتجزئة. أما τ²-bench فهو الإصدار اللاحق الصادر عام 2025 عن المجموعة نفسها، ويحتفظ بنسخ مُتحقَّق منها من هذين القطاعين، ويضيف قطاع الاتصالات الذي يستخدم فيه العميل المُحاكى الأدوات أيضًا.
لماذا يُستخدم اختبار علمي مثل GPQA Diamond لمقارنة النماذج في محادثات العملاء؟
يُستخدم GPQA Diamond مقياسًا عامًا للقدرة على الاستدلال، ولا يكشف شيئًا مباشرًا عن المحادثات أو الأدوات أو الكلام. اقرأه بوصفه فحصًا لعمق الاستدلال، واعتمد على معايير المهام لتقييم ما تبقّى.
أيّ معيار تقييم هو الأهم للوكيل الصوتي بالذكاء الاصطناعي؟
لا يكفي أيٌّ منها وحده. فاستخدام الأدوات وفق سياسة محددة، واتباع التعليمات عبر الأدوار، والالتزام بالمعلومات هي الأقرب إلى عمل مراكز التواصل، لذا تُعدّ τ²-bench وMulti-IF وvCX Benchmark الأكثر ملاءمة. ومع ذلك، فإن اختبارًا مُقيَّمًا على سيناريوهات مكالماتك الخاصة أهم من أيٍّ منها.
ما نتائج Tell-1 في τ²-bench وMulti-IF وGPQA Diamond؟
تُعلن منصّة Retell أن Tell-1 حقق 72.0 في τ²-bench لقطاع الطيران، و78.0 في τ²-bench لقطاع التجزئة، و82.1 في Multi-IF، و83.5 في GPQA Diamond، وكلها من 100. وهذه اختبارات أجرتها المنصّة بنفسها على 50 مهمة لكل قطاع في τ²-bench، و504 محادثات في Multi-IF، و198 سؤالًا في GPQA Diamond.
See how much your business could save by switching to AI-powered voice agents.
ROI Result
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Estimate your monthly voice AI cost
Read Other Blogs


أحدث ثورة في مركز الاتصال لديك مع Retell


