Εξειδικευμένα έναντι γενικής χρήσης LLM για κέντρα επικοινωνίας





Ένα LLM γενικής χρήσης είναι το ασφαλέστερο σημείο εκκίνησης για τα περισσότερα κέντρα επικοινωνίας. Ένα εξειδικευμένο LLM αξίζει τη θέση του όταν ένας τύπος κλήσης έχει μεγάλο όγκο και ένα γενικό μοντέλο αποτυγχάνει επανειλημμένα με τον ίδιο μετρήσιμο τρόπο: αργές πρώτες λέξεις, λανθασμένες κλήσεις εργαλείων ή απαντήσεις που ακούγονται σαν ιστοσελίδα που διαβάζεται φωναχτά. Καμία κατηγορία δεν κερδίζει από μόνη της. Το μοντέλο που πρέπει να επιλέξετε είναι αυτό που περνά τις δικές σας κλήσεις, σε κάθε εκτέλεση, με κόστος ανά λεπτό που μπορείτε να προβλέψετε.
Ο οδηγός αυτός απευθύνεται στον υπεύθυνο που λογοδοτεί για την τηλεφωνική γραμμή. Η Retell AI δημοσιεύει αυτόν τον οδηγό και έχει συμφέρον και στις δύο πλευρές. Η πλατφόρμα της προσφέρει μοντέλα γενικής χρήσης από OpenAI, Anthropic και Google, και αναπτύσσει και δικό της: το Tell-1, το δικό LLM της Retell, σχεδιασμένο για κλήσεις κέντρων επικοινωνίας. Το Tell-1 κατατάσσεται #1 συνολικά στο δημόσιο benchmark της Retell, το Retell vCX Benchmark (ανάγνωση στις 13 Νοεμβρίου 2026). Αντιμετωπίστε το όπως κάθε benchmark προμηθευτή: ως λόγο να το βάλετε στη λίστα σας και στη συνέχεια ως κάτι προς έλεγχο στις δικές σας κλήσεις.
Τι απαιτεί μια κλήση κέντρου επικοινωνίας από ένα γλωσσικό μοντέλο;
Μια κλήση κέντρου επικοινωνίας ζητά από ένα μοντέλο πέντε πράγματα σε κάθε γύρο: να ακολουθεί ένα μακρύ σενάριο, να καλεί σωστά εργαλεία, να ακούγεται φυσικό όταν εκφωνείται, να απαντά γρήγορα και να παραμένει οικονομικό σε μεγάλο όγκο.
- Μακροσκελή σενάρια. Το prompt του πράκτορα περιέχει τα βήματα, τις πολιτικές και τις εξαιρέσεις για έναν τύπο κλήσης, και το μοντέλο πρέπει να εφαρμόζει τον σωστό κανόνα σε κάθε γύρο. Στο benchmark Multi-IF, και τα 14 μοντέλα που αξιολογήθηκαν αποτύγχαναν σε περισσότερες οδηγίες με κάθε επιπλέον γύρο.
- Κλήσεις εργαλείων. Οι κρατήσεις, οι αναζητήσεις και οι μεταβιβάσεις γίνονται μέσω εργαλείων, και μια λανθασμένη κλήση αλλάζει μια πραγματική εγγραφή. Η δημοσίευση tau-bench του 2024 διαπίστωσε ότι πράκτορες function calling βασισμένοι σε ένα κορυφαίο μοντέλο γενικής χρήσης ολοκλήρωσαν με επιτυχία λιγότερο από το 50% των εργασιών υποστήριξης πελατών του, και πέρασαν και τις οκτώ επαναλαμβανόμενες δοκιμές μιας εργασίας λιανικής λιγότερο από το 25% των φορών.
- Φυσική ομιλία. Η απάντηση ακούγεται, δεν διαβάζεται. Λίστες και σύμβολα που λειτουργούν σε μια οθόνη ακούγονται λάθος σε μια συνθετική φωνή.
- Ταχύτητα. Οι άνθρωποι αφήνουν μικρά κενά μεταξύ των γύρων ομιλίας. Μια ανασκόπηση της έρευνας για την εναλλαγή ομιλητών τοποθετεί το τυπικό κενό γύρω στα 200 χιλιοστά του δευτερολέπτου. Το μοντέλο είναι ένα στάδιο ανάμεσα στην τελευταία λέξη του καλούντος και την πρώτη του πράκτορα, οπότε ο χρόνος που χρειάζεται πριν ξεκινήσει μια απάντηση ακούγεται ως σιωπή.
- Κόστος σε μεγάλο όγκο. Κάθε γύρος στέλνει ξανά στο μοντέλο το σενάριο και τη συνομιλία μέχρι εκείνη τη στιγμή. Οι πάροχοι προσφέρουν έκπτωση σε αυτή την επαναλαμβανόμενη είσοδο (ο οδηγός prompt caching της OpenAI αναφέρει έκπτωση έως 95% για την αποθηκευμένη στην cache είσοδο), αλλά στον όγκο ενός κέντρου επικοινωνίας μια μικρή διαφορά ανά λεπτό γίνεται γραμμή προϋπολογισμού.
Πού ταιριάζουν τα LLM γενικής χρήσης σε ένα κέντρο επικοινωνίας;
Τα LLM γενικής χρήσης ταιριάζουν καλύτερα εκεί όπου οι κλήσεις ποικίλλουν: πολλοί τύποι κλήσεων, πολλές γλώσσες και ερωτήσεις που δεν είχε προβλέψει κανένα σενάριο. Εκπαιδεύονται ευρέως και διατίθενται από αρκετούς παρόχους, ώστε μια ομάδα μπορεί να αλλάξει μοντέλο καθώς αλλάζουν οι ανάγκες της.
Χρειάζονται επίσης λιγότερη προσαρμοσμένη δουλειά απ' όσο υποθέτουν πολλοί αγοραστές. Ο οδηγός βελτιστοποίησης μοντέλων της OpenAI περιγράφει έναν κύκλο από evals και prompt engineering, με fine-tuning που προστίθεται «για ορισμένες περιπτώσεις χρήσης». Μεγάλο μέρος όσων κρατούν έναν πράκτορα στο σενάριο βρίσκεται στο prompt, στη ροή της κλήσης και στα εργαλεία, και αυτή η δουλειά μεταφέρεται όταν αλλάζει το μοντέλο.
Οι περιορισμοί φαίνονται στο τηλέφωνο. Οι λειτουργίες συλλογισμού (reasoning) που σκέφτονται πριν απαντήσουν προσθέτουν καθυστέρηση πριν από την πρώτη λέξη. Τα μοντέλα που έχουν ρυθμιστεί για γραπτή συνομιλία χρειάζονται κατάλληλο prompting ώστε οι απαντήσεις να μένουν σύντομες και εκφωνήσιμες. Και το χρονοδιάγραμμα το ορίζει ο πάροχος: η πολιτική απόσυρσης της OpenAI δίνει ειδοποίηση τουλάχιστον 6 μηνών πριν αποσύρει ένα γενικά διαθέσιμο μοντέλο, και ο πράκτορας πρέπει στη συνέχεια να ελεγχθεί στο μοντέλο αντικατάστασης. Για μια ανάλυση ανά μοντέλο, δείτε ποιο LLM πρέπει να τροφοδοτεί τον φωνητικό πράκτορα AI σας.
Τι αλλάζει ένα εξειδικευμένο ή fine-tuned LLM;
Ένα εξειδικευμένο LLM μεταφέρει τη συμπεριφορά από το prompt στην εκπαίδευση του μοντέλου. Αντί να δίνει οδηγίες σε ένα γενικό μοντέλο να μιλά σύντομα, να τηρεί την πολιτική και να καλεί εργαλεία τη σωστή στιγμή, ο προμηθευτής το εκπαιδεύει σε παραδείγματα ακριβώς αυτής της συμπεριφοράς, συχνά πάνω σε ένα μικρότερο μοντέλο. Τρεις όροι συχνά συγχέονται:
- Ένα LLM ειδικού τομέα ή κάθετο (vertical) LLM εκπαιδεύεται ή ρυθμίζεται από έναν προμηθευτή για έναν κλάδο ή μία εργασία και προσφέρεται σε όλους τους πελάτες του.
- Ένα fine-tuned μοντέλο είναι ένα βασικό μοντέλο που εκπαιδεύεται περαιτέρω σε ένα πιο στενό σύνολο δεδομένων, συχνά δικό σας. Το λήμμα του γλωσσαρίου για το fine-tuning μοντέλων AI εξηγεί τους μηχανισμούς.
- Ένα προσαρμοσμένο LLM συνήθως σημαίνει οποιοδήποτε μοντέλο φέρνετε μόνοι σας σε μια πλατφόρμα, είτε έχει υποστεί fine-tuning είτε όχι.
Ο οδηγός της OpenAI για την ακρίβεια των LLM δίνει δύο λόγους για fine-tuning: τη βελτίωση της ακρίβειας σε μια συγκεκριμένη εργασία και τη βελτίωση της αποδοτικότητας, δηλαδή την ίδια ακρίβεια με λιγότερα tokens ή από ένα μικρότερο μοντέλο. Στις κλήσεις, αυτό μπορεί να σημαίνει πιο σταθερή τήρηση του σεναρίου, συντομότερα prompts και χαμηλότερο κόστος ανά λεπτό.
Η ιδέα δεν είναι καινούργια. Η Observe.AI ανακοίνωσε ένα Contact Center LLM τον Ιούνιο του 2023, το οποίο περιγράφει ως μοντέλο 30 δισεκατομμυρίων παραμέτρων εκπαιδευμένο σε σύνολο δεδομένων ειδικού τομέα με εκατοντάδες εκατομμύρια αλληλεπιδράσεις πελατών. Τα κέρδη ακρίβειας σε εκείνη την ανακοίνωση προέρχονται από τα αρχικά benchmarks του ίδιου του προμηθευτή. Αυτό είναι σύνηθες στην κατηγορία, και γι' αυτό η δική σας αξιολόγηση μετρά περισσότερο από οποιαδήποτε ανακοίνωση.
Ποια είναι τα trade-offs ανάμεσα στα δύο;
Τα trade-offs είναι η δέσμευση σε προμηθευτή (lock-in), η κάλυψη και το βάρος της αξιολόγησης, και το καθένα λειτουργεί και προς τις δύο κατευθύνσεις.
| Παράγοντας | LLM γενικής χρήσης | Εξειδικευμένο ή fine-tuned LLM |
|---|---|---|
| Καλύτερη εφαρμογή | Ποικίλοι τύποι κλήσεων, πολλές γλώσσες, ερωτήσεις εκτός σεναρίου | Ένας τύπος κλήσης μεγάλου όγκου με σταθερούς κανόνες |
| Συμπεριφορά σεναρίου και εργαλείων | Ορίζεται από το prompt και τη ροή της κλήσης | Ενσωματωμένη μέσω εκπαίδευσης, άρα χρειάζεται μικρότερο prompt |
| Ταχύτητα και κόστος ανά λεπτό | Εξαρτάται από το μέγεθος του μοντέλου και τη λειτουργία συλλογισμού | Μπορεί να είναι χαμηλότερα όταν το μοντέλο είναι μικρότερο |
| Lock-in | Αρκετοί πάροχοι, καθένας αποσύρει μοντέλα με το δικό του χρονοδιάγραμμα | Συχνά ένας προμηθευτής ή μία πλατφόρμα |
| Κάλυψη | Ευρεία | Πιο περιορισμένη εκτός των δεδομένων εκπαίδευσης |
| Διαθέσιμα τεκμήρια | Δημόσια benchmarks, λίγα από αυτά σε τηλεφωνικές κλήσεις | Συχνά το benchmark του ίδιου του προμηθευτή |
| Βάρος αξιολόγησης | Επανέλεγχος κάθε φορά που αποσύρεται ένα μοντέλο | Έλεγχος πριν από την υιοθέτηση και μετά από κάθε επανεκπαίδευση |
Lock-in. Ένα εξειδικευμένο μοντέλο πωλείται συχνά από έναν μόνο προμηθευτή, μερικές φορές μέσα σε μία πλατφόρμα. Ρωτήστε αν μπορείτε να αλλάξετε μοντέλο χωρίς να ξαναχτίσετε τον πράκτορα και αν τα prompts, οι ροές και τα σενάρια δοκιμών παραμένουν δικά σας. Τα μοντέλα γενικής χρήσης ενέχουν μια πιο αθόρυβη εκδοχή του ίδιου κινδύνου όταν ένας πάροχος αποσύρει μια έκδοση.
Κάλυψη. Ένα μοντέλο εκπαιδευμένο σε κλήσεις ραντεβού στα αγγλικά μπορεί να είναι πιο αδύναμο στα ισπανικά ή σε μια διαφωνία χρέωσης που δεν έχει δει ποτέ. Ζητήστε αποτελέσματα ανά γλώσσα και ανά τύπο κλήσης, όχι έναν μέσο όρο.
Βάρος αξιολόγησης. Τα δημόσια benchmarks σπάνια μετρούν τηλεφωνικές κλήσεις, και ένα benchmark προμηθευτή είναι τεκμήριο επιλεγμένο από τον πωλητή. Αν κάνετε fine-tuning στο δικό σας μοντέλο, το βάρος μεγαλώνει. Ο οδηγός ακρίβειας της OpenAI αναφέρει ότι τα παραδείγματα εκπαίδευσης «πρέπει να αντιπροσωπεύουν ακριβώς ό,τι θα δει το μοντέλο στον πραγματικό κόσμο» και συνιστά ένα σύνολο hold-out για τον εντοπισμό υπερπροσαρμογής (overfitting).
Πώς αξιολογείτε οποιοδήποτε από τα δύο μοντέλα στις δικές σας κλήσεις;
Αξιολογήστε και τα δύο με τον ίδιο τρόπο: σταθερά σενάρια από τις δικές σας κλήσεις, βαθμολογημένα με γραπτά κριτήρια επιτυχίας, που εκτελούνται περισσότερες από μία φορές, και στη συνέχεια διαχωρισμός της ζωντανής κίνησης.
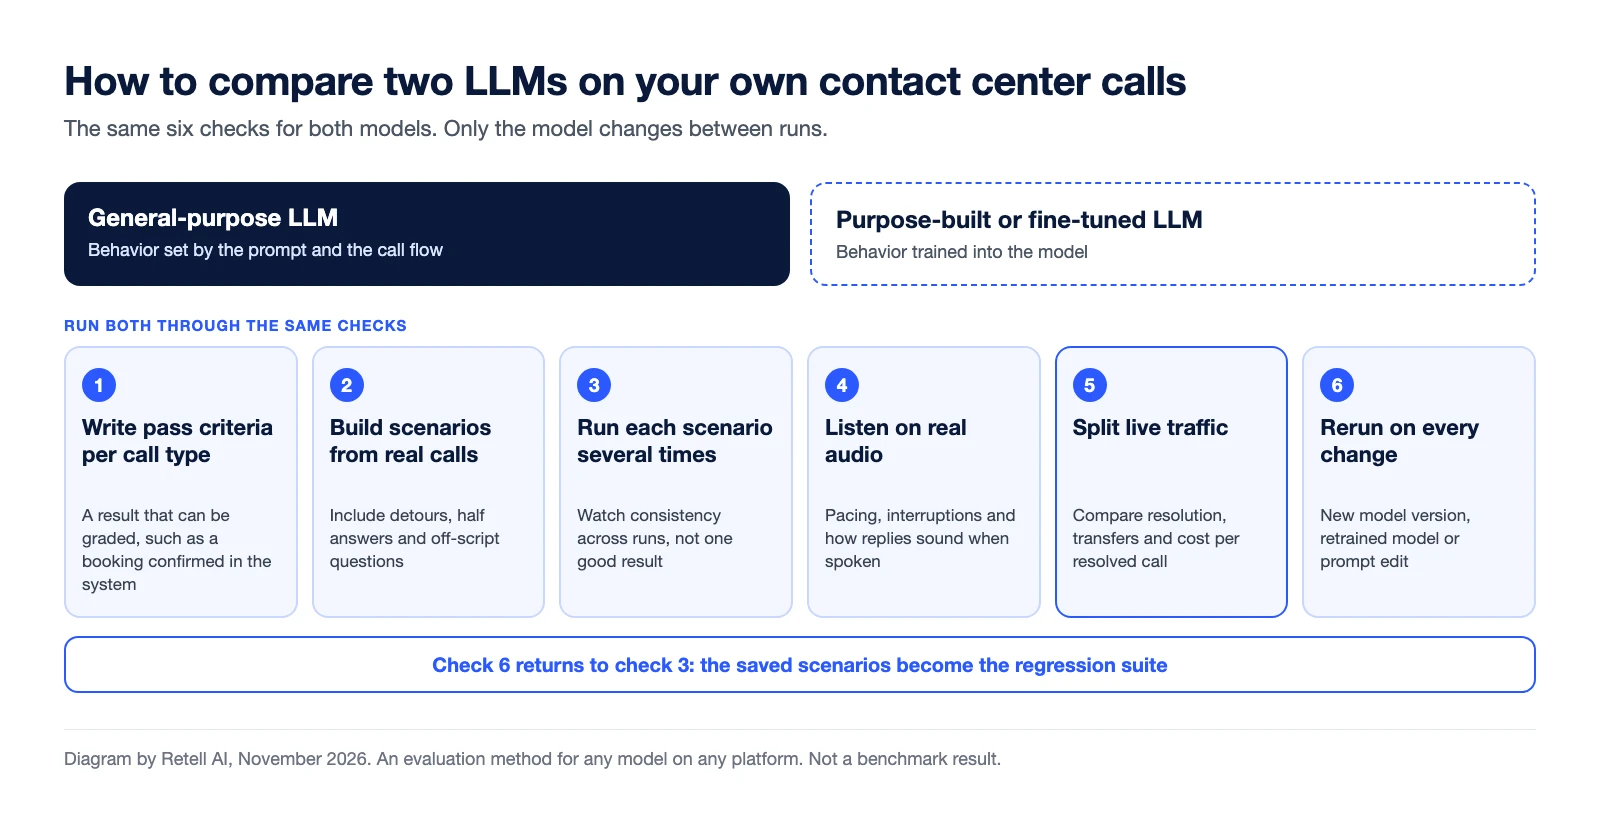
- Γράψτε κριτήρια επιτυχίας ανά τύπο κλήσης. Το «Το ραντεβού κλείστηκε στο σύστημα προγραμματισμού και επιβεβαιώθηκε στον καλούντα» μπορεί να βαθμολογηθεί. Το «Ακουγόταν καλό» όχι.
- Δημιουργήστε σενάρια από πραγματικές κλήσεις. Συμπεριλάβετε τις παρεκκλίσεις: τον καλούντα που αλλάζει γνώμη, κάνει μια ερώτηση εκτός σεναρίου ή δίνει μισή απάντηση.
- Εκτελέστε κάθε σενάριο αρκετές φορές σε κάθε μοντέλο. Οι συγγραφείς του tau-bench πρότειναν τη μετρική pass^k για τη μέτρηση της αξιοπιστίας σε επαναλαμβανόμενες δοκιμές.
- Ακούστε σε πραγματικό ήχο. Τα αποτελέσματα σε κείμενο χάνουν τον ρυθμό, τις διακοπές και το πώς ακούγεται μια απάντηση όταν εκφωνείται.
- Διαχωρίστε τη ζωντανή κίνηση. Στείλτε ένα μέρος των κλήσεων σε κάθε επιλογή και συγκρίνετε επίλυση, μεταβιβάσεις και κόστος ανά επιλυμένη κλήση.
- Επαναλάβετε σε κάθε αλλαγή. Μια νέα έκδοση μοντέλου, ένα επανεκπαιδευμένο μοντέλο και μια τροποποίηση του prompt απαιτούν όλα την ίδια σουίτα δοκιμών.
Στη Retell, οι δοκιμές προσομοίωσης βαθμολογούν κάθε εκτέλεση ως επιτυχή ή αποτυχημένη βάσει κριτηρίων επιτυχίας, οι μαζικές δοκιμές επαναλαμβάνουν τις αποθηκευμένες περιπτώσεις ως σουίτα παλινδρόμησης, και το A/B testing κατανέμει την κίνηση κλήσεων μεταξύ πρακτόρων βάσει ποσοστού. Η τεκμηρίωση αναφέρει ότι μπορείτε να αλλάξετε μοντέλο αργότερα χωρίς να ξαναγράψετε το prompt σας. Αν φέρετε το δικό σας μοντέλο, οι δοκιμές προσομοίωσης και οι μαζικές δοκιμές δεν εφαρμόζονται, και ο έλεγχός του γίνεται μέσω κλήσεων web και τηλεφώνου. Για το ευρύτερο πιλοτικό, δείτε πώς να αξιολογήσετε μια πλατφόρμα φωνητικών πρακτόρων AI πριν από τη ζωντανή λειτουργία.
Πού τοποθετείται το Tell-1 σε αυτή τη σύγκριση;
Το Tell-1, το δικό LLM της Retell, είναι ένα εξειδικευμένο μοντέλο για κλήσεις κέντρων επικοινωνίας, οπότε κάθε trade-off αυτού του οδηγού ισχύει και γι' αυτό. Δείτε πού βρίσκεται σε καθένα, με την πηγή για κάθε αριθμό.
- Σενάρια, εργαλεία και ομιλία. Στο Retell vCX Benchmark, το Tell-1 έχει μέσο όρο 94,45 και κατατάσσεται #1 συνολικά. Ανά σουίτα, σημειώνει 88,6% στην τήρηση οδηγιών (θέση 2), 97,2% στη θεμελίωση (grounding) (θέση 2), 95,4% στις κλήσεις εργαλείων (θέση 5) και 96,6% στην καθομιλουμένη (θέση 1), όλα με ανάγνωση στις 13 Νοεμβρίου 2026. Το benchmark το διαχειρίζεται η ίδια η Retell, οπότε χρησιμοποιήστε το όπως προτείνει αυτός ο οδηγός: ως λόγο να το βάλετε στη λίστα σας.
- Ταχύτητα. Έχει τη χαμηλότερη διάμεση καθυστέρηση (latency) στον πίνακα, στα 76 ms (ανάγνωση στις 13 Νοεμβρίου 2026). Πρόκειται για την τιμή του μοντέλου στο benchmark, όχι για τον συνολικό χρόνο απόκρισης μιας κλήσης.
- Κόστος. Το benchmark το αναφέρει στα 3,5 σεντς ανά λεπτό. Αυτό αφορά μόνο το LLM, όχι την τιμή μιας κλήσης, και ορισμένες διαμορφώσεις γενικής χρήσης στον πίνακα κοστίζουν λιγότερο. Η τιμολόγηση της Retell ξεκινά από 0,07 $ ανά λεπτό.
- Πώς λειτουργεί. Το μοντέλο ξεκινά την απάντησή του και συνεχίζει να συλλογίζεται ενώ ακούγονται οι πρώτες λέξεις. Η τεχνική δημοσίευση, Retell LLM: Interleaved Reasoning for Real-Time Voice Agents, αναφέρει κατά μέσο όρο περίπου 200 tokens συλλογισμού στη μέση της απάντησης και περιγράφει τα τρία στάδια εκπαίδευσης πίσω από αυτό.
- Lock-in. Το Tell-1 προσφέρεται μέσα στη Retell. Βρίσκεται στον ίδιο επιλογέα μοντέλων με μοντέλα από OpenAI, Anthropic και Google, και η τεκμηρίωση της Retell αναφέρει ότι μπορείτε να αλλάξετε μοντέλο αργότερα χωρίς να ξαναγράψετε το prompt σας, οπότε η επιλογή του δεν αποκλείει τα υπόλοιπα.
- Κάλυψη. Ένα μοντέλο σχεδιασμένο για κλήσεις είναι εκ σχεδιασμού πιο περιορισμένο. Δοκιμάστε το Tell-1 στις δικές σας γλώσσες και τους δικούς σας τύπους κλήσεων πριν βασιστείτε σε αυτό, και κρατήστε ένα μοντέλο γενικής χρήσης για κάθε τύπο κλήσης όπου έρχεται δεύτερο.
- Αξιολόγηση. Οι έξι έλεγχοι παραπάνω ισχύουν αμετάβλητοι. Επειδή το Tell-1 είναι μοντέλο που διαχειρίζεται η Retell, οι δοκιμές προσομοίωσης και οι μαζικές δοκιμές λειτουργούν με αυτό, και ένας διαχωρισμός A/B μπορεί να στείλει την ίδια κίνηση σε δύο αντίγραφα ενός πράκτορα που διαφέρουν μόνο στο μοντέλο.
Η δίκαιη σύνοψη: το Tell-1 είναι η εξειδικευμένη επιλογή που αξίζει να βάλετε στη λίστα σας αν λειτουργείτε στη Retell, και τα μοντέλα γενικής χρήσης δίπλα του αποτελούν την ομάδα ελέγχου. Δείτε το Tell-1 για τις λεπτομέρειες του προϊόντος.
Συχνές ερωτήσεις
Τι είναι ένα εξειδικευμένο LLM;
Ένα εξειδικευμένο LLM είναι ένα γλωσσικό μοντέλο εκπαιδευμένο ή ρυθμισμένο για μία εργασία, όπως η διαχείριση κλήσεων κέντρου επικοινωνίας, αντί για γενική χρήση. Ονομάζεται επίσης LLM ειδικού τομέα ή κάθετο LLM. Ένα μεγάλο γλωσσικό μοντέλο γενικής χρήσης προσαρμόζεται στην εργασία μέσω prompts και εργαλείων.
Είναι τα εξειδικευμένα LLM πιο ακριβή από τα LLM γενικής χρήσης;
Στην εργασία για την οποία εκπαιδεύτηκαν, μπορεί να είναι. Εκτός αυτής, συχνά όχι. Οι περισσότερες δημοσιευμένες συγκρίσεις προέρχονται από τον προμηθευτή που κατασκεύασε το μοντέλο, οπότε δοκιμάστε και τα δύο στα δικά σας σενάρια.
Χρειάζεται ένα κέντρο επικοινωνίας να εκπαιδεύσει το δικό του LLM;
Συνήθως όχι. Ο οδηγός βελτιστοποίησης της OpenAI ξεκινά με evals και prompt engineering και προσθέτει fine-tuning μόνο για ορισμένες περιπτώσεις χρήσης. Η εκπαίδευση δικού σας μοντέλου σημαίνει επίσης ότι αναλαμβάνετε τα δεδομένα εκπαίδευσης και ένα σύνολο hold-out.
Είναι ένα προσαρμοσμένο LLM το ίδιο με ένα fine-tuned μοντέλο;
Όχι πάντα. Στις περισσότερες φωνητικές πλατφόρμες, ένα προσαρμοσμένο LLM είναι οποιοδήποτε μοντέλο φιλοξενείτε και συνδέετε μόνοι σας, το οποίο μπορεί να έχει υποστεί fine-tuning ή όχι. Η επιλογή προσαρμοσμένου LLM της Retell συνδέει το δικό σας μοντέλο μέσω WebSocket, ενώ η Retell διαχειρίζεται την τηλεφωνία, τη μεταγραφή και την εναλλαγή ομιλητών.
Μπορεί ένα κέντρο επικοινωνίας να χρησιμοποιεί περισσότερα από ένα LLM;
Ναι. Στη Retell, κάθε πράκτορας έχει τη δική του ρύθμιση μοντέλου, και η τεκμηρίωση ρυθμίσεων LLM περιγράφει ένα γρήγορο fallback που εκτελεί ένα εφεδρικό μοντέλο παράλληλα με το κύριο.
Είναι το Tell-1 εξειδικευμένο LLM;
Ναι. Το Tell-1 είναι το δικό LLM της Retell, σχεδιασμένο για κλήσεις κέντρων επικοινωνίας. Κατατάσσεται #1 συνολικά στο Retell vCX Benchmark με μέσο όρο 94,45 (ανάγνωση στις 13 Νοεμβρίου 2026). Είναι μία επιλογή στον επιλογέα μοντέλων της Retell, δίπλα σε μοντέλα γενικής χρήσης από OpenAI, Anthropic και Google.
Συγκρίνετε μοντέλα στις δικές σας κλήσεις πριν δεσμευτείτε
Η Retell είναι μια πλατφόρμα φωνητικών πρακτόρων AI για κέντρα επικοινωνίας. Κάθε πράκτορας διαθέτει επιλογέα μοντέλων, και η σελίδα τιμολόγησης παραθέτει μοντέλα από OpenAI, Anthropic και Google μαζί με μια προσαρμοσμένη επιλογή για μοντέλο που φιλοξενείτε εσείς. Το Tell-1, το δικό LLM της Retell, βρίσκεται στον ίδιο επιλογέα. Οι άνθρωποι που βρίσκονται πιο κοντά στους πελάτες σας μπορούν να αλλάξουν το μοντέλο, να επαναλάβουν τη σουίτα δοκιμών και να διαχωρίσουν την κίνηση μόνοι τους. Σε αντίθεση με τη συνεργασία με έναν προμηθευτή managed AI, αυτή η αλλαγή δεν γίνεται αίτημα (ticket), ουρά αναμονής ή ακόμη ένα SOW. Η τιμολόγηση βασίζεται στη χρήση, από 0,07 $ ανά λεπτό στη σελίδα τιμολόγησης. Φέρτε έναν τύπο κλήσης και τα δικά σας κριτήρια επιτυχίας και τρέξτε ένα πιλοτικό σε πραγματικές κλήσεις πριν υπογράψετε οτιδήποτε.
See how much your business could save by switching to AI-powered voice agents.
ROI Result
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Estimate your monthly voice AI cost
Read Other Blogs


Επαναστατήστε τη διαχείριση κλήσεων σας με τη Retell


