Benchmark πρακτόρων AI: επεξήγηση για φωνητικούς πράκτορες





Ένα benchmark πρακτόρων AI είναι ένα σταθερό σύνολο εργασιών με κανόνα βαθμολόγησης, που χρησιμοποιείται για τη σύγκριση μοντέλων στην ίδια δουλειά. Για τους φωνητικούς πράκτορες AI, αξίζει να γνωρίζετε τέσσερα: το τ²-bench (tau2-bench) για τη χρήση εργαλείων βάσει πολιτικής, το Multi-IF για την τήρηση οδηγιών σε διαδοχικούς γύρους, το GPQA Diamond για σύνθετη συλλογιστική και το Retell vCX Benchmark για κλήσεις κέντρων επικοινωνίας. Το καθένα μετρά μόνο ένα κομμάτι όσων συμβαίνουν σε μια τηλεφωνική κλήση.
Αυτός ο οδηγός εξηγεί τι ελέγχει κάθε benchmark, πώς βαθμολογείται και τι δεν σας λέει η βαθμολογία. Η Retell AI δημοσιεύει αυτόν τον οδηγό και δημοσιεύει επίσης ένα από τα τέσσερα benchmark, το vCX Benchmark. Οι βαθμολογίες αλλάζουν με κάθε νέα έκδοση μοντέλου, γι' αυτό κάθε ενότητα παραπέμπει στην πηγή με τα τρέχοντα αποτελέσματα.
Τι είναι ένα benchmark πρακτόρων AI;
Ένα benchmark πρακτόρων AI δίνει σε κάθε μοντέλο τις ίδιες εργασίες και τον ίδιο αξιολογητή και στη συνέχεια αναφέρει πόσο συχνά το μοντέλο ολοκληρώνει σωστά την εργασία. Το τι σημαίνει μια βαθμολογία εξαρτάται από την εργασία, από το ποιος ή τι παίζει τον ρόλο της άλλης πλευράς στη συνομιλία και από το πώς κρίνεται η επιτυχία.
Οι αξιολογητές είναι τριών ειδών. Ο έλεγχος κατάστασης συγκρίνει το αποτέλεσμα των ενεργειών του πράκτορα με ένα γνωστό σωστό αποτέλεσμα, όπως μια βάση δεδομένων μετά από επιστροφή χρημάτων. Ο έλεγχος κανόνων εκτελεί ένα script πάνω στην απάντηση. Ένα μοντέλο-κριτής βαθμολογεί την απάντηση με βάση ένα σύνολο κριτηρίων. Οι έλεγχοι κατάστασης και κανόνων είναι επαναλήψιμοι αλλά περιορισμένοι. Τα μοντέλα-κριτές μπορούν να αξιολογήσουν το ύφος και το νόημα, έχουν όμως τα δικά τους τυφλά σημεία.
Τι μετρούν τα τέσσερα benchmark, το ένα δίπλα στο άλλο;
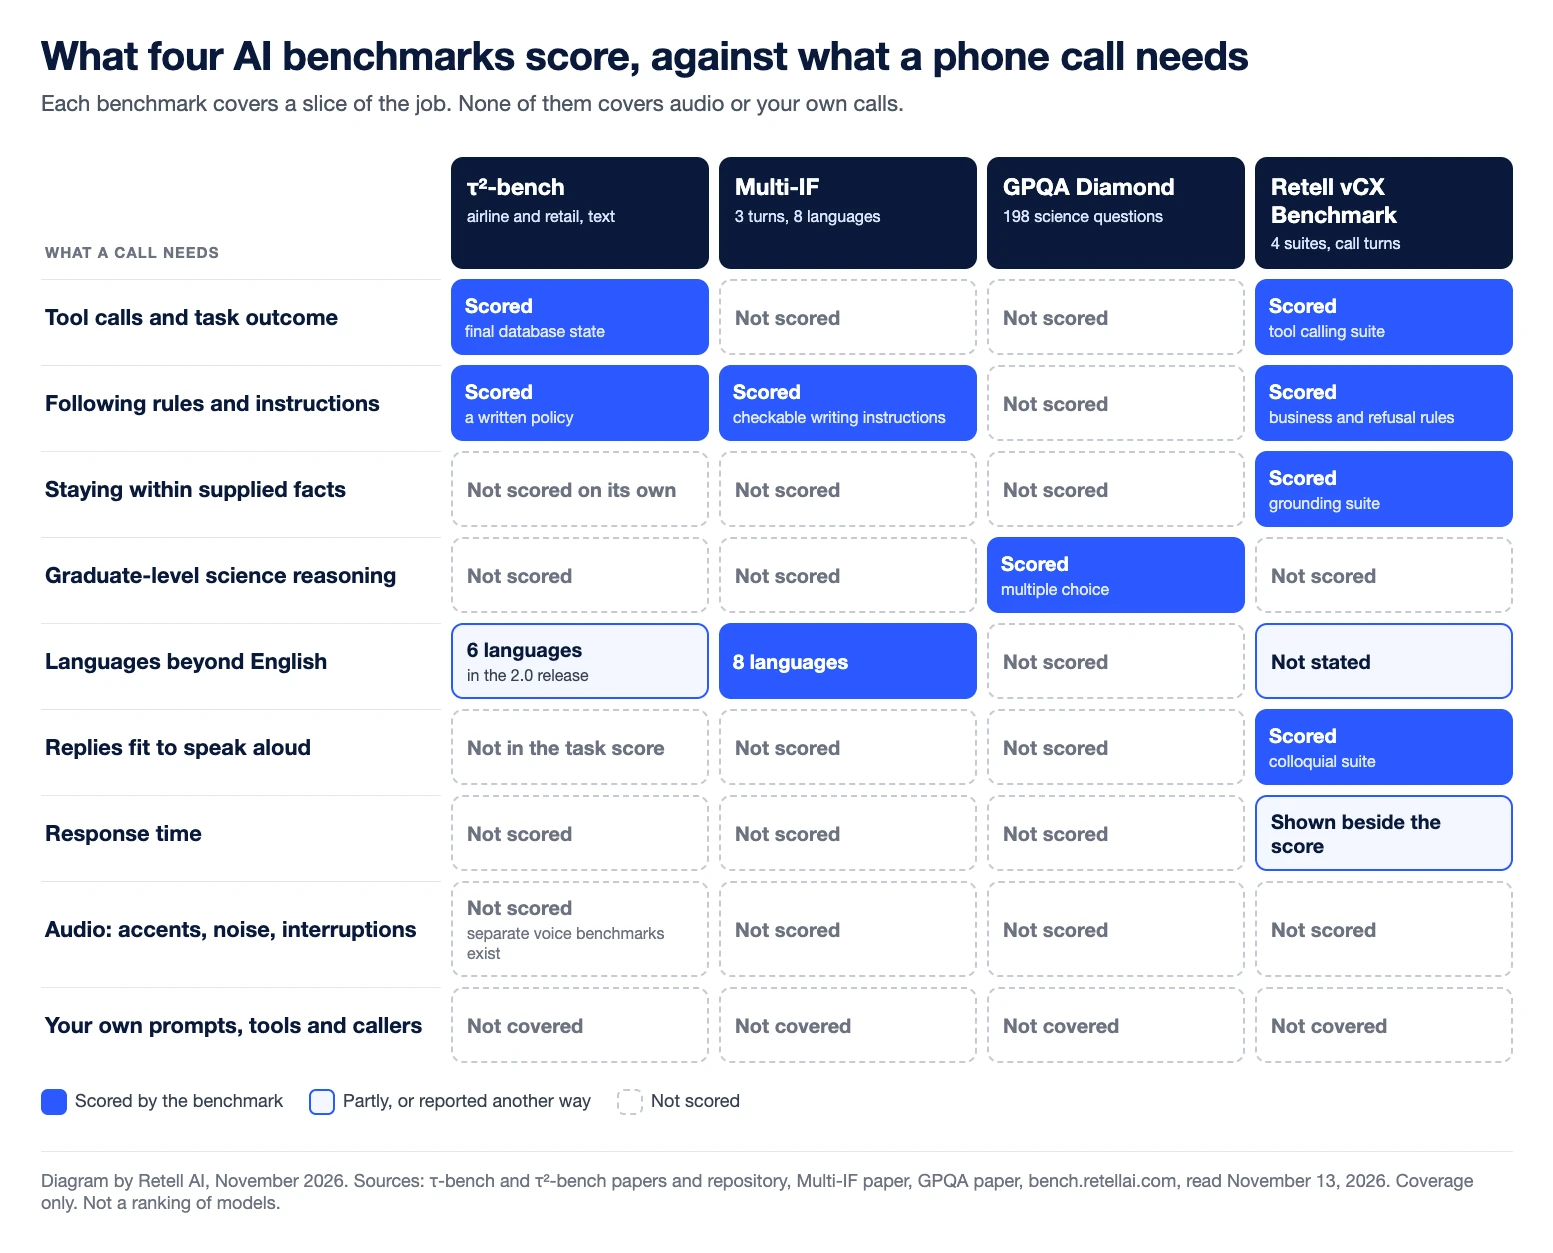
Καλύπτουν διαφορετικές δεξιότητες και μόνο το vCX Benchmark βασίζεται σε τηλεφωνικές κλήσεις. Ο πίνακας συνοψίζει το καθένα από το paper, το αποθετήριο ή το leaderboard του, όπως διαβάστηκαν στις 13 Νοεμβρίου 2026.
| Benchmark | Δημοσιεύτηκε από | Ποια είναι η εργασία | Πώς βαθμολογείται | Τι παραλείπει για έναν αγοραστή φωνητικών λύσεων |
|---|---|---|---|---|
| τ²-bench, αεροπορικές εταιρείες και λιανική | Sierra | Εξυπηρέτηση ενός προσομοιωμένου πελάτη σε γραπτή συνομιλία, με χρήση εργαλείων και τήρηση μιας γραπτής πολιτικής | 0 ή 1 ανά συνομιλία: η τελική βάση δεδομένων πρέπει να ταιριάζει με τον στόχο και να δοθούν οι απαιτούμενες πληροφορίες | Ήχο, χρόνο απόκρισης, τη δική σας πολιτική και τα δικά σας εργαλεία |
| Multi-IF | Meta | Τήρηση επαληθεύσιμων οδηγιών γραφής σε τρεις γύρους, σε οκτώ γλώσσες | Μέσος όρος τεσσάρων δεικτών ακρίβειας, ανά οδηγία και ανά συνομιλία, με αυστηρό και χαλαρό κριτήριο | Εργαλεία, μεγάλα σενάρια, προφορική απόδοση |
| GPQA Diamond | Ερευνητές από NYU, Cohere και Anthropic | Απάντηση σε 198 επιστημονικές ερωτήσεις πολλαπλής επιλογής γραμμένες από ειδικούς | Ποσοστό σωστών απαντήσεων, με 25% το επίπεδο τύχης | Συνομιλία, εργαλεία, οδηγίες, ταχύτητα |
| Retell vCX Benchmark | Retell AI | Χειρισμός γύρων σε κλήσεις κέντρων επικοινωνίας σε τέσσερις σουίτες | Ποσοστό επιτυχίας ανά σουίτα, με μέσο όρο σε μία βαθμολογία | Ήχο, τους δικούς σας τύπους κλήσεων, αποτελέσματα σε ολόκληρη κλήση |
Τι μετρά το τ²-bench στους τομείς αεροπορικών εταιρειών και λιανικής;
Το τ²-bench μετρά αν ένας πράκτορας μπορεί να ολοκληρώσει μια εργασία εξυπηρέτησης πελατών μέσω συνομιλίας, τηρώντας μια γραπτή πολιτική και καλώντας τα σωστά εργαλεία. Ένα γλωσσικό μοντέλο παίζει τον ρόλο του πελάτη και ο πράκτορας εργάζεται πάνω σε μια εικονική βάση δεδομένων παραγγελιών ή κρατήσεων. Το αρχικό paper του τ-bench δημιούργησε τους δύο τομείς με 115 εργασίες λιανικής και 50 εργασίες αεροπορικών εταιρειών. Το paper του τ²-bench επαναχρησιμοποιεί επαληθευμένες εκδόσεις και των δύο και προσθέτει έναν τομέα τηλεπικοινωνιών.
Η βαθμολόγηση είναι αυστηρή. Σύμφωνα με τις σημειώσεις αξιολόγησης στο αποθετήριο, η ανταμοιβή κάθε εργασίας είναι το γινόμενο των ελέγχων της. Από προεπιλογή, αυτοί είναι ένας έλεγχος βάσης δεδομένων, που συγκρίνει την τελική βάση δεδομένων με την κατάσταση-στόχο, και ένας έλεγχος επικοινωνίας, που επιβεβαιώνει ότι ο πράκτορας έδωσε στον πελάτη τις απαιτούμενες πληροφορίες. Οποιαδήποτε ακολουθία κλήσεων εργαλείων φτάνει στη σωστή τελική κατάσταση θεωρείται επιτυχής.
Δύο αναφερόμενοι αριθμοί έχουν σημασία. Το pass^1 είναι το ποσοστό των εργασιών που επιλύονται με μία μόνο προσπάθεια. Το pass^k είναι το ποσοστό που επιλύεται σε όλες τις k επαναλαμβανόμενες προσπάθειες, ένας δείκτης που εισήγαγε το αρχικό paper για να αποτυπώσει τη συνέπεια. Εκείνο το paper του 2024 ανέφερε ότι ακόμη και οι κορυφαίοι πράκτορες κλήσης συναρτήσεων της εποχής πέτυχαν σε λιγότερες από τις μισές εργασίες, με pass^8 κάτω από 25% στη λιανική.
Τι δεν λέει σε έναν αγοραστή φωνητικών λύσεων: οι γραπτές βαθμολογίες για αεροπορικές εταιρείες και λιανική προέρχονται από πληκτρολογημένες συνομιλίες χωρίς ήχο, χωρίς διακοπές και χωρίς χρονικό περιορισμό. Οι πολιτικές και τα εργαλεία είναι αυτά του ίδιου του benchmark. Ο προσομοιωμένος πελάτης είναι επίσης μοντέλο, και οι συντάκτες του τ²-bench μέτρησαν ποσοστά σφάλματος του προσομοιωτή 40% στη λιανική και 47% στις αεροπορικές εταιρείες, με 12% και 13% αντίστοιχα αρκετά σοβαρά ώστε να εμποδίζουν την εργασία. Το ίδιο αποθετήριο περιλαμβάνει πλέον ξεχωριστά φωνητικά benchmark, ενώ η έκδοση 2.0 προσθέτει έξι γλώσσες και αναφέρει ότι οι βαθμολογίες της δεν είναι συγκρίσιμες με το leaderboard της 1.x. Ελέγξτε από ποια έκδοση προέρχεται μια βαθμολογία που παρατίθεται.
Τι μετρά το Multi-IF;
Το Multi-IF μετρά αν ένα μοντέλο συνεχίζει να τηρεί οδηγίες καθώς προχωρά μια συνομιλία και αν αυτό ισχύει και εκτός αγγλικών. Το paper του Multi-IF από τη Meta επεκτείνει ένα παλαιότερο τεστ ενός γύρου, το IFEval, σε 4.501 συνομιλίες τριών γύρων η καθεμία σε οκτώ γλώσσες: αγγλικά, γαλλικά, ρωσικά, χίντι, ιταλικά, πορτογαλικά, ισπανικά και κινεζικά.
Οι οδηγίες είναι διατυπωμένες έτσι ώστε να μπορούν να επαληθευτούν, όπως η απαγόρευση χρήσης κομμάτων ή ο κανόνας απάντησης με κεφαλαία γράμματα. Η κύρια βαθμολογία είναι ο μέσος όρος τεσσάρων δεικτών ακρίβειας. Η ακρίβεια σε επίπεδο οδηγίας μετρά κάθε οδηγία ξεχωριστά. Η ακρίβεια σε επίπεδο συνομιλίας μετρά μια συνομιλία μόνο αν τηρήθηκε κάθε οδηγία μέχρι εκείνον τον γύρο. Η καθεμία αναφέρεται με αυστηρό και με χαλαρό κριτήριο.
Το βασικό εύρημα του paper είναι ο λόγος που αυτό το benchmark έχει σημασία για τους τηλεφωνικούς πράκτορες: καθένα από τα 14 μοντέλα που δοκιμάστηκαν αποτύγχανε συχνότερα με κάθε επιπλέον γύρο. Ένα μοντέλο έπεσε από 0,877 στον πρώτο γύρο σε 0,707 στον τρίτο. Ένας πράκτορας που τηρεί έναν κανόνα στην αρχή μιας κλήσης και τον εγκαταλείπει λίγες ανταλλαγές αργότερα αποτυγχάνει με τον ίδιο τρόπο.
Τι δεν λέει σε έναν αγοραστή φωνητικών λύσεων: οι οδηγίες είναι περιορισμοί μορφοποίησης και γραφής σε κείμενο, όπως μήκος, στίξη και λέξεις-κλειδιά. Δεν είναι επιχειρησιακοί κανόνες. Δεν υπάρχουν εργαλεία, οι τρεις γύροι είναι λίγοι σε σύγκριση με μια πραγματική κλήση και τίποτα δεν εκφωνείται.
Τι μετρά το GPQA Diamond;
Το GPQA Diamond μετρά αν ένα μοντέλο μπορεί να απαντήσει σε πολύ δύσκολες επιστημονικές ερωτήσεις που δεν λύνονται με μια αναζήτηση στο διαδίκτυο. Το paper του GPQA περιγράφει 448 ερωτήσεις πολλαπλής επιλογής στη βιολογία, τη φυσική και τη χημεία, γραμμένες και επικυρωμένες από άτομα που κατέχουν ή εκπονούν διδακτορικό. Το Diamond είναι το υποσύνολο των 198 ερωτήσεων στις οποίες και οι δύο ειδικοί επικυρωτές απάντησαν σωστά, ενώ οι περισσότεροι μη ειδικοί όχι.
Η βαθμολόγηση είναι απλή ακρίβεια. Κάθε ερώτηση έχει τέσσερις επιλογές, οπότε η τυχαία επιλογή δίνει 25%. Στο πλήρες σύνολο, οι ειδικοί έφτασαν το 65% και οι έμπειροι μη ειδικοί με απεριόριστη πρόσβαση στο διαδίκτυο το 34%.
Τι δεν λέει σε έναν αγοραστή φωνητικών λύσεων: σχεδόν τίποτα για μια κλήση. Δεν υπάρχει συνομιλία, οδηγία προς τήρηση, εργαλείο ή χρονικό όριο. Αποτελεί ένδειξη για το βάθος συλλογιστικής. Με 198 ερωτήσεις, οι μικρές διαφορές μεταξύ μοντέλων αποτελούν επίσης αδύναμη ένδειξη, και οι συντάκτες αναφέρουν το μικρό μέγεθος του συνόλου δεδομένων ως περιορισμό.
Τι μετρά το Retell vCX Benchmark;
Το Retell vCX Benchmark μετρά πώς τα μοντέλα χειρίζονται γύρους κλήσεων κέντρων επικοινωνίας σε τέσσερις σουίτες. Το ζωντανό leaderboard, όπως διαβάστηκε στις 13 Νοεμβρίου 2026, τις περιγράφει ως εξής:
- Τήρηση οδηγιών: αν το μοντέλο σέβεται τους περιορισμούς ρόλου, τους επιχειρησιακούς κανόνες και τους κανόνες άρνησης.
- Θεμελίωση (grounding): αν οι απαντήσεις παραμένουν εντός του prompt, των εργαλείων και του ανακτημένου πλαισίου.
- Κλήση εργαλείων: αν το μοντέλο επιλέγει τη σωστή ενέργεια και περνά έγκυρα ορίσματα.
- Καθομιλουμένη: αν οι απαντήσεις ακούγονται φυσικές, σύντομες και ασφαλείς για εκφώνηση.
Κάθε σουίτα αναφέρει ποσοστό επιτυχίας σε περίπου 1.000 ή περισσότερες περιπτώσεις και η συνολική βαθμολογία είναι ο μέσος όρος των τεσσάρων. Το leaderboard περιλάμβανε εκείνη την ημερομηνία 62 καταχωρίσεις από 45 μοντέλα και εμφανίζει τη διάμεση καθυστέρηση (latency) και το κόστος ανά λεπτό δίπλα σε κάθε βαθμολογία.
Η δημοσιευμένη σημείωση μεθοδολογίας είναι η ανάρτηση για το vCX-Hard, η οποία καλύπτει τα δύο πρώτα σύνολα δοκιμών, τη θεμελίωση και την κλήση εργαλείων. Οι περιπτώσεις αντλήθηκαν από κλήσεις παραγωγής, με δειγματοληψία από διάφορους οργανισμούς ώστε κανένας μεμονωμένος πελάτης να μην κυριαρχεί. Μια ομάδα μοντέλων-κριτών βαθμολογεί κάθε περίπτωση με βάση ένα σύνολο κριτηρίων και μια λύση αναφοράς. Η ανάρτηση αυτή θεωρεί ως ένδειξη την κατάταξη περισσότερο από τον ακριβή αριθμό.
Τι δεν λέει σε έναν αγοραστή φωνητικών λύσεων: πρόκειται για benchmark προμηθευτή, και ο προμηθευτής έχει δική του καταχώριση. Το Tell-1, το μοντέλο της ίδιας της Retell, κατατάσσεται #1 συνολικά στο Retell vCX Benchmark (Νοέμβριος 2026). Οι περιπτώσεις προέρχονται από την κίνηση της Retell, οπότε οι δικοί σας τύποι κλήσεων μπορεί να εκπροσωπούνται ελάχιστα ή καθόλου. Οι τέσσερις σουίτες βαθμολογούν απαντήσεις και κλήσεις εργαλείων, οπότε τα σφάλματα αναγνώρισης ομιλίας, οι διακοπές και το αν μια ολόκληρη κλήση καταλήγει σε επίλυση βρίσκονται εκτός του πεδίου τους. Τα μοντέλα-κριτές μπορούν επίσης να κάνουν λάθος.
Πώς βαθμολογείται το Tell-1 σε αυτά τα τέσσερα benchmark;
Το Tell-1, το LLM της ίδιας της Retell, είναι ένα πρακτικό παράδειγμα συνδυαστικής ανάγνωσης των τεσσάρων. Η Retell αναφέρει τις παρακάτω βαθμολογίες δημόσιων benchmark στην τεχνική ανάρτησή της για το Retell LLM, ενώ τα στοιχεία του vCX προέρχονται από το ζωντανό leaderboard, όπως διαβάστηκε στις 13 Νοεμβρίου 2026.
| Benchmark | Βαθμολογία Tell-1 | Μέγεθος εκτέλεσης | Ποιος το εκτέλεσε |
|---|---|---|---|
| τ²-bench αεροπορικές εταιρείες | 72,0 | 50 εργασίες | Retell |
| τ²-bench λιανική | 78,0 | 50 εργασίες | Retell |
| Multi-IF | 82,1 | 504 συνομιλίες | Retell |
| GPQA Diamond | 83,5 | 198 ερωτήσεις × 3 | Retell |
| Retell vCX Benchmark | 94,45 μέσος όρος, #1 συνολικά από 62 διαμορφώσεις μοντέλων | Τέσσερις σουίτες, περίπου 1.000 περιπτώσεις η καθεμία | Retell |
Διαβάστε τα όπως προτείνουν οι παραπάνω ενότητες. Κάθε γραμμή είναι δική της εκτέλεση της Retell, βαθμολογημένη με άριστα το 100 και με την ίδια greedy αποκωδικοποίηση κάθε φορά, και η Retell δηλώνει ότι κανένα από τα benchmark δεν χρησιμοποιήθηκε στην εκπαίδευση. Η εκτέλεση του Multi-IF καλύπτει 504 από τις 4.501 συνομιλίες του benchmark και οι εκτελέσεις του τ²-bench καλύπτουν 50 εργασίες ανά τομέα, επομένως δεν είναι άμεσα συγκρίσιμες με τα στοιχεία των αρχικών paper ή άλλων leaderboard.
Στο vCX οι βαθμολογίες ανά σουίτα διαφέρουν: 96,6% στην καθομιλουμένη (θέση 1), 97,2% στη θεμελίωση (θέση 2), 88,6% στην τήρηση οδηγιών (θέση 2) και 95,4% στην κλήση εργαλείων (θέση 5). Άλλα μοντέλα προηγούνται σε τρεις από τις τέσσερις σουίτες. Η ίδια επιφύλαξη ισχύει εδώ όπως για κάθε μοντέλο: αυτοί οι αριθμοί εξασφαλίζουν στο Tell-1 μια θέση στη λίστα υποψηφίων, και μια δοκιμή στις δικές σας κλήσεις αποφασίζει τα υπόλοιπα.
Τι παραλείπουν οι βαθμολογίες benchmark για έναν αγοραστή φωνητικών πρακτόρων AI;
Οι βαθμολογίες benchmark παραλείπουν την πλατφόρμα γύρω από το μοντέλο και τις συνθήκες των δικών σας κλήσεων. Μια τηλεφωνική κλήση προσθέτει αναγνώριση ομιλίας, εναλλαγή σειράς ομιλίας, σύνθεση ομιλίας, τηλεφωνία και καθυστέρηση (latency) σε κάθε στάδιο. Κανένα από τα τέσσερα benchmark, στη μορφή που περιγράφεται εδώ, δεν τα βαθμολογεί.
Τα αποτελέσματα μπορεί να διαφέρουν ανά πλατφόρμα ακόμη και όταν ο πράκτορας είναι ίδιος. Σε μια μελέτη του παρόχου δοκιμών Cekura, ένας πράκτορας αναπτύχθηκε αμετάβλητος σε έξι φωνητικές πλατφόρμες και οι βαθμολογίες ροής εργασιών κυμάνθηκαν από 65,2% έως 95,7%. Η σύνοψη της Retell για εκείνη τη μελέτη Medicare καλύπτει τη μεθοδολογία και τη γνωστοποίηση που ισχύει γι' αυτήν.
Πώς πρέπει ένας αγοραστής να χρησιμοποιεί τις βαθμολογίες benchmark;
Χρησιμοποιήστε τις βαθμολογίες benchmark για να καταρτίσετε μια λίστα υποψηφίων και, στη συνέχεια, αποφασίστε με βάση τις δικές σας κλήσεις. Μια λογική σειρά:
- Αντιστοιχίστε το benchmark στον κίνδυνο: αποτελέσματα χρήσης εργαλείων αν η λάθος ενέργεια είναι η δαπανηρή αποτυχία, τήρηση οδηγιών αν ο πράκτορας πρέπει να ακολουθεί ένα μεγάλο σενάριο.
- Ελέγξτε την έκδοση, την ημερομηνία και ποιος εκτέλεσε τη δοκιμή.
- Προτιμήστε αριθμούς επαναλαμβανόμενων δοκιμών, όπως το pass^k, όταν αναφέρονται.
- Αναδημιουργήστε τη δοκιμή με τα δικά σας σενάρια και θεωρήστε ένα σενάριο επιτυχές μόνο όταν όλες οι επαναλαμβανόμενες εκτελέσεις είναι επιτυχείς.
Στη Retell, οι δοκιμές προσομοίωσης επιτρέπουν σε ένα AI να παίζει τον ρόλο του καλούντος, ενώ τα κριτήρια επιτυχίας χαρακτηρίζουν κάθε εκτέλεση ως επιτυχή ή αποτυχημένη, και οι μαζικές δοκιμές εκτελούν ξανά αποθηκευμένες περιπτώσεις μετά από κάθε αλλαγή του prompt. Μετά την κυκλοφορία, το AI QA βαθμολογεί ένα δείγμα πραγματικών κλήσεων σε μετρικές όπως οι ψευδαισθήσεις (hallucination) και η χρήση εργαλείων, ενώ οι δοκιμές A/B μοιράζουν τη ζωντανή κίνηση μεταξύ δύο πρακτόρων. Για την επιλογή μοντέλου, δείτε ποιο LLM πρέπει να τροφοδοτεί τον φωνητικό πράκτορα AI σας. Για τη διαδικασία αγοράς, δείτε πώς να αξιολογήσετε μια πλατφόρμα φωνητικών πρακτόρων AI.
Ένα benchmark σας λέει ποια μοντέλα αξίζουν δοκιμή. Ένα πιλοτικό σε πραγματικές κλήσεις σας λέει ποιο να χρησιμοποιήσετε. Η Retell είναι μια πλατφόρμα φωνητικών πρακτόρων AI για κέντρα επικοινωνίας, με τιμή από 0,07 $ ανά λεπτό, ώστε να μπορείτε να την αποδείξετε στις δικές σας κλήσεις πριν υπογράψετε οτιδήποτε.
Συχνές ερωτήσεις
Ποια είναι η διαφορά μεταξύ pass^1 και pass^k;
Το pass^1 είναι το ποσοστό των εργασιών που ένας πράκτορας επιλύει με μία μόνο προσπάθεια. Το pass^k είναι το ποσοστό που επιλύει σε καθεμία από k επαναλαμβανόμενες προσπάθειες στην ίδια εργασία. Το pass^k είναι πάντα ίσο ή χαμηλότερο από το pass^1, και η διαφορά δείχνει πόσο συνεπής είναι ο πράκτορας.
Είναι το τ-bench ίδιο με το τ²-bench;
Όχι. Το τ-bench είναι το αρχικό benchmark του 2024 με τομείς αεροπορικών εταιρειών και λιανικής. Το τ²-bench είναι η συνέχεια του 2025 από την ίδια ομάδα, η οποία διατηρεί επαληθευμένες εκδόσεις αυτών των δύο τομέων και προσθέτει έναν τομέα τηλεπικοινωνιών όπου ο προσομοιωμένος πελάτης χρησιμοποιεί επίσης εργαλεία.
Γιατί ένα επιστημονικό τεστ όπως το GPQA Diamond χρησιμοποιείται για τη σύγκριση μοντέλων για συνομιλίες με πελάτες;
Το GPQA Diamond χρησιμοποιείται ως γενικό μέτρο ικανότητας συλλογιστικής. Δεν λέει τίποτα άμεσα για συνομιλίες, εργαλεία ή ομιλία. Διαβάστε το ως έλεγχο του βάθους συλλογιστικής και βασιστείτε σε benchmark εργασιών για τα υπόλοιπα.
Ποιο benchmark έχει τη μεγαλύτερη σημασία για έναν φωνητικό πράκτορα AI;
Κανένα μεμονωμένα. Η χρήση εργαλείων βάσει πολιτικής, η τήρηση οδηγιών σε διαδοχικούς γύρους και η θεμελίωση αντιστοιχούν περισσότερο στην εργασία ενός κέντρου επικοινωνίας, επομένως τα τ²-bench, Multi-IF και vCX Benchmark είναι τα πιο κατάλληλα. Μια βαθμολογημένη δοκιμή στα δικά σας σενάρια κλήσεων έχει μεγαλύτερη σημασία από οποιοδήποτε από αυτά.
Πώς βαθμολογήθηκε το Tell-1 στα τ²-bench, Multi-IF και GPQA Diamond;
Η Retell αναφέρει για το Tell-1 72,0 στο τ²-bench αεροπορικών εταιρειών, 78,0 στο τ²-bench λιανικής, 82,1 στο Multi-IF και 83,5 στο GPQA Diamond, με άριστα το 100 σε κάθε περίπτωση. Πρόκειται για δικές της εκτελέσεις της Retell σε 50 εργασίες ανά τομέα του τ²-bench, 504 συνομιλίες του Multi-IF και τις 198 ερωτήσεις του GPQA Diamond.
See how much your business could save by switching to AI-powered voice agents.
ROI Result
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Estimate your monthly voice AI cost
Read Other Blogs


Επαναστατήστε τη διαχείριση κλήσεων σας με τη Retell


