Hvad produktteams kigger efter i en stemme-AI-platform




En stemme-AI-platform er den software, et produktteam bruger til at bygge, forbinde, teste og køre AI-stemmeagenter på telefon- og webopkald. Produkt- og udviklingsledere vælger sjældent en platform ud fra en demo. De bygger den samme agent på hver platform på shortlisten og tjekker selv fire ting: hvor hurtigt den første fungerende agent kommer på plads, hvor langt API'et og workflowværktøjerne rækker, hvor længe opkaldere venter på svar, og hvad der ændrer sig, når en pilot bliver til produktionstrafik.
Denne guide er en plan for den praktiske sammenligning. Retell AI udgiver guiden og er en af de platforme, produktteams sammenligner, sammen med Vapi, ElevenLabs og Bland. Det, vi skriver om de tre andre, stammer fra hver leverandørs egen dokumentation, læst den 10. november 2026 og linket. Vi har ikke foretaget testopkald til denne guide, så den indeholder ingen scorer og ingen rangering. Det, vi skriver om Retell, stammer fra den offentlige Retell-dokumentation, inklusive de begrænsninger, dokumentationen selv nævner.
Hvad tjekker et produktteam, som en demo ikke viser?
En demo viser ét godt opkald. En praktisk sammenligning viser, hvad dine egne udviklere kan bygge, forbinde og måle. Giv én udvikler den samme opkaldstype på hver platform, en rigtig en som fx at booke et møde via jeres planlægnings-API, og registrér de samme fire resultater på hver.
| Hvad der skal tjekkes | Hvad dit team gør | Hvad der skal noteres |
|---|---|---|
| Hvor nemt det er at bygge | Byg agenten fra en tom konto til et første opkald uden hjælp fra leverandøren | Timer til et første fungerende opkald og hvert punkt, hvor I gik i stå |
| API- og workflowdybde | Kald jeres eget API under et opkald, modtag opkaldshændelser, opret agenten fra kode | Hvilke trin der krævede en nødløsning |
| Svarlatens | Foretag mindst 20 opkald, og hent timingen for hver tur | Median og 95. percentil med den definition, leverandøren bruger |
| Fra pilot til stor skala | Læs grænserne, fejladfærden og udgivelseskontrollerne, før du får brug for dem | Standardgrænser, hvad der sker, når du når dem, og hvad der driver omkostningerne |
Hvor hurtigt kan dit team bygge den første fungerende agent?
Mål tiden fra en tom konto til et opkald, din udvikler ville vise en kollega, og notér hvert punkt, hvor vedkommende måtte bede leverandøren om hjælp. Et svar fundet i dokumentationen tæller som selvbetjening.
To ting afgør den tid på de fleste platforme. Den første er, hvor meget struktur du skal designe, før agenten kan tale. Retell-dokumentationen anbefaler at starte med en agent med én prompt og først gå over til et samtaleflow, som deler opgaven op i noder med hver deres instruktioner, når en enkelt prompt ikke længere kan opfylde dine krav. Samme side er ærlig om afvejningen: "Et samtaleflow er ikke automatisk mere pålideligt."
Den anden er, hvor hurtigt du kan høre agenten og fange dens fejl. I testoversigten fra Retell nævnes fire metoder: tekstchat i LLM Playground, gemte simuleringstestcases, browseropkald "uden et telefonnummer" og rigtige telefonopkald. Sæt budget af til testopkaldene. Hos Retell faktureres test til de samme takster som produktion. En komplet gennemgang af en første opbygning finder du i sådan bygger du en AI-stemmeagent.
Hvor nemt det er at bygge, afhænger også af, hvad platformen kører for dig. Ifølge Retell-dokumentationen "kører platformen telefoni-, tale- og sprogmodellagene, så du konfigurerer agenten i stedet for at forbinde udbydere." Dit team ejer agentens adfærd uden at vedligeholde infrastrukturen under den. Om den byttehandel passer til jer, er en separat beslutning, som gennemgås i byg selv eller køb AI-stemmeagenter.
Hvor dybt går API'et og workflowværktøjerne?
Dybt nok betyder to ting: Dine udviklere kan gøre fra kode, hvad de gjorde i dashboardet, og agenten kan nå jeres systemer under et opkald uden et middleware-projekt. Tjek fem områder på hver platform.
- SDK'er og API-dækning. Spørg, om hver handling i dashboardet har et endpoint. Retell udgiver officielle SDK'er til Node.js og Python, beskrevet som typede klienter med fuld endpoint-dækning for stemme og chat.
- Kald af jeres API under et opkald. En brugerdefineret funktion i Retell sender en GET-, POST-, PUT-, PATCH- eller DELETE-anmodning til jeres endpoint og venter på svaret. Timeoutten er 1 til 600 sekunder med 120 som standard. Anmodninger forsøges ikke igen, medmindre du angiver et antal genforsøg. Spørg hver leverandør, hvad opkalderen hører, mens en langsom anmodning kører.
- Opkaldshændelser. Webhooks fra Retell sender hændelserne call_started, call_ended og call_analyzed til jeres server. Hver har en timeout på 10 sekunder og forsøges igen op til 3 gange. En signaturheader lader dig verificere afsenderen.
- MCP i begge retninger. En Retell-agent kan kalde værktøjer på en ekstern MCP-server under et live opkald. Retell har også sin egen MCP-server, som lader klienter som Cursor og Claude Code bygge og administrere agenter via API'et.
- Din egen model og din egen operatør. Med en tilpasset LLM håndterer Retell opkaldet og åbner en WebSocket til jeres server for hvert opkald. Dokumentationen anbefaler de indbyggede agenttyper til de fleste agenter og siger, at du med en tilpasset LLM selv står for latens, oppetid og håndtering af genforbindelse. Til telefonlinjer forbinder tilpasset telefoni via elastisk SIP-trunking eller ved at ringe op til en SIP-URI.
Tjek også færdige forbindelser. Integrationsoversigten fra Retell nævner 11 udbydere inden for CRM, support, kalender og vidensbase. Alt uden for den liste går gennem en brugerdefineret funktion, MCP eller en webhook.
Hvordan bør du måle svarlatens?
Mål den på dine egne opkald, tur for tur, og rapportér percentiler med definitionen vedhæftet. Et latenstal uden start- og stoppunkt kan ikke sammenlignes med en anden leverandørs tal.
Retell-dokumentationen definerer end-to-end-latens som tiden fra, brugeren holder op med at tale, til agenten begynder at svare. Ud fra den definition angiver dokumentationen, at platformen "opnår latens helt ned til 600ms." Læs "helt ned til" som et minimum. Dit tal afhænger af den model, den prompt og de indstillinger, du vælger.
Hent dine egne tal pr. opkald. Get Call API fra Retell returnerer et latensobjekt med 50., 90., 95. og 99. percentil for end-to-end-tallet og for transskription, LLM'en, tekst-til-tale og hentning fra vidensbasen. Samme side nævner en begrænsning: End-to-end-tallet omfatter ikke netværksturen fra serveren hos Retell til brugerens enhed. Ved web- og in-app-opkald bør du også tage tid på svaret på klienten.
Når et tal er højt, så se på konfigurationen, før du giver platformen skylden. Guiden til fejlfinding af latens fra Retell nævner valg af LLM-model og promptlængde som de to hyppigste årsager, siger, at prompts over cirka 8.000 tokens bliver mærkbart langsommere, og anbefaler at holde den estimerede latens under 1,5 sekunder. Bed hver leverandør om den samme opdeling pr. komponent.
Hastighed er én faktor i et godt opkald. Stemme-AI-latens: årsager, måling og effekt på opkalderen forklarer, hvor forsinkelsen kommer fra, og hvornår et hurtigere svar gør et opkald dårligere. Offentliggjorte benchmarkresultater for de fire platforme finder du i Retell AI vs Bland AI vs Vapi vs ElevenLabs.
Hvad ændrer sig mellem en pilot og produktion i stor skala?
Tre ting ændrer sig: de grænser, du løber ind i, hvad opkaldere oplever, når noget fejler, og hvordan ændringer når ud til live opkald. Læs hver leverandørs svar, før piloten slutter.
- Samtidighed. Spørg efter standardgrænsen, og hvad der sker ved grænsen. Hos Retell får et workspace med betal efter forbrug 20 samtidige opkald som standard, og du kan hæve grænsen fra dashboardet. Ved grænsen venter et nyt indgående opkald på en ledig plads. Efter cirka 40 sekunder viderestilles det til et fallback-nummer, hvis du har angivet et, og ellers afsluttes opkaldet. Et udgående opkald over grænsen afvises, medmindre du slår concurrency burst til, som tilføjer et tillæg pr. minut.
- Oppetid og fallbacks. Pålidelighedsoversigten fra Retell angiver en garanti på mere end 99,9 % oppetid og linker til en offentlig statusside. Den nævner LLM-fallback og genforsøg som indbygget samt en Backup mode, der omdirigerer nye indgående opkald til et fallback-nummer, mens du undersøger et problem.
- Udgivelseskontrol. Versioner, staging-tags, batchkørsler fra din CI-pipeline og procentvis trafikfordeling afgør, hvor sikkert en ændring rulles ud. Det emne har sin egen guide: købskravene til stemme-AI.
- Sikkerhedsgennemgang. Start den under piloten. Ifølge siden om sikkerhed og compliance fra Retell er platformen HIPAA-compliant, GDPR-compliant og SOC 2 Type 1- og Type 2-certificeret, og den tilbyder en BAA via selvbetjening.
- Omkostningsdrivere. Retell-priserne er forbrugsbaserede, fra $0,07 pr. minut på prissiden. Taksten afhænger af den stemme, model og telefoni, du vælger, og nogle latensmuligheder koster mere end standardmodeltaksten. Sådan fungerer forbrugsbaseret prissætning forklarer delene.
Til design af piloten gennemgår sådan evaluerer du en stemmeagentplatform før go-live, hvilke opkald du skal tage med, og hvad du skal måle, og fra stemme-AI-demo til produktion dækker de første 30 dage.
Hvordan beskriver Vapi, ElevenLabs, Bland og Retell sig selv?
Hver leverandørs dokumentation beskriver en platform til at bygge, implementere og overvåge stemmeagenter med en promptbaseret måde at starte på og en mere struktureret mulighed. Tabellen citerer hver leverandørs egen dokumentation, læst den 10. november 2026.
| Platform | Sådan beskriver dens egen dokumentation den | Byggemuligheder, som dokumentationen nævner |
|---|---|---|
| Retell AI | "En platform til at bygge, teste, implementere og overvåge AI-stemme- og chatagenter med indbygget telefoni, prompts, værktøjer og analyse" (Retell-dokumentation) | Agenter med én prompt og samtaleflow-agenter |
| Vapi | "Udviklerplatformen til at bygge stemme-AI-agenter" (Vapi-dokumentation) | Assistants, der bruger én systemprompt plus værktøjer og strukturerede output, og Squads, der kører flere assistenter med viderestillinger, som bevarer konteksten. Du vælger udbyderne af tale-til-tekst, LLM og tekst-til-tale |
| ElevenLabs | ElevenAgents tilbyder "udtryksfulde modeller med rige stemmer, udviklerværktøjer til at bygge multimodale agenter og værktøjer til at overvåge og evaluere agenters ydeevne i stor skala" (ElevenLabs-dokumentation) | Et udviklerværktøjssæt, et dashboard eller en visuel workflowbygger med SDK'er til React, Swift, Kotlin, React Native og Unity |
| Bland | "Alt, hvad du behøver for at bygge, overvåge og forbedre stemme-AI-agenter i Bland" (Bland-dokumentation) | En agent builder, hvor "de fleste agenter starter som en enkelt prompt", og pathways tilføjer struktur, hvor samtalen har brug for det |
Beskrivelserne ligner hinanden, så det er ikke dem, der træffer valget for dig. De fire tjek køres på din opkaldstype og dine systemer. For detaljer side om side udgiver Retell sammenligninger med Vapi, ElevenLabs og Bland samt en guide til Vapi-alternativer.
Hvordan gennemfører du sammenligningen fair?
Hold alt konstant undtagen platformen. Brug én opkaldstype, én udvikler, ét script for opkalderens adfærd og ét scorecard, og udfyld de samme felter for hver leverandør.
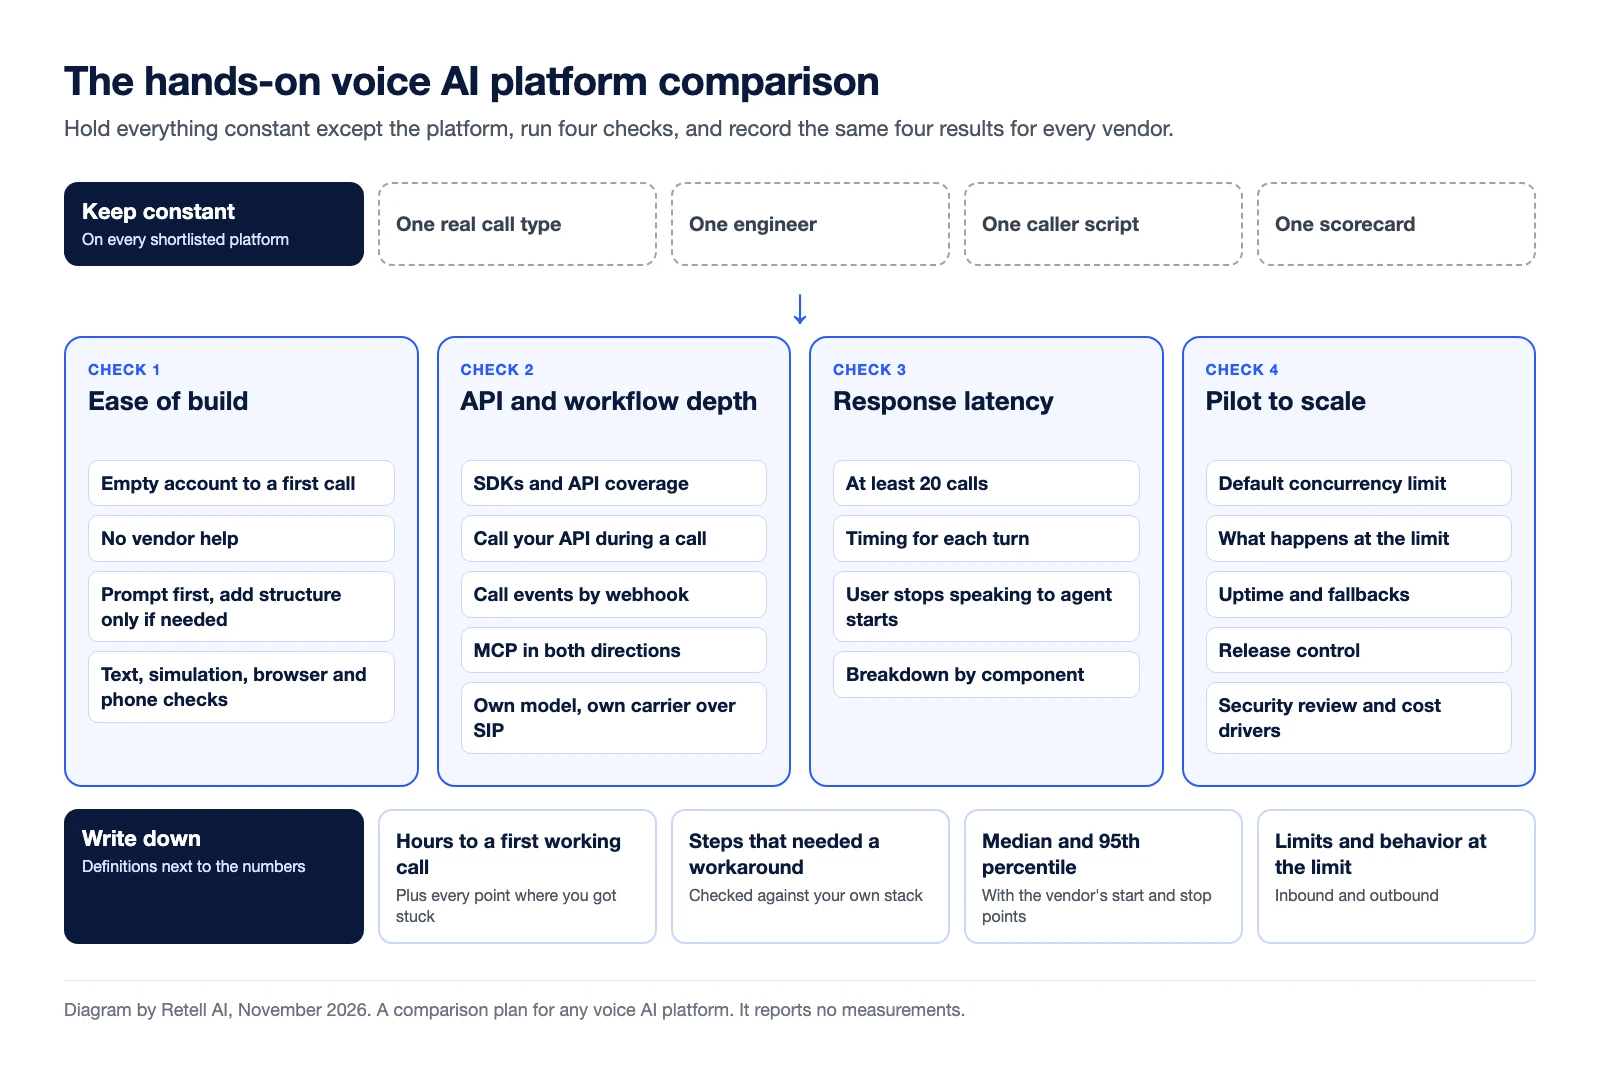
Skriv opkalderscriptet, før nogen begynder at bygge. Medtag en afbrydelse, en rettelse, et spørgsmål, agenten bør afvise, og én anmodning, der kræver jeres API. Sammenlign derefter de fire resultater side om side med hver leverandørs definitioner ved siden af dens tal.
Nogen skal eje agenten, når valget er truffet. Mange teams giver den opgave til en CX-engineer, også kaldet en CX automation engineer eller en intern deployed engineer: den interne ejer, der finder dårligt håndterede opkald, bygger rettelser, tjekker dem og implementerer dem. Hvis du allerede har den person, så tag vedkommende med i sammenligningen. Hvad den ledende sponsor har brug for fra platformen og leverandøren, gennemgås i hvad CX-ledere har brug for fra AI-stemmeagenter.
Ofte stillede spørgsmål
Hvad bør et produktteam kigge efter i en stemme-AI-platform?
Fire ting, alle tjekket i praksis: hvor hurtigt din egen udvikler kan bygge en første fungerende agent, hvor langt API'et, webhooks og workflowværktøjerne rækker, hvor længe opkaldere venter på svar på dine egne opkald, og hvordan grænserne og fejladfærden ser ud ved produktionsvolumen. Kør de samme tjek på hver platform på shortlisten.
Hvordan sammenligner man stemme-AI-platforme i praksis?
Vælg én rigtig opkaldstype, giv én udvikler den samme opgave på hver platform, og foretag de samme scriptede opkald på hver. Registrér timer til et første fungerende opkald, de trin, der krævede en nødløsning, median og 95. percentil for svartid samt standardgrænserne. Hold hver leverandørs definitioner ved siden af dens tal.
Hvad er en god svarlatens for en AI-stemmeagent?
Det afhænger af modellen, prompten og indstillingerne, så mål den på dine egne opkald. Retell-dokumentationen angiver latens helt ned til 600ms, målt fra brugeren holder op med at tale, til agenten begynder at svare, og anbefaler at holde den estimerede latens under 1,5 sekunder. Sammenlign kun percentiler på tværs af leverandører, når start- og stoppunkterne er de samme.
Skal du have udviklere for at bygge en AI-stemmeagent?
Ikke til en første agent. Med hurtigstarten fra Retell går du fra en skabelon til et telefonopkald i dashboardet. Udviklere kommer ind i billedet, når agenten skal kalde jeres API under et opkald, sende opkaldshændelser til jeres systemer eller forbinde til jeres egen teleoperatør over SIP. Det er de dele, et produktteam bør bygge under sammenligningen.
Hvor mange samtidige opkald kan en stemme-AI-platform håndtere?
Det afhænger af planen og leverandøren. Hos Retell får et workspace med betal efter forbrug 20 samtidige opkald som standard, og grænsen kan hæves fra dashboardet. Spørg hver leverandør, hvad der sker med et indgående og et udgående opkald, når grænsen er nået.
Kør de fire tjek på dine egne opkald
Retell er en platform til AI-stemmeagenter for kontaktcentre med agenter med én prompt og samtaleflow-agenter, typede SDK'er, brugerdefinerede funktioner, webhooks, MCP, tilpasset telefoni og latensdata pr. opkald. Mere end 4.000 kunder kører over 100 millioner opkald om måneden på Retell, som nåede $100M i annualiseret run rate i november 2026. Priserne er forbrugsbaserede, fra $0,07 pr. minut på prissiden. Byg den samme agent, som du har bygget andre steder, kør den på dine egne opkald, og sammenlign tallene, før du skriver under på noget.
See how much your business could save by switching to AI-powered voice agents.
ROI Result
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Estimate your monthly voice AI cost
Revolutionér din callcenter-drift med Retell


