LLM especializados vs. generalistas para centros de contacto





Un LLM generalista es el punto de partida más seguro para la mayoría de los centros de contacto. Un LLM especializado se gana su sitio cuando un tipo de llamada tiene un volumen alto y un modelo generalista falla una y otra vez de la misma forma medible: primeras palabras lentas, llamadas a herramientas incorrectas o respuestas que suenan como una página web leída en voz alta. Ninguno gana por categoría. El modelo que debes elegir es el que supera tus propias llamadas, ejecución tras ejecución, con un coste por minuto que puedas prever.
Esta guía está pensada para el responsable de la línea telefónica. Retell AI publica esta guía y tiene intereses en ambos lados. Su plataforma ofrece modelos generalistas de OpenAI, Anthropic y Google, y además desarrolla el suyo propio: Tell-1, el LLM propio de Retell, creado para llamadas de centros de contacto. Tell-1 ocupa el puesto n.º 1 en la clasificación general del benchmark público de Retell, el Retell vCX Benchmark (consultado el 13 de noviembre de 2026). Trátalo como cualquier benchmark de un proveedor: un motivo para incluirlo en tu lista de candidatos y, después, algo que comprobar con tus propias llamadas.
¿Qué exige una llamada de un centro de contacto a un modelo de lenguaje?
Una llamada de un centro de contacto pide cinco cosas a un modelo en cada turno: seguir un guion largo, llamar correctamente a las herramientas, sonar natural al hablar, responder rápido y mantener un coste asumible a escala.
- Guiones largos. El prompt del agente contiene los pasos, las políticas y las excepciones de un tipo de llamada, y el modelo tiene que aplicar la regla correcta en cada turno. En el benchmark Multi-IF, los 14 modelos evaluados fallaron más instrucciones con cada turno añadido.
- Llamadas a herramientas. Las reservas, las consultas y las transferencias pasan por herramientas, y una llamada errónea modifica un registro real. El artículo de tau-bench de 2024 concluyó que los agentes con llamada a funciones basados en un modelo generalista líder resolvían con éxito menos del 50 % de sus tareas de atención al cliente, y superaban los ocho intentos repetidos de una tarea de comercio minorista menos del 25 % de las veces.
- Habla natural. La respuesta se escucha, no se lee. Las listas y los símbolos que funcionan en pantalla suenan mal en una voz sintética.
- Velocidad. Las personas dejan pausas breves entre turnos. Una revisión de la investigación sobre la toma de turnos sitúa la pausa típica en unos 200 milisegundos. El modelo es una etapa entre la última palabra de quien llama y la primera del agente, así que el tiempo que tarda en empezar una respuesta se percibe como silencio.
- Coste a escala. En cada turno se reenvían al modelo el guion y toda la conversación hasta ese momento. Los proveedores aplican descuentos a esa entrada repetida (la guía de prompt caching de OpenAI indica descuentos de hasta el 95 % en la entrada en caché), pero con el volumen de un centro de contacto, una pequeña diferencia por minuto se convierte en una partida presupuestaria.
¿Dónde encajan los LLM generalistas en un centro de contacto?
Los LLM generalistas encajan mejor donde las llamadas varían: muchos tipos de llamada, muchos idiomas y preguntas que nadie incluyó en el guion. Se entrenan de forma amplia y los venden varios proveedores, así que un equipo puede cambiar de modelo a medida que cambian sus necesidades.
Además, requieren menos trabajo a medida de lo que muchos compradores suponen. La guía de optimización de modelos de OpenAI describe un ciclo de evaluaciones e ingeniería de prompts, y añade el fine-tuning «para algunos casos de uso». Gran parte de lo que mantiene a un agente fiel al guion reside en el prompt, el flujo de la llamada y las herramientas, y ese trabajo se conserva cuando cambias de modelo.
Los límites aparecen al teléfono. Los modos de razonamiento que piensan antes de responder añaden retraso antes de la primera palabra. Los modelos ajustados para chat escrito necesitan instrucciones para dar respuestas breves y fáciles de pronunciar. Y el proveedor marca el calendario: la política de retirada de modelos de OpenAI da al menos 6 meses de preaviso antes de retirar un modelo de disponibilidad general, y después hay que comprobar el agente con el modelo sustituto. Para un análisis modelo por modelo, consulta qué LLM debería impulsar tu agente de voz con IA.
¿Qué cambia un LLM especializado o con fine-tuning?
Un LLM especializado traslada el comportamiento del prompt al entrenamiento del modelo. En lugar de indicar a un modelo generalista que hable con brevedad, siga las políticas y llame a las herramientas en el momento adecuado, el proveedor lo entrena con ejemplos exactamente de eso, a menudo sobre un modelo más pequeño. Hay tres términos que suelen confundirse:
- Un LLM de dominio específico o vertical es un modelo que un proveedor entrena o ajusta para un sector o una tarea y ofrece a todos sus clientes.
- Un modelo con fine-tuning es un modelo base entrenado adicionalmente con un conjunto de datos más acotado, a menudo el tuyo. La entrada del glosario sobre fine-tuning de modelos de IA explica el funcionamiento.
- Un LLM personalizado suele referirse a cualquier modelo que tú mismo conectas a una plataforma, con o sin ajuste.
La guía sobre la precisión de los LLM de OpenAI da dos motivos para hacer fine-tuning: mejorar la precisión en una tarea concreta y mejorar la eficiencia, es decir, obtener la misma precisión con menos tokens o con un modelo más pequeño. En las llamadas, eso puede traducirse en un seguimiento del guion más estable, prompts más cortos y un menor coste por minuto.
La idea no es nueva. Observe.AI anunció un Contact Center LLM en junio de 2023, que describe como un modelo de 30.000 millones de parámetros entrenado con un conjunto de datos de dominio específico de cientos de millones de interacciones con clientes. Las mejoras de precisión de ese anuncio proceden de los benchmarks iniciales del propio proveedor. Es lo habitual en la categoría, y por eso tu propia evaluación importa más que cualquier anuncio.
¿Qué ventajas e inconvenientes tiene cada uno?
Los compromisos son la dependencia del proveedor, la cobertura y la carga de evaluación, y cada uno actúa en ambas direcciones.
| Factor | LLM generalista | LLM especializado o con fine-tuning |
|---|---|---|
| Mejor encaje | Tipos de llamada variados, muchos idiomas, preguntas fuera de guion | Un tipo de llamada de alto volumen con reglas estables |
| Comportamiento con guiones y herramientas | Definido por el prompt y el flujo de la llamada | Incorporado en el entrenamiento, por lo que se necesita menos prompt |
| Velocidad y coste por minuto | Depende del tamaño del modelo y del modo de razonamiento | Puede ser menor si el modelo es más pequeño |
| Dependencia del proveedor | Varios proveedores, cada uno retira modelos según su propio calendario | A menudo un único proveedor o una única plataforma |
| Cobertura | Amplia | Más limitada fuera de los datos de entrenamiento |
| Evidencia disponible | Benchmarks públicos, pocos de ellos sobre llamadas telefónicas | A menudo el benchmark del propio proveedor |
| Carga de evaluación | Una nueva comprobación cada vez que se retira un modelo | Una comprobación antes de adoptarlo y después de cada reentrenamiento |
Dependencia del proveedor. Un modelo especializado suele venderlo un único proveedor, a veces dentro de una sola plataforma. Pregunta si puedes cambiar de modelo sin reconstruir el agente y si los prompts, los flujos y los casos de prueba siguen siendo tuyos. Los modelos generalistas conllevan una versión más discreta del mismo riesgo cuando un proveedor retira una versión.
Cobertura. Un modelo entrenado con llamadas de citas en inglés puede rendir peor en español o ante una disputa de facturación que nunca vio. Pide resultados por idioma y por tipo de llamada, no una media.
Carga de evaluación. Los benchmarks públicos rara vez miden llamadas telefónicas, y un benchmark de proveedor es evidencia elegida por quien vende. Si haces fine-tuning de tu propio modelo, la carga aumenta. La guía de precisión de OpenAI indica que los ejemplos de entrenamiento «deben representar exactamente lo que el modelo verá en el mundo real» y recomienda un conjunto de reserva para detectar el sobreajuste.
¿Cómo evalúas cualquiera de los dos modelos con tus propias llamadas?
Evalúa ambos de la misma manera: escenarios fijos extraídos de tus propias llamadas, calificados según criterios de éxito por escrito, ejecutados más de una vez y, después, un reparto del tráfico real.
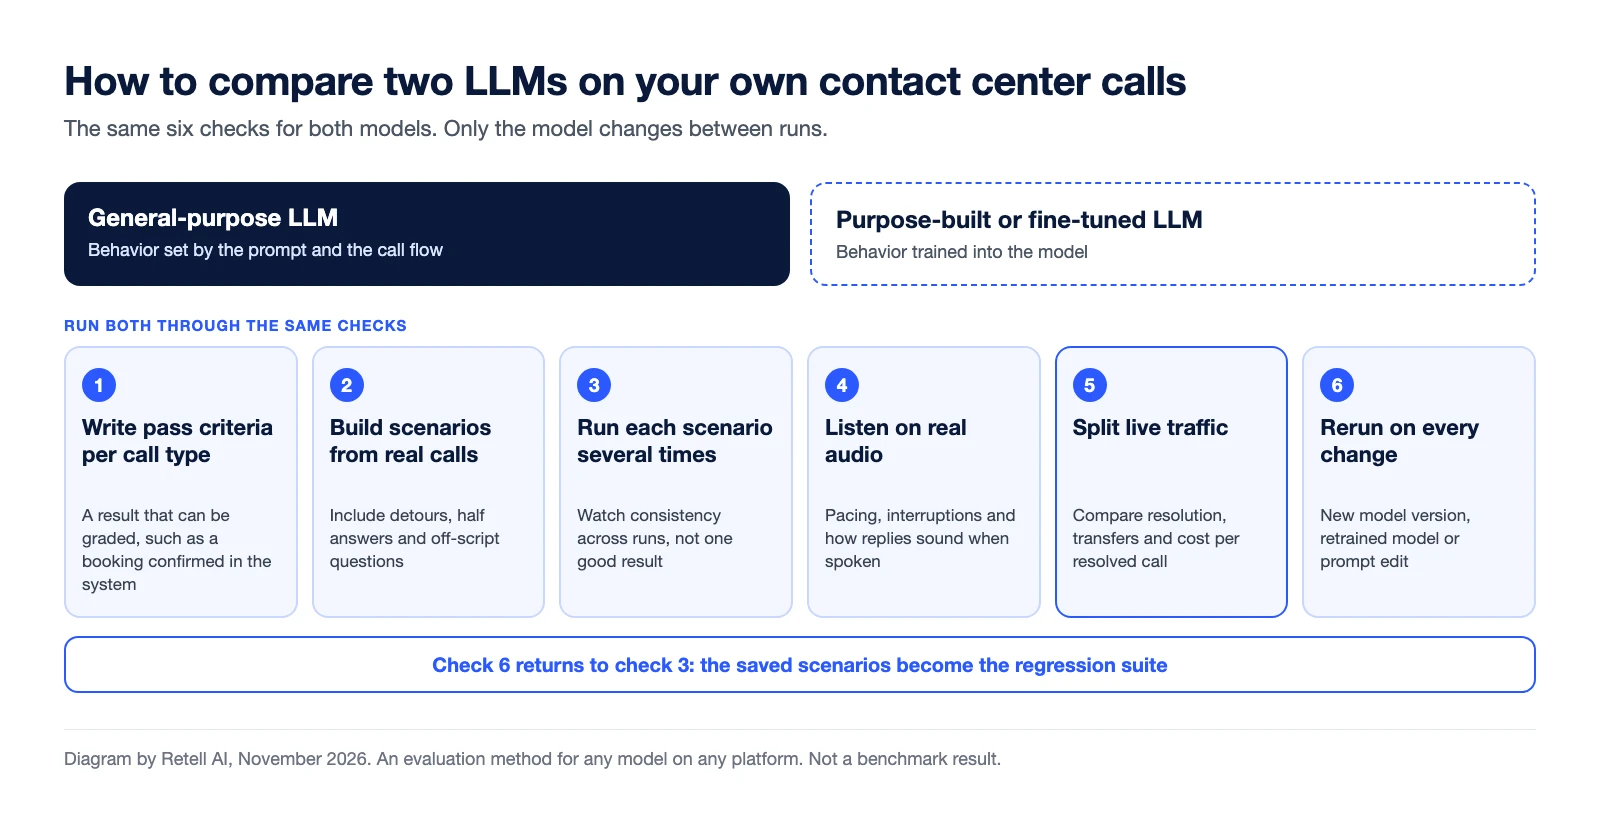
- Redacta criterios de éxito por tipo de llamada. «Cita registrada en el sistema de agenda y confirmada a quien llama» se puede calificar. «Sonaba bien», no.
- Crea escenarios a partir de llamadas reales. Incluye los desvíos: la persona que cambia de opinión, hace una pregunta fuera de guion o da una respuesta a medias.
- Ejecuta cada escenario varias veces en cada modelo. Los autores de tau-bench propusieron la métrica pass^k para medir la fiabilidad en intentos repetidos.
- Escucha con audio real. Los resultados en texto no captan el ritmo, las interrupciones ni cómo suena una respuesta al pronunciarse.
- Reparte el tráfico real. Envía una parte de las llamadas a cada opción y compara la resolución, las transferencias y el coste por llamada resuelta.
- Vuelve a ejecutar con cada cambio. Una nueva versión del modelo, un modelo reentrenado y una edición del prompt requieren la misma suite.
En Retell, las pruebas de simulación califican cada ejecución como superada o fallida según criterios de éxito, las pruebas por lotes vuelven a ejecutar los casos guardados como suite de regresión y las pruebas A/B reparten el tráfico de llamadas entre agentes por porcentaje. La documentación indica que puedes cambiar de modelo más adelante sin reescribir tu prompt. Si usas tu propio modelo, las pruebas de simulación y por lotes no se aplican, y la forma de comprobarlo son las llamadas web y telefónicas. Para el piloto en general, consulta cómo evaluar una plataforma de agentes de voz con IA antes de su puesta en marcha.
¿Dónde encaja Tell-1 en esta comparación?
Tell-1, el LLM propio de Retell, es un modelo especializado para llamadas de centros de contacto, así que todos los compromisos de esta guía se le aplican. Esta es su posición en cada uno, con la fuente de cada cifra.
- Guiones, herramientas y habla. En el Retell vCX Benchmark, Tell-1 obtiene una media de 94,45 y ocupa el puesto n.º 1 en la clasificación general. Por suite, obtiene un 88,6 % en seguimiento de instrucciones (puesto 2), un 97,2 % en fundamentación (puesto 2), un 95,4 % en llamadas a herramientas (puesto 5) y un 96,6 % en habla coloquial (puesto 1), todo consultado el 13 de noviembre de 2026. Retell gestiona ese benchmark, así que úsalo como sugiere esta guía: como un motivo para incluirlo en tu lista de candidatos.
- Velocidad. Tiene la latencia mediana más baja de la clasificación, 76 ms (consultado el 13 de noviembre de 2026). Es la cifra del modelo en el benchmark, no el tiempo de respuesta de extremo a extremo de una llamada.
- Coste. El benchmark lo sitúa en 3,5 céntimos por minuto. Es solo la partida del LLM, no el precio de una llamada, y algunas configuraciones generalistas de la clasificación cuestan menos. Los precios de Retell empiezan desde 0,07 $ por minuto.
- Cómo funciona. El modelo empieza su respuesta y sigue razonando mientras suenan las primeras palabras. El artículo técnico, Retell LLM: Interleaved Reasoning for Real-Time Voice Agents, indica una media de unos 200 tokens de razonamiento a mitad de respuesta y describe las tres fases de entrenamiento que hay detrás.
- Dependencia del proveedor. Tell-1 se ofrece dentro de Retell. Está en el mismo selector de modelos que los modelos de OpenAI, Anthropic y Google, y la documentación de Retell indica que puedes cambiar de modelo más adelante sin reescribir tu prompt, así que elegirlo no te cierra las demás opciones.
- Cobertura. Un modelo creado para llamadas es más limitado por diseño. Prueba Tell-1 con tus propios idiomas y tipos de llamada antes de confiar en él, y mantén un modelo generalista para cualquier tipo de llamada en el que quede segundo.
- Evaluación. Las seis comprobaciones anteriores se aplican sin cambios. Como Tell-1 es un modelo gestionado por Retell, las pruebas de simulación y por lotes funcionan con él, y un reparto A/B puede enviar el mismo tráfico a dos copias de un agente que solo se diferencian en el modelo.
El resumen justo: Tell-1 es la opción especializada que debes incluir en tu lista de candidatos si trabajas con Retell, y los modelos generalistas que tiene al lado son el grupo de control. Consulta Tell-1 para ver los detalles del producto.
Preguntas frecuentes
¿Qué es un LLM especializado?
Un LLM especializado es un modelo de lenguaje entrenado o ajustado para una tarea concreta, como gestionar llamadas de centros de contacto, en lugar de para un uso general. También se denomina LLM de dominio específico o vertical. Un modelo de lenguaje de gran tamaño generalista se adapta a la tarea mediante prompts y herramientas.
¿Son los LLM especializados más precisos que los generalistas?
En la tarea para la que se entrenaron, pueden serlo. Fuera de ella, a menudo no. La mayoría de las comparaciones publicadas proceden del proveedor que creó el modelo, así que prueba ambos con tus propios escenarios.
¿Necesita un centro de contacto entrenar su propio LLM?
Normalmente no. La guía de optimización de OpenAI empieza por las evaluaciones y la ingeniería de prompts, y añade el fine-tuning solo para algunos casos de uso. Entrenar tu propio modelo también implica encargarte de los datos de entrenamiento y de un conjunto de reserva.
¿Un LLM personalizado es lo mismo que un modelo con fine-tuning?
No siempre. En la mayoría de las plataformas de voz, un LLM personalizado es cualquier modelo que alojas y conectas tú mismo, con o sin fine-tuning. La opción de LLM personalizado de Retell conecta tu propio modelo mediante un WebSocket mientras Retell se encarga de la telefonía, la transcripción y la toma de turnos.
¿Puede un centro de contacto usar más de un LLM?
Sí. En Retell, cada agente tiene su propia configuración de modelo, y la documentación de configuración del LLM describe un fallback rápido que ejecuta un modelo de respaldo en paralelo al principal.
¿Es Tell-1 un LLM especializado?
Sí. Tell-1 es el LLM propio de Retell, creado para llamadas de centros de contacto. Ocupa el puesto n.º 1 en la clasificación general del Retell vCX Benchmark con una media de 94,45 (consultado el 13 de noviembre de 2026). Es una de las opciones del selector de modelos de Retell, junto a modelos generalistas de OpenAI, Anthropic y Google.
Compara modelos con tus propias llamadas antes de comprometerte
Retell es una plataforma de agentes de voz con IA para centros de contacto. Cada agente tiene un selector de modelos, y la página de precios incluye modelos de OpenAI, Anthropic y Google junto con una opción personalizada para un modelo que alojes tú. Tell-1, el LLM propio de Retell, está en el mismo selector. Las personas más cercanas a tus clientes pueden cambiar el modelo, volver a ejecutar la suite de pruebas y repartir el tráfico por sí mismas. A diferencia de trabajar con un proveedor de IA gestionada, ese cambio no se convierte en un ticket, una cola de espera ni otro SOW. Los precios se basan en el uso, desde 0,07 $ por minuto en la página de precios. Elige un tipo de llamada y tus propios criterios de éxito, y haz un piloto con llamadas reales antes de firmar nada.
Descubre cuánto podría ahorrar tu empresa al pasar a agentes de voz impulsados por IA.
Resultado del ROI
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Estimate your monthly voice AI cost
Read Other Blogs


Revoluciona tu operación de llamadas con Retell


