Benchmarks de agentes de IA explicados para agentes de voz





Un benchmark de agentes de IA es un conjunto fijo de tareas con una regla de puntuación, que se usa para comparar modelos en el mismo trabajo. Para los agentes de voz con IA, conviene conocer cuatro: τ²-bench (tau2-bench), para el uso de herramientas bajo una política; Multi-IF, para seguir instrucciones a lo largo de varios turnos; GPQA Diamond, para el razonamiento complejo; y el Retell vCX Benchmark, para llamadas de centro de contacto. Cada uno mide una sola parte de lo que ocurre en una llamada telefónica.
Esta guía explica qué evalúa cada benchmark, cómo se puntúa y qué no te dice la puntuación. Retell AI publica esta guía y también publica uno de los cuatro benchmarks, el vCX Benchmark. Las puntuaciones cambian con cada nuevo modelo, así que cada sección enlaza a la fuente que recoge los resultados actuales.
¿Qué es un benchmark de agentes de IA?
Un benchmark de agentes de IA da a todos los modelos las mismas tareas y el mismo evaluador, y después indica con qué frecuencia el modelo resuelve bien la tarea. Lo que significa una puntuación depende de la tarea, de quién o qué hace de interlocutor en la conversación y de cómo se decide si se supera.
Hay tres tipos de evaluadores. Una comprobación de estado compara el resultado de las acciones del agente con un resultado correcto conocido, como una base de datos tras un reembolso. Una comprobación por reglas ejecuta un script sobre la respuesta. Un modelo juez califica la respuesta según una rúbrica. Las comprobaciones de estado y por reglas son repetibles, pero limitadas. Los modelos jueces pueden valorar el tono y el significado, aunque tienen sus propios puntos ciegos.
¿Qué miden los cuatro benchmarks, comparados entre sí?
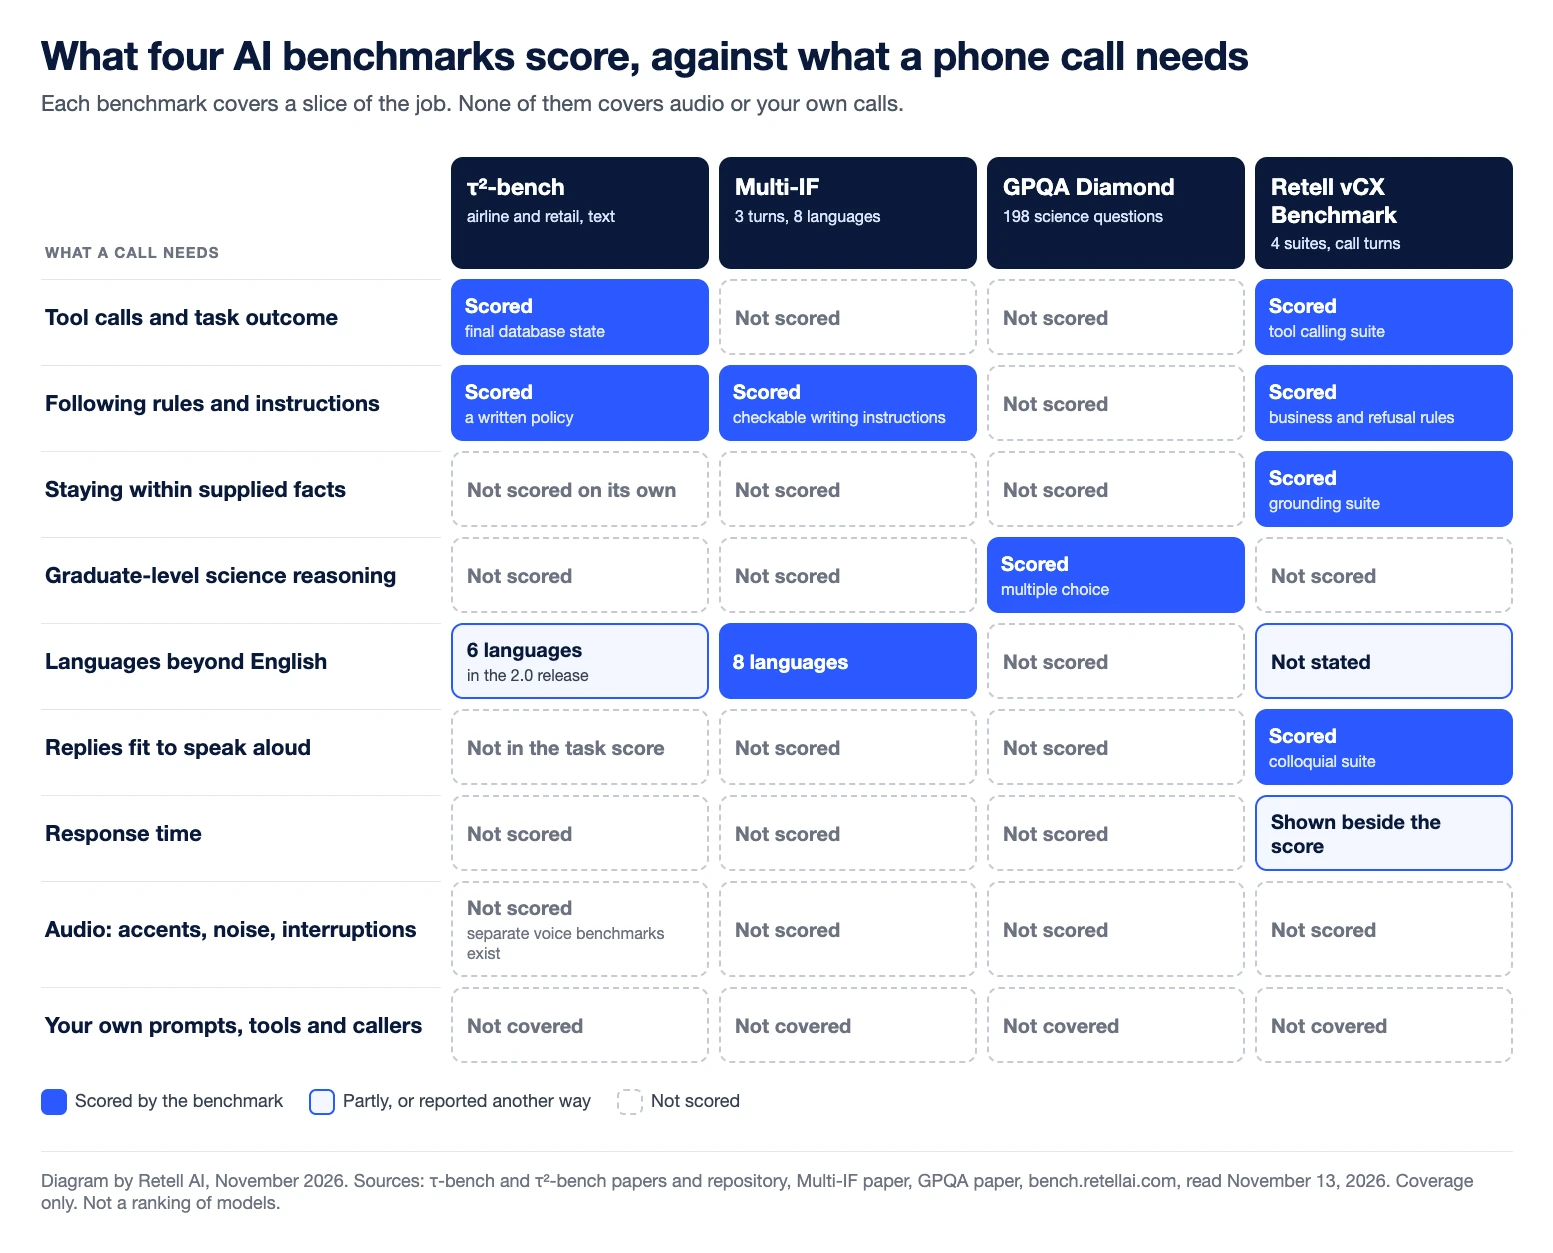
Cubren habilidades distintas, y solo el vCX Benchmark se construye a partir de llamadas telefónicas. La tabla resume cada uno según su artículo, repositorio o clasificación, consultados el 13 de noviembre de 2026.
| Benchmark | Publicado por | En qué consiste la tarea | Cómo se puntúa | Qué deja fuera para quien compra voz |
|---|---|---|---|---|
| τ²-bench, aerolínea y comercio minorista | Sierra | Atender a un cliente simulado en una conversación de texto, usando herramientas y siguiendo una política escrita | 0 o 1 por conversación: la base de datos final debe coincidir con el objetivo y debe facilitarse la información requerida | Audio, tiempo de respuesta, tu propia política y tus herramientas |
| Multi-IF | Meta | Seguir instrucciones de redacción verificables durante tres turnos, en ocho idiomas | Media de cuatro cifras de precisión, por instrucción y por conversación, con criterio estricto y flexible | Herramientas, guiones largos, expresión oral |
| GPQA Diamond | Investigadores de NYU, Cohere y Anthropic | Responder 198 preguntas científicas de opción múltiple redactadas por expertos | Porcentaje de preguntas respondidas correctamente, con un 25 % como azar | Conversación, herramientas, instrucciones, velocidad |
| Retell vCX Benchmark | Retell AI | Gestionar turnos en llamadas de centro de contacto en cuatro conjuntos de pruebas | Tasa de aciertos por conjunto, promediada en una única puntuación | Audio, tus propios tipos de llamada, resultados en una llamada completa |
¿Qué mide τ²-bench en sus dominios de aerolínea y comercio minorista?
τ²-bench mide si un agente puede completar una tarea de atención al cliente mediante una conversación, siguiendo una política escrita y llamando a las herramientas adecuadas. Un modelo de lenguaje hace de cliente, y el agente trabaja sobre una base de datos simulada de pedidos o reservas. El artículo original de τ-bench creó los dos dominios con 115 tareas de comercio minorista y 50 de aerolínea. El artículo de τ²-bench reutiliza versiones verificadas de ambos y añade un dominio de telecomunicaciones.
La puntuación es estricta. Según las notas de evaluación del repositorio, la recompensa de cada tarea es el producto de sus comprobaciones. Por defecto, son una comprobación de la base de datos, que compara la base de datos final con el estado objetivo, y una comprobación de comunicación, que confirma que el agente dio al cliente la información requerida. Cualquier secuencia de llamadas a herramientas que alcance el estado final correcto se da por superada.
Hay dos cifras que importan. Pass^1 es el porcentaje de tareas resueltas en un único intento. Pass^k es el porcentaje resuelto en los k intentos repetidos, una métrica que el artículo original introdujo para medir la consistencia. Ese artículo de 2024 indicó que incluso los principales agentes con llamadas a funciones de la época acertaban en menos de la mitad de las tareas, con un pass^8 inferior al 25 % en comercio minorista.
Lo que no le dice a quien compra voz: las puntuaciones de texto de aerolínea y comercio minorista proceden de conversaciones escritas, sin audio, sin interrupciones y sin límite de tiempo. Las políticas y herramientas son las del propio benchmark. El cliente simulado también es un modelo, y los autores de τ²-bench midieron tasas de error del simulador del 40 % en comercio minorista y del 47 % en aerolínea, con un 12 % y un 13 % lo bastante graves como para bloquear la tarea. El mismo repositorio incluye ahora benchmarks de voz independientes, y su versión 2.0 añade seis idiomas e indica que sus puntuaciones no son comparables con la clasificación 1.x. Comprueba de qué versión procede una puntuación citada.
¿Qué mide Multi-IF?
Multi-IF mide si un modelo sigue cumpliendo las instrucciones a medida que avanza una conversación, y si eso se mantiene fuera del inglés. El artículo de Multi-IF, de Meta, amplía una prueba anterior de un solo turno, IFEval, a 4.501 conversaciones de tres turnos cada una en ocho idiomas: inglés, francés, ruso, hindi, italiano, portugués, español y chino.
Las instrucciones están redactadas para poder verificarse, como la prohibición de usar comas o la norma de responder en mayúsculas. La puntuación principal promedia cuatro cifras de precisión. La precisión por instrucción cuenta cada instrucción por separado. La precisión por conversación solo cuenta una conversación si se han cumplido todas las instrucciones hasta ese turno. Cada una se indica con un criterio estricto y otro flexible.
La principal conclusión del artículo es la razón por la que este benchmark importa para los agentes telefónicos: los 14 modelos evaluados fallaron más con cada turno añadido. Un modelo bajó de 0,877 en el primer turno a 0,707 en el tercero. Un agente que cumple una norma al inicio de una llamada y la abandona unos intercambios después falla de la misma manera.
Lo que no le dice a quien compra voz: las instrucciones son restricciones de formato y redacción sobre texto, como la longitud, la puntuación y las palabras clave. No son reglas de negocio. No hay herramientas, tres turnos son pocos comparados con una llamada real y nada se dice en voz alta.
¿Qué mide GPQA Diamond?
GPQA Diamond mide si un modelo puede responder preguntas científicas muy difíciles que una búsqueda web no resuelve. El artículo de GPQA describe 448 preguntas de opción múltiple de biología, física y química, redactadas y validadas por personas con un doctorado o que lo están cursando. Diamond es el subconjunto de 198 preguntas en el que ambos validadores expertos acertaron y la mayoría de los no expertos no.
La puntuación es simplemente la precisión. Cada pregunta tiene cuatro opciones, así que responder al azar da un 25 %. En el conjunto completo, los expertos alcanzaron un 65 % y los no expertos cualificados con acceso ilimitado a la web, un 34 %.
Lo que no le dice a quien compra voz: casi nada sobre una llamada. No hay conversación, ni instrucciones que seguir, ni herramientas, ni límite de tiempo. Es un indicador indirecto de la profundidad de razonamiento. Con 198 preguntas, las pequeñas diferencias entre modelos son además una prueba débil, y los autores señalan el reducido tamaño del conjunto de datos como una limitación.
¿Qué mide el Retell vCX Benchmark?
El Retell vCX Benchmark mide cómo gestionan los modelos los turnos de llamadas de centro de contacto en cuatro conjuntos de pruebas. La clasificación en directo, consultada el 13 de noviembre de 2026, los describe así:
- Seguimiento de instrucciones: si el modelo respeta las restricciones de rol, las reglas de negocio y las reglas de rechazo.
- Grounding: si las respuestas se ciñen al prompt, a las herramientas y al contexto recuperado.
- Llamadas a herramientas: si el modelo elige la acción correcta y pasa argumentos válidos.
- Coloquial: si las respuestas suenan naturales, concisas y seguras para decirse en voz alta.
Cada conjunto indica una tasa de aciertos sobre aproximadamente 1.000 casos o más, y la puntuación global es la media de los cuatro. En esa fecha, la clasificación incluía 62 entradas de 45 modelos y muestra la latencia mediana y el coste por minuto junto a cada puntuación.
La nota metodológica publicada es el artículo sobre vCX-Hard, que cubre los dos primeros conjuntos de pruebas: grounding y llamadas a herramientas. Los casos se extrajeron de llamadas en producción, muestreadas entre organizaciones para que ningún cliente concreto predomine. Un panel de modelos jueces puntúa cada caso según una rúbrica y una solución de referencia. Ese artículo considera que la señal es la clasificación, más que la cifra exacta.
Lo que no le dice a quien compra voz: es un benchmark de un proveedor, y el proveedor participa en él. Tell-1, el modelo propio de Retell, ocupa el puesto n.º 1 en la clasificación general del Retell vCX Benchmark (a noviembre de 2026). Los casos proceden del tráfico de Retell, así que tus tipos de llamada pueden estar poco representados o ausentes. Los cuatro conjuntos puntúan respuestas y llamadas a herramientas, así que los errores de reconocimiento de voz, las interrupciones y si una llamada completa termina resuelta quedan fuera. Los modelos jueces también pueden equivocarse.
¿Qué puntuación obtiene Tell-1 en estos cuatro benchmarks?
Tell-1, el LLM propio de Retell, es un ejemplo práctico de cómo leer los cuatro en conjunto. Retell publica las puntuaciones de benchmarks públicos que aparecen abajo en su artículo técnico sobre Retell LLM, y las cifras de vCX proceden de la clasificación en directo, consultada el 13 de noviembre de 2026.
| Benchmark | Puntuación de Tell-1 | Tamaño de la ejecución | Quién la ejecutó |
|---|---|---|---|
| τ²-bench aerolínea | 72,0 | 50 tareas | Retell |
| τ²-bench comercio minorista | 78,0 | 50 tareas | Retell |
| Multi-IF | 82,1 | 504 conversaciones | Retell |
| GPQA Diamond | 83,5 | 198 preguntas × 3 | Retell |
| Retell vCX Benchmark | 94,45 de media, n.º 1 general de 62 configuraciones de modelos | Cuatro conjuntos, unos 1.000 casos cada uno | Retell |
Léelos como sugieren las secciones anteriores. Cada fila es una ejecución propia de Retell, puntuada sobre 100 con la misma decodificación voraz en cada caso, y Retell afirma que ninguno de los benchmarks se usó en el entrenamiento. La ejecución de Multi-IF cubre 504 de las 4.501 conversaciones del benchmark y las de τ²-bench cubren 50 tareas por dominio, así que no son directamente comparables con las cifras de los artículos originales ni de otras clasificaciones.
En vCX, las puntuaciones por conjunto varían: 96,6 % en coloquial (puesto 1), 97,2 % en grounding (puesto 2), 88,6 % en seguimiento de instrucciones (puesto 2) y 95,4 % en llamadas a herramientas (puesto 5). Otros modelos lideran tres de los cuatro conjuntos. Aquí se aplica la misma cautela que con cualquier modelo: estas cifras le valen a Tell-1 un lugar en una lista de candidatos, y una prueba con tus propias llamadas decide el resto.
¿Qué dejan fuera las puntuaciones de los benchmarks para quien compra un agente de voz con IA?
Las puntuaciones de los benchmarks dejan fuera la plataforma que rodea al modelo y las condiciones de tus propias llamadas. Una llamada telefónica añade reconocimiento de voz, gestión de turnos, síntesis de voz, telefonía y latencia en cada fase. Ninguno de los cuatro benchmarks, en la forma descrita aquí, puntúa esos aspectos.
Los resultados pueden variar según la plataforma aunque el agente sea idéntico. En un estudio del proveedor de pruebas Cekura, se desplegó un mismo agente sin cambios en seis plataformas de voz y las puntuaciones de flujo de trabajo oscilaron entre el 65,2 % y el 95,7 %. El resumen de Retell sobre ese estudio de Medicare explica el método y la advertencia que le corresponde.
¿Cómo debería usar un comprador las puntuaciones de los benchmarks?
Usa las puntuaciones de los benchmarks para elaborar una lista de candidatos y decide después con tus propias llamadas. Un orden sensato:
- Relaciona el benchmark con el riesgo: resultados de uso de herramientas si una acción equivocada es el fallo más costoso, seguimiento de instrucciones si el agente debe mantener un guion largo.
- Comprueba la versión, la fecha y quién ejecutó la prueba.
- Da preferencia a las cifras de intentos repetidos, como pass^k, cuando se indiquen.
- Reconstruye la prueba con tus propios escenarios y considera superado un escenario solo cuando todas las ejecuciones repetidas lo superen.
En Retell, las pruebas de simulación permiten que una IA haga de llamante mientras unos criterios de éxito califican cada ejecución como superada o fallida, y las pruebas por lotes vuelven a ejecutar los casos guardados tras cada cambio en el prompt. Tras el lanzamiento, AI QA puntúa una muestra de llamadas reales en criterios como las alucinaciones y el uso de herramientas, y las pruebas A/B reparten el tráfico real entre dos agentes. Para elegir modelo, consulta qué LLM debería impulsar tu agente de voz con IA. Para el proceso de compra, consulta cómo evaluar una plataforma de agentes de voz con IA.
Un benchmark te dice qué modelos merecen una prueba. Un piloto con llamadas reales te dice cuál poner en marcha. Retell es una plataforma de agentes de voz con IA para centros de contacto, con precios desde 0,07 $ por minuto, así que puedes probarla con tus propias llamadas antes de firmar nada.
Preguntas frecuentes
¿Cuál es la diferencia entre pass^1 y pass^k?
Pass^1 es el porcentaje de tareas que un agente resuelve en un único intento. Pass^k es el porcentaje que resuelve en cada uno de k intentos repetidos de la misma tarea. Pass^k siempre es igual o inferior a pass^1, y la diferencia muestra lo consistente que es el agente.
¿Es τ-bench lo mismo que τ²-bench?
No. τ-bench es el benchmark original de 2024 con dominios de aerolínea y comercio minorista. τ²-bench es su continuación de 2025, del mismo grupo, que mantiene versiones verificadas de esos dos dominios y añade un dominio de telecomunicaciones en el que el cliente simulado también usa herramientas.
¿Por qué se usa una prueba científica como GPQA Diamond para comparar modelos para conversaciones con clientes?
GPQA Diamond se usa como medida general de la capacidad de razonamiento. No dice nada directo sobre conversaciones, herramientas o voz. Tómalo como una comprobación de la profundidad de razonamiento y apóyate en benchmarks de tareas para lo demás.
¿Qué benchmark importa más para un agente de voz con IA?
Ninguno por sí solo. El uso de herramientas bajo una política, el seguimiento de instrucciones a lo largo de varios turnos y el grounding son lo que más se parece al trabajo de un centro de contacto, así que τ²-bench, Multi-IF y el vCX Benchmark son los que mejor encajan. Una prueba evaluada con tus propios escenarios de llamada importa más que cualquiera de ellos.
¿Qué puntuación obtuvo Tell-1 en τ²-bench, Multi-IF y GPQA Diamond?
Retell publica para Tell-1 un 72,0 en τ²-bench aerolínea, un 78,0 en τ²-bench comercio minorista, un 82,1 en Multi-IF y un 83,5 en GPQA Diamond, todos sobre 100. Son ejecuciones propias de Retell con 50 tareas por dominio de τ²-bench, 504 conversaciones de Multi-IF y las 198 preguntas de GPQA Diamond.
Descubre cuánto podría ahorrar tu empresa al pasar a agentes de voz impulsados por IA.
Resultado del ROI
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Estimate your monthly voice AI cost
Read Other Blogs


Revoluciona tu operación de llamadas con Retell


