Claude Fable 5.2 voor AI-stemagents: waar het past en waar niet




Claude Fable 5.2 is een sterk model voor het bouwen, testen en beoordelen van AI-stemagents, maar een slechte standaardkeuze om de beller te woord te staan. Anthropic bracht het op 9 november 2026 uit voor wat het bedrijf het meest ambitieuze, open technische werk noemt, en raadt aan om voor de meeste programmeer- en kennistaken te beginnen met Claude Opus 5.5. Tijdens een telefoongesprek tikt bij elk antwoord de klok, dus het model dat spreekt kies je op snelheid en kosten per minuut. Juist bij het werk waarbij geen beller zit te wachten, verdient Fable 5.2 zichzelf terug.
Retell AI publiceert deze gids en biedt Claude-modellen aan op het eigen platform voor AI-stemagents, al hoort Fable 5.2 daar niet bij.
Claude Fable 5.2 in één oogopslag
| Claude Fable 5.2 | |
|---|---|
| Ontwikkelaar | Anthropic |
| Uitgebracht | 9 november 2026 |
| Model-ID | claude-fable-5-2 |
| Positionering | Gebouwd voor het meest ambitieuze, open technische werk. Anthropic raadt aan om voor de meeste programmeer- en kennistaken te beginnen met Claude Opus 5.5. |
| API-prijs | $8 per miljoen input-tokens en $40 per miljoen output-tokens |
| Snelheid | Genereert output tot 30% sneller dan Claude Fable 5.1. Een optionele snelle modus versnelt de tokengeneratie tot 2,5 keer, tegen $16 per miljoen input-tokens en $80 per miljoen output-tokens. |
| Beschikbaarheid | Alle platforms, waaronder Amazon Web Services, Google Cloud en Microsoft Azure |
| Claude Mythos 5.2 | Hetzelfde onderliggende model zonder bepaalde beveiligingsmaatregelen op het gebied van cybersecurity en biologie, beschikbaar voor gescreende organisaties |
| Op Retell AI | Niet in de modellijst van Retell per 10 november 2026 |
Bron: de lanceringspost van Anthropic voor Claude Fable 5.2 en Claude Mythos 5.2, geraadpleegd op 10 november 2026. Beschikbaarheid bij Retell volgens de API-referentie en de prijspagina van Retell, op dezelfde dag geraadpleegd.
Waarom Fable 5.2 niet het model in het gesprek is
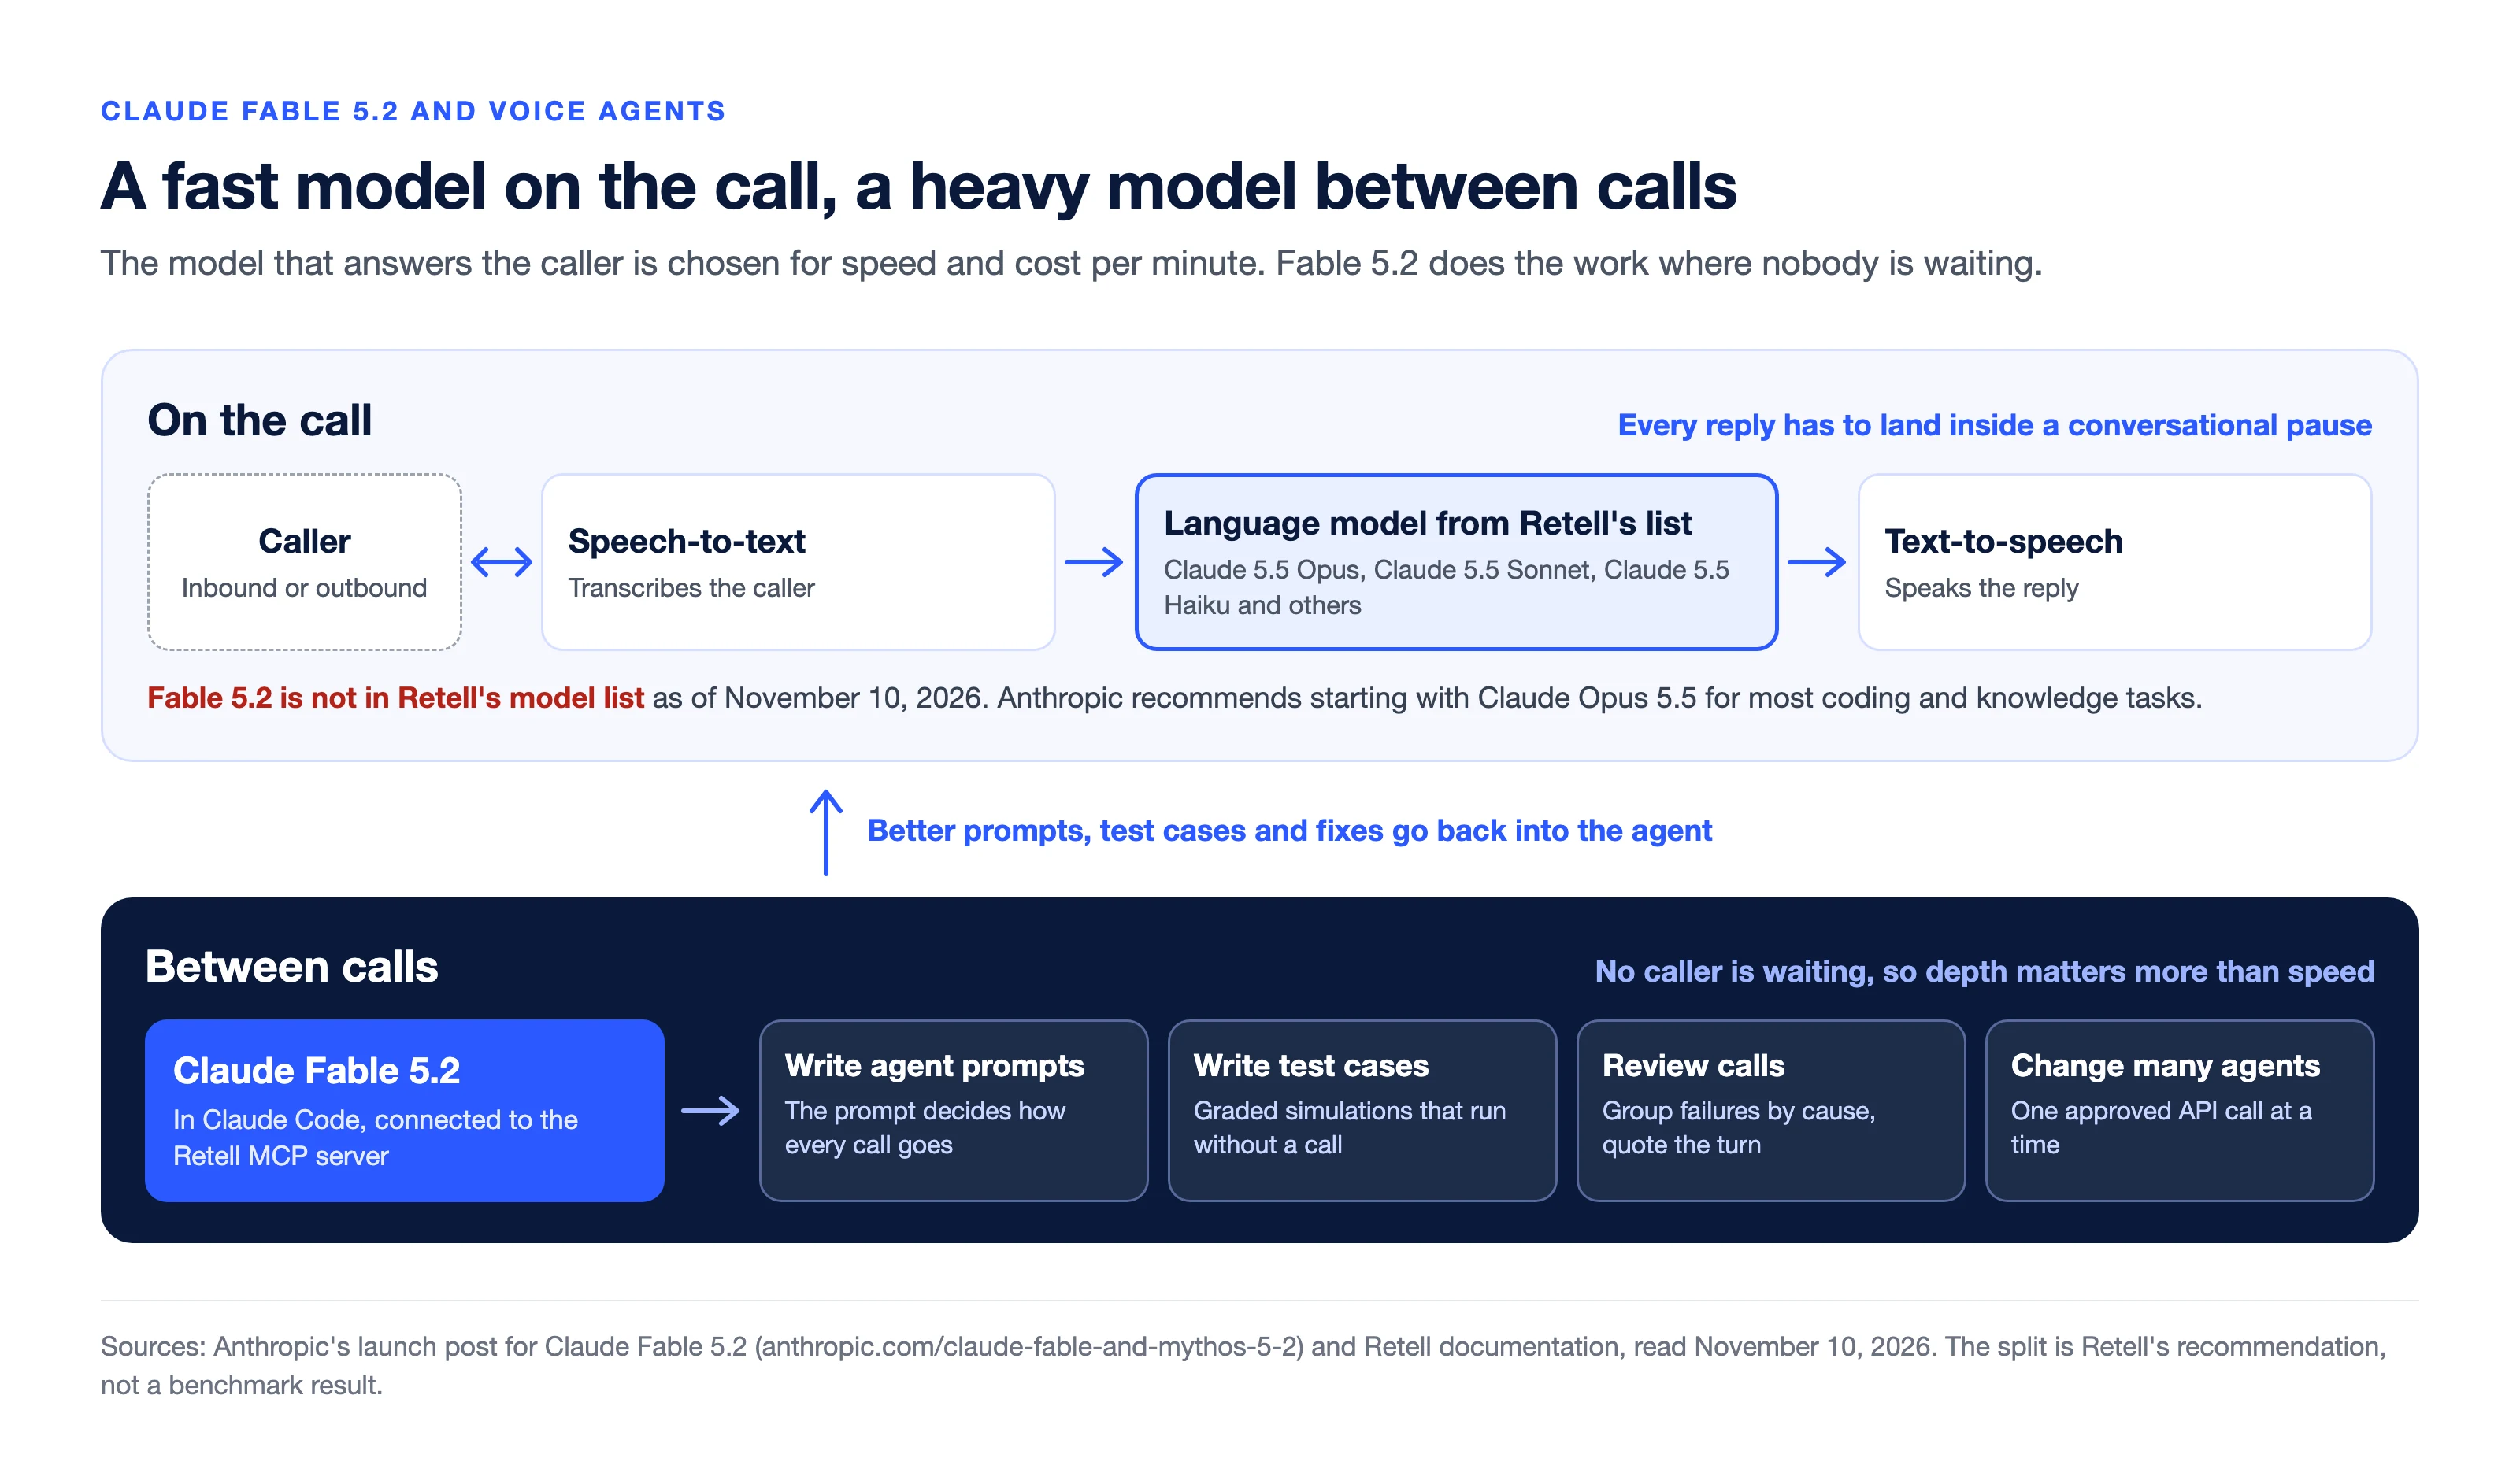
Een AI-stemagent moet antwoorden binnen een natuurlijke gesprekspauze. Bij een cascade-agent gaat elke beurt door speech-to-text, een taalmodel en text-to-speech, en de tijd die het taalmodel nodig heeft tot de eerste uitspreekbare woorden is een van de vertragingen die de beller hoort. Van een model dat gepositioneerd is voor lang, open werk is niet aangetoond dat het binnen die tijd past.
Drie punten uit de lanceringspost van Anthropic bepalen onze kijk:
- De aanbeveling. "Voor de meeste programmeer- en kennistaken raden we gebruikers aan te beginnen met Claude Opus 5.5, ons sterkste model voor dagelijks gebruik."
- De prijs. Fable 5.2 kost $8 per miljoen input-tokens en $40 per miljoen output-tokens, wat Anthropic presenteert als een lagere prijs dan voorheen. Wij lezen het zo: het past nog altijd beter bij werk waarvoor het antwoord het wachten en betalen waard is dan bij een telefoongesprek dat per minuut wordt afgerekend.
- De stilte over stem. De post gaat niet in op AI-stemagents, realtime gesprekken of klantenservice. Hij rapporteert resultaten op het gebied van programmeren, wetenschap, computergebruik en zakelijke workflows.
De post zegt wel dat Fable 5.2 output tot 30% sneller genereert dan Fable 5.1 en een snelle modus biedt. Er wordt geen cijfer gegeven voor de tijd tot het eerste antwoord in een gespreksbeurt, en Retell heeft dat zelf niet gemeten. We zouden niet beweren dat het te traag is voor een gesprek. Maar bewijs dat het er de juiste keuze voor is, is niet gepubliceerd.
Er is ook een praktisch antwoord. De modellijst van Retell voor AI-stemagents bevat Claude 5.5 Opus, Claude 5.5 Sonnet en Claude 5.5 Haiku. Fable 5.2 staat er niet in.
Waar Fable 5.2 je voice-team helpt
Het meeste werk dat een AI-stemagent goed maakt, gebeurt als er niemand aan de lijn is. Een model dat een lange, rommelige taak kan vasthouden en afronden, is daar nuttig.
| Taak | Rol van Fable 5.2 | Hoe het Retell bereikt |
|---|---|---|
| De beller beantwoorden, beurt voor beurt | Nu nog niet. Gebruik een model uit de lijst van Retell | Gekozen in de modelselector van de agent |
| Agentprompts schrijven en herschrijven | Goede match. De prompt bepaalt hoe elk gesprek verloopt | Claude Code via de Retell MCP-server |
| Een regressiesuite schrijven | Goede match. Het kan foutpatronen omzetten in beoordeelde testcases | Maakt simulatietestcases aan via de API |
| Gesprekken op grote schaal beoordelen | Goede match. Het kan fouten groeperen op oorzaak en de betreffende beurt citeren | Haalt gesprekken op en leest per gesprek het transcript, de latency en de analyse na het gesprek |
| Veel agents tegelijk aanpassen | Goede match. Lang werk in meerdere stappen binnen een workspace | Leest en werkt agents bij, telkens via één goedgekeurde aanroep |
| De beller spelen in een simulatie | Nu nog niet. De gesimuleerde beller draait op een model dat je in Retell kiest | Ingesteld op de testcase |
Anthropic beschrijft deze taakverdeling zelf. Volgens de lanceringspost kan Fable 5.2 de rol spelen van een Advisor, of van een Orchestrator die eenvoudigere taken delegeert aan kleinere modellen. Een voice-stack is dat patroon met een telefoon eraan: een snel model handelt elke beurt af, en een zwaarder model werkt tussen gesprekken door aan de prompts, de tests en de beoordeling.
Voor de praktische versie, zie hoe je een AI-stemagent bouwt met Claude Code en Claude Fable 5.2.
En als je Fable 5.2 toch in het gesprek wilt?
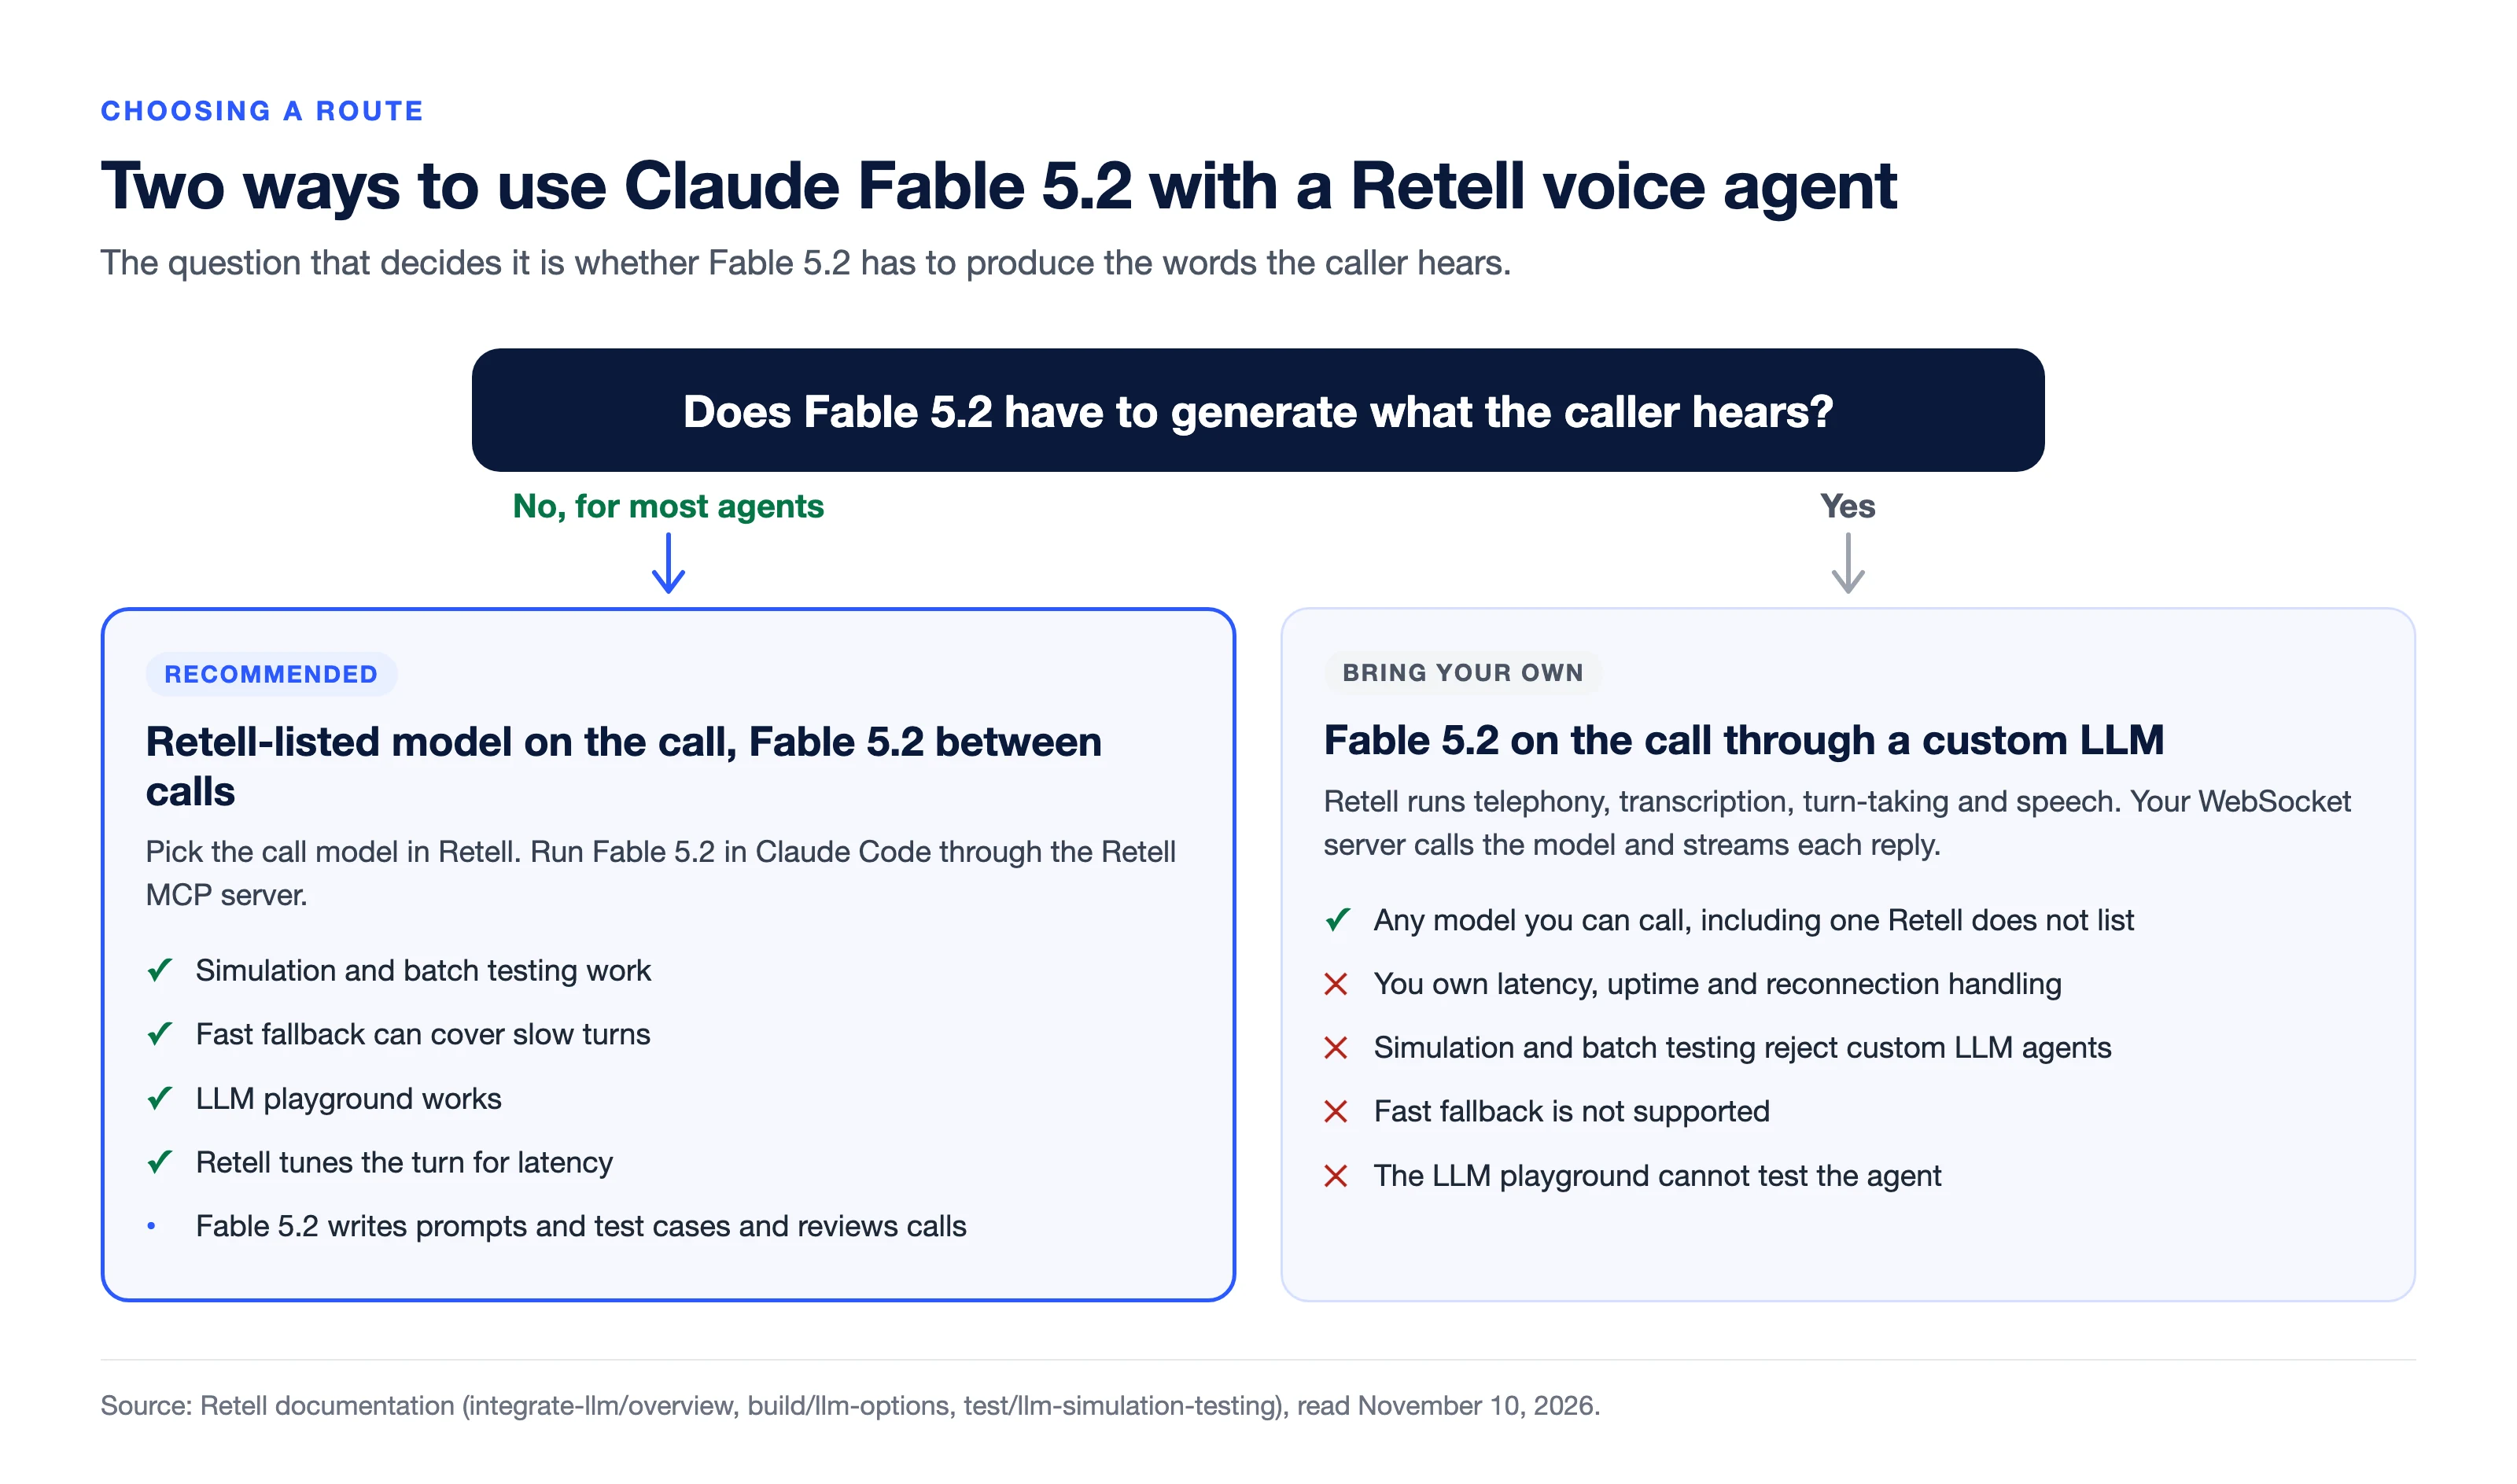
Dan kun je het zelf inbrengen. Met de custom LLM-optie van Retell draai je je eigen model achter een AI-stemagent: Retell regelt de telefonie, transcriptie, beurtwisseling en spraaksynthese, en opent per gesprek een WebSocket naar jouw server. Jouw server roept het model aan dat je kiest en streamt terug wat de agent moet zeggen.
Die route heeft nadelen die de documentatie van Retell expliciet benoemt. Jij bent verantwoordelijk voor latency, uptime en het afhandelen van herverbindingen. De LLM-playground kan geen custom LLM-agent testen, en simulatie- en batchtests weigeren ze, dus web- en telefoongesprekken zijn de enige manier om te testen. Fast fallback, dat een back-upmodel naast het primaire model draait zodat een traag antwoord het gesprek niet ophoudt, ondersteunt geen custom LLM-agents. Retell raadt voor de meeste agents single-prompt- of conversation flow-agents aan.
Zo kies je het model dat het gesprek beantwoordt
Kies het model voor het gesprek niet op basis van een lanceringspost, ook niet deze. Kies het op basis van je eigen gesprekken.
- Begin bij de modellijst van Retell. Daar zijn de functies voor testen, fallback en analytics van het platform omheen gebouwd.
- Meet de latency per gesprek. De Call History van Retell toont de end-to-end latency van elk gesprek, en de Get Call API geeft een uitsplitsing die ook de tijd bevat die het taalmodel nodig heeft tot het eerste uitspreekbare fragment.
- Draai dezelfde simulatiesuite op elke kandidaat. Een model dat sneller is maar faalt op je cases voor doorverbinding of openbaarmaking, is op geen enkele manier die ertoe doet sneller.
- Voeg een back-up toe voor trage beurten. Fast fallback start het primaire model en een back-upmodel tegelijk en laat de back-up het overnemen als het primaire model niet op tijd begint te antwoorden.
Onze bredere gids over het kiezen van een LLM voor AI-stemagents behandelt de afwegingen tussen modelfamilies. Voor het full-duplex stemmodel van OpenAI, zie hoe GPT-Live-1 werkt bij telefoongesprekken. Het eigen taalmodel van Retell, Tell-1, is nog een kandidaat voor die tests; op de Tell-1-pagina vind je de benchmarkscores.
Veelgestelde vragen
Kan ik Claude Fable 5.2 gebruiken voor een AI-stemagent?
Niet als model uit de lijst van Retell, per 10 november 2026. De modellijst van Retell bevat Claude 5.5 Opus, Claude 5.5 Sonnet en Claude 5.5 Haiku. Je kunt Fable 5.2 achter een Retell-agent draaien via de custom LLM-optie, waarbij je eigen server elk antwoord genereert, of het buiten het gesprek gebruiken om agents te bouwen en te beoordelen.
Is Claude Fable 5.2 snel genoeg voor live telefoongesprekken?
Anthropic heeft geen cijfer gepubliceerd dat daar antwoord op geeft. De lanceringspost zegt dat Fable 5.2 output tot 30% sneller genereert dan Fable 5.1 en een snelle modus heeft die de tokengeneratie tot 2,5 keer versnelt, maar noemt geen tijd tot het eerste antwoord voor gesprekken. Meet het in je eigen gesprekken voordat je erop vertrouwt.
Wat kost Claude Fable 5.2?
Anthropic rekent $8 per miljoen input-tokens en $40 per miljoen output-tokens. De snelle modus kost $16 per miljoen input-tokens en $80 per miljoen output-tokens.
Wat is het verschil tussen Claude Fable 5.2 en Claude Mythos 5.2?
Volgens Anthropic is het hetzelfde onderliggende model. Fable heeft beveiligingsmaatregelen voor cybersecurity en biologie, zodat het aan alle gebruikers kan worden aangeboden. Mythos 5.2 draait zonder een deel van die maatregelen en is alleen beschikbaar voor gescreende organisaties.
Welk Claude-model moet een AI-stemagent gebruiken?
Kies uit de Claude-modellen die je voice-platform aanbiedt en beslis op basis van gemeten latency en slagingspercentage, niet op basis van welk model het nieuwst is. Anthropic raadt zelf aan om voor de meeste programmeer- en kennistaken te beginnen met Claude Opus 5.5.
Waar is Claude Fable 5.2 goed voor in voice-AI?
Het werk tussen gesprekken door: agentprompts schrijven, testcases genereren, gesprekstranscripten op grote schaal beoordelen en wijzigingen doorvoeren in veel agents tegelijk. Claude Code kan dat allemaal doen in een Retell-workspace via de MCP-server van Retell.
Zet Fable 5.2 aan het werk tussen gesprekken door
Houd een snel model in het gesprek en geef het zware model het werk eromheen. Verbind Claude Code met de Retell MCP-server, laat het een testsuite schrijven voor een agent die je al in Retell draait, en ontdek wat het vindt in je eigen gesprekken.
See how much your business could save by switching to AI-powered voice agents.
ROI Result
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Estimate your monthly voice AI cost
Read Other Blogs



Revolutioneer je belactiviteiten met Retell


