Claude Fable 5.2 för röstagenter: där den passar och där den inte gör det




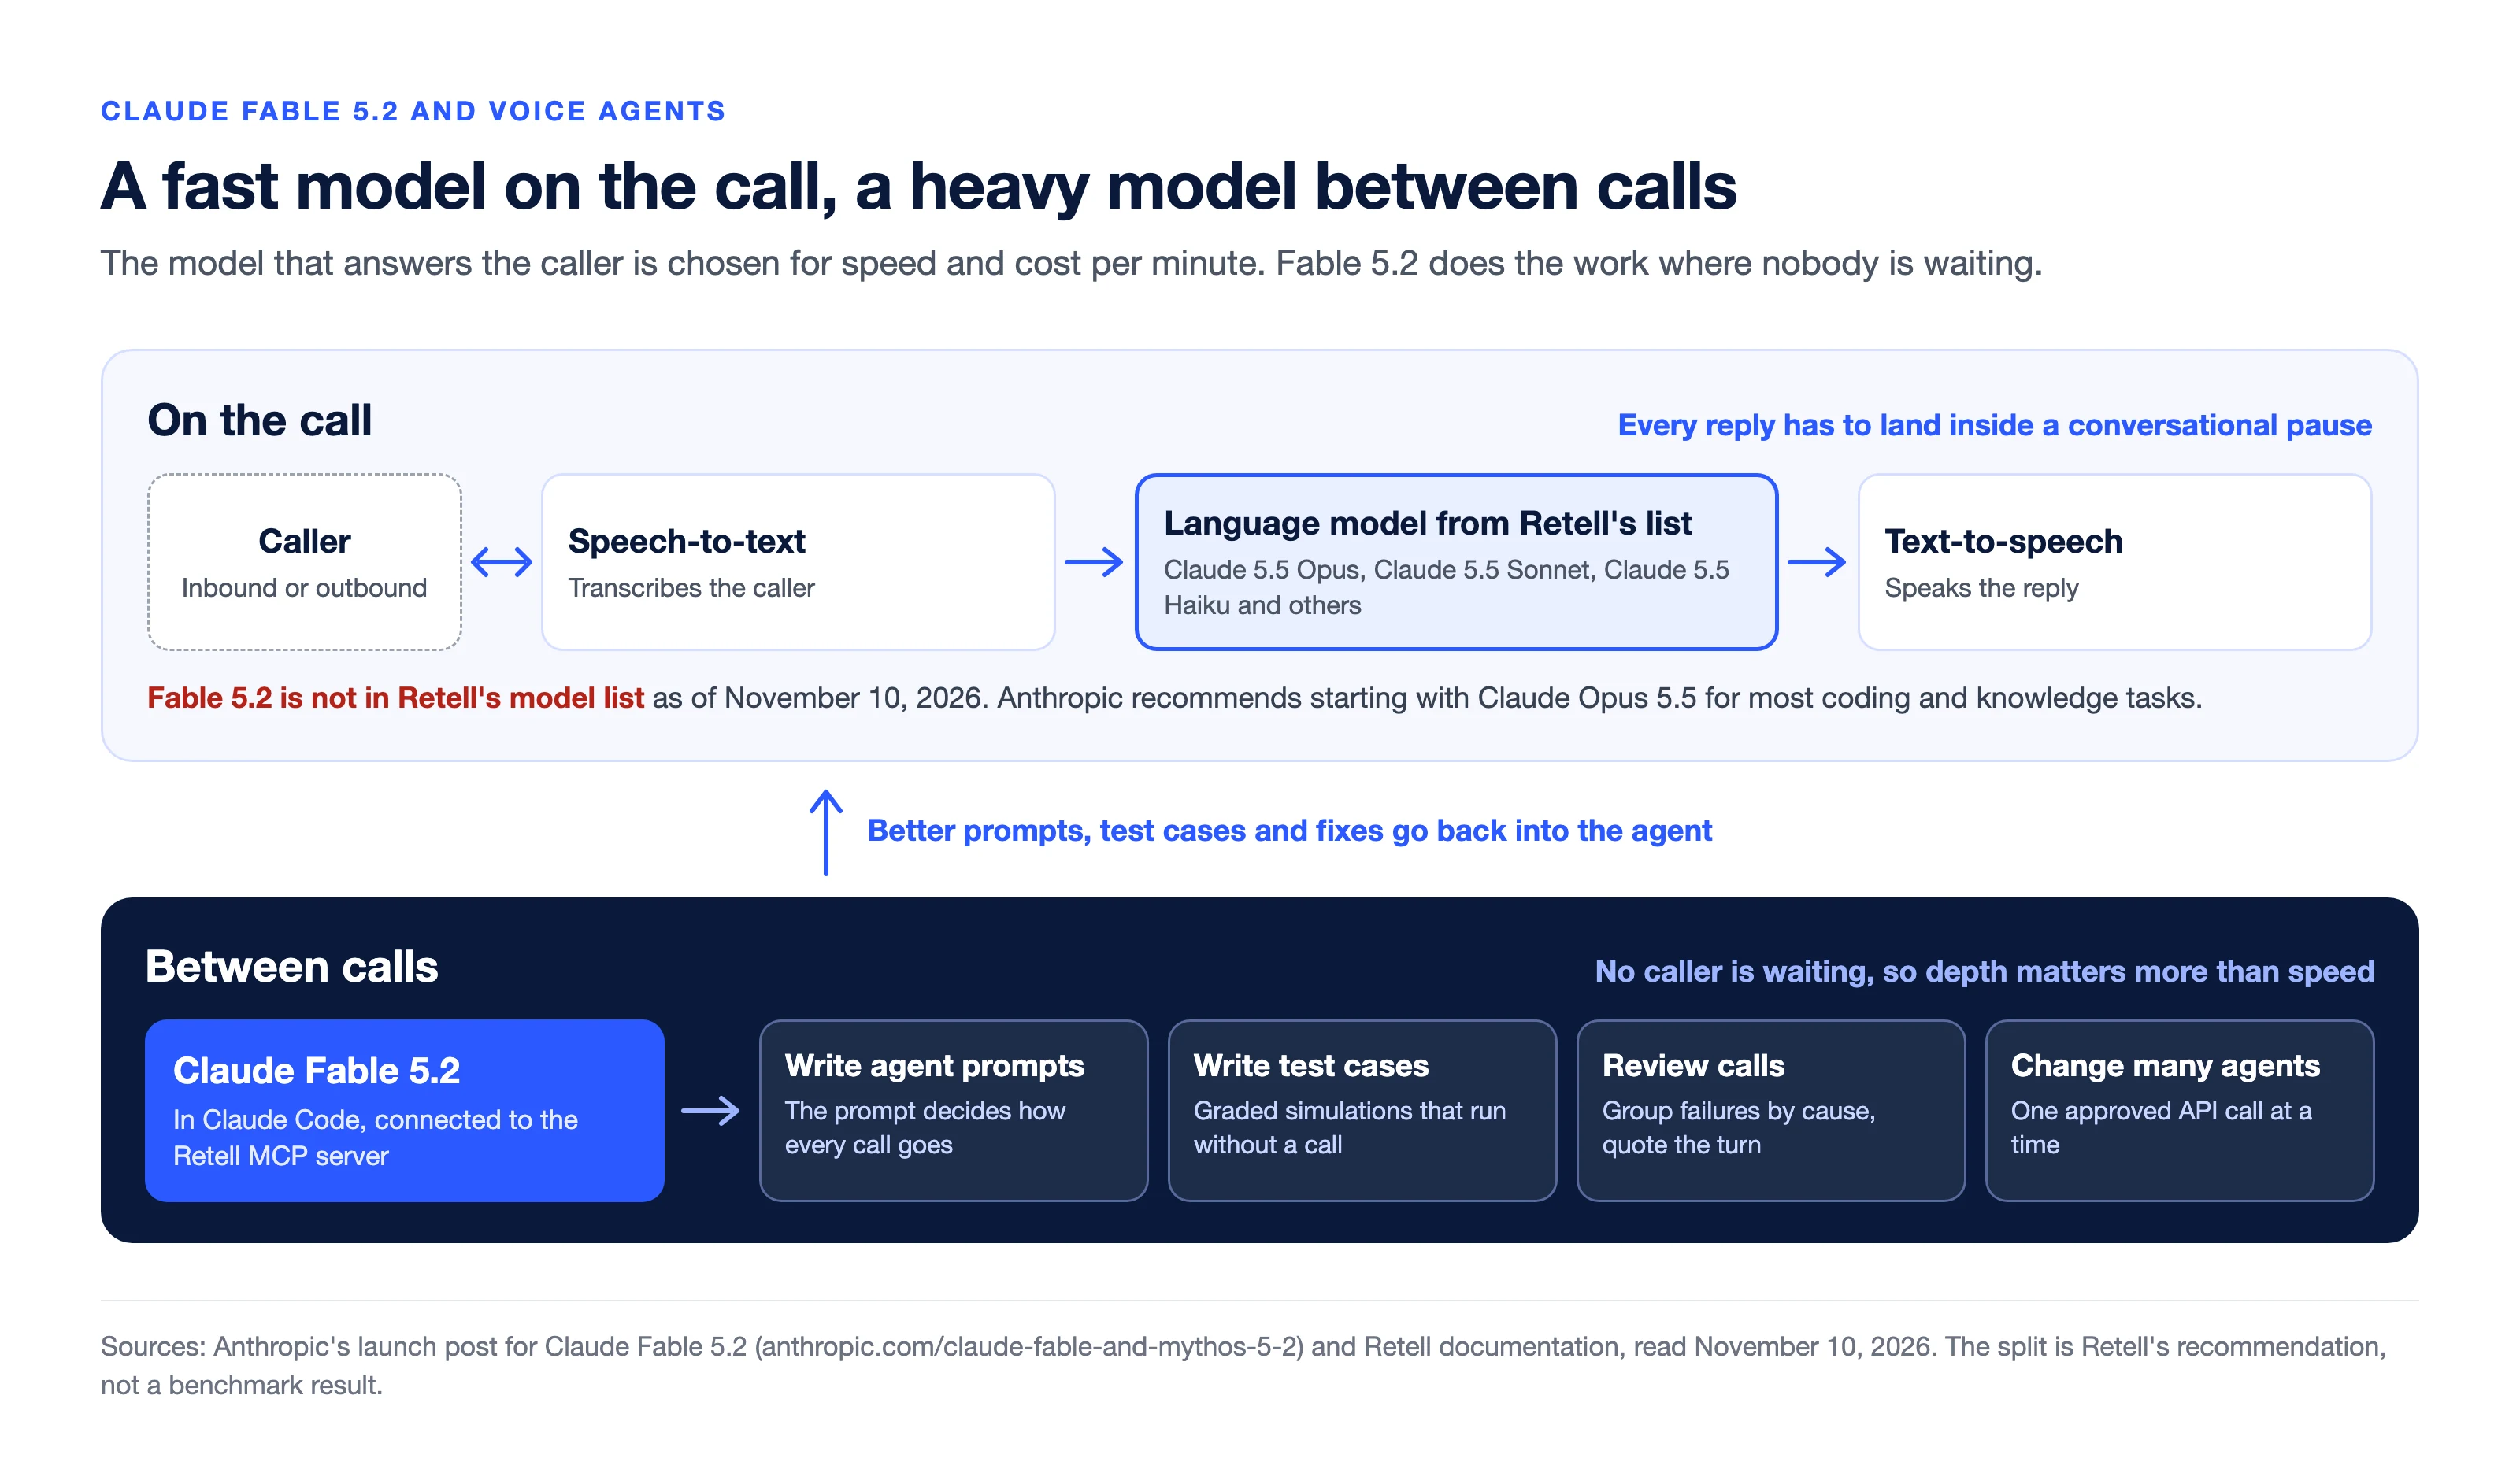
Claude Fable 5.2 är en stark modell för att bygga, testa och granska röstagenter, men ett dåligt standardval för att svara den som ringer. Anthropic släppte den den 9 november 2026 för det som företaget kallar det mest ambitiösa, öppna tekniska arbetet, och rekommenderar att man börjar med Claude Opus 5.5 för de flesta kodnings- och kunskapsuppgifter. I ett telefonsamtal är varje svar tidskritiskt, så modellen som talar bör väljas utifrån hastighet och kostnad per minut. Det är i arbetet där ingen uppringare väntar som Fable 5.2 betalar sig.
Retell AI publicerar den här guiden och erbjuder Claude-modeller, dock inte Fable 5.2, på sin plattform för röstagenter.
Claude Fable 5.2 i korthet
| Claude Fable 5.2 | |
|---|---|
| Utvecklare | Anthropic |
| Lansering | 9 november 2026 |
| Modell-ID | claude-fable-5-2 |
| Positionering | Byggd för det mest ambitiösa, öppna tekniska arbetet. Anthropic rekommenderar att man börjar med Claude Opus 5.5 för de flesta kodnings- och kunskapsuppgifter. |
| API-pris | $8 per miljon indata-tokens och $40 per miljon utdata-tokens |
| Hastighet | Genererar utdata upp till 30 % snabbare än Claude Fable 5.1. Ett valfritt snabbläge gör tokengenereringen upp till 2,5 gånger snabbare, till $16 per miljon indata-tokens och $80 per miljon utdata-tokens. |
| Tillgänglighet | Alla plattformar, inklusive Amazon Web Services, Google Cloud och Microsoft Azure |
| Claude Mythos 5.2 | Samma underliggande modell utan vissa skyddsåtgärder för cybersäkerhet och biologi, tillgänglig för granskade organisationer |
| I Retell AI | Finns inte i modellistan hos Retell per den 10 november 2026 |
Källa: Anthropics lanseringsinlägg för Claude Fable 5.2 och Claude Mythos 5.2, läst 10 november 2026. Tillgänglighet i Retell enligt API-referensen och prissidan från Retell, lästa samma dag.
Varför Fable 5.2 inte är modellen i samtalet
En röstagent måste svara inom en naturlig paus i samtalet. I en kaskadagent går varje tur genom tal-till-text, en språkmodell och text-till-tal, och språkmodellens tid till de första talbara orden är en av fördröjningarna som den som ringer hör. En modell som är positionerad för långt, öppet arbete har inte visats passa den tidsramen.
Tre saker från Anthropics lanseringsinlägg ligger till grund för vår bedömning:
- Rekommendationen. ”För de flesta kodnings- och kunskapsuppgifter rekommenderar vi att användare börjar med Claude Opus 5.5, vår starkaste modell för vardagsbruk.”
- Priset. Fable 5.2 kostar $8 per miljon indata-tokens och $40 per miljon utdata-tokens, vilket Anthropic presenterar som ett lägre pris än tidigare. Vår tolkning är att den ändå passar bättre för arbete där svaret är värt att vänta och betala för än för ett telefonsamtal som debiteras per minut.
- Tystnaden om röst. Inlägget tar inte upp röstagenter, realtidskonversation eller kundtjänst. Det redovisar resultat inom kodning, vetenskap, datoranvändning och affärsarbetsflöden.
Inlägget säger visserligen att Fable 5.2 genererar utdata upp till 30 % snabbare än Fable 5.1 och erbjuder ett snabbläge. Det anger ingen siffra för tid till första svar i en konversationstur, och Retell har inte mätt någon. Vi skulle inte påstå att den är för långsam för ett samtal. Men belägg för att den är rätt val för ett samtal har inte publicerats.
Det finns också ett praktiskt svar. Modellistan för röstagenter i Retell omfattar Claude 5.5 Opus, Claude 5.5 Sonnet och Claude 5.5 Haiku. Fable 5.2 ingår inte.
Där Fable 5.2 hjälper ett röstteam
Det mesta av arbetet som gör en röstagent bra sker när ingen är på linjen. Där är en modell som klarar en lång, rörig uppgift och slutför den användbar.
| Uppgift | Fable 5.2:s roll | Hur den når Retell |
|---|---|---|
| Svara den som ringer, tur för tur | Inte i dag. Använd en modell från listan i Retell | Väljs i agentens modellväljare |
| Skriva och skriva om agentprompter | Passar bra. Prompten avgör hur varje samtal går | Claude Code via Retell MCP-servern |
| Skriva en regressionssvit | Passar bra. Den kan omvandla felmönster till bedömda testfall | Skapar simuleringstestfall via API:et |
| Granska samtal i stor volym | Passar bra. Den kan gruppera fel efter orsak och citera turen | Listar samtal och läser varje samtals transkript, latens och analys efter samtal |
| Ändra många agenter samtidigt | Passar bra. Långt arbete i flera steg över en hel arbetsyta | Läser och uppdaterar agenter, ett godkänt anrop i taget |
| Spela den som ringer i en simulering | Inte i dag. Den simulerade uppringaren körs på en modell du väljer i Retell | Ställs in i testfallet |
Anthropic beskriver själv den här arbetsfördelningen. Lanseringsinlägget säger att Fable 5.2 kan ta rollen som Advisor, eller som Orchestrator som delegerar enklare uppgifter till mindre modeller. En röststack är samma mönster med en telefon kopplad till: en snabb modell hanterar varje tur, och en tyngre modell arbetar med prompterna, testerna och granskningen mellan samtalen.
För en praktisk genomgång, se hur du bygger en röstagent med Claude Code och Claude Fable 5.2.
Vad gör du om du ändå vill ha Fable 5.2 i samtalet?
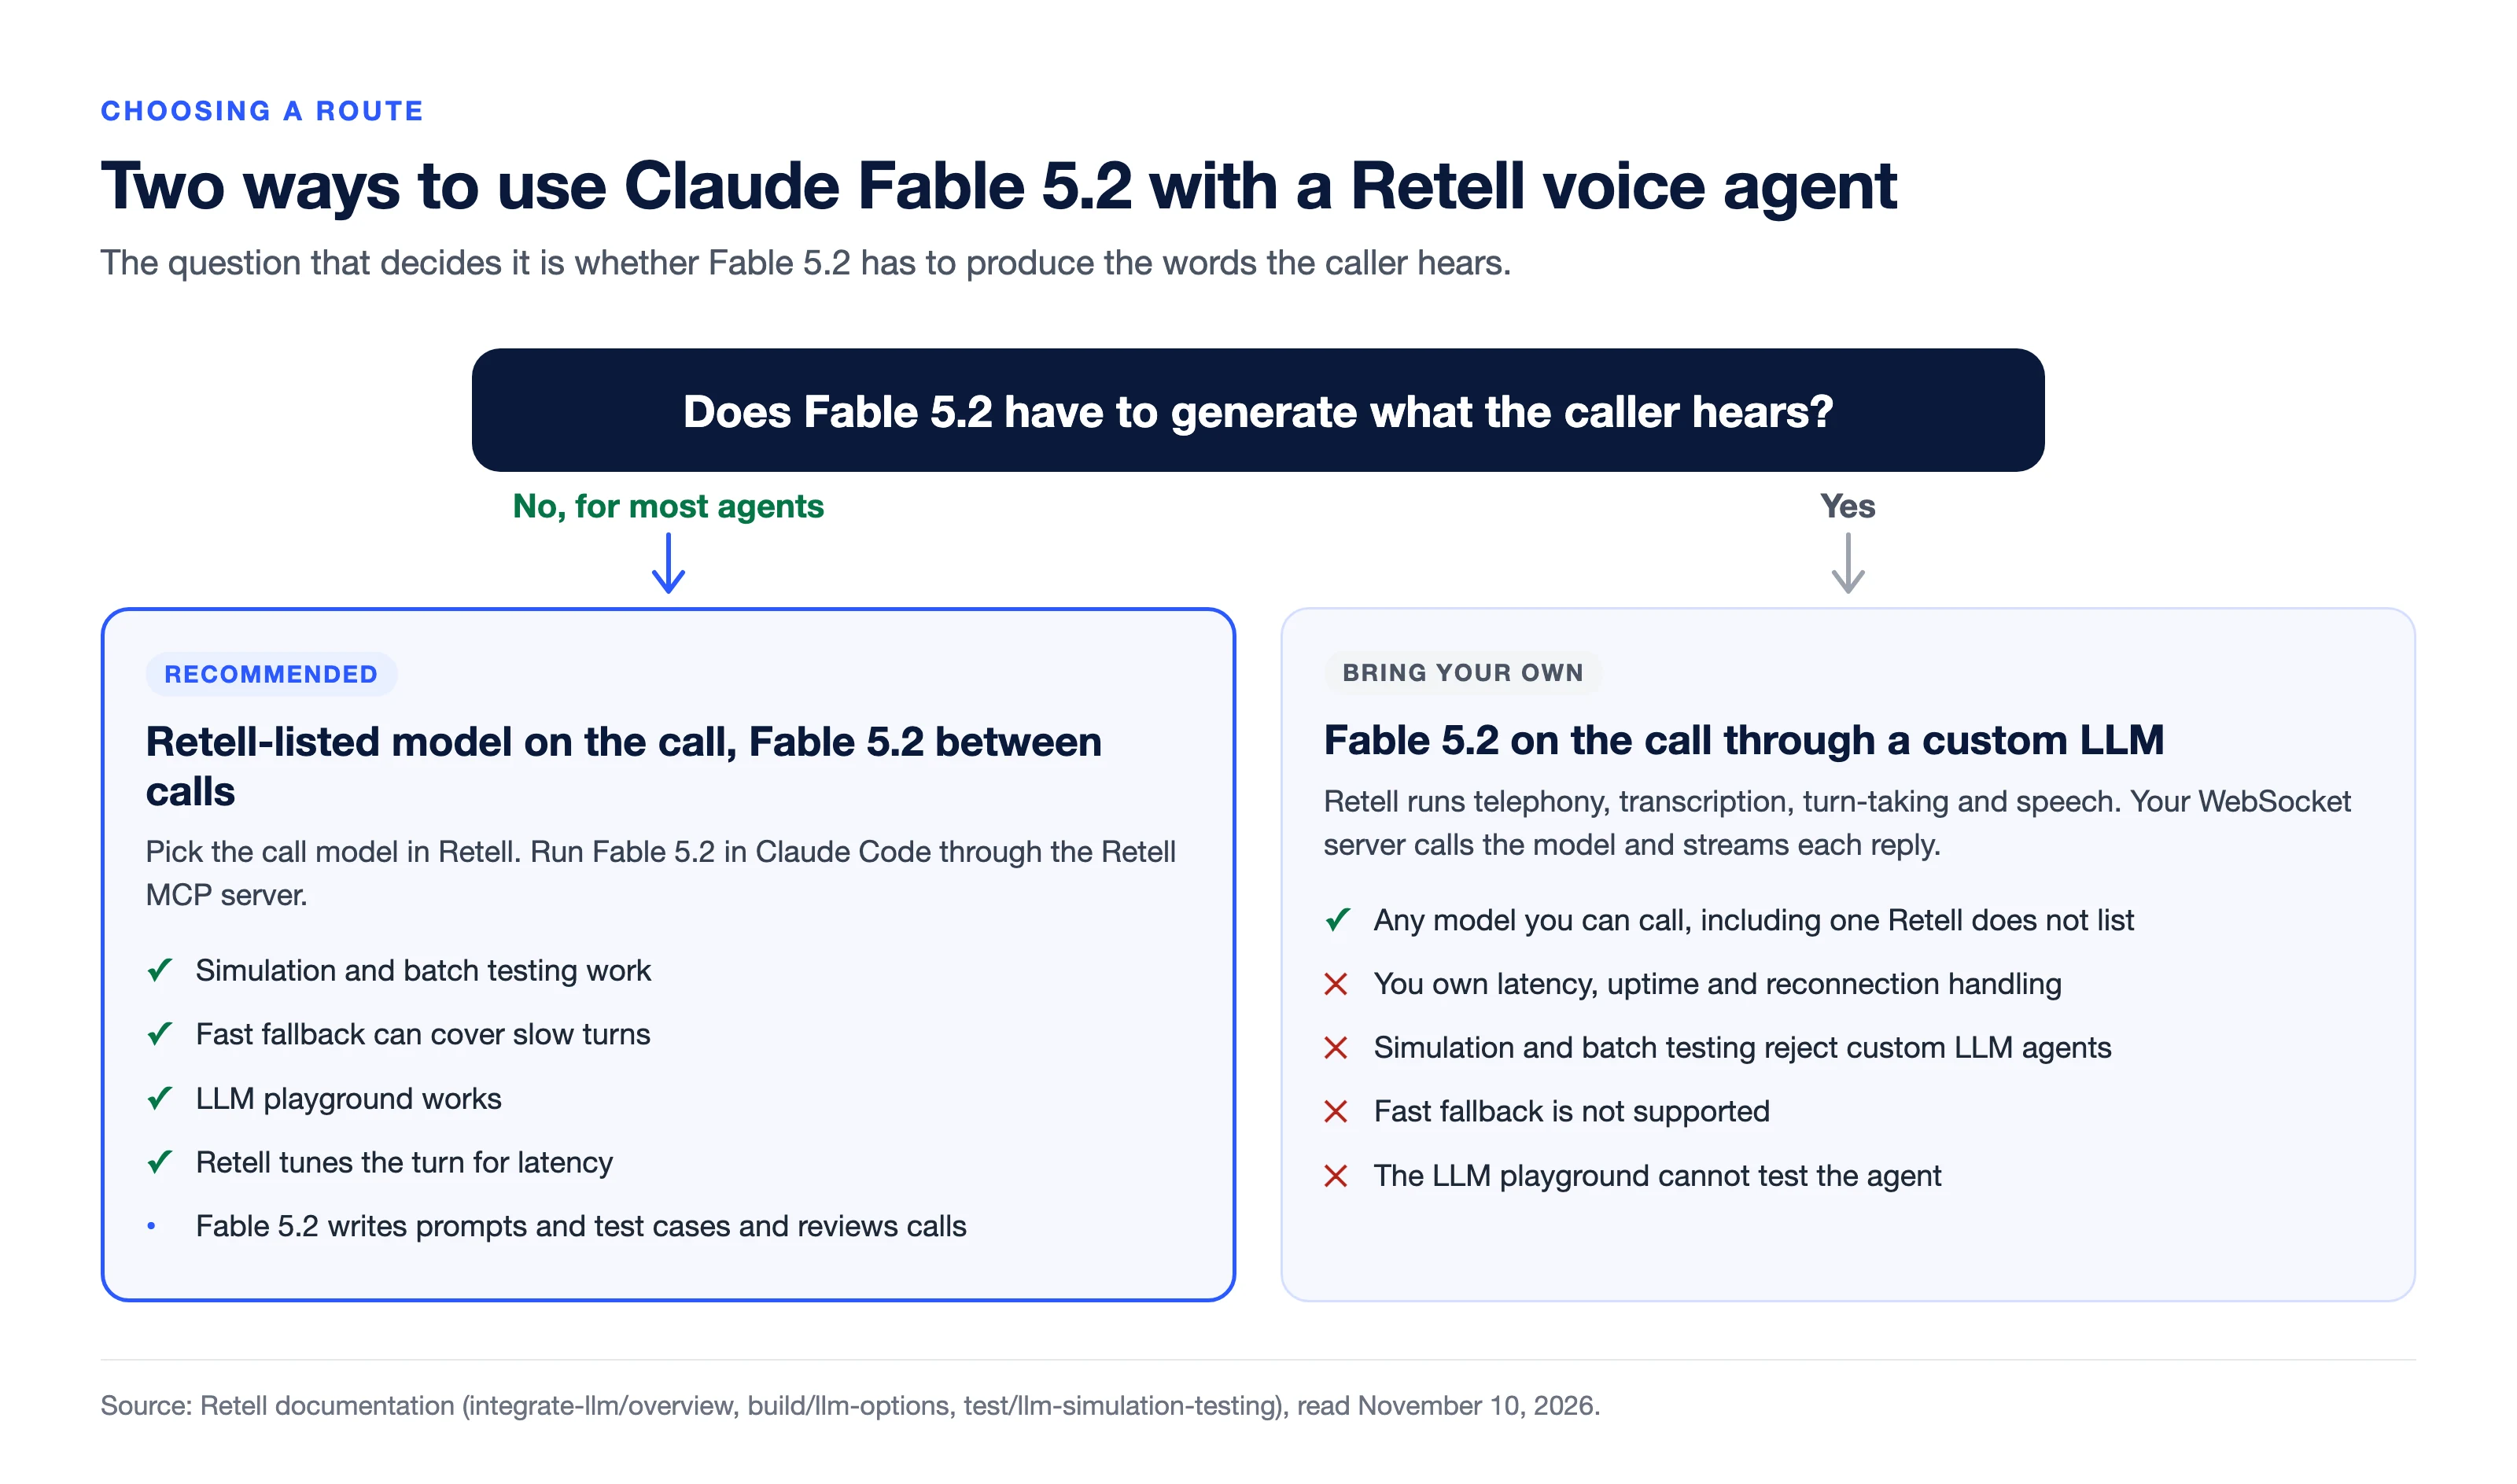
Du kan ta in den själv. Med alternativet anpassad LLM i Retell kan du köra din egen modell bakom en röstagent: Retell hanterar telefoni, transkribering, turtagning och talsyntes och öppnar en WebSocket till din server för varje samtal. Din server anropar den modell du väljer och strömmar tillbaka det agenten ska säga.
Den vägen har kostnader som dokumentationen från Retell beskriver tydligt. Du tar själv ansvar för latens, drifttid och hantering av återanslutningar. LLM-playground kan inte testa en agent med anpassad LLM, och simulerings- och batchtester avvisar sådana agenter, så webb- och telefonsamtal är det enda sättet att testa. Snabb fallback, som kör en reservmodell parallellt med den primära så att ett långsamt svar inte håller upp samtalet, stöder inte agenter med anpassad LLM. Retell rekommenderar agenter med en enda prompt eller med konversationsflöde för de flesta agenter.
Så väljer du modellen som svarar i samtalet
Välj inte modellen för samtalet utifrån ett lanseringsinlägg, inte ens det här. Välj den utifrån dina egna samtal.
- Utgå från modellistan i Retell. Det är kring den som plattformens funktioner för testning, fallback och analys är byggda.
- Mät latensen per samtal. Call History i Retell visar latensen från början till slut för varje samtal, och Get Call API returnerar en uppdelning som inkluderar språkmodellens tid till dess första talbara del.
- Kör samma simuleringssvit mot varje kandidat. En modell som är snabbare men misslyckas med dina fall för överföring eller upplysningskrav är inte snabbare på något sätt som spelar roll.
- Lägg till en reserv för långsamma turer. Snabb fallback startar den primära modellen och en reservmodell samtidigt och låter reserven ta över om den primära inte har börjat svara i tid.
Vår bredare guide om att välja en LLM för röstagenter går igenom avvägningarna mellan olika modellfamiljer. För OpenAI:s full duplex-röstmodell, se hur GPT-Live-1 fungerar i telefonsamtal. Den egna LLM:en från Retell, Tell-1, är ytterligare en kandidat för de testerna; sidan om Tell-1 visar dess benchmarkresultat.
Vanliga frågor
Kan jag använda Claude Fable 5.2 för en röstagent?
Inte som listad modell i Retell per den 10 november 2026. Modellistan i Retell omfattar Claude 5.5 Opus, Claude 5.5 Sonnet och Claude 5.5 Haiku. Du kan köra Fable 5.2 bakom en agent i Retell via alternativet anpassad LLM, där din egen server genererar varje svar, eller använda den utanför samtalet för att bygga och granska agenter.
Är Claude Fable 5.2 tillräckligt snabb för telefonsamtal i realtid?
Anthropic har inte publicerat någon siffra som besvarar det. Lanseringsinlägget säger att Fable 5.2 genererar utdata upp till 30 % snabbare än Fable 5.1 och har ett snabbläge som gör tokengenereringen upp till 2,5 gånger snabbare, men anger ingen siffra för tid till första svar i en konversation. Mät det i dina egna samtal innan du förlitar dig på den.
Vad kostar Claude Fable 5.2?
Anthropic tar $8 per miljon indata-tokens och $40 per miljon utdata-tokens. Snabbläget kostar $16 per miljon indata-tokens och $80 per miljon utdata-tokens.
Vad är skillnaden mellan Claude Fable 5.2 och Claude Mythos 5.2?
Enligt Anthropic är de samma underliggande modell. Fable har skyddsåtgärder för cybersäkerhet och biologi så att den kan erbjudas till alla användare. Mythos 5.2 körs utan vissa av dessa skyddsåtgärder och är endast tillgänglig för granskade organisationer.
Vilken Claude-modell bör en röstagent använda?
Välj bland de Claude-modeller som din röstplattform erbjuder och bestäm utifrån uppmätt latens och andel godkända tester, inte utifrån vilken modell som är nyast. Anthropic rekommenderar själv att börja med Claude Opus 5.5 för de flesta kodnings- och kunskapsuppgifter.
Vad är Claude Fable 5.2 bra för inom röst-AI?
Arbetet mellan samtalen: skriva agentprompter, generera testfall, granska samtalstranskript i stor volym och göra ändringar över många agenter. Claude Code kan göra allt detta mot en arbetsyta i Retell via Retell MCP-servern.
Låt Fable 5.2 arbeta mellan samtalen
Behåll en snabb modell i samtalet och ge den tunga modellen arbetet runt omkring. Anslut Claude Code till Retell MCP-servern, låt den skriva en testsvit för en agent som du redan kör i Retell och se vad den hittar i dina egna samtal.
See how much your business could save by switching to AI-powered voice agents.
ROI Result
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Estimate your monthly voice AI cost
Read Other Blogs



Revolutionera din samtalsverksamhet med Retell


