GPT-Live-1: Sådan fungerer OpenAIs full-duplex-stemmemodel i telefonopkald




GPT-Live-1 er OpenAIs full-duplex-stemmemodel. Den lytter og taler på samme tid, håndterer selv afbrydelser og overlader ræsonnement og brug af værktøjer til en separat backend-model. OpenAI lancerede den i API'et den 10. september 2026, efter at den havde debuteret i ChatGPT's stemmetilstand, og den har været tilgængelig på Retell AI-telefonagenter siden den 2. november 2026. Denne guide gennemgår, hvordan den fungerer, hvad den koster i API'et, hvor den passer ind i telefonopkald, og hvordan du sætter den op på en Retell-agent.
Retell AI udgiver denne guide og tilbyder GPT-Live-1 som en af modellerne på sin platform til stemmeagenter.
GPT-Live-1 i overblik
| GPT-Live-1 | |
|---|---|
| Udvikler | OpenAI |
| Model-ID | gpt-live-1 |
| Type | Full-duplex-stemmemodel, der uddelegerer ræsonnement og brug af værktøjer til en backend-model eller -agent |
| Input og output | Lyd og tekst ind, lyd og tekst ud |
| API-endpoint | Live sessions (v1/live/sessions) via WebRTC, WebSockets eller telefoni og SIP |
| API-pris | $0,05 pr. minut stemmesession, afregnet pr. sekund. Backend-model og brug af værktøjer afregnes separat. |
| Samtidighed | 50 sessioner på Build-niveauet, 300 på Launch, 500 på Grow. Ikke tilgængelig på Free-niveauet. |
| Kontekstvindue | 128.000 tokens |
| Nyere version | GPT-Live-1.1 blev rullet ud til ChatGPT, Codex og dots den 15. oktober 2026 og annonceret som snart tilgængelig i API'et. Ikke i API'et pr. 5. november. |
Kilder: OpenAIs modelside for GPT-Live-1, Live-guide, guide til Live-samtaler, API-changelog og lanceringsindlæg; GPT-Live-1.1 fra et indlæg på OpenAIs udviklerforum. Læst 5. november 2026.
Sådan fungerer fuld duplex
De fleste stemmeagenter skiftes til at tale på én af to måder. En kaskaderende agent transskriberer den, der ringer, sender teksten til en sprogmodel og omdanner derefter svaret til tale. En speech-to-speech-model, som OpenAIs gpt-realtime-2.1, gør alle tre ting i én model.
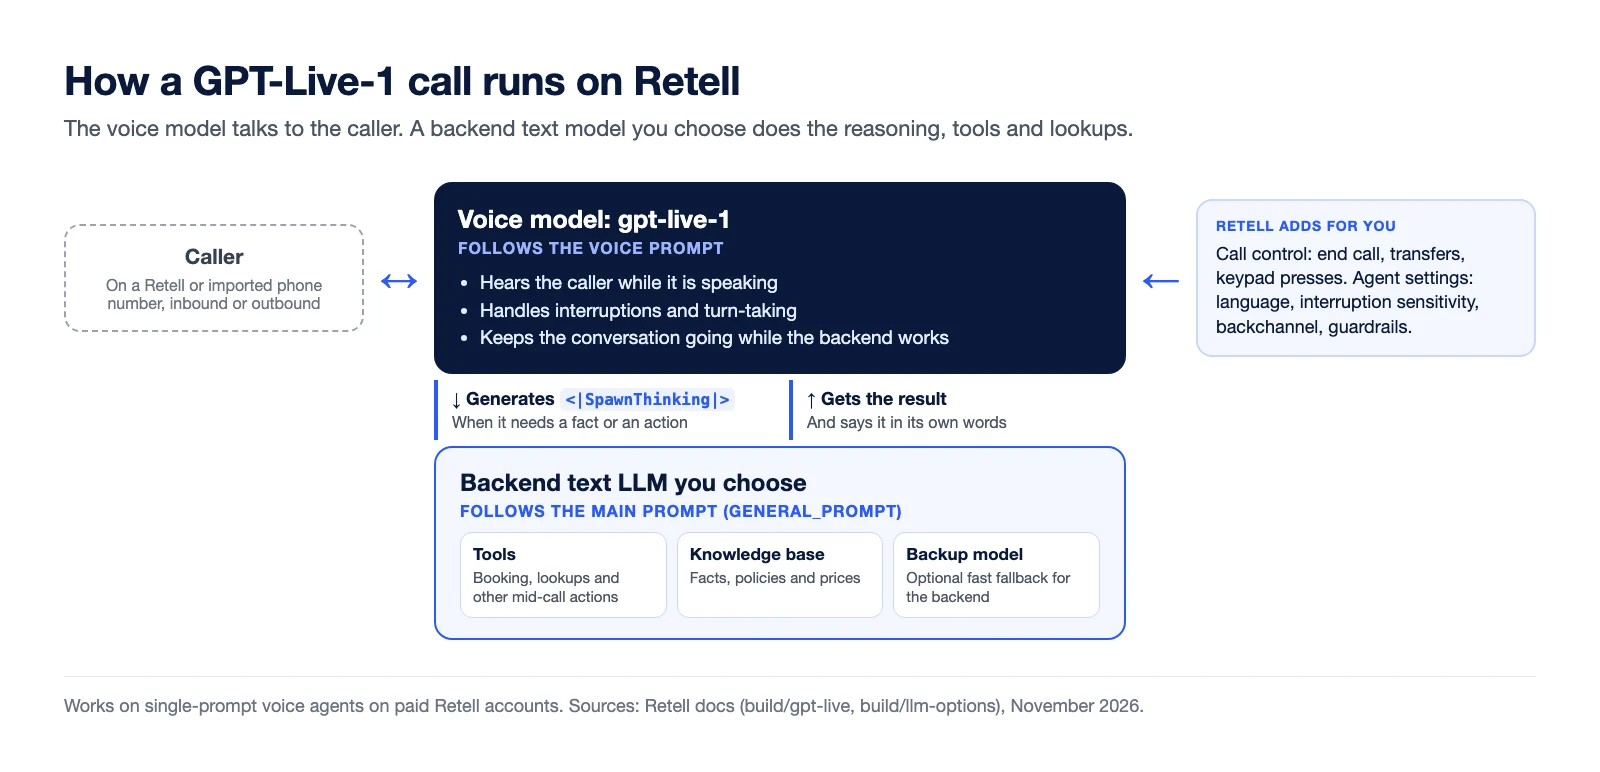
GPT-Live-1 deler opgaven anderledes op. Stemmemodellen ejer samtalen: Den hører den, der ringer, mens den selv taler, håndterer afbrydelser og pauser og beslutter, hvad den skal sige som det næste. Når den har brug for en oplysning eller en handling, anmoder den om backend-arbejde ved at generere et særligt token, <|SpawnThinking|>. Backenden kan være en model, en agent eller en tjeneste; hos Retell er det en tekstmodel, du selv vælger, som kører agentens værktøjer og vidensbase. Backenden returnerer resultatet, og stemmemodellen siger det med sine egne ord. Backend-arbejdet kan fortsætte, selvom den, der ringer, afbryder.
OpenAIs egne tal taler for opdelingen. I graferne fra lanceringsindlægget til API'et klarer GPT-Live-1 med GPT-6 Astra på mellem ræsonnementsniveau som backend 86,2 % af Tau3-stemmeopgaverne (support til flyselskaber, detailhandel og telekom) i første forsøg mod 45,7 % for GPT-Realtime-2.1. På Full Duplex Bench rapporterer OpenAI en latens for turtagning på 0,798 sekunder for GPT-Live-1 mod 1,41 sekunder for GPT-Realtime-2.1. Det er OpenAIs resultater, ikke Retells målinger.
Kaskaderende, speech-to-speech eller fuld duplex?
Retell understøtter alle tre måder at køre en stemmeagent på. De egner sig til forskellige opkald.
| Kaskaderende | Speech-to-speech | Fuld duplex (GPT-Live-1) | |
|---|---|---|---|
| Sådan fungerer en tur | Transskription, derefter en tekst-LLM, derefter tekst-til-tale | Én model hører lyd og svarer med lyd | En stemmemodel taler, mens en backend-tekst-LLM står for ræsonnement og værktøjer |
| Eksempler på Retell | GPT 5.6 Terra, Claude 5 Sonnet, Gemini 3.5 Flash | gpt-realtime-2.1, grok-voice-3.0 | gpt-live-1 med en backend-tekst-LLM |
| Prompts | Én | Én | To: en stemmeprompt og backend-prompten |
| Hurtig fallback-backupmodel | Understøttet | Ikke understøttet | Gælder for backend-modellen |
| Bedst til | Samtaleflows og stram logik i flere trin | Hurtige, naturlige opkald, der primært følger én prompt | Naturlige opkald, der også udfører handlinger undervejs |
Hvis du vil se xAIs speech-to-speech-mulighed, kan du læse, hvordan du kører en telefonagent på Grok Voice. For et bredere overblik over modellerne kan du se vores sammenligning af speech-to-speech AI-API'er til telefonopkald.
Hvor GPT-Live-1 passer ind i telefonopkald
GPT-Live-1 står stærkest på agenter med én prompt, der udfører handlinger under opkaldet, f.eks. at booke et møde eller slå en ordre op, hvor svarpausen hos en kaskaderende agent er mærkbar. Mens backenden booker eller slår noget op, holder stemmemodellen samtalen i gang i stedet for at holde pause med en fyldsætning.
Hos Retell har den klare begrænsninger:
- Kun stemmeagenter med én prompt. Den er ikke tilgængelig for samtaleflows, agenter med flere prompts, viderestillingsagenter eller chatagenter. Brug en kaskaderende model eller en speech-to-speech-model til dem.
- Nogle værktøjer understøttes ikke. Agentskift, assisteret (brokoblet) viderestilling og annullering af viderestilling afvises, når du gemmer. Almindelig viderestilling af opkald, afslut opkald og tryk på tast fungerer alle.
- Kun betalte konti. Ligesom speech-to-speech-modeller er GPT-Live-1 ikke en del af den gratis prøveperiode.
- Intet skift pr. opkald. En agent-override på et enkelt opkald kan ikke flytte en agent over på GPT-Live-1.
Sådan sætter du GPT-Live-1 op på en Retell-telefonagent
GPT-Live-1 konfigureres via Retell API'et på en Retell LLM.
- Opret en Retell LLM med model_config sat til typen duplex, gpt-live-1 som primær model og den tekstmodel, du ønsker, som backend.
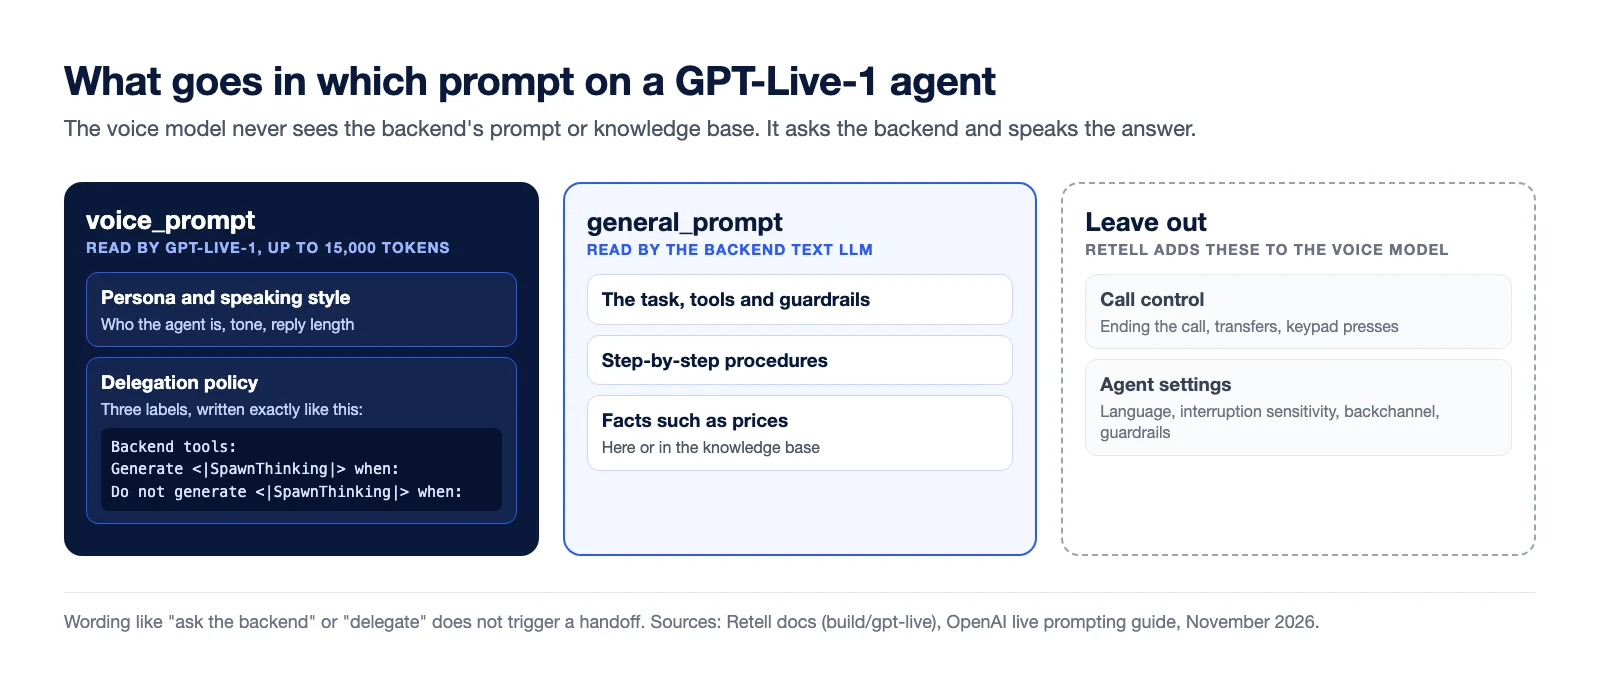
- Skriv to prompts. general_prompt er backendens prompt: opgaven, værktøjerne og guardrails. voice_prompt fortæller stemmemodellen, hvordan den skal tale, og hvornår den skal overlade arbejde til backenden. Den kan være på op til 15.000 tokens.
- Tilknyt LLM'en til en stemmeagent som dens response engine, på samme måde som enhver anden Retell LLM.
- Forbind et telefonnummer, og modtag indgående opkald eller foretag udgående.
Her er en forespørgsel tilpasset fra Retells dokumentation til en agent for en tandklinik:
curl --request POST "https://api.retellai.com/create-retell-llm" \
  --header "Authorization: Bearer $RETELL_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "general_prompt": "You are the backend for a dental clinic phone agent. Collect the caller name and date of birth, then use the booking tool to find and confirm an appointment. Keep names, numbers, and dates exact.",
    "voice_prompt": "You are a warm, efficient front-desk agent for Bright Smile Dental. Keep replies short and natural, and ask one question at a time.\n\nDelegation policy:\nBackend tools:\n- Appointments: find open times and book, change, or cancel appointments.\n\nGenerate <|SpawnThinking|> when:\n- The caller wants to book, change, or cancel an appointment.\n\nDo not generate <|SpawnThinking|> when:\n- You need a brief clarification to understand the request.",
    "model_config": {
      "type": "duplex",
      "primary": { "model": "gpt-live-1" },
      "backend": { "model": "gpt-4.1" }
    }
  }'
Alle detaljer om felterne finder du i opsætningsguiden til GPT Live.
Sådan skriver du stemmeprompten
Det er i stemmeprompten, at de fleste GPT-Live-1-agenter går galt. Modellen overlader kun arbejde til backenden, når den genererer <|SpawnThinking|>, så reglerne for overdragelse skal bruge præcis den formulering. Formuleringer som "spørg backenden" eller "uddeleger" udløser ikke en overdragelse. OpenAIs promptguide advarer også om, at et mundtligt løfte som "jeg tjekker det lige" ikke betyder, at backend-arbejdet er gået i gang.
Skriv stemmeprompten i to dele:
- Persona og talestil. Hvem agenten er, og hvordan den taler, f.eks. tone og svarlængde.
- En uddelegeringspolitik under tre etiketter, der bevares præcis som skrevet: "Backend tools:" angiver, hvad backenden kan gøre, én funktion pr. linje. "Generate <|SpawnThinking|> when:" angiver, hvornår der skal overdrages. "Do not generate <|SpawnThinking|> when:" angiver, hvad der skal besvares direkte.
Hold værktøjsdefinitioner, trin-for-trin-procedurer og fakta som priser i backend-prompten og vidensbasen. Stemmemodellen ser dem ikke; den spørger backenden og siger svaret med sine egne ord. Retell tilføjer også instruktioner til opkaldsstyring (afslutning af opkaldet, viderestillinger, tastetryk) og agentens indstillinger til stemmemodellen for dig, så dem skal du udelade.
Hvad der overføres fra dine agentindstillinger
De fleste af Retells agentindstillinger gælder stadig. Stemmemodellen respekterer agentens sprog, følsomhed over for afbrydelser, responsivitet, backchannel, talehastighed, udtale, boostede nøgleord og guardrails. Registrering af telefonsvarer, IVR, do-not-call og tilbagekald kører via backenden, og indstillingen for velkomstbesked afgør stadig, hvem der taler først.
To ting fungerer anderledes. Hvert værktøjs indstilling "speak during execution" ignoreres, fordi stemmemodellen bliver ved med at tale, mens backenden kører, og agenten taler altid, når et værktøj er færdigt. Dynamiske variabler i stemmeprompten udfyldes én gang, når opkaldet starter.
Hvad GPT-Live-1 koster
I OpenAIs API koster en GPT-Live-1-stemmesession $0,05 pr. minut, afregnet pr. sekund og ikke rundet op til det næste minut. Backend-modellen og dens værktøjer afregnes separat til deres normale takster.
Hos Retell afregnes stemmemodellen pr. minut opkaldstid, og backend-tekst-LLM'en afregnes separat for sit eget forbrug. Aktuelle priser finder du på prissiden. Én detalje er vigtig ved lange opkald: Retell reducerer modelomkostningerne under lange stille perioder, men full-duplex-stemmemodeller afregnes stadig i disse perioder.
Ofte stillede spørgsmål
Hvad er GPT-Live-1?
GPT-Live-1 er OpenAIs full-duplex-stemmemodel til samtaler i realtid. Den lytter og taler på samme tid, håndterer afbrydelser og uddelegerer ræsonnement og brug af værktøjer til en backend-model eller -agent, som du vælger.
Er GPT-Live-1 tilgængelig i API'et?
Ja. GPT-Live-1 blev generelt tilgængelig i OpenAIs API den 10. september 2026 på Live sessions-endpointet. GPT-Live-1.1, en nyere version med flere stemmer og bedre ydeevne på andre sprog end engelsk, blev rullet ud til ChatGPT, Codex og dots den 15. oktober 2026 og blev annonceret som snart tilgængelig i API'et.
Hvad koster GPT-Live-1?
OpenAI tager $0,05 pr. minut for en GPT-Live-1-stemmesession, afregnet pr. sekund. Backend-modellen og brug af værktøjer afregnes separat til deres normale takster.
Kan GPT-Live-1 håndtere telefonopkald?
Ja. OpenAI understøtter telefoni- og SIP-forbindelser til Live sessions. Hos Retell er en GPT-Live-1-agent en stemmeagent som alle andre, så du forbinder den til et telefonnummer til indgående og udgående opkald, og både almindelig viderestilling af opkald og tryk på tast fungerer.
Hvordan adskiller GPT-Live-1 sig fra gpt-realtime?
gpt-realtime-modeller er speech-to-speech: Én model lytter, ræsonnerer, kalder værktøjer og taler via OpenAIs Realtime API. GPT-Live-1 kører på et separat Live sessions-endpoint, holder stemmen i sin egen model og sender ræsonnement og værktøjer til en backend. OpenAI rapporterer højere opgavegennemførelse for GPT-Live-1 kombineret med en stærk backend samt hurtigere turtagning.
Fungerer GPT-Live-1 med samtaleflows på Retell?
Nej. Hos Retell fungerer GPT-Live-1 kun på stemmeagenter med én prompt. Samtaleflows og agenter med flere prompts kræver en kaskaderende model eller en speech-to-speech-model.
Prøv GPT-Live-1 på dine egne opkald
Hvis din agent udfører handlinger under opkaldet, og pauserne generer dig, er GPT-Live-1 værd at teste i et pilotprojekt. Følg opsætningsguiden, forbind et nummer i Retell, og sammenlign den med din nuværende model på rigtige opkald, før du skifter.
See how much your business could save by switching to AI-powered voice agents.
ROI Result
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Et demonummer fra Retell Clinic Office
What results look like with Retell AI


Estimate your monthly voice AI cost
Read Other Blogs
Revolutionér din callcenter-drift med Retell


