Fra stemme-AI-demo til produktion: Hvad købere har brug for de første 30 dage




At få en AI-stemmeagent fra demo til produktion på 30 dage betyder, at du afgrænser én opkaldstype, bygger og forbinder den i uge to, tester den med simulerede og rigtige opkald i uge tre og soft launcher den på en del af den live trafik i uge fire – med én navngiven ansvarlig for hver arbejdsopgave. Demoen beviser, at platformen kan føre en samtale. De 30 dage beviser, at dit team kan drive den, og et pilot-til-produktion-scorecard til sidst fortæller dig, hvornår agenten er klar til mere trafik.
Hvorfor bringer en god demo dig ikke i produktion?
En demo svarer på "kan den tale?" Produktion stiller fire andre spørgsmål: hvilke opkald den tager, hvilke systemer den skriver til, hvem der retter den, når et opkald går galt, og hvordan en ændring bliver testet, før opkalderne hører den. De fleste teams, der går i stå efter en demo, sidder ikke fast i softwaren. De forstår dashboardet. Det, de mangler, er en plan, en navngiven ansvarlig og nogen at spørge, når opbygningen rammer et spørgsmål, som dokumentationen ikke besvarer for netop deres workflow.
Hvis du stadig er ved at vælge platform, så start med sådan evaluerer du en stemmeagentplatform før go-live. Hvis du har en favorit, men ikke har forpligtet dig, så afprøv den først på dine egne edge cases, som næste afsnit beskriver. Derefter antager denne guide, at du har valgt og nu skal i luften.
Hvordan kører du et proof of concept for stemme-AI på dine egne edge cases?
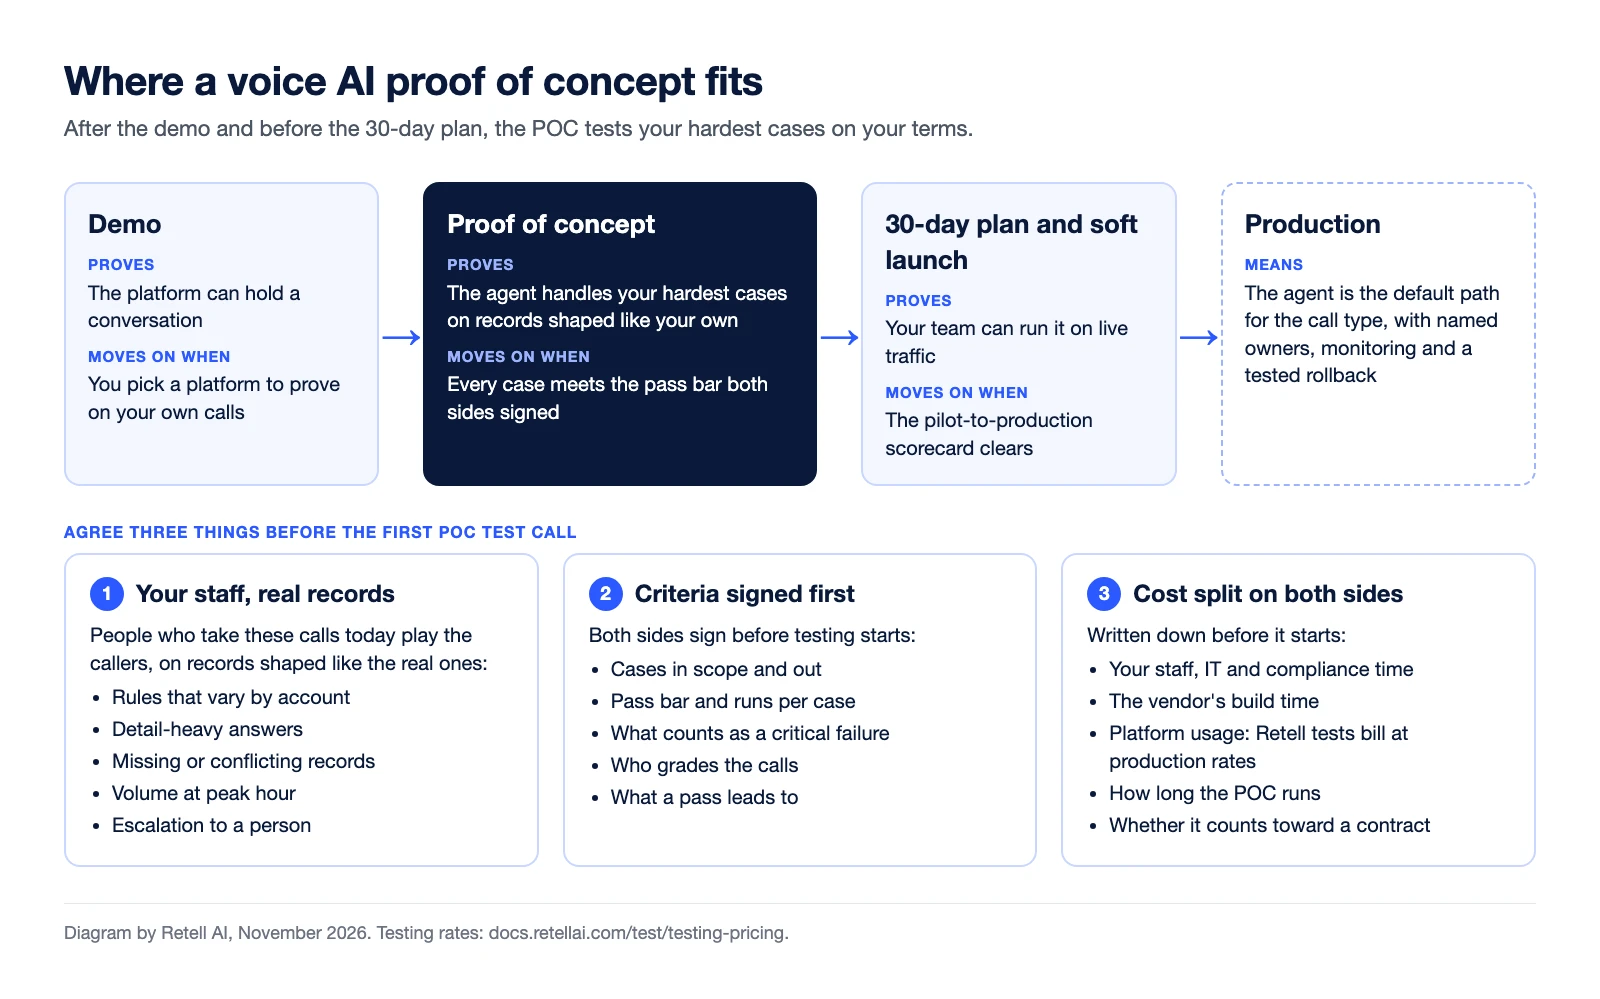
Kør et proof of concept (POC) for stemme-AI på de opkald, demoen sprang over: dine egne medarbejdere spiller dine sværeste opkaldere på poster, der ligner dine rigtige, mod succeskriterier, som begge parter har underskrevet på forhånd, og med testomkostningerne aftalt fra start. En demo kører den lette vej. Et POC viser, om agenten holder til de regler, der gør dine opkald svære.
Test med dine egne medarbejdere på rigtige poster
Spørg de medarbejdere, der tager disse opkald i dag, hvilke tilfælde der får nyansatte til at snuble, og lad dem derefter ringe til agenten som de opkaldere. Kør hvert tilfælde mod en post, der ligner den rigtige, fordi en ren testpost skjuler det, en rodet post afslører.
| Edge case | Hvad dine medarbejdere tester | Sådan ser bestået ud |
|---|---|---|
| Regler, der varierer fra konto til konto | Én forespørgsel fra opkaldere, hvis poster har forskellige regler eller undtagelser | Agenten anvender reglen på den pågældende post, ikke den mest almindelige |
| Detaljetunge svar | Spørgsmål, der kræver flere felter på én gang, såsom datoer, beløb og grænser | Hver detalje stemmer med posten, og agenten siger, hvad den ikke kan bekræfte |
| Manglende eller modstridende poster | Ingen post, en dublet eller oplysninger, der ikke stemmer med opkalderens | Agenten verificerer, spørger eller overdrager og gætter aldrig |
| Volumen | Belastning i spidsbelastningstimen ved den trafikandel, piloten skal bære, kørt som en belastningstest på den rigtige opkaldsvej | Opkald forbindes, og resultatet holder ved den belastning |
| Eskalering | Tilfælde, der skal nå et menneske, inden for og uden for åbningstid, på en rigtig telefonlinje | Agenten opdager dem tidligt og viderestiller til den ansvarlige, som din eskaleringsmatrix angiver |
Afklar datahåndteringen, før rigtige poster indgår i en test. Compliance-dokumentationen fra Retell kræver en underskrevet BAA, før beskyttede helbredsoplysninger går gennem Retell. Hvis dine regler endnu ikke tillader rigtige poster, så kopiér deres struktur: i en Retell-simuleringstest angiver hvert tilfælde sine egne værdier for dynamiske variabler og mockede funktionsresultater. Tjek, hvad dine regler tillader, med din juridiske rådgiver eller dit compliance-team.
Aftal succeskriterierne, før piloten starter
Begge parter underskriver kriterierne før det første testopkald, fordi kriterier, der skrives bagefter, glider mod det, agenten tilfældigvis gjorde. Angiv de tilfælde, der er omfattet, beståelsesgrænsen og antallet af kørsler for hvert, hvad der tæller som en kritisk fejl, hvem der bedømmer, og hvad en beståelse fører til, så en beståelse ender i en beslutning frem for mere test. Brug guiden til platformevaluering til metrikkerne; scorecardet senere i denne guide dækker en anden beslutning.
Opgør testomkostningerne på begge sider
Din side bruger medarbejdertimer på at foretage og bedømme opkald plus tid fra IT og compliance. Leverandøren bruger opbygningstid på at tilpasse en agent til dine regler. Dertil kommer platformforbrug: ifølge testpriserne hos Retell faktureres test til produktionspriser uden gratis sandbox, med stemme fra $0.07 pr. minut og tekst pr. besked, så kør de fleste tilfælde som tekst. Skriv ned, hvem der dækker hver omkostning, hvor længe dit POC kører, og om det tæller med i en kontrakt. En fast liste over tilfælde og et fast tidsvindue holder det billigt for begge parter.
Hvordan skal de første 30 dage se ud, uge for uge?
Fire uger, hver med ét mål og et klart "færdig, når". Start ikke næste uge, før den nuværende er færdig.
| Dage | Mål | Færdig, når |
|---|---|---|
| 1 til 7 | Afgræns én opkaldstype | En afgrænsning på én side er underskrevet af den forretningsansvarlige |
| 8 til 14 | Byg og forbind | Agenten gennemfører hovedforløbet fra start til slut på en kladdeversion |
| 15 til 21 | Test med simulerede og rigtige opkald | Testsuiten består ved den tærskel, du har sat, og viderestillinger virker på en rigtig telefonlinje |
| 22 til 30 | Soft launch og overvågning | En del af den live trafik kører i en uge med alarmer slået til og en daglig gennemgang |
Afgræns én opkaldstype (dag 1 til 7)
Vælg én opkaldstype med stabil volumen og et resultat, du kan kontrollere i et kildesystem: et booket møde, et routet lead, en oprettet sag. Hent rigtige optagelser eller transskriptioner af den opkaldstype, ikke det script, dit team tror, opkalderne følger.
Afgrænsningsdokumentet skal besvare fem ting:
- Den ene opkaldstype, der er omfattet, og alle opkaldstyper, der udtrykkeligt ikke er omfattet.
- Succesmetrikken, defineret så en maskine kan markere den som sand eller falsk.
- Det ene kildesystem, agenten læser fra eller skriver til.
- Hvor opkald går hen, når agenten ikke kan hjælpe, og i hvilke tidsrum.
- Hvem der godkender agentens formuleringer, og hvem der godkender lanceringen.
Byg og forbind (dag 8 til 14)
Byg på en kladdeversion. I Retell starter en ny version som en kladde, du kan redigere og teste, og når du publicerer den, bliver den skrivebeskyttet, så du altid har en fast konfiguration at vende tilbage til. Forbind kun det ene system fra din afgrænsning. Hvis den forbindelse er ny for dit team, gennemgår workflowet fra CRM til stemme-AI, hvilke data der flyttes på hvert tidspunkt i opkaldet.
Sæt succesmetrikken op nu, ikke efter lanceringen. Post Call Extraction i Retell kører, efter hvert opkald er afsluttet, og indeholder et indbygget call_successful-felt plus brugerdefinerede felter, som du definerer som boolean, tekst, tal eller selector. Et felt som "appointment_booked" er det, du vil vise i grafer og sætte alarmer på i uge fire.
Test med simulerede og rigtige opkald (dag 15 til 21)
Test først i tekst, derefter i stemme og så på telefonen. Simuleringstest i Retell kører et testtilfælde uden at foretage et opkald: en AI spiller opkalderen ud fra en persona, du skriver, og kørslen bedømmes som bestået eller ikke bestået mod dine succeskriterier med en skriftlig forklaring. Gemte tilfælde kører samlet som en batch, der rapporterer en beståelsesrate, så suiten bliver dit regressionstjek efter hver ændring. Conductor, copiloten i Retell-dashboardet, kan udarbejde testtilfælde fra bunden eller ud fra rigtige opkald.
Tre ting, du skal have styr på i denne uge:
- Mock alt, der skriver til et live system. Dokumentationen fra Retell advarer om, at en brugerdefineret funktion uden mock kalder sit rigtige endpoint under en test, så en test kan oprette en rigtig booking eller post.
- Brug webopkald til stemme og telefonopkald til telefoni. Et browseropkald lader dig høre afbrydelser og turtagning, men viderestillinger til et telefonnummer fejler dér. Brug et rigtigt telefonopkald til at tjekke viderestillinger, tastaturinput og operatørlyd.
- Sæt budget af til det. Test faktureres til produktionspriser i Retell: teksttest pr. besked, stemmetest pr. minut.
Afslut ugen med, at medarbejdere ringer ind, som rigtige opkaldere ville gøre – også de besværlige.
Soft launch og overvågning (dag 22 til 30)
Send en lille andel af den rigtige trafik til agenten, hold øje med den dagligt, og hav en rollback klar, der kan udføres i ét træk. Til den første andel router din telefoniansvarlige en del af opkaldene til agentens nummer fra din eksisterende IVR eller kø. Derefter giver Retell dig tre værktøjer:
- A/B-test fordeler et telefonnummers trafik mellem agenter efter procent, så en rettelse kan tage en lille andel, mens resten bliver på den agent, du stoler på.
- Miljøtags peger et telefonnummer på en version. Når du flytter
prod-tagget til en ny version, skifter live opkald til den; flytter du det tilbage, ruller du tilbage. - Alarmregler sender en e-mail eller webhook, når opkaldssuccesrate, opkaldsvolumen, brugt samtidighed, negativ stemning eller omkostning krydser en tærskel, du har sat.
Gennemgå opkald hver dag. Call History filtrerer efter resultat, årsag til afbrydelse og agentversion. Live Monitoring lader en supervisor følge en live transskription, lytte med i stilhed eller overtage et opkald. Analysedashboardet kan vise dit brugerdefinerede udtræksfelt i graf ved siden af opkaldsvolumen, opdelt efter agentversion, så du kan se, om en rettelse flyttede tallet. Hvis du har brug for struktureret scoring i stor skala, scorer AI QA i Retell et udvalg af opkald mod kriterier, du definerer.
Hvem ejer hvad under udrulningen?
Én ansvarlig pr. række. Delte rækker er dér, hvor udrulninger går i stå.
| Arbejdsstrøm | Ansvarlig på din side | Leverandørens eller partnerens rolle |
|---|---|---|
| Afgrænsning, succesmetrik, godkendelse af lancering | Leder af kontaktcenter eller drift | Rådgiver om, hvad der passer til en første release |
| Opbygning af agent og prompt-ændringer | En driftsanalytiker eller udvikler med reserveret tid | Implementeringshjælp, hvis den er købt |
| Forbindelse til kildesystem | IT eller CRM-administratoren | Dokumenterer API- og integrationsmulighederne |
| Telefonnumre, operatør eller routing i kontaktcenteret | Telefoniansvarlig | Dokumenterer opsætningen; yder support i henhold til planen |
| Testsuite og daglig gennemgang af opkald | En teamleder eller QA-reviewer | Gennemgår suiten, hvis det er inkluderet |
| Godkendelse af data, optagelse og compliance | Sikkerhed eller compliance | Leverer aftaler og rapporter |
| Platformhændelser | Eskalerer | Ejer, i henhold til dit supportniveau |
Den række, der betyder mest, er den anden. Hvis ingen i dit team kan ændre agenten uden at oprette en sag, forbedres agenten i takt med en andens kø. I et voksende antal teams tilhører den række en CX automation engineer: en intern ansvarlig, der driver agenten i hverdagen, efter at leverandørens forward deployed engineers har hjulpet med at bygge den første version og trænet teamet.
Hvad skal du spørge en leverandør om enablement og hjælp, før du skriver under?
Få skriftligt, hvilken hjælp der følger med din plan, og hvem du ringer til, når opbygningen går i stå. Selvbetjening fungerer, når du har en intern udvikler med tid. Når du ikke har det, så køb hjælpen fra start i stedet for at opdage hullet i uge to.
Hos Retell viser prissiden community- og e-mailsupport på betal efter forbrug. Enterprise-planen omfatter 24/7-support med en dedikeret portal, en navngiven account manager og Dedicated Implementation Support som tilkøb. Hvis du vil have praktisk hjælp til opbygningen fra en tredjepart, viser Retell-kataloget over løsningspartnere certificerede partnere, som du kan filtrere efter placering, sprog, integrationer, om den første konsultation er gratis, og prisniveau.
Spørgsmål, du kan stille enhver leverandør:
- Hvilke supportkanaler og åbningstider indgår i vores plan, og hvad tæller som akut?
- Er implementeringshjælp inkluderet, et tilkøb eller leveret gennem en partner? Hvad koster det, og er det en fast pris eller afgrænset pr. projekt?
- Vil nogen gennemgå vores afgrænsning, agentdesign og testsuite, før vi soft launcher?
- Hvem kontakter vi i soft launch-ugen, hvis noget går i stykker, og hvor hurtigt svarer de?
- Kan vores eget team køre hele ændringsloopet (finde et fejlet opkald, rette det, teste det, publicere det, rulle det tilbage) uden supportsager hos leverandøren?
- Hvordan kommunikeres platformhændelser?
Hvis en partner bygger sammen med dig, dækker sådan afgrænser leverandører og partnere af stemme-AI den første aftale fordelingen fra deres side.
| Din situation | Sandsynlig vej |
|---|---|
| En udvikler med reserveret tid og en standardintegration | Selvbetjening med dokumentation og support via planen |
| Der er en udvikler, men vedkommende har aldrig leveret et stemme-workflow | Selvbetjening plus et afgrænset designreview fra leverandøren eller en partner |
| Ingen ejer opbygningen, eller agenten ligger bag en kontaktcenterplatform | En certificeret partner eller implementeringssupport fra leverandøren fra dag ét |
Hvordan scorer du en AI-pilot, før du flytter den i produktion?
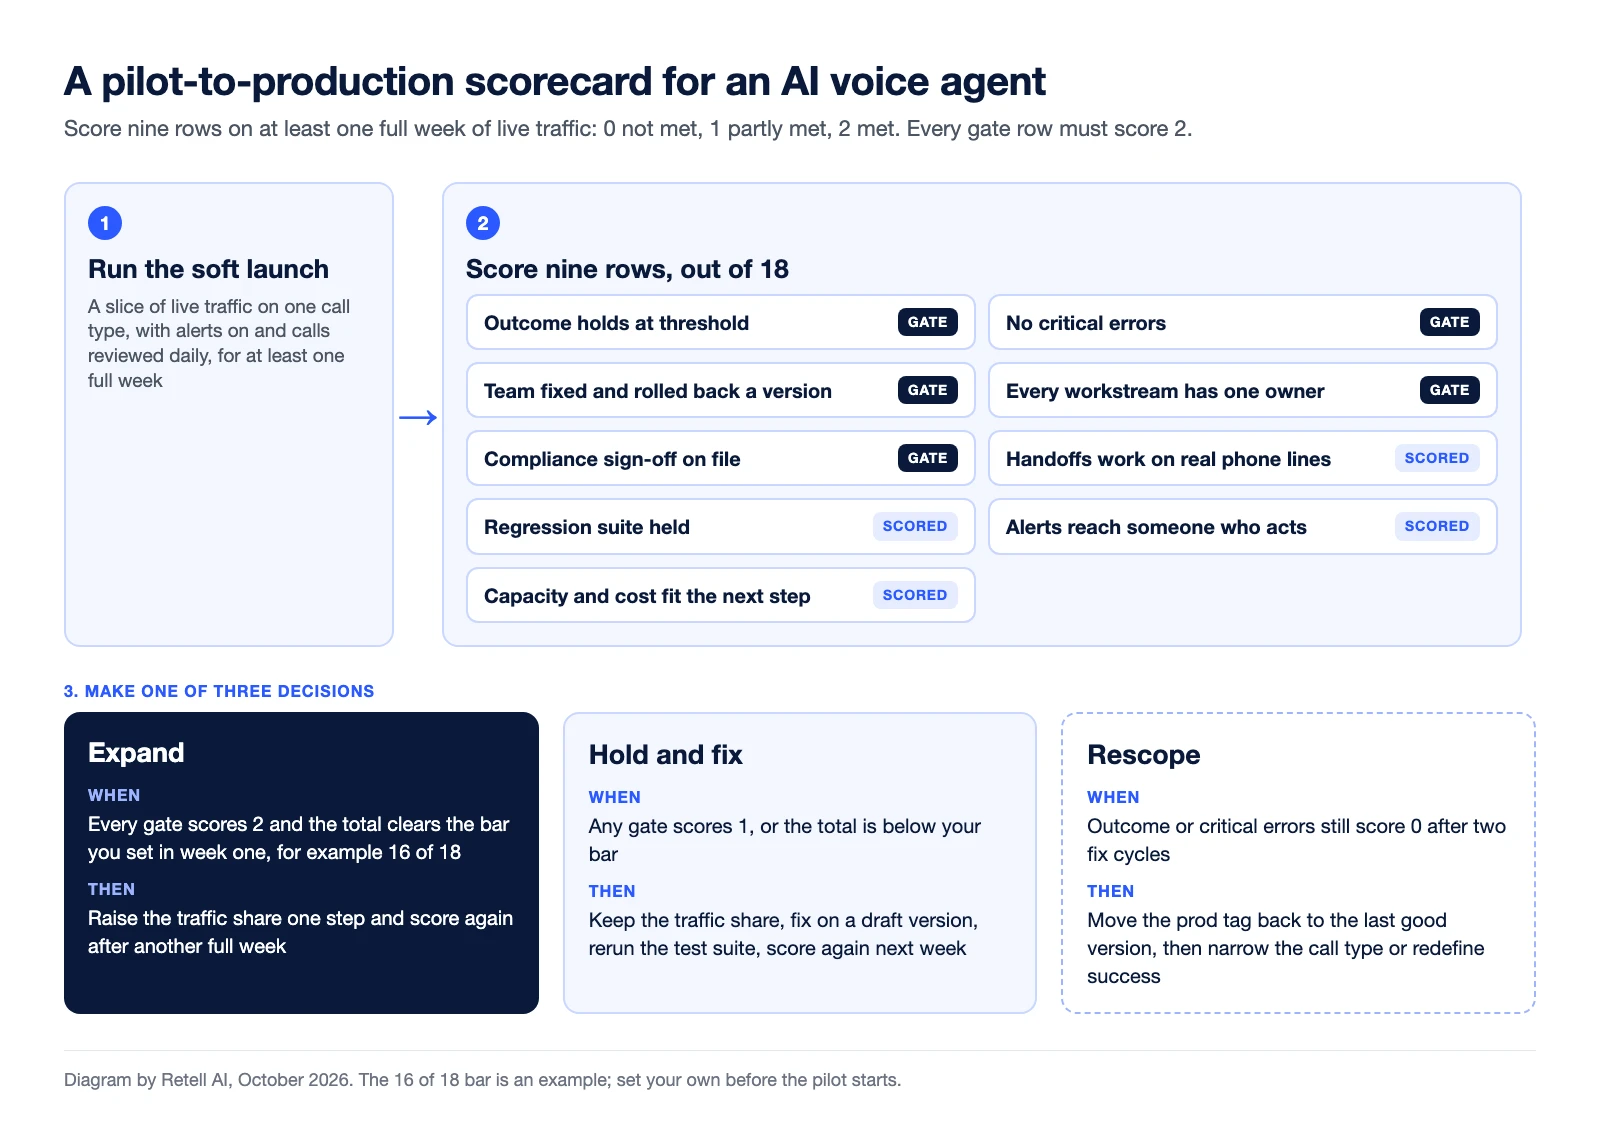
Scor piloten på et fast scorecard efter mindst én hel uge med live trafik, og flyt den først i produktion, når alle gate-rækker består, og totalen overstiger en grænse, du satte i uge ét. Scorecardet forvandler "det ser ud til at gå godt" til én af tre beslutninger: udvid, hold og ret eller afgræns på ny.
Skriv grænsen ind i afgrænsningsdokumentet før soft launch, så ingen argumenterer den ned, efter at have set tallene. Scor hver række 0 (ikke opfyldt), 1 (delvist opfyldt) eller 2 (opfyldt). Gate-rækker skal score 2 uanset totalen. Ni rækker giver maksimalt 18, og 16 er en fornuftig standardgrænse.
| Række | Scor 2, når | Dokumentation | Type |
|---|---|---|---|
| Resultat | Succesmetrikken holder på eller over din tærskel hver dag | Dit udtræksfelt vist i graf efter agentversion og stikprøvekontrolleret mod kildesystemet | Gate |
| Ingen kritiske fejl | Gennemgåede opkald viser ingen opdigtede fakta og ingen oversprungne verifikationer eller påkrævede oplysninger | AI QA-resultater plus en lille stikprøve bedømt manuelt | Gate |
| Ændringsloop | Dit team har rettet et fejlet opkald på en kladdeversion, testet og publiceret det og bevidst rullet en version tilbage uden en supportsag hos leverandøren | Versionshistorik | Gate |
| Ejerskab | Hver række i ejerskabstabellen har én navngiven person, og eskaleringskontakten hos leverandøren eller partneren er skrevet ned | Ejerskabstabellen | Gate |
| Compliance | Godkendelse af dataopbevaring, opkaldsoptagelse og compliance foreligger | Underskrevne godkendelser | Gate |
| Overdragelser | Viderestillinger når den rigtige kø på en rigtig telefonlinje, inden for og uden for åbningstid, og medarbejderne ved, hvad opkalderen allerede har sagt | Call History filtreret efter årsag til afbrydelse plus et par opkald aflyttet fra start til slut | Scoret |
| Regressionssuite | Batchens beståelsesrate holdt på tværs af de seneste to ændringer, skrivninger til live systemer er mocket, og fejlede produktionsopkald er nu testtilfælde | Batchtestresultater | Scoret |
| Overvågning | Alarmregler er slået til, hver af dem når en person, der handler, og opkald blev gennemgået hver dag | Alarmindstillinger og noterne fra den daglige gennemgang | Scoret |
| Kapacitet og omkostning | Samtidigheden dækker spidsbelastningstimen ved den næste trafikandel, og omkostningen pr. løst opkald er inden for budgettet | Grænse for samtidige opkald og fakturering. Alle Retell-konti inkluderer 20 samtidige opkald, med flere til $8 pr. samtidigt opkald pr. måned | Scoret |
| Beslutning | Hvornår | Hvad du gør derefter |
|---|---|---|
| Udvid | Alle gate-rækker scorer 2, og totalen overstiger din grænse | Hæv trafikandelen ét trin, og scor igen efter endnu en hel uge |
| Hold og ret | En gate-række scorer 1, eller totalen er under din grænse | Behold trafikandelen, hvor den er, ret på en kladdeversion, kør testsuiten igen, og scor igen næste uge |
| Afgræns på ny | Resultat eller Ingen kritiske fejl scorer stadig 0 efter to rettelsesrunder | Flyt prod-tagget tilbage til den seneste version, der virkede, og indsnævr derefter opkaldstypen eller omdefiner succes, før du tilføjer trafik |
Scor igen ved hvert trin op i trafik, fordi en andel, der fungerede ved en lille del, kan bryde sammen ved en større. Ændringsloop-rækken er den, teams er mest fristet til at springe over, og den afgør, hvor hurtigt agenten forbedres i produktion. Behandl hver prompt-ændring som en ny, testbar version – praksissen kendt som prompt-versionering – så en rettelse, der fejler, kan fortrydes i ét træk.
Dette scorecard er til at flytte en soft launch i produktion på en platform, du allerede har valgt. For at sammenligne leverandører i en pilot skal du bruge go/no-go-listen i guiden til platformevaluering.
Hvad skal du udvide først?
Ændr én ting ad gangen. Hæv trafikandelen først, tilføj derefter en anden opkaldstype og så et andet system. Hver udvidelse genbruger det samme loop: afgræns, byg på en kladde, kør suiten, soft launch, gennemgå. Gør hvert fejlet produktionsopkald til et nyt testtilfælde, så suiten vokser med det, opkalderne faktisk gør. Før du hæver trafikken kraftigt, så kør en belastningstest, der følger den rigtige opkaldsvej.
Start med det rette niveau af hjælp
De første 30 dage går hurtigst, når du på forhånd beslutter, hvor meget hjælp du har brug for. Sammenlign, hvad hver Retell-plan inkluderer, på prissiden, eller find en certificeret partner i Retell-kataloget over løsningspartnere, hvis ingen i dit team kan eje opbygningen.
Ofte stillede spørgsmål
Hvad betyder AI-pilot til produktion?
AI-pilot til produktion er overgangen fra en afprøvning på en del af den rigtige trafik til at køre en AI-agent som standardvejen for en opkaldstype med navngivne ansvarlige, overvågning og en testet måde at rulle tilbage på. Piloten beviser, at agenten kan gennemføre opkaldet. Produktion beviser, at dit team kan holde den kørende.
Hvad skal et proof of concept for stemme-AI indeholde?
Dine sværeste rigtige tilfælde, ringet ind af dine egne medarbejdere mod poster, der ligner dine rigtige; succeskriterier, som begge parter underskriver før det første testopkald; og en skriftlig fordeling af, hvem der betaler for platformforbrug, opbygningstid og medarbejdertid. Hold det til en fast liste over tilfælde og et fast tidsvindue, så det ender i en beslutning.
Kan du teste en stemmeagent uden at sende rigtige kundedata til leverandøren?
Ja. Kopiér i stedet strukturen fra rigtige poster ind i testtilfælde. I simuleringstest i Retell angiver hvert tilfælde sine egne værdier for dynamiske variabler og mockede funktionsresultater. Mock alle funktioner, der når et live system, og giv hver mock et resultat, fordi en tom mock kører den rigtige funktion, og MCP-værktøjer ignorerer mocks. Hvis rigtige data skal flyde, så underskriv aftalerne først: Retell kræver en underskrevet BAA, før beskyttede helbredsoplysninger går gennem platformen. Tjek dine egne regler med din juridiske rådgiver eller dit compliance-team.
Hvor lang tid tager en stemme-AI-pilot før produktion?
For én opkaldstype skal du regne med omkring 30 dage: en uge hver til at afgrænse, bygge og teste og derefter en soft launch på en del af den live trafik. Scor piloten efter mindst én hel uge med live opkald og igen ved hvert trin op i trafik.
Hvordan ved du, at en stemmeagent er klar til produktion?
Når alle gate-rækker på scorecardet scorer 2 over en hel uge med live trafik: succesmetrikken holder, gennemgåede opkald har ingen kritiske fejl, dit team har rettet og rullet en version tilbage uden hjælp fra leverandøren, hver arbejdsstrøm har en navngiven ansvarlig, og compliance-godkendelsen foreligger.
Hvad skal du gøre, hvis piloten ikke lever op til forventningerne?
Hold trafikandelen, eller flyt produktionstagget tilbage til den seneste version, der virkede. Ret på en kladdeversion, kør testsuiten igen, og scor igen efter endnu en uge. Hvis resultat- eller kritisk fejl-rækken stadig scorer 0 efter to rettelsesrunder, så indsnævr opkaldstypen eller omdefiner succes.
See how much your business could save by switching to AI-powered voice agents.
ROI Result
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Et demonummer fra Retell Clinic Office
What results look like with Retell AI


Estimate your monthly voice AI cost
Read Other Blogs
Revolutionér din callcenter-drift med Retell


