GPT-Live-1: come funziona il modello vocale full-duplex di OpenAI nelle chiamate telefoniche




GPT-Live-1 è il modello vocale full-duplex di OpenAI. Ascolta e parla nello stesso momento, gestisce da solo le interruzioni e affida il ragionamento e l'uso degli strumenti a un modello di backend separato. OpenAI lo ha reso disponibile nell'API il 10 settembre 2026, dopo il debutto nella modalità vocale di ChatGPT, ed è disponibile sugli agenti telefonici di Retell AI dal 2 novembre 2026. Questa guida spiega come funziona, quanto costa nell'API, in quali casi è adatto alle chiamate telefoniche e come configurarlo su un agente Retell.
Retell AI pubblica questa guida e offre GPT-Live-1 come uno dei modelli disponibili sulla sua piattaforma di agenti vocali.
GPT-Live-1 in sintesi
| GPT-Live-1 | |
|---|---|
| Sviluppatore | OpenAI |
| ID modello | gpt-live-1 |
| Tipo | Modello vocale full-duplex che delega il ragionamento e l'uso degli strumenti a un modello o agente di backend |
| Input e output | Audio e testo in ingresso, audio e testo in uscita |
| Endpoint API | Live sessions (v1/live/sessions), tramite WebRTC, WebSocket oppure telefonia e SIP |
| Prezzo API | 0,05 $ al minuto di sessione vocale, fatturati al secondo. Il modello di backend e l'uso degli strumenti sono fatturati a parte. |
| Sessioni simultanee | 50 sessioni sul piano Build, 300 su Launch, 500 su Grow. Non disponibile sul piano Free. |
| Finestra di contesto | 128.000 token |
| Versione più recente | GPT-Live-1.1 è stato rilasciato su ChatGPT, Codex e dots il 15 ottobre 2026, con l'annuncio di un prossimo arrivo nell'API. Non ancora presente nell'API al 5 novembre. |
Fonti: pagina del modello GPT-Live-1, guida Live, guida alle conversazioni Live, changelog dell'API e post di lancio di OpenAI; per GPT-Live-1.1, un post sul forum per sviluppatori di OpenAI. Consultate il 5 novembre 2026.
Come funziona il full duplex
La maggior parte degli agenti vocali gestisce i turni in uno di due modi. Un agente a cascata trascrive chi chiama, invia il testo a un modello linguistico e poi trasforma la risposta in voce. Un modello speech-to-speech, come gpt-realtime-2.1 di OpenAI, svolge tutti e tre i passaggi all'interno di un unico modello.
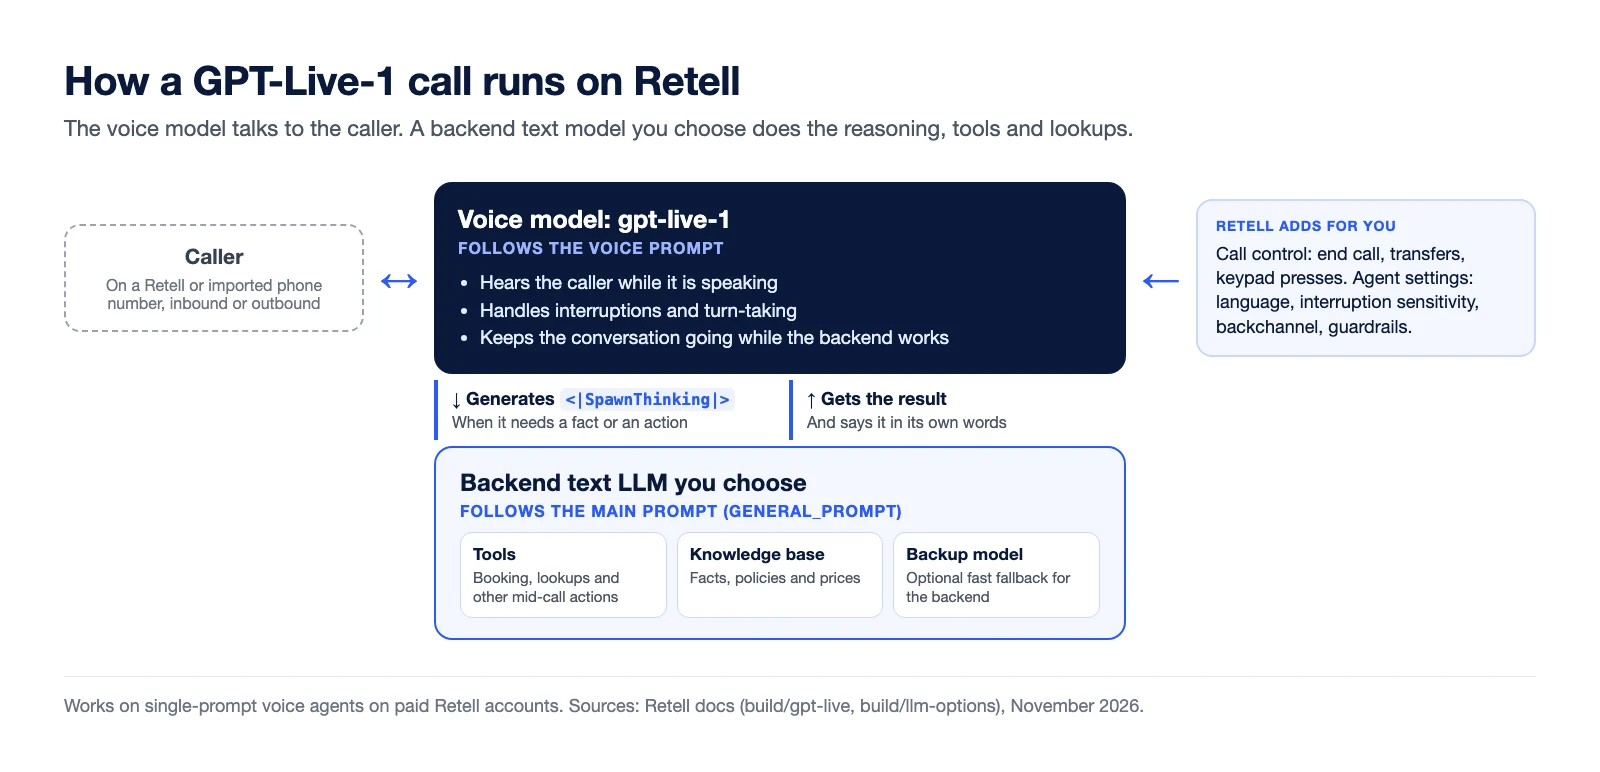
GPT-Live-1 divide il lavoro in modo diverso. Il modello vocale guida la conversazione: sente chi chiama anche mentre parla, gestisce barge-in e pause e decide cosa dire dopo. Quando ha bisogno di un'informazione o di un'azione, richiede lavoro al backend generando un token speciale, <|SpawnThinking|>. Il backend può essere un modello, un agente o un servizio; su Retell è un modello di testo a tua scelta, che esegue gli strumenti e la knowledge base dell'agente. Il backend restituisce il risultato e il modello vocale lo riformula con parole sue. Il lavoro del backend può proseguire anche se chi chiama interrompe.
I dati di OpenAI stessa mostrano i vantaggi di questa divisione. Nei grafici del suo post di lancio nell'API, GPT-Live-1 con GPT-6 Astra come backend, con sforzo di ragionamento medio, supera al primo tentativo l'86,2% dei task vocali di Tau3 (assistenza clienti per compagnie aeree, retail e telecomunicazioni), contro il 45,7% di GPT-Realtime-2.1. Su Full Duplex Bench, OpenAI riporta per GPT-Live-1 una latenza nel passaggio di turno di 0,798 secondi, contro 1,41 secondi per GPT-Realtime-2.1. Si tratta di risultati di OpenAI, non di misurazioni di Retell.
A cascata, speech-to-speech o full duplex?
Retell supporta tutti e tre i modi di far funzionare un agente vocale. Ognuno è adatto a chiamate diverse.
| A cascata | Speech-to-speech | Full duplex (GPT-Live-1) | |
|---|---|---|---|
| Come funziona un turno | Trascrizione, poi un LLM di testo, poi sintesi vocale | Un unico modello ascolta l'audio e risponde in audio | Un modello vocale parla mentre un LLM di testo di backend si occupa di ragionamento e strumenti |
| Esempi su Retell | GPT 5.6 Terra, Claude 5 Sonnet, Gemini 3.5 Flash | gpt-realtime-2.1, grok-voice-3.0 | gpt-live-1 con un LLM di testo di backend |
| Prompt | Uno | Uno | Due: un prompt vocale e il prompt del backend |
| Modello di backup fast-fallback | Supportato | Non supportato | Si applica al modello di backend |
| Ideale per | Flussi di conversazione e logiche rigide in più passaggi | Chiamate rapide e naturali che seguono per lo più un unico prompt | Chiamate naturali che richiedono anche azioni durante la chiamata |
Per l'opzione speech-to-speech di xAI, scopri come far funzionare un agente telefonico con Grok Voice. Per una panoramica più ampia dei modelli, leggi il nostro confronto tra le API di IA speech-to-speech per le chiamate telefoniche.
In quali casi GPT-Live-1 è adatto alle chiamate telefoniche
GPT-Live-1 dà il meglio sugli agenti a prompt singolo che eseguono azioni durante la chiamata, come fissare un appuntamento o cercare un ordine, dove il tempo di risposta di un agente a cascata si nota. Mentre il backend prenota o cerca qualcosa, il modello vocale porta avanti la conversazione invece di fermarsi su una frase di riempimento.
Su Retell ha limiti precisi:
- Solo agenti vocali a prompt singolo. Non è disponibile per flussi di conversazione, agenti multi-prompt, agenti di trasferimento o agenti di chat. Per questi usa un modello a cascata o speech-to-speech.
- Alcuni strumenti non sono supportati. Agent swap, trasferimento assistito (bridged) e annullamento del trasferimento vengono rifiutati al salvataggio. Il trasferimento di chiamata semplice, la chiusura della chiamata e la pressione di tasti funzionano.
- Solo account a pagamento. Come i modelli speech-to-speech, GPT-Live-1 non è incluso nella prova gratuita.
- Nessun cambio per singola chiamata. Un override dell'agente su una singola chiamata non può spostare un agente su GPT-Live-1.
Come configurare GPT-Live-1 su un agente telefonico Retell
GPT-Live-1 si configura tramite l'API di Retell, su un Retell LLM.
- Crea un Retell LLM con model_config impostato sul tipo duplex, gpt-live-1 come modello principale e il modello di testo che preferisci come backend.
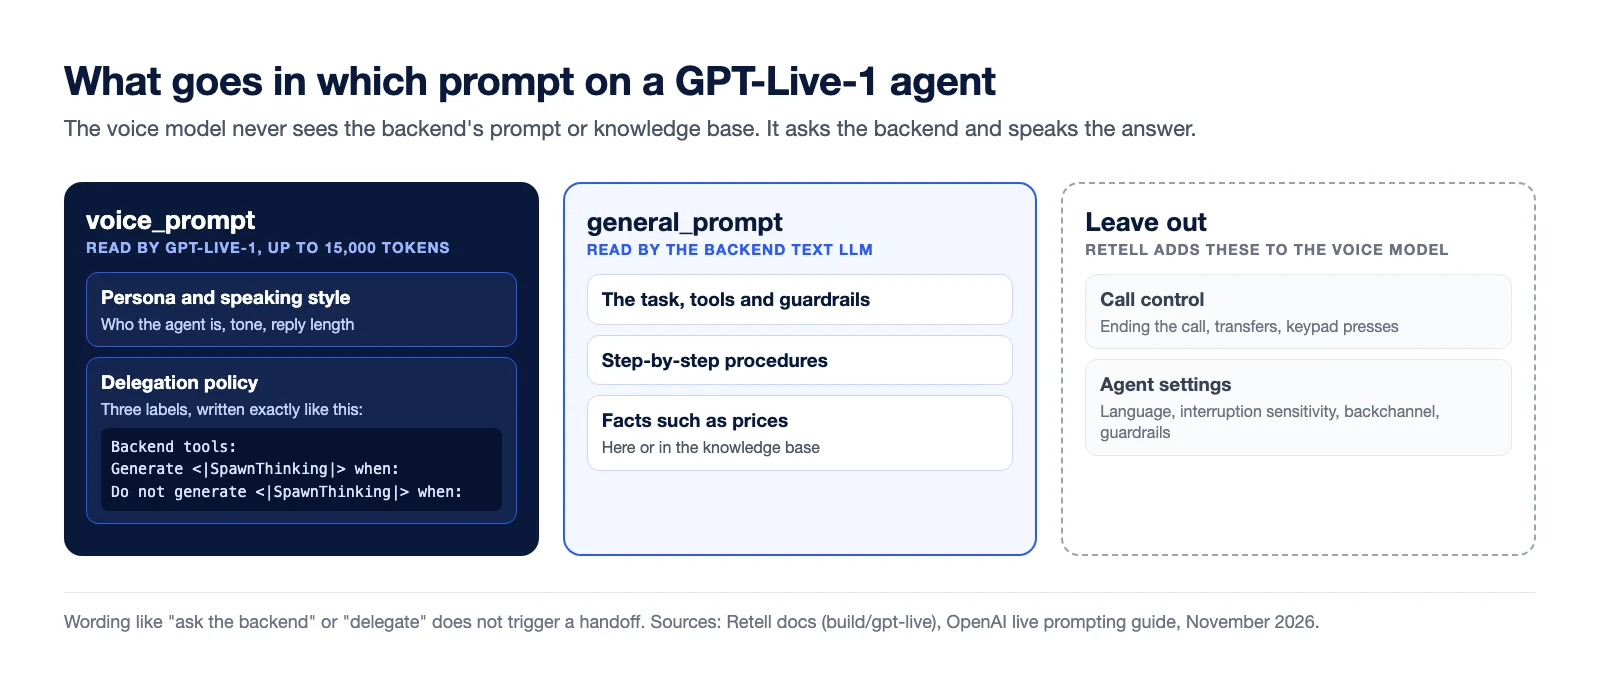
- Scrivi due prompt. general_prompt è il prompt del backend: il compito, gli strumenti e i guardrail. voice_prompt indica al modello vocale come parlare e quando affidare il lavoro al backend. Può arrivare fino a 15.000 token.
- Collega l'LLM a un agente vocale come motore di risposta, come qualsiasi altro Retell LLM.
- Collega un numero di telefono e ricevi chiamate in entrata o effettua chiamate in uscita.
Ecco una richiesta adattata dalla documentazione di Retell, per l'agente di uno studio dentistico:
curl --request POST "https://api.retellai.com/create-retell-llm" \
  --header "Authorization: Bearer $RETELL_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "general_prompt": "You are the backend for a dental clinic phone agent. Collect the caller name and date of birth, then use the booking tool to find and confirm an appointment. Keep names, numbers, and dates exact.",
    "voice_prompt": "You are a warm, efficient front-desk agent for Bright Smile Dental. Keep replies short and natural, and ask one question at a time.\n\nDelegation policy:\nBackend tools:\n- Appointments: find open times and book, change, or cancel appointments.\n\nGenerate <|SpawnThinking|> when:\n- The caller wants to book, change, or cancel an appointment.\n\nDo not generate <|SpawnThinking|> when:\n- You need a brief clarification to understand the request.",
    "model_config": {
      "type": "duplex",
      "primary": { "model": "gpt-live-1" },
      "backend": { "model": "gpt-4.1" }
    }
  }'
Tutti i dettagli sui campi sono nella guida alla configurazione di GPT Live.
Scrivere il prompt vocale
Il prompt vocale è il punto in cui la maggior parte degli agenti GPT-Live-1 sbaglia. Il modello affida il lavoro al backend solo quando genera <|SpawnThinking|>, quindi le regole di passaggio devono usare esattamente quella stringa. Formulazioni come "ask the backend" o "delegate" non attivano il passaggio. Anche la guida al prompting di OpenAI avverte che una promessa pronunciata come "Sto verificando" non significa che il lavoro del backend sia iniziato.
Scrivi il prompt vocale in due parti:
- Persona e stile di conversazione. Chi è l'agente e come parla, ad esempio tono e lunghezza delle risposte.
- Una policy di delega sotto tre etichette, da mantenere esattamente così come sono scritte: "Backend tools:" elenca cosa può fare il backend, una funzionalità per riga. "Generate <|SpawnThinking|> when:" elenca quando passare il lavoro al backend. "Do not generate <|SpawnThinking|> when:" elenca a cosa rispondere direttamente.
Tieni le definizioni degli strumenti, le procedure passo passo e informazioni come i prezzi nel prompt del backend e nella knowledge base. Il modello vocale non le vede: interroga il backend e riformula la risposta con parole sue. Retell aggiunge inoltre per te al modello vocale le istruzioni di controllo della chiamata (chiusura della chiamata, trasferimenti, pressione dei tasti) e le impostazioni dell'agente, quindi non includerle.
Cosa viene mantenuto dalle impostazioni dell'agente
La maggior parte delle impostazioni dell'agente Retell resta valida. Il modello vocale rispetta lingua, sensibilità alle interruzioni, reattività, backchannel, velocità della voce, pronuncia, parole chiave potenziate e guardrail dell'agente. Il rilevamento di segreteria telefonica, IVR, richieste di non essere chiamati e richiamate passa dal backend, e l'impostazione del messaggio di benvenuto continua a decidere chi parla per primo.
Due aspetti funzionano in modo diverso. L'impostazione "parla durante l'esecuzione" di ogni strumento viene ignorata, perché il modello vocale continua a parlare mentre il backend lavora, e l'agente parla sempre dopo che uno strumento ha terminato. Le variabili dinamiche nel prompt vocale vengono compilate una sola volta, all'inizio della chiamata.
Quanto costa GPT-Live-1
Nell'API di OpenAI, una sessione vocale GPT-Live-1 costa 0,05 $ al minuto, fatturati al secondo e senza arrotondamento al minuto successivo. Il modello di backend e i suoi strumenti sono fatturati a parte alle normali tariffe.
Su Retell, il modello vocale è fatturato per minuto di chiamata e l'LLM di testo di backend è fatturato a parte in base al proprio utilizzo. Le tariffe aggiornate sono nella pagina dei prezzi. Un dettaglio conta per le chiamate lunghe: Retell riduce i costi dei modelli durante i lunghi tratti di silenzio, ma i modelli vocali full-duplex vengono comunque fatturati anche in quei tratti.
Domande frequenti
Che cos'è GPT-Live-1?
GPT-Live-1 è il modello vocale full-duplex di OpenAI per le conversazioni in tempo reale. Ascolta e parla nello stesso momento, gestisce le interruzioni e delega il ragionamento e l'uso degli strumenti a un modello o agente di backend a tua scelta.
GPT-Live-1 è disponibile nell'API?
Sì. GPT-Live-1 è diventato disponibile per tutti nell'API di OpenAI il 10 settembre 2026, sull'endpoint Live sessions. GPT-Live-1.1, una versione più recente con più voci e prestazioni migliori nelle lingue diverse dall'inglese, è stato rilasciato su ChatGPT, Codex e dots il 15 ottobre 2026, con l'annuncio di un prossimo arrivo nell'API.
Quanto costa GPT-Live-1?
OpenAI addebita 0,05 $ al minuto per una sessione vocale GPT-Live-1, fatturati al secondo. Il modello di backend e l'uso degli strumenti sono fatturati a parte alle normali tariffe.
GPT-Live-1 può gestire le chiamate telefoniche?
Sì. OpenAI supporta connessioni di telefonia e SIP per le Live sessions. Su Retell, un agente GPT-Live-1 è un agente vocale come tutti gli altri: lo colleghi a un numero di telefono per chiamate in entrata e in uscita, e sia il trasferimento di chiamata semplice sia la pressione di tasti funzionano.
In cosa GPT-Live-1 è diverso da gpt-realtime?
I modelli gpt-realtime sono speech-to-speech: un unico modello ascolta, ragiona, chiama gli strumenti e parla, sulla Realtime API di OpenAI. GPT-Live-1 funziona su un endpoint Live sessions separato, mantiene la voce nel proprio modello e invia ragionamento e strumenti a un backend. OpenAI riporta un tasso di completamento dei task più alto per GPT-Live-1 abbinato a un backend potente e passaggi di turno più rapidi.
GPT-Live-1 funziona con i flussi di conversazione su Retell?
No. Su Retell, GPT-Live-1 funziona solo sugli agenti vocali a prompt singolo. I flussi di conversazione e gli agenti multi-prompt richiedono un modello a cascata o speech-to-speech.
Prova GPT-Live-1 sulle tue chiamate
Se il tuo agente esegue azioni durante la chiamata e le pause ti danno fastidio, vale la pena fare un test pilota con GPT-Live-1. Segui la guida alla configurazione, collega un numero in Retell e confrontalo con il tuo modello attuale su chiamate reali prima di passare.
See how much your business could save by switching to AI-powered voice agents.
ROI Result
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Un numero di telefono demo di Retell Clinic Office
What results look like with Retell AI


Estimate your monthly voice AI cost
Read Other Blogs
Rivoluziona le tue operazioni di chiamata con Retell


