GPT-Live-1: zo werkt het full-duplex stemmodel van OpenAI bij telefoongesprekken




GPT-Live-1 is het full-duplex stemmodel van OpenAI. Het luistert en spreekt tegelijk, handelt onderbrekingen zelf af en laat redeneren en toolgebruik over aan een apart backendmodel. OpenAI bracht het op 10 september 2026 naar de API, nadat het eerst debuteerde in de spraakmodus van ChatGPT, en het is sinds 2 november 2026 beschikbaar op telefoonagents van Retell AI. Deze gids legt uit hoe het werkt, wat het kost in de API, waar het past bij telefoongesprekken en hoe je het instelt op een Retell-agent.
Retell AI publiceert deze gids en biedt GPT-Live-1 aan als een van de modellen op zijn platform voor stemagents.
GPT-Live-1 in één oogopslag
| GPT-Live-1 | |
|---|---|
| Ontwikkelaar | OpenAI |
| Model-ID | gpt-live-1 |
| Type | Full-duplex stemmodel dat redeneren en toolgebruik delegeert aan een backendmodel of -agent |
| Input en output | Audio en tekst in, audio en tekst uit |
| API-endpoint | Live sessions (v1/live/sessions), via WebRTC, WebSockets of telefonie en SIP |
| API-prijs | $0,05 per minuut spraaksessie, per seconde gefactureerd. Backendmodel en toolgebruik worden apart gefactureerd. |
| Gelijktijdigheid | 50 sessies op de Build-tier, 300 op Launch, 500 op Grow. Niet beschikbaar op de Free-tier. |
| Contextvenster | 128.000 tokens |
| Nieuwere versie | GPT-Live-1.1 is op 15 oktober 2026 uitgerold naar ChatGPT, Codex en dots en aangekondigd als binnenkort beschikbaar in de API. Per 5 november nog niet in de API. |
Bronnen: de modelpagina van GPT-Live-1, de Live-gids, de gids voor Live-gesprekken, de API-changelog en de lanceringspost van OpenAI; GPT-Live-1.1 uit een post op het ontwikkelaarsforum van OpenAI. Geraadpleegd op 5 november 2026.
Zo werkt full duplex
De meeste stemagents nemen op een van twee manieren de beurt. Een cascade-agent transcribeert de beller, stuurt de tekst naar een taalmodel en zet het antwoord daarna om in spraak. Een speech-to-speech-model, zoals gpt-realtime-2.1 van OpenAI, doet alle drie de stappen binnen één model.
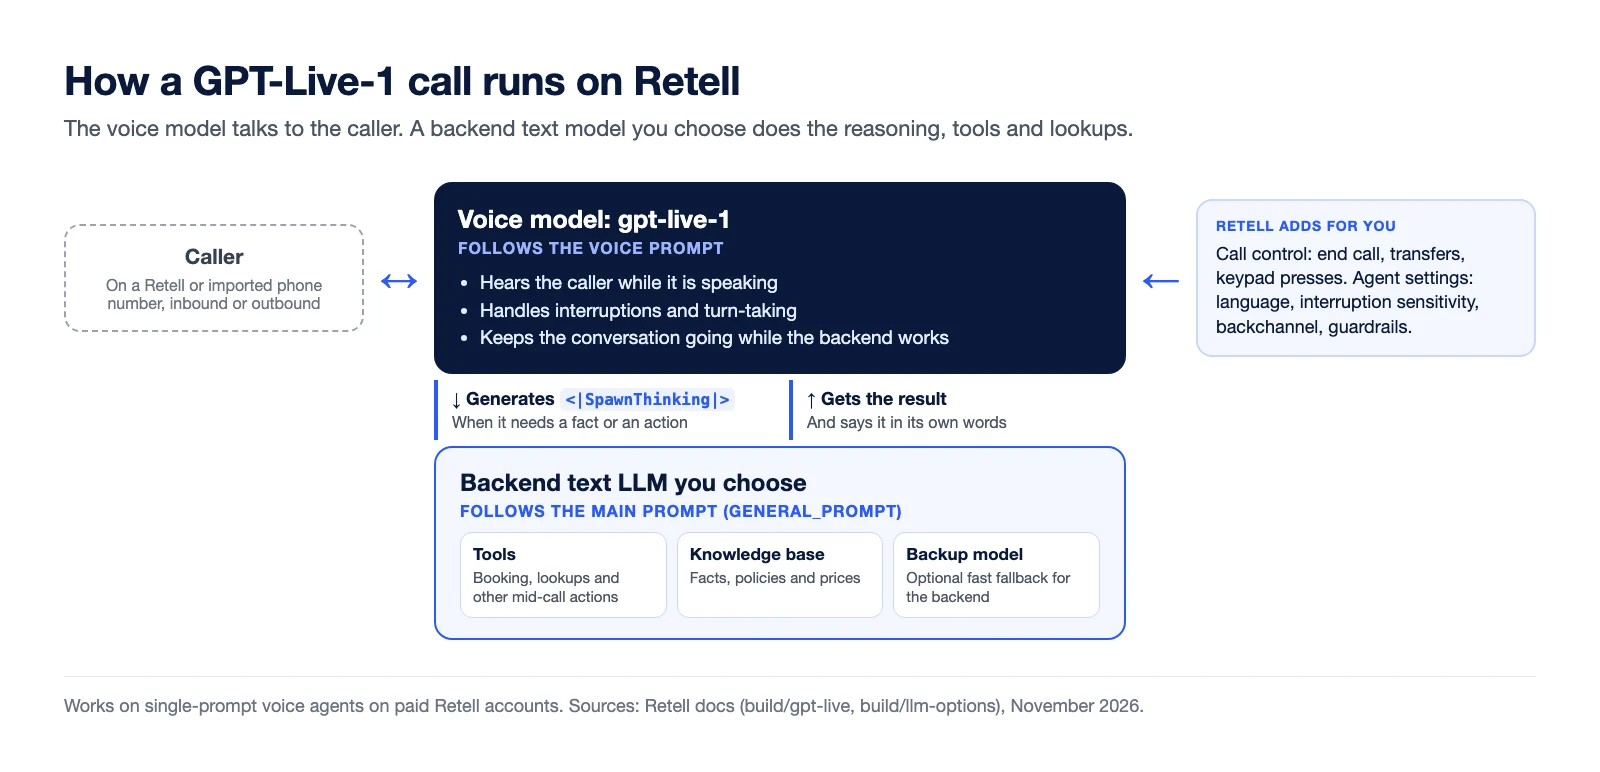
GPT-Live-1 verdeelt het werk anders. Het stemmodel voert het gesprek: het hoort de beller terwijl het zelf praat, handelt barge-in en pauzes af en bepaalt wat het daarna zegt. Heeft het een feit of een actie nodig, dan vraagt het backendwerk aan door een speciaal token te genereren, <|SpawnThinking|>. De backend kan een model, een agent of een service zijn; bij Retell is het een tekstmodel naar keuze dat de tools en de kennisbank van de agent gebruikt. De backend geeft het resultaat terug en het stemmodel verwoordt het in eigen woorden. Backendwerk kan doorlopen als de beller onderbreekt.
De eigen cijfers van OpenAI onderbouwen deze opsplitsing. In de grafieken uit de API-lanceringspost haalt GPT-Live-1 met GPT-6 Astra op gemiddelde redeneerinspanning als backend 86,2% van de Tau3-spraaktaken (klantenservice voor luchtvaart, retail en telecom) bij de eerste poging, tegenover 45,7% voor GPT-Realtime-2.1. Op Full Duplex Bench meldt OpenAI een latency bij beurtwisseling van 0,798 seconde voor GPT-Live-1, tegenover 1,41 seconden voor GPT-Realtime-2.1. Dit zijn resultaten van OpenAI, geen metingen van Retell.
Cascade, speech-to-speech of full duplex?
Retell ondersteunt alle drie de manieren om een stemagent te draaien. Ze passen bij verschillende soorten gesprekken.
| Cascade | Speech-to-speech | Full duplex (GPT-Live-1) | |
|---|---|---|---|
| Hoe een beurt werkt | Transcriptie, dan een tekst-LLM, dan text-to-speech | Eén model hoort audio en antwoordt in audio | Een stemmodel praat terwijl een backend-tekst-LLM het redeneren en de tools doet |
| Voorbeelden op Retell | GPT 5.6 Terra, Claude 5 Sonnet, Gemini 3.5 Flash | gpt-realtime-2.1, grok-voice-3.0 | gpt-live-1 met een backend-tekst-LLM |
| Prompts | Eén | Eén | Twee: een voice prompt en de backendprompt |
| Fast-fallback-back-upmodel | Ondersteund | Niet ondersteund | Geldt voor het backendmodel |
| Het meest geschikt voor | Gespreksflows en strikte logica in meerdere stappen | Snelle, natuurlijke gesprekken die grotendeels één prompt volgen | Natuurlijke gesprekken waarin ook acties worden uitgevoerd tijdens het gesprek |
Voor de speech-to-speech-optie van xAI lees je hoe je een telefoonagent op Grok Voice draait. Voor het bredere aanbod aan modellen kun je onze vergelijking van speech-to-speech-AI-API's voor telefoongesprekken bekijken.
Waar GPT-Live-1 past bij telefoongesprekken
GPT-Live-1 komt het best tot zijn recht bij single-prompt-agents die tijdens het gesprek acties uitvoeren, zoals een afspraak inplannen of een bestelling opzoeken, waarbij de wachttijd van een cascade-agent opvalt. Terwijl de backend iets boekt of opzoekt, houdt het stemmodel het gesprek gaande in plaats van te pauzeren met een opvulzin.
Op Retell heeft het duidelijke beperkingen:
- Alleen single-prompt-stemagents. Het is niet beschikbaar voor gespreksflows, multi-prompt-agents, transfer-agents of chatagents. Gebruik daarvoor een cascade- of speech-to-speech-model.
- Sommige tools worden niet ondersteund. Agent swap, warme (gebridgede) doorverbinding en cancel transfer worden geweigerd bij het opslaan. Een gewone gespreksoverdracht, gesprek beëindigen en toets indrukken werken wel.
- Alleen betaalde accounts. Net als speech-to-speech-modellen maakt GPT-Live-1 geen deel uit van de gratis proefperiode.
- Geen schakeling per gesprek. Met een agent-override op een individueel gesprek kun je een agent niet naar GPT-Live-1 overzetten.
GPT-Live-1 instellen op een Retell-telefoonagent
GPT-Live-1 configureer je via de Retell-API, op een Retell LLM.
- Maak een Retell LLM aan met model_config ingesteld op type duplex, gpt-live-1 als primair model en het gewenste tekstmodel als backend.
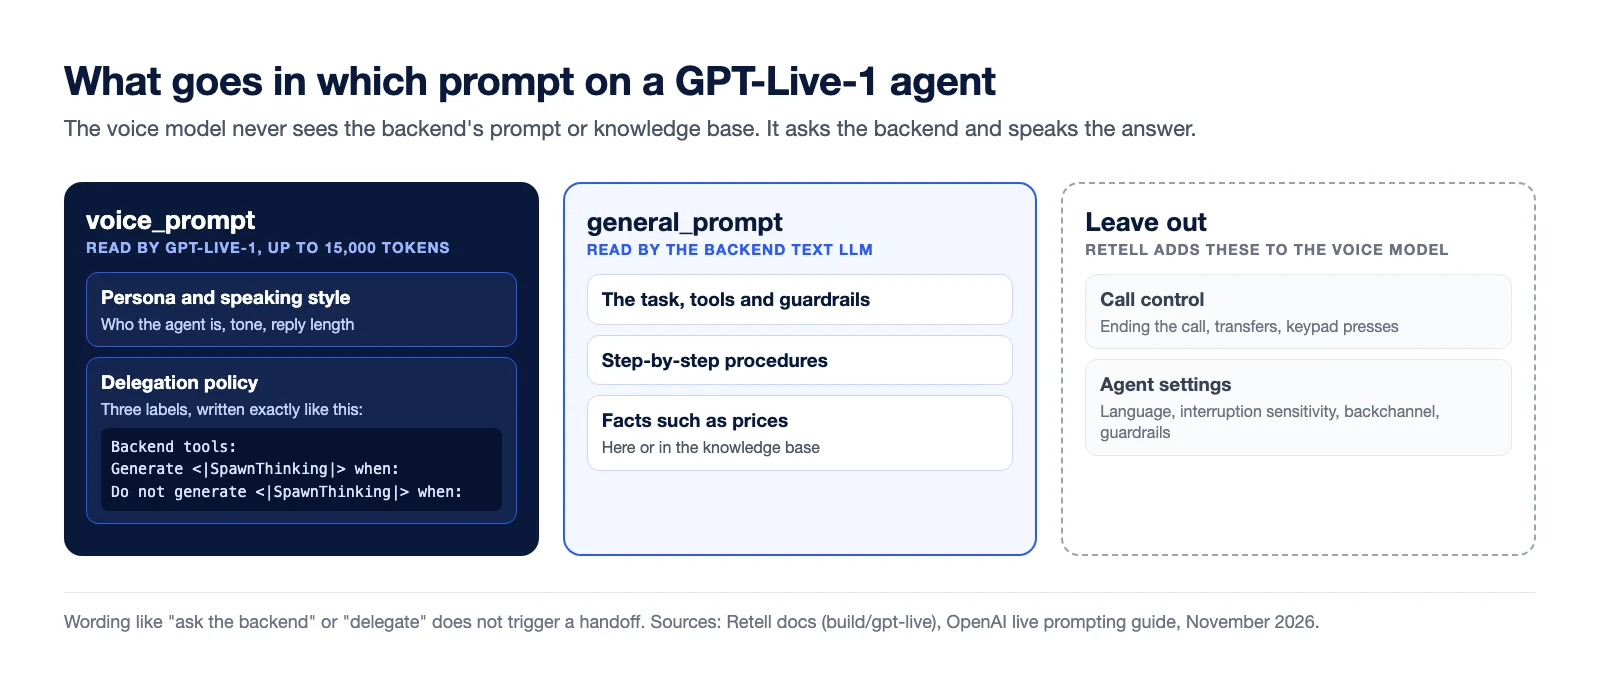
- Schrijf twee prompts. general_prompt is de prompt van de backend: de taak, tools en guardrails. voice_prompt vertelt het stemmodel hoe het moet praten en wanneer het werk aan de backend moet doorgeven. Deze mag maximaal 15.000 tokens lang zijn.
- Koppel de LLM aan een stemagent als response engine, net als elke andere Retell LLM.
- Koppel een telefoonnummer en neem inkomende gesprekken aan of voer uitgaande gesprekken.
Hier is een request, aangepast uit de documentatie van Retell, voor een agent van een tandartspraktijk:
curl --request POST "https://api.retellai.com/create-retell-llm" \
  --header "Authorization: Bearer $RETELL_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "general_prompt": "You are the backend for a dental clinic phone agent. Collect the caller name and date of birth, then use the booking tool to find and confirm an appointment. Keep names, numbers, and dates exact.",
    "voice_prompt": "You are a warm, efficient front-desk agent for Bright Smile Dental. Keep replies short and natural, and ask one question at a time.\n\nDelegation policy:\nBackend tools:\n- Appointments: find open times and book, change, or cancel appointments.\n\nGenerate <|SpawnThinking|> when:\n- The caller wants to book, change, or cancel an appointment.\n\nDo not generate <|SpawnThinking|> when:\n- You need a brief clarification to understand the request.",
    "model_config": {
      "type": "duplex",
      "primary": { "model": "gpt-live-1" },
      "backend": { "model": "gpt-4.1" }
    }
  }'
Alle details over de velden vind je in de installatiegids voor GPT Live.
De voice prompt schrijven
Bij de voice prompt gaat het bij de meeste GPT-Live-1-agents mis. Het model geeft alleen werk door aan de backend als het <|SpawnThinking|> genereert, dus de overdrachtsregels moeten precies die term gebruiken. Formuleringen als "vraag het aan de backend" of "delegeer" leiden niet tot een overdracht. De promptinggids van OpenAI waarschuwt ook dat een uitgesproken belofte als "Ik zoek het even voor je op" niet betekent dat het backendwerk is gestart.
Schrijf de voice prompt in twee delen:
- Persona en spreekstijl. Wie de agent is en hoe hij praat, zoals toon en lengte van de antwoorden.
- Een delegatiebeleid onder drie labels, precies zoals ze geschreven zijn: "Backend tools:" somt op wat de backend kan, één capaciteit per regel. "Generate <|SpawnThinking|> when:" somt op wanneer er moet worden doorgegeven. "Do not generate <|SpawnThinking|> when:" somt op wat direct beantwoord moet worden.
Zet tooldefinities, stapsgewijze procedures en feiten zoals prijzen in de backendprompt en de kennisbank. Het stemmodel ziet die niet; het vraagt de backend en verwoordt het antwoord in eigen woorden. Retell voegt ook instructies voor gespreksbesturing (het gesprek beëindigen, doorverbinden, toetsaanslagen) en de instellingen van de agent automatisch toe aan het stemmodel, dus die laat je weg.
Wat er wordt overgenomen uit je agentinstellingen
De meeste agentinstellingen van Retell blijven gelden. Het stemmodel respecteert de taal, gevoeligheid voor onderbrekingen, reactiesnelheid, backchannel, spreeksnelheid, uitspraak, boosted keywords en guardrails van de agent. Detectie van voicemail, IVR, do-not-call en terugbelverzoeken loopt via de backend, en de instelling voor het welkomstbericht bepaalt nog steeds wie als eerste spreekt.
Twee dingen werken anders. De instelling "speak during execution" van elke tool wordt genegeerd, omdat het stemmodel blijft praten terwijl de backend bezig is, en de agent spreekt altijd nadat een tool klaar is. Dynamische variabelen in de voice prompt worden één keer ingevuld, bij de start van het gesprek.
Wat GPT-Live-1 kost
In de API van OpenAI kost een GPT-Live-1-spraaksessie $0,05 per minuut, per seconde gefactureerd en niet naar boven afgerond op de volgende minuut. Het backendmodel en de bijbehorende tools worden apart gefactureerd tegen hun normale tarieven.
Bij Retell wordt het stemmodel per gespreksminuut gefactureerd en de backend-tekst-LLM apart voor zijn eigen gebruik. De actuele tarieven vind je op de prijzenpagina. Eén detail is belangrijk bij lange gesprekken: Retell verlaagt de modelkosten tijdens lange stiltes, maar full-duplex stemmodellen worden ook tijdens die stiltes gefactureerd.
Veelgestelde vragen
Wat is GPT-Live-1?
GPT-Live-1 is het full-duplex stemmodel van OpenAI voor realtime gesprekken. Het luistert en spreekt tegelijk, handelt onderbrekingen af en delegeert redeneren en toolgebruik aan een backendmodel of -agent naar keuze.
Is GPT-Live-1 beschikbaar in de API?
Ja. GPT-Live-1 is sinds 10 september 2026 algemeen beschikbaar in de API van OpenAI, op het endpoint Live sessions. GPT-Live-1.1, een nieuwere versie met meer stemmen en betere prestaties in andere talen dan Engels, is op 15 oktober 2026 uitgerold naar ChatGPT, Codex en dots en aangekondigd als binnenkort beschikbaar in de API.
Wat kost GPT-Live-1?
OpenAI rekent $0,05 per minuut voor een GPT-Live-1-spraaksessie, per seconde gefactureerd. Het backendmodel en toolgebruik worden apart gefactureerd tegen hun normale tarieven.
Kan GPT-Live-1 telefoongesprekken afhandelen?
Ja. OpenAI ondersteunt telefonie- en SIP-verbindingen voor Live sessions. Op Retell is een GPT-Live-1-agent een stemagent zoals elke andere, dus je koppelt hem aan een telefoonnummer voor inkomende en uitgaande gesprekken, en een gewone gespreksoverdracht en toets indrukken werken allebei.
Waarin verschilt GPT-Live-1 van gpt-realtime?
gpt-realtime-modellen zijn speech-to-speech: één model luistert, redeneert, roept tools aan en spreekt, via de Realtime API van OpenAI. GPT-Live-1 draait op een apart endpoint voor Live sessions, houdt de stem in een eigen model en stuurt redeneren en tools naar een backend. OpenAI meldt een hogere taakvoltooiing voor GPT-Live-1 in combinatie met een sterke backend, en een snellere beurtwisseling.
Werkt GPT-Live-1 met gespreksflows op Retell?
Nee. Op Retell werkt GPT-Live-1 alleen op single-prompt-stemagents. Gespreksflows en multi-prompt-agents hebben een cascade- of speech-to-speech-model nodig.
Probeer GPT-Live-1 op je eigen gesprekken
Voert je agent acties uit tijdens het gesprek en storen de pauzes je, dan is GPT-Live-1 een pilot waard. Volg de installatiegids, koppel een nummer in Retell en vergelijk het met je huidige model op echte gesprekken voordat je overstapt.
See how much your business could save by switching to AI-powered voice agents.
ROI Result
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Een demodemonummer van Retell Clinic Office
What results look like with Retell AI


Estimate your monthly voice AI cost
Read Other Blogs
Revolutioneer je belactiviteiten met Retell


