Waar productteams op letten bij een voice-AI-platform




Een voice-AI-platform is de software waarmee een productteam AI-stemagenten bouwt, koppelt, test en draait voor telefoon- en webgesprekken. Product- en engineeringleads kiezen zelden een platform op basis van een demo. Ze bouwen dezelfde agent op elk platform op hun shortlist en controleren zelf vier dingen: hoe snel de eerste werkende agent staat, hoe ver de API- en workflowtools gaan, hoe lang bellers op een antwoord wachten en wat er verandert wanneer een pilot productieverkeer wordt.
Deze gids is een plan voor die praktische vergelijking. Retell AI publiceert deze gids en is een van de platforms die productteams vergelijken, naast Vapi, ElevenLabs en Bland. Wat we over de andere drie zeggen, komt uit de eigen documentatie van elke leverancier, gelezen op 10 november 2026 en gelinkt. Voor deze gids hebben we geen testgesprekken gevoerd, dus er zijn geen scores en geen ranking. Wat we over Retell zeggen, komt uit de openbare documentatie van Retell, inclusief de limieten die daarin staan.
Wat controleert een productteam dat een demo niet laat zien?
Een demo laat één goed gesprek zien. Een praktische vergelijking laat zien wat je eigen engineers kunnen bouwen, koppelen en meten. Geef één engineer op elk platform hetzelfde type gesprek, een echt gesprek zoals afspraken inplannen via je planning-API, en noteer op elk platform dezelfde vier resultaten.
| Wat je controleert | Wat je team doet | Wat je noteert |
|---|---|---|
| Bouwgemak | Bouw de agent van een leeg account tot een eerste gesprek, zonder hulp van de leverancier | Aantal uren tot een eerste werkend gesprek, en elk punt waarop je vastliep |
| Diepgang van API en workflows | Roep tijdens een gesprek je eigen API aan, ontvang gesprekevents, maak de agent aan vanuit code | Welke stappen een workaround nodig hadden |
| Responslatency | Voer minstens 20 gesprekken en haal per beurt de timing op | Mediaan en 95e percentiel, met de definitie die de leverancier hanteert |
| Van pilot naar opschalen | Lees de limieten, het gedrag bij storingen en de opties voor releasebeheer voordat je ze nodig hebt | Standaardlimieten, wat er gebeurt als je ze bereikt, en wat de kosten bepaalt |
Hoe snel kan je team de eerste werkende agent bouwen?
Meet de tijd van een leeg account tot een gesprek dat je engineer aan een collega zou laten zien, en noteer elk punt waarop de leverancier om hulp gevraagd moest worden. Een antwoord dat in de documentatie te vinden is, telt als selfservice.
Op de meeste platforms bepalen twee dingen die tijd. Het eerste is hoeveel structuur je moet ontwerpen voordat de agent kan praten. De documentatie van Retell raadt aan om te beginnen met een single prompt-agent en pas over te stappen op een conversation flow, die de taak opsplitst in nodes met eigen instructies, wanneer één prompt niet meer aan je eisen kan voldoen. Dezelfde pagina is duidelijk over de afweging: "Een conversation flow is niet automatisch betrouwbaarder."
Het tweede is hoe snel je de agent kunt horen en zijn fouten kunt opsporen. Het testoverzicht van Retell noemt vier methoden: tekstchat in de LLM Playground, opgeslagen simulatietestcases, browsergesprekken "zonder telefoonnummer" en echte telefoongesprekken. Reken op kosten voor de testgesprekken. Bij Retell wordt testen gefactureerd tegen dezelfde tarieven als productie. Voor een volledige walkthrough van een eerste build, zie hoe je een AI-stemagent bouwt.
Bouwgemak hangt ook af van wat het platform voor je draait. Volgens de documentatie van Retell "draait het de telefonie-, spraak- en taalmodellagen, zodat je de agent configureert in plaats van providers te koppelen." Je team is eigenaar van het gedrag van de agent zonder de onderliggende infrastructuur te onderhouden. Of die afweging bij je past, is een aparte beslissing, besproken in bouwen of kopen bij AI-stemagenten.
Hoe diep gaan de API- en workflowtools?
Diep genoeg betekent twee dingen: je engineers kunnen vanuit code doen wat ze in het dashboard deden, en de agent kan tijdens een gesprek je systemen bereiken zonder middlewareproject. Controleer op elk platform vijf gebieden.
- SDK's en API-dekking. Vraag of elke actie in het dashboard een endpoint heeft. Retell publiceert officiële SDK's voor Node.js en Python, beschreven als getypeerde clients met volledige dekking van de voice- en chat-endpoints.
- Je API aanroepen tijdens een gesprek. Een custom function van Retell stuurt een GET-, POST-, PUT-, PATCH- of DELETE-request naar je endpoint en wacht op het antwoord. De timeout is 1 tot 600 seconden, standaard 120. Requests worden niet opnieuw geprobeerd, tenzij je een aantal retries instelt. Vraag elke leverancier wat de beller hoort terwijl een trage request loopt.
- Gesprekevents. Webhooks van Retell sturen call_started-, call_ended- en call_analyzed-events naar je server. Elk heeft een timeout van 10 seconden en wordt maximaal 3 keer opnieuw geprobeerd. Met een signature-header kun je de afzender verifiëren.
- MCP in beide richtingen. Een Retell-agent kan tijdens een live gesprek de tools van een externe MCP-server aanroepen. Met de eigen MCP-server van Retell kunnen clients zoals Cursor en Claude Code agents bouwen en beheren via de API.
- Je eigen model en je eigen carrier. Met een Custom LLM handelt Retell het gesprek af en opent het per gesprek een WebSocket naar je server. De documentatie raadt voor de meeste agents de ingebouwde agenttypes aan en zegt dat je met een custom LLM zelf verantwoordelijk bent voor latency, uptime en het afhandelen van herverbindingen. Voor telefoonlijnen verbindt custom telephony via elastic SIP-trunking of door een SIP-URI te bellen.
Controleer ook kant-en-klare koppelingen. Het integratieoverzicht van Retell noemt 11 providers voor CRM, support, agenda en kennisbank. Alles daarbuiten loopt via een custom function, MCP of een webhook.
Hoe meet je responslatency?
Meet het op je eigen gesprekken, beurt voor beurt, en rapporteer percentielen met de definitie erbij. Een latencycijfer zonder begin- en eindpunt kun je niet vergelijken met het cijfer van een andere leverancier.
De documentatie van Retell definieert end-to-end latency als de tijd vanaf het moment dat de gebruiker stopt met praten tot het moment dat de agent begint te antwoorden. Volgens die definitie stelt de documentatie dat het platform "een latency van slechts 600ms haalt." Lees "van slechts" als een ondergrens. Jouw cijfer hangt af van het model, de prompt en de instellingen die je kiest.
Haal je eigen cijfers per gesprek op. De Get Call API van Retell geeft een latency-object terug met het 50e, 90e, 95e en 99e percentiel voor het end-to-end cijfer en voor transcriptie, de LLM, text-to-speech en het ophalen uit de kennisbank. Dezelfde pagina noemt een beperking: het end-to-end cijfer omvat niet het netwerktraject van de server van Retell naar het apparaat van de gebruiker. Meet bij web- en in-app-gesprekken de reactietijd daarom ook aan de clientzijde.
Als een cijfer hoog is, kijk dan eerst naar de configuratie voordat je het platform de schuld geeft. De gids voor het oplossen van latencyproblemen van Retell noemt de keuze van het LLM-model en de promptlengte als de twee meest voorkomende oorzaken, zegt dat prompts boven ongeveer 8.000 tokens merkbaar trager worden en adviseert de geschatte latency onder 1,5 seconde te houden. Vraag elke leverancier om dezelfde uitsplitsing per component.
Snelheid is één factor voor een goed gesprek. Voice-AI-latency: oorzaken, meting en impact op bellers legt uit waar de vertraging vandaan komt en wanneer een sneller antwoord een gesprek juist slechter maakt. Voor gepubliceerde benchmarkresultaten van deze vier platforms, zie Retell AI vs Bland AI vs Vapi vs ElevenLabs.
Wat verandert er tussen een pilot en productie op schaal?
Drie dingen veranderen: de limieten waar je tegenaan loopt, wat bellers ervaren als er iets misgaat en hoe wijzigingen live gesprekken bereiken. Lees de antwoorden van elke leverancier voordat de pilot afloopt.
- Concurrency. Vraag naar de standaardlimiet en wat er bij die limiet gebeurt. Bij Retell krijgt een workspace met betalen naar gebruik standaard 20 gelijktijdige gesprekken, en je kunt de limiet verhogen vanuit het dashboard. Bij de limiet wacht een nieuw inkomend gesprek op een vrije plek. Na ongeveer 40 seconden wordt het doorgeschakeld naar een fallbacknummer als je dat hebt ingesteld; anders wordt het gesprek beëindigd. Een uitgaand gesprek boven de limiet wordt geweigerd, tenzij je concurrency burst inschakelt, wat een toeslag per minuut met zich meebrengt.
- Uptime en fallbacks. Het betrouwbaarheidsoverzicht van Retell vermeldt een garantie van meer dan 99,9% uptime en linkt naar een openbare statuspagina. Het noemt LLM-fallback en retries als ingebouwd, plus een Backup-modus die nieuwe inkomende gesprekken naar een fallbacknummer omleidt terwijl je een probleem onderzoekt.
- Releasebeheer. Versies, staging-tags, batchruns vanuit je CI-pipeline en procentuele verkeerssplitsingen bepalen hoe veilig een wijziging live gaat. Daar is een aparte gids over: de lat bij het kopen van voice-AI.
- Securityreview. Begin daar al tijdens de pilot mee. Volgens de pagina over beveiliging en compliance van Retell is het platform HIPAA-compliant, AVG/GDPR-compliant en gecertificeerd voor SOC 2 Type 1 en Type 2, en biedt het een self-service BAA.
- Kostenfactoren. De prijzen van Retell zijn gebaseerd op gebruik, vanaf $0,07 per minuut op de prijspagina. Het tarief hangt af van de stem, het model en de telefonie die je kiest, en sommige latency-opties kosten meer dan het standaardtarief van het model. Hoe prijzen op basis van gebruik werken legt de onderdelen uit.
Voor het opzetten van een pilot behandelt hoe je een voice-agentplatform evalueert voordat je live gaat welke gesprekken je meeneemt en wat je meet, en van voice-AI-demo naar productie behandelt de eerste 30 dagen.
Hoe omschrijven Vapi, ElevenLabs, Bland en Retell zichzelf?
De documentatie van elke leverancier beschrijft een platform voor het bouwen, uitrollen en monitoren van voice-agents, met een promptgebaseerde manier om te starten en een meer gestructureerde optie. De tabel citeert de eigen documentatie van elke leverancier, gelezen op 10 november 2026.
| Platform | Hoe de eigen documentatie het omschrijft | Bouwopties die de documentatie noemt |
|---|---|---|
| Retell AI | "Een platform om AI-spraak- en chatagents te bouwen, testen, uitrollen en monitoren, met ingebouwde telefonie, prompts, tools en analytics" (documentatie van Retell) | Single prompt-agents en conversation flow-agents |
| Vapi | "Het developerplatform voor het bouwen van voice-AI-agents" (documentatie van Vapi) | Assistants, die één systeemprompt plus tools en gestructureerde outputs gebruiken, en Squads, die meerdere assistants draaien met overdrachten waarbij de context behouden blijft. Je kiest zelf de providers voor speech-to-text, LLM en text-to-speech |
| ElevenLabs | ElevenAgents biedt "stemrijke, expressieve modellen, developertools voor het bouwen van multimodale agents en tools om agentprestaties op schaal te monitoren en te evalueren" (documentatie van ElevenLabs) | Een developertoolkit, een dashboard of een visuele workflowbuilder, met SDK's voor React, Swift, Kotlin, React Native en Unity |
| Bland | "Alles wat je nodig hebt om voice-AI-agents in Bland te bouwen, monitoren en verbeteren" (documentatie van Bland) | Een agent builder waarin "de meeste agents beginnen als één prompt" en pathways structuur toevoegen waar het gesprek dat nodig heeft |
De omschrijvingen liggen dicht bij elkaar, dus door ze te lezen maak je de keuze nog niet. De vier checks draaien op jouw type gesprek en jouw systemen. Voor gedetailleerde vergelijkingen naast elkaar publiceert Retell vergelijkingen met Vapi, ElevenLabs en Bland, en een gids over alternatieven voor Vapi.
Hoe voer je de vergelijking eerlijk uit?
Houd alles constant behalve het platform. Gebruik één type gesprek, één engineer, één script voor bellergedrag en één scorekaart, en vul voor elke leverancier dezelfde velden in.
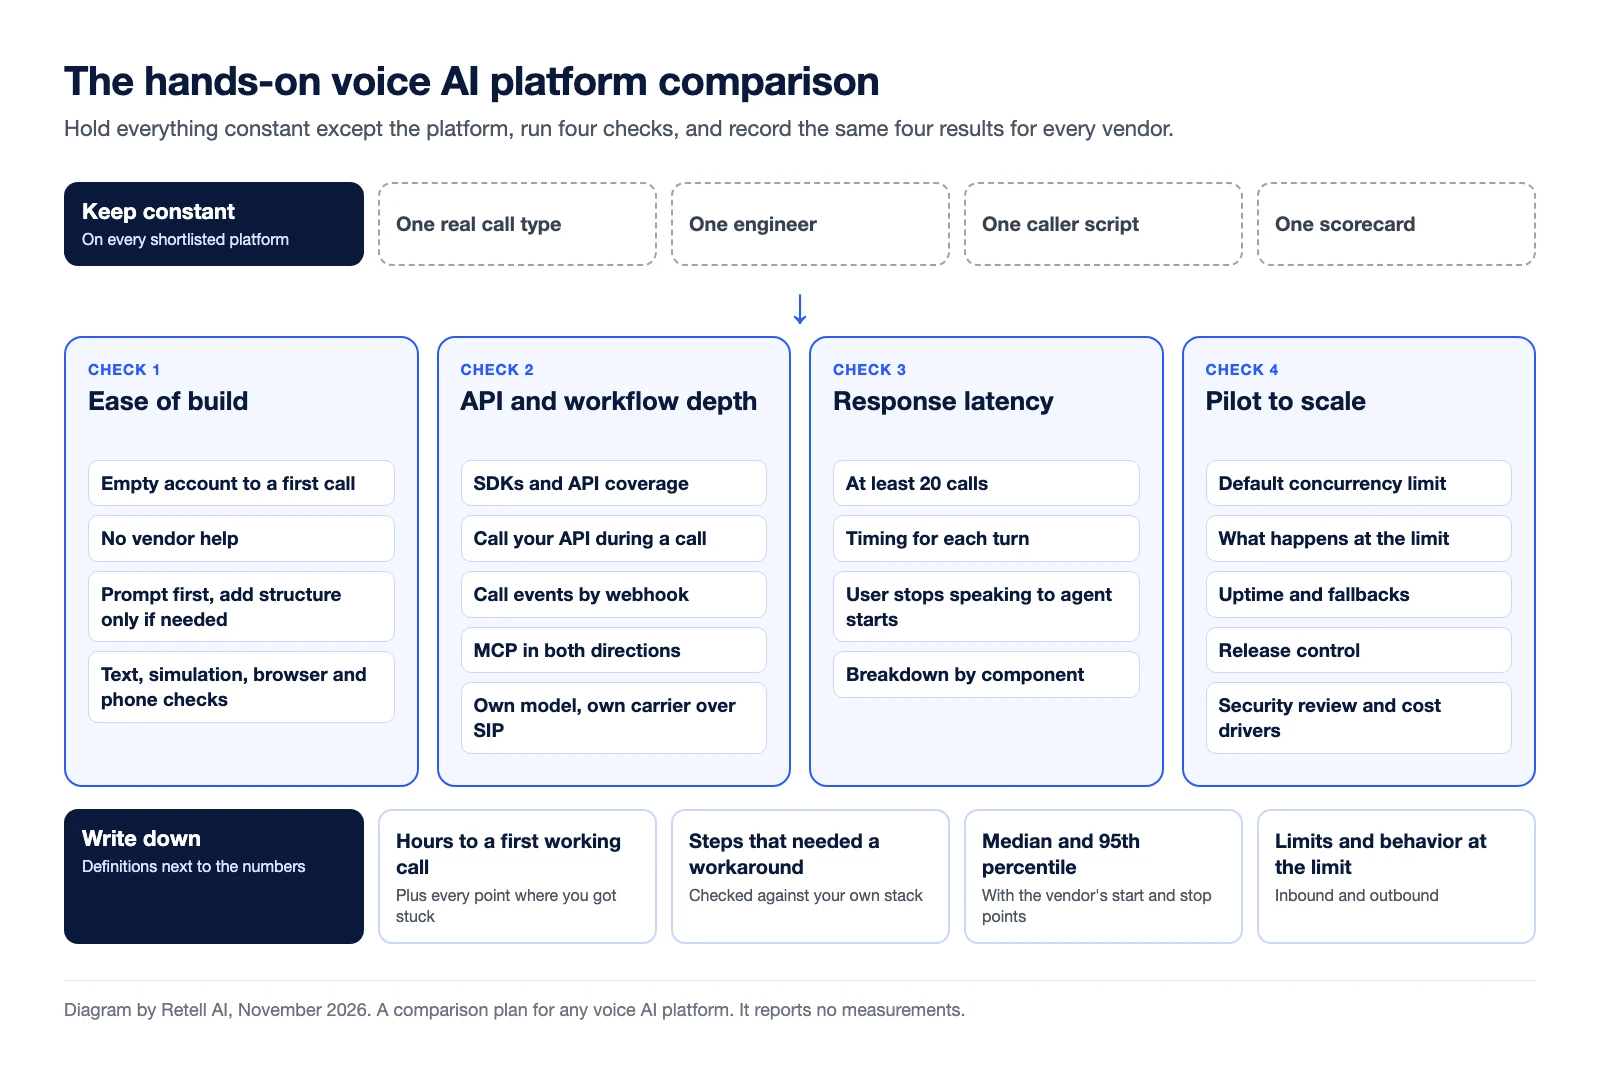
Schrijf het bellerscript voordat iemand gaat bouwen. Neem een onderbreking op, een correctie, een vraag die de agent moet weigeren en één verzoek waarvoor je API nodig is. Vergelijk daarna de vier resultaten naast elkaar, met de definities van elke leverancier naast de cijfers.
Na de keuze moet iemand eigenaar worden van de agent. Veel teams geven die taak aan een CX-engineer, ook wel CX-automation-engineer of internal deployed engineer genoemd: de interne eigenaar die slecht afgehandelde gesprekken opspoort, oplossingen bouwt, controleert en uitrolt. Heb je die persoon al, betrek hem of haar dan bij de vergelijking. Wat de executive sponsor nodig heeft van het platform en de leverancier, lees je in wat CX-leiders nodig hebben van AI-stemagenten.
Veelgestelde vragen
Waar moet een productteam op letten bij een voice-AI-platform?
Vier dingen, allemaal in de praktijk gecontroleerd: hoe snel je eigen engineer een eerste werkende agent kan bouwen, hoe ver de API, webhooks en workflowtools gaan, hoe lang bellers bij je eigen gesprekken op een antwoord wachten, en hoe de limieten en het gedrag bij storingen eruitzien bij productievolume. Voer dezelfde checks uit op elk platform op je shortlist.
Hoe vergelijk je voice-AI-platforms in de praktijk?
Kies één echt type gesprek, laat één engineer op elk platform dezelfde agent bouwen en voer op elk platform dezelfde gescripte gesprekken. Noteer het aantal uren tot een eerste werkend gesprek, de stappen die een workaround nodig hadden, de responstijd voor de mediaan en het 95e percentiel, en de standaardlimieten. Houd de definities van elke leverancier naast de cijfers.
Wat is een goede responslatency voor een AI-stemagent?
Dat hangt af van het model, de prompt en de instellingen, dus meet het op je eigen gesprekken. De documentatie van Retell noemt een latency van slechts 600ms, gemeten vanaf het moment dat de gebruiker stopt met praten tot het moment dat de agent begint te antwoorden, en adviseert de geschatte latency onder 1,5 seconde te houden. Vergelijk percentielen tussen leveranciers alleen als de begin- en eindpunten overeenkomen.
Heb je engineers nodig om een AI-stemagent te bouwen?
Niet voor een eerste agent. De quickstart van Retell gaat in het dashboard van een template naar een telefoongesprek. Engineers komen erbij wanneer de agent tijdens een gesprek je API moet aanroepen, gesprekevents naar je systemen moet sturen of via SIP moet koppelen met je eigen telefoniecarrier. Dat zijn de onderdelen die een productteam tijdens de vergelijking zou moeten bouwen.
Hoeveel gelijktijdige gesprekken kan een voice-AI-platform aan?
Dat hangt af van het abonnement en de leverancier. Bij Retell krijgt een workspace met betalen naar gebruik standaard 20 gelijktijdige gesprekken, en de limiet kan vanuit het dashboard worden verhoogd. Vraag elke leverancier wat er met een inkomend en een uitgaand gesprek gebeurt zodra de limiet is bereikt.
Voer de vier checks uit op je eigen gesprekken
Retell is een platform voor AI-stemagenten voor contactcenters, met single prompt- en conversation flow-agents, getypeerde SDK's, custom functions, webhooks, MCP, custom telephony en latencydata per gesprek. Meer dan 4.000 klanten voeren maandelijks meer dan 100 miljoen gesprekken via Retell, dat in november 2026 een geannualiseerde run rate van $100M bereikte. De prijzen zijn gebaseerd op gebruik, vanaf $0,07 per minuut op de prijspagina. Bouw dezelfde agent die je elders bouwde, laat hem draaien op je eigen gesprekken en vergelijk de cijfers voordat je iets tekent.
See how much your business could save by switching to AI-powered voice agents.
ROI Result
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Estimate your monthly voice AI cost
Revolutioneer je belactiviteiten met Retell


