GPT-Live-1: Så fungerar OpenAI:s full-duplex-röstmodell i telefonsamtal




GPT-Live-1 är OpenAI:s full-duplex-röstmodell. Den lyssnar och talar samtidigt, hanterar avbrott själv och lämnar över resonemang och verktygsanvändning till en separat backend-modell. OpenAI lanserade den i API:et den 10 september 2026, efter att den debuterat i ChatGPT:s röstläge, och den har varit tillgänglig på Retell AI:s telefonagenter sedan den 2 november 2026. Den här guiden går igenom hur den fungerar, vad den kostar i API:et, var den passar i telefonsamtal och hur du konfigurerar den på en Retell-agent.
Retell AI publicerar den här guiden och erbjuder GPT-Live-1 som en av modellerna på sin plattform för röstagenter.
GPT-Live-1 i korthet
| GPT-Live-1 | |
|---|---|
| Utvecklare | OpenAI |
| Modell-ID | gpt-live-1 |
| Typ | Full-duplex-röstmodell som delegerar resonemang och verktygsanvändning till en backend-modell eller agent |
| Indata och utdata | Ljud och text in, ljud och text ut |
| API-endpoint | Live-sessioner (v1/live/sessions), via WebRTC, WebSockets eller telefoni och SIP |
| API-pris | 0,05 $ per minut röstsession, debiteras per sekund. Backend-modell och verktygsanvändning debiteras separat. |
| Samtidighet | 50 sessioner på Build-nivån, 300 på Launch, 500 på Grow. Inte tillgänglig på Free-nivån. |
| Kontextfönster | 128 000 tokens |
| Nyare version | GPT-Live-1.1 rullades ut i ChatGPT, Codex och dots den 15 oktober 2026 och aviserades som snart tillgänglig i API:et. Inte i API:et per den 5 november. |
Källor: OpenAI:s modellsida för GPT-Live-1, Live-guide, guide för Live-konversationer, API-ändringslogg och lanseringsinlägg; GPT-Live-1.1 från ett inlägg på OpenAI:s utvecklarforum. Lästa den 5 november 2026.
Så fungerar full duplex
De flesta röstagenter turas om på ett av två sätt. En kaskadagent transkriberar den som ringer, skickar texten till en språkmodell och omvandlar sedan svaret till tal. En tal-till-tal-modell, till exempel OpenAI:s gpt-realtime-2.1, gör alla tre stegen i en och samma modell.
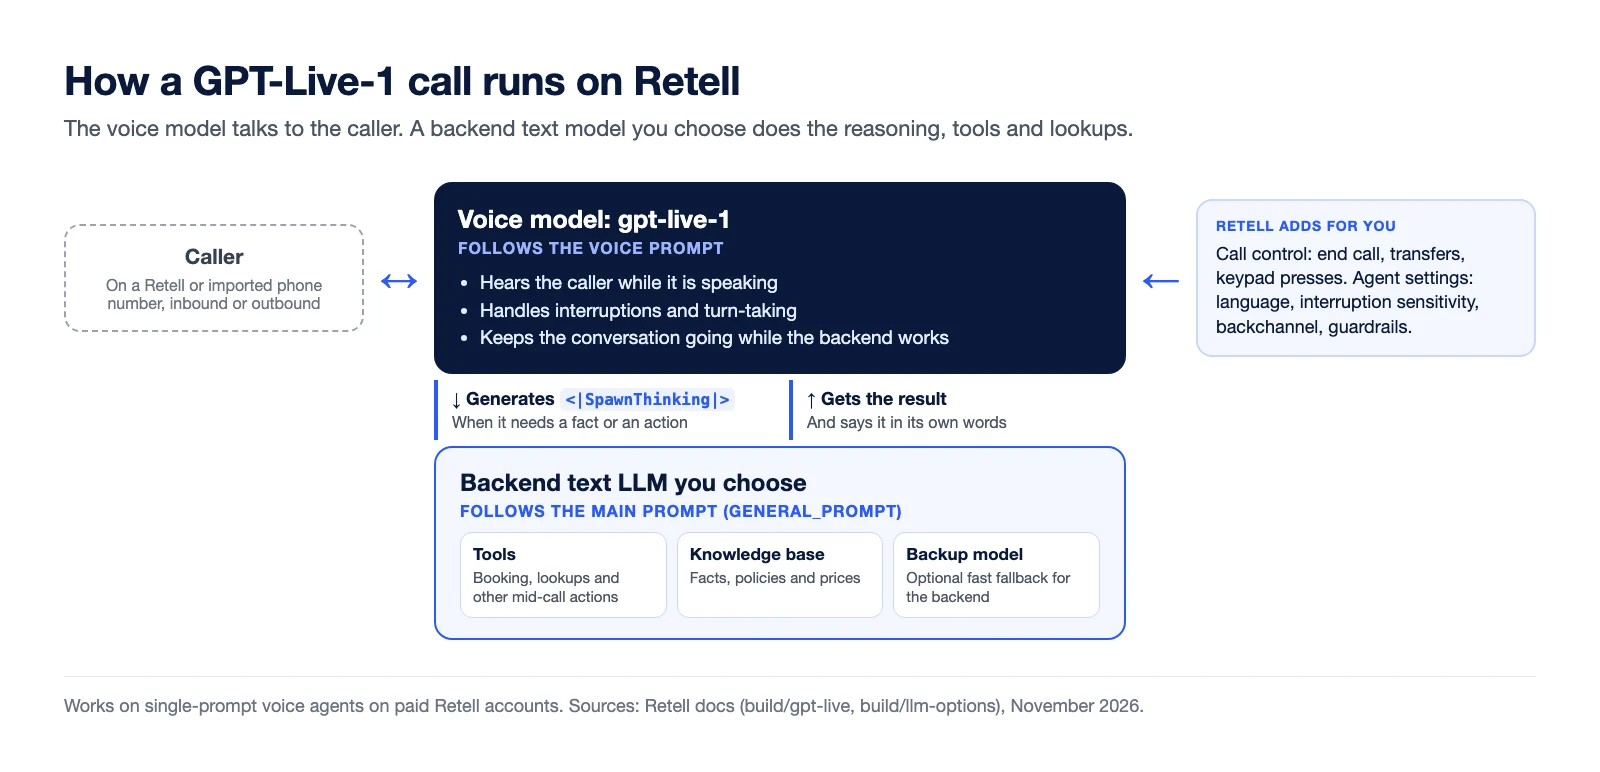
GPT-Live-1 delar upp jobbet på ett annat sätt. Röstmodellen äger samtalet: den hör den som ringer medan den själv pratar, hanterar avbrott och pauser och avgör vad som ska sägas härnäst. När den behöver ett faktum eller en åtgärd begär den backend-arbete genom att generera en särskild token, <|SpawnThinking|>. Backend kan vara en modell, en agent eller en tjänst; på Retell är det en textmodell som du väljer, som kör agentens verktyg och kunskapsbas. Backend returnerar resultatet och röstmodellen återger det med egna ord. Backend-arbetet kan fortsätta även när den som ringer avbryter.
OpenAI:s egna siffror talar för uppdelningen. I diagrammen från dess lanseringsinlägg för API:et klarar GPT-Live-1, med GPT-6 Astra på medelhög resonemangsnivå som backend, 86,2 % av röstuppgifterna i Tau3 (support inom flyg, detaljhandel och telekom) på första försöket, jämfört med 45,7 % för GPT-Realtime-2.1. På Full Duplex Bench rapporterar OpenAI en latens för turtagning på 0,798 sekunder för GPT-Live-1, jämfört med 1,41 sekunder för GPT-Realtime-2.1. Det här är OpenAI:s resultat, inte mätningar gjorda av Retell.
Kaskad, tal-till-tal eller full duplex?
Retell stöder alla tre sätten att köra en röstagent. De passar olika typer av samtal.
| Kaskad | Tal-till-tal | Full duplex (GPT-Live-1) | |
|---|---|---|---|
| Hur en tur fungerar | Transkribering, sedan en text-LLM, sedan text-till-tal | En modell hör ljud och svarar med ljud | En röstmodell pratar medan en backend-text-LLM sköter resonemang och verktyg |
| Exempel på Retell | GPT 5.6 Terra, Claude 5 Sonnet, Gemini 3.5 Flash | gpt-realtime-2.1, grok-voice-3.0 | gpt-live-1 med en backend-text-LLM |
| Promptar | En | En | Två: en röstprompt och backend-prompten |
| Reservmodell för snabb fallback | Stöds | Stöds inte | Gäller backend-modellen |
| Passar bäst för | Konversationsflöden och strikt logik i flera steg | Snabba, naturliga samtal som till största delen följer en prompt | Naturliga samtal som också utför åtgärder under samtalet |
För xAI:s tal-till-tal-alternativ, se hur du kör en telefonagent på Grok Voice. För en bredare överblick över modeller, se vår jämförelse av tal-till-tal-AI-API:er för telefonsamtal.
Var GPT-Live-1 passar i telefonsamtal
GPT-Live-1 är som starkast på agenter med en enda prompt som utför åtgärder under samtalet, till exempel att boka ett möte eller slå upp en order, där svarsfördröjningen hos en kaskadagent märks. Medan backend bokar eller slår upp något håller röstmodellen igång samtalet i stället för att pausa med en utfyllnadsfras.
På Retell har den tydliga begränsningar:
- Endast röstagenter med en enda prompt. Den är inte tillgänglig för konversationsflöden, agenter med flera promptar, överföringsagenter eller chattagenter. Använd en kaskad- eller tal-till-tal-modell för dem.
- Vissa verktyg stöds inte. Agentbyte, förberedd (bryggad) överföring och avbruten överföring avvisas när du sparar. En vanlig samtalsöverföring, avsluta samtal och knapptryckning fungerar alla.
- Endast betalda konton. Precis som tal-till-tal-modeller ingår GPT-Live-1 inte i den kostnadsfria provperioden.
- Ingen växling per samtal. En agentåsidosättning för ett enskilt samtal kan inte flytta en agent till GPT-Live-1.
Så konfigurerar du GPT-Live-1 på en Retell-telefonagent
GPT-Live-1 konfigureras via Retell API, på en Retell LLM.
- Skapa en Retell LLM med model_config satt till typen duplex, gpt-live-1 som primär modell och den textmodell du vill använda som backend.
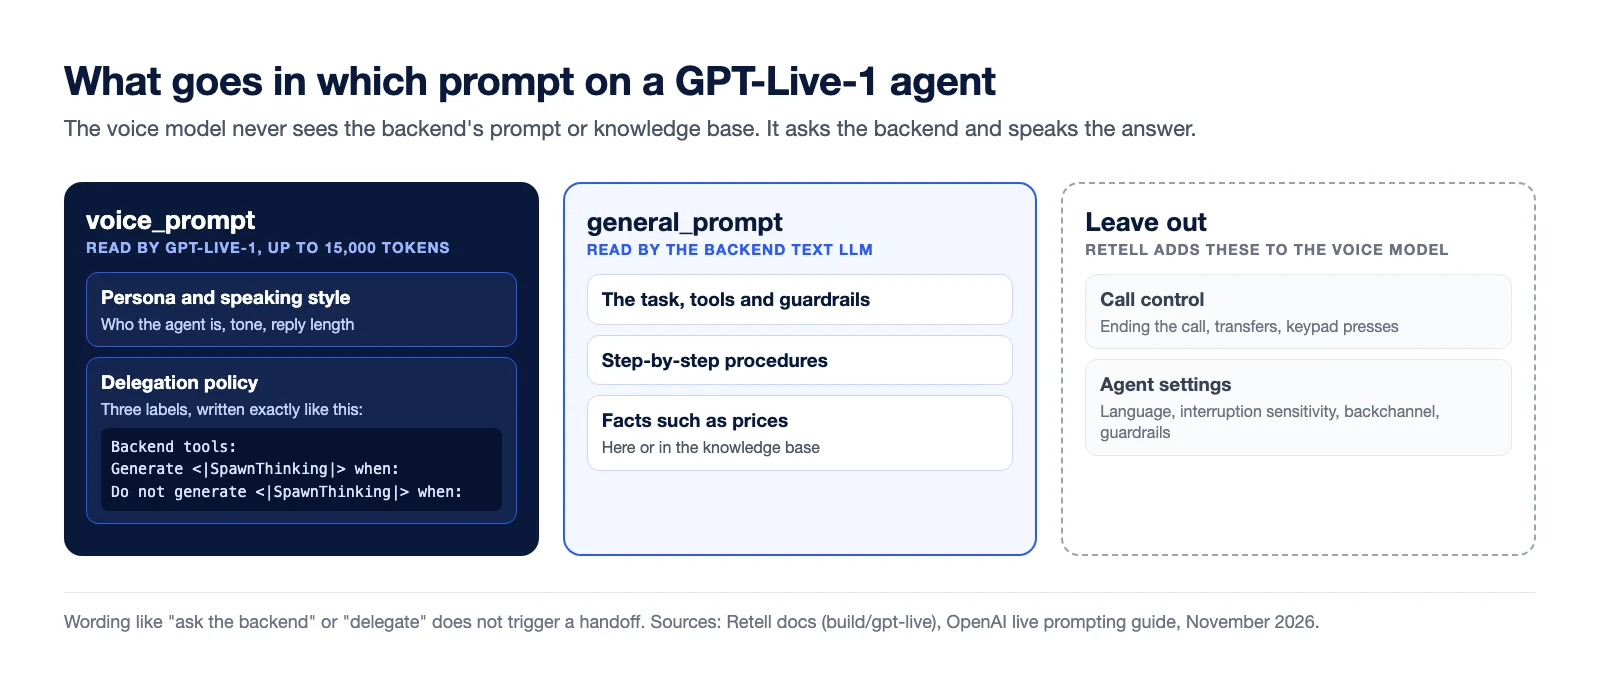
- Skriv två promptar. general_prompt är backends prompt: uppgiften, verktygen och skyddsreglerna. voice_prompt talar om för röstmodellen hur den ska prata och när den ska lämna över arbete till backend. Den kan vara upp till 15 000 tokens.
- Koppla LLM:en till en röstagent som dess svarsmotor, precis som med vilken annan Retell LLM som helst.
- Anslut ett telefonnummer och ta emot inkommande samtal eller ring utgående.
Här är en förfrågan, anpassad från Retells dokumentation, för en agent på en tandvårdsklinik:
curl --request POST "https://api.retellai.com/create-retell-llm" \
  --header "Authorization: Bearer $RETELL_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "general_prompt": "You are the backend for a dental clinic phone agent. Collect the caller name and date of birth, then use the booking tool to find and confirm an appointment. Keep names, numbers, and dates exact.",
    "voice_prompt": "You are a warm, efficient front-desk agent for Bright Smile Dental. Keep replies short and natural, and ask one question at a time.\n\nDelegation policy:\nBackend tools:\n- Appointments: find open times and book, change, or cancel appointments.\n\nGenerate <|SpawnThinking|> when:\n- The caller wants to book, change, or cancel an appointment.\n\nDo not generate <|SpawnThinking|> when:\n- You need a brief clarification to understand the request.",
    "model_config": {
      "type": "duplex",
      "primary": { "model": "gpt-live-1" },
      "backend": { "model": "gpt-4.1" }
    }
  }'
Fullständiga fältdetaljer finns i konfigurationsguiden för GPT Live.
Så skriver du röstprompten
Röstprompten är där de flesta GPT-Live-1-agenter går fel. Modellen lämnar bara över arbete till backend när den genererar <|SpawnThinking|>, så reglerna för överlämning måste använda exakt den frasen. Formuleringar som ”fråga backend” eller ”delegera” utlöser ingen överlämning. OpenAI:s promptguide varnar också för att ett muntligt löfte som ”jag kollar det” inte betyder att backend-arbetet har startat.
Skriv röstprompten i två delar:
- Persona och talstil. Vem agenten är och hur den pratar, till exempel ton och svarslängd.
- En delegeringspolicy under tre etiketter, som behålls exakt som de skrivs: ”Backend tools:” listar vad backend kan göra, en förmåga per rad. ”Generate <|SpawnThinking|> when:” listar när överlämning ska ske. ”Do not generate <|SpawnThinking|> when:” listar vad som ska besvaras direkt.
Håll verktygsdefinitioner, steg-för-steg-procedurer och fakta som priser i backend-prompten och kunskapsbasen. Röstmodellen ser dem inte; den frågar backend och återger svaret med egna ord. Retell lägger dessutom till instruktioner för samtalskontroll (avsluta samtalet, överföringar, knapptryckningar) och agentens inställningar i röstmodellen åt dig, så utelämna dem.
Vad som följer med från dina agentinställningar
De flesta agentinställningar i Retell gäller fortfarande. Röstmodellen respekterar agentens språk, avbrottskänslighet, responsivitet, backchannel, talhastighet, uttal, förstärkta nyckelord och skyddsregler. Detektering av röstbrevlåda, IVR, spärrlistor och återuppringning körs via backend, och inställningen för välkomstmeddelande avgör fortfarande vem som talar först.
Två saker fungerar annorlunda. Varje verktygs inställning ”tala under körning” ignoreras, eftersom röstmodellen fortsätter prata medan backend arbetar, och agenten talar alltid efter att ett verktyg är klart. Dynamiska variabler i röstprompten fylls i en gång, när samtalet startar.
Vad GPT-Live-1 kostar
I OpenAI:s API kostar en GPT-Live-1-röstsession 0,05 $ per minut, debiteras per sekund och avrundas inte uppåt till nästa minut. Backend-modellen och dess verktyg debiteras separat enligt sina vanliga priser.
På Retell debiteras röstmodellen per minut samtalstid och backend-text-LLM:en debiteras separat för sin egen användning. Aktuella priser finns på prissidan. En detalj spelar roll för långa samtal: Retell sänker modellavgifterna under långa tysta perioder, men full-duplex-röstmodeller debiteras fortfarande under dessa perioder.
Vanliga frågor
Vad är GPT-Live-1?
GPT-Live-1 är OpenAI:s full-duplex-röstmodell för konversationer i realtid. Den lyssnar och talar samtidigt, hanterar avbrott och delegerar resonemang och verktygsanvändning till en backend-modell eller agent som du väljer.
Finns GPT-Live-1 i API:et?
Ja. GPT-Live-1 blev allmänt tillgänglig i OpenAI:s API den 10 september 2026, på endpointen för Live-sessioner. GPT-Live-1.1, en nyare version med fler röster och bättre prestanda på andra språk än engelska, rullades ut i ChatGPT, Codex och dots den 15 oktober 2026 och aviserades som snart tillgänglig i API:et.
Vad kostar GPT-Live-1?
OpenAI tar 0,05 $ per minut för en GPT-Live-1-röstsession, debiterat per sekund. Backend-modellen och verktygsanvändningen debiteras separat enligt sina vanliga priser.
Kan GPT-Live-1 hantera telefonsamtal?
Ja. OpenAI stöder telefoni- och SIP-anslutningar för Live-sessioner. På Retell är en GPT-Live-1-agent en röstagent som vilken annan som helst, så du ansluter den till ett telefonnummer för inkommande och utgående samtal, och både vanlig samtalsöverföring och knapptryckning fungerar.
Hur skiljer sig GPT-Live-1 från gpt-realtime?
gpt-realtime-modellerna är tal-till-tal: en modell lyssnar, resonerar, anropar verktyg och talar, via OpenAI:s Realtime API. GPT-Live-1 körs på en separat endpoint för Live-sessioner, behåller rösten i sin egen modell och skickar resonemang och verktyg till en backend. OpenAI rapporterar högre uppgiftsslutförande för GPT-Live-1 i kombination med en stark backend, samt snabbare turtagning.
Fungerar GPT-Live-1 med konversationsflöden på Retell?
Nej. På Retell fungerar GPT-Live-1 endast på röstagenter med en enda prompt. Konversationsflöden och agenter med flera promptar kräver en kaskad- eller tal-till-tal-modell.
Testa GPT-Live-1 på dina egna samtal
Om din agent utför åtgärder under samtalet och pauserna stör dig är GPT-Live-1 värd ett pilottest. Följ konfigurationsguiden, anslut ett nummer i Retell och jämför den med din nuvarande modell på riktiga samtal innan du byter.
See how much your business could save by switching to AI-powered voice agents.
ROI Result
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Ett demonummer från Retell Clinic Office
What results look like with Retell AI


Estimate your monthly voice AI cost
Read Other Blogs
Revolutionera din samtalsverksamhet med Retell


