Vad produktteam letar efter i en röst-AI-plattform




En röst-AI-plattform är den programvara ett produktteam använder för att bygga, koppla ihop, testa och köra AI-röstagenter i telefon- och webbsamtal. Produkt- och teknikansvariga väljer sällan en plattform utifrån en demo. De bygger samma agent på varje plattform i urvalet och kontrollerar fyra saker själva: hur snabbt den första fungerande agenten kommer på plats, hur långt API:et och arbetsflödesverktygen räcker, hur länge uppringare väntar på svar och vad som förändras när en pilot blir produktionstrafik.
Den här guiden är en plan för den praktiska jämförelsen. Retell AI publicerar guiden och är en av de plattformar som produktteam jämför, tillsammans med Vapi, ElevenLabs och Bland. Det vi säger om de andra tre bygger på respektive leverantörs egen dokumentation, läst den 10 november 2026 och länkad. Vi har inte ringt några testsamtal för den här guiden, så den innehåller inga poäng och ingen rankning. Det vi säger om Retell bygger på den offentliga dokumentationen från Retell, inklusive de begränsningar som dokumentationen anger.
Vad kontrollerar ett produktteam som en demo inte visar?
En demo visar ett bra samtal. En praktisk jämförelse visar vad dina egna utvecklare kan bygga, koppla ihop och mäta. Ge en utvecklare samma samtalstyp på varje plattform, en verklig sådan som att boka möten mot ditt schemaläggnings-API, och notera samma fyra resultat för var och en.
| Vad du ska kontrollera | Vad ditt team gör | Vad du ska anteckna |
|---|---|---|
| Hur enkelt det är att bygga | Bygg agenten från ett tomt konto till ett första samtal, utan hjälp från leverantören | Timmar till ett första fungerande samtal, och varje punkt där du fastnade |
| API- och arbetsflödesdjup | Anropa ditt eget API under ett samtal, ta emot samtalshändelser, skapa agenten från kod | Vilka steg som krävde en nödlösning |
| Svarslatens | Ring minst 20 samtal och hämta tidsdata för varje tur | Median och 95:e percentil, med den definition leverantören använder |
| Från pilot till skala | Läs på om begränsningar, felbeteende och releasekontroller innan du behöver dem | Standardgränser, vad som händer när du når dem och vad som driver kostnaden |
Hur snabbt kan ditt team bygga den första fungerande agenten?
Mät tiden från ett tomt konto till ett samtal som din utvecklare skulle visa för en kollega, och notera varje punkt där hen behövde be leverantören om hjälp. Ett svar som hittas i dokumentationen räknas som självbetjäning.
Två saker avgör den tiden på de flesta plattformar. Den första är hur mycket struktur du måste utforma innan agenten kan prata. Dokumentationen från Retell rekommenderar att börja med en agent med en enda prompt och gå över till ett konversationsflöde, som delar upp uppgiften i noder med egna instruktioner, först när en enda prompt inte längre räcker för dina krav. Samma sida är tydlig med avvägningen: ”Ett konversationsflöde är inte automatiskt mer tillförlitligt.”
Den andra är hur snart du kan höra agenten och upptäcka dess misstag. Testöversikten från Retell listar fyra metoder: textchatt i LLM Playground, sparade simuleringstestfall, webbläsarsamtal ”utan telefonnummer” och riktiga telefonsamtal. Budgetera för testsamtalen. Hos Retell debiteras testning till samma priser som produktion. En fullständig genomgång av ett första bygge finns i hur du bygger en AI-röstagent.
Hur enkelt det är att bygga beror också på vad plattformen kör åt dig. Enligt dokumentationen från Retell ”kör den telefoni-, tal- och språkmodellslagren, så att du konfigurerar agenten i stället för att koppla ihop leverantörer.” Ditt team äger agentens beteende utan att underhålla infrastrukturen under den. Om den avvägningen passar dig är ett separat beslut, som behandlas i bygga eller köpa AI-röstagenter.
Hur djupt går API:et och arbetsflödesverktygen?
Tillräckligt djupt betyder två saker: dina utvecklare kan göra från kod det de gjorde i dashboarden, och agenten kan nå dina system under ett samtal utan ett middleware-projekt. Kontrollera fem områden på varje plattform.
- SDK:er och API-täckning. Fråga om varje åtgärd i dashboarden har en endpoint. Retell publicerar officiella SDK:er för Node.js och Python, som beskrivs som typade klienter med full täckning av röst- och chatt-endpoints.
- Anropa ditt API under ett samtal. En anpassad funktion i Retell skickar en GET-, POST-, PUT-, PATCH- eller DELETE-begäran till din endpoint och väntar på svaret. Timeouten är 1 till 600 sekunder, med 120 som standard. Begäranden görs inte om såvida du inte anger ett antal återförsök. Fråga varje leverantör vad uppringaren hör medan en långsam begäran pågår.
- Samtalshändelser. Webhooks i Retell skickar händelserna call_started, call_ended och call_analyzed till din server. Var och en har en timeout på 10 sekunder och görs om upp till 3 gånger. Med ett signaturhuvud kan du verifiera avsändaren.
- MCP i båda riktningarna. En Retell-agent kan anropa verktyg på en fjärransluten MCP-server under ett pågående samtal. Den egna MCP-servern från Retell låter klienter som Cursor och Claude Code bygga och hantera agenter via API:et.
- Din egen modell och din egen operatör. Med en anpassad LLM hanterar Retell samtalet och öppnar en WebSocket mot din server för varje samtal. Dokumentationen rekommenderar de inbyggda agenttyperna för de flesta agenter och säger att du med en anpassad LLM själv tar ansvar för latens, drifttid och återanslutning. För telefonlinjer ansluter anpassad telefoni via elastic SIP trunking eller genom att ringa en SIP URI.
Kontrollera även färdiga kopplingar. Integrationsöversikten från Retell listar 11 leverantörer inom CRM, support, kalender och kunskapsbas. Allt utanför den listan går via en anpassad funktion, MCP eller en webhook.
Hur bör du mäta svarslatens?
Mät den i dina egna samtal, tur för tur, och redovisa percentiler med definitionen bifogad. En latenssiffra utan start- och stopppunkt kan inte jämföras med en annan leverantörs siffra.
Dokumentationen från Retell definierar latens från början till slut som tiden från att användaren slutar prata till att agenten börjar svara. Med den definitionen anger dokumentationen att plattformen ”når en latens så låg som 600 ms.” Läs ”så låg som” som ett golv. Din siffra beror på vilken modell, prompt och vilka inställningar du väljer.
Hämta dina egna siffror per samtal. Get Call API från Retell returnerar ett latensobjekt med 50:e, 90:e, 95:e och 99:e percentilen för totalsiffran och för transkribering, LLM, text till tal och hämtning från kunskapsbasen. Samma sida anger en begränsning: totalsiffran inkluderar inte nätverksvägen från servern hos Retell till användarens enhet. För webb- och appsamtal bör du även mäta svarstiden på klienten.
När en siffra är hög, titta på konfigurationen innan du skyller på plattformen. Felsökningsguiden för latens från Retell pekar ut valet av LLM-modell och promptlängden som de två vanligaste orsakerna, säger att prompter över ungefär 8 000 tokens blir märkbart långsammare och rekommenderar att hålla den uppskattade latensen under 1,5 sekunder. Be varje leverantör om samma uppdelning per komponent.
Hastighet är en av flera faktorer bakom ett bra samtal. Latens i röst-AI: orsaker, mätning och påverkan på uppringare förklarar var fördröjningen kommer ifrån och när ett snabbare svar gör ett samtal sämre. Publicerade benchmarkresultat för de fyra plattformarna finns i Retell AI vs Bland AI vs Vapi vs ElevenLabs.
Vad förändras mellan pilot och produktion i stor skala?
Tre saker förändras: de gränser du stöter på, vad uppringare upplever när något fallerar och hur ändringar når pågående samtal. Läs varje leverantörs svar innan piloten är slut.
- Samtidighet. Fråga efter standardgränsen och vad som händer vid gränsen. Hos Retell får en workspace med betala per användning 20 samtidiga samtal som standard, och du kan höja gränsen i dashboarden. Vid gränsen väntar ett nytt inkommande samtal på en ledig plats. Efter cirka 40 sekunder överförs det till ett reservnummer om du har angett ett, annars avslutas samtalet. Ett utgående samtal över gränsen avvisas om du inte aktiverar concurrency burst, som lägger till en avgift per minut.
- Drifttid och reservlösningar. Tillförlitlighetsöversikten från Retell anger en garanti på mer än 99,9 % drifttid och länkar till en offentlig statussida. Där listas LLM-fallback och återförsök som inbyggda funktioner, samt ett Backup-läge som leder om nya inkommande samtal till ett reservnummer medan du utreder ett problem.
- Releasekontroll. Versioner, staging-taggar, batchkörningar från din CI-pipeline och procentuell trafikuppdelning avgör hur säkert en ändring rullas ut. Det ämnet har en egen guide: ribban för att köpa röst-AI.
- Säkerhetsgranskning. Påbörja den under piloten. Enligt sidan om säkerhet och efterlevnad från Retell uppfyller plattformen HIPAA och GDPR och är certifierad enligt SOC 2 Type 1 och Type 2, och den erbjuder ett BAA via självbetjäning.
- Kostnadsdrivare. Prissättningen hos Retell är användningsbaserad, från 0,07 USD per minut enligt prissidan. Priset beror på vilken röst, modell och telefoni du väljer, och vissa latensalternativ kostar mer än standardpriset för modellen. Så fungerar användningsbaserad prissättning förklarar delarna.
För utformningen av piloten tar hur du utvärderar en röstagentplattform innan lansering upp vilka samtal som bör ingå och vad du ska mäta, och från röst-AI-demo till produktion täcker de första 30 dagarna.
Hur beskriver Vapi, ElevenLabs, Bland och Retell sig själva?
Varje leverantörs dokumentation beskriver en plattform för att bygga, driftsätta och övervaka röstagenter, med ett promptbaserat sätt att börja och ett mer strukturerat alternativ. Tabellen citerar varje leverantörs egen dokumentation, läst den 10 november 2026.
| Plattform | Hur den egna dokumentationen beskriver den | Byggalternativ som dokumentationen nämner |
|---|---|---|
| Retell AI | ”En plattform för att bygga, testa, driftsätta och övervaka AI-röst- och chattagenter med inbyggd telefoni, prompter, verktyg och analys” (Retell-dokumentationen) | Agenter med en enda prompt och agenter med konversationsflöde |
| Vapi | ”Utvecklarplattformen för att bygga AI-röstagenter” (Vapi-dokumentationen) | Assistants, som använder en enda systemprompt plus verktyg och strukturerade utdata, och Squads, som kör flera assistenter med överföringar som bevarar kontexten. Du väljer leverantörer för tal till text, LLM och text till tal |
| ElevenLabs | ElevenAgents erbjuder ”uttrycksfulla modeller med rika röster, utvecklarverktyg för att bygga multimodala agenter och verktyg för att övervaka och utvärdera agenters prestanda i stor skala” (ElevenLabs-dokumentationen) | Ett utvecklarverktyg, en dashboard eller en visuell arbetsflödesbyggare, med SDK:er för React, Swift, Kotlin, React Native och Unity |
| Bland | ”Allt du behöver för att bygga, övervaka och förbättra AI-röstagenter i Bland” (Bland-dokumentationen) | En agentbyggare där ”de flesta agenter börjar som en enda prompt” och pathways ger struktur där samtalet behöver det |
Beskrivningarna ligger nära varandra, så att läsa dem gör inte valet åt dig. De fyra kontrollerna körs på din samtalstyp och dina system. För detaljerade jämförelser sida vid sida publicerar Retell jämförelser med Vapi, ElevenLabs och Bland, samt en guide till alternativ till Vapi.
Hur gör du jämförelsen rättvis?
Håll allt konstant utom plattformen. Använd en samtalstyp, en utvecklare, ett manus för uppringarens beteende och ett utvärderingsformulär, och fyll i samma fält för varje leverantör.
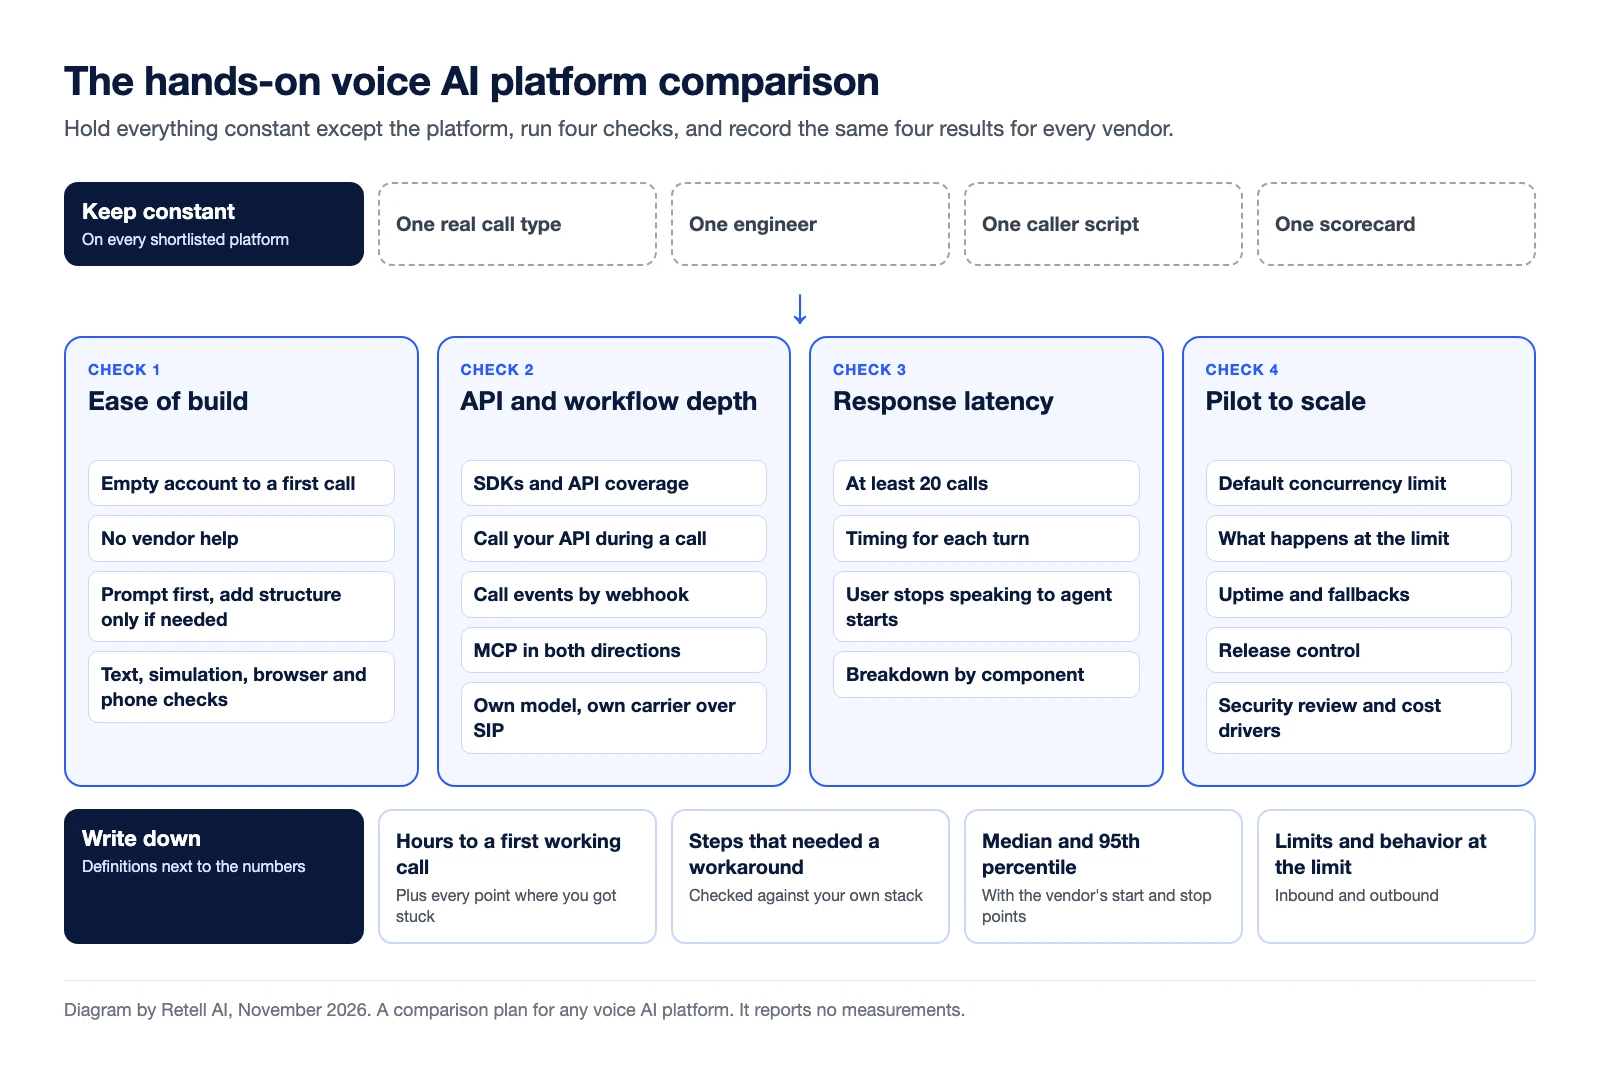
Skriv uppringarmanuset innan någon börjar bygga. Ta med ett avbrott, en rättelse, en fråga som agenten ska avböja och en begäran som kräver ditt API. Jämför sedan de fyra resultaten sida vid sida, med varje leverantörs definitioner bredvid dess siffror.
Någon måste äga agenten när valet är gjort. Många team ger det uppdraget till en CX engineer, även kallad CX automation engineer eller intern deployed engineer: den interna ägaren som hittar dåligt hanterade samtal, bygger lösningar, kontrollerar dem och driftsätter dem. Om du redan har den personen, ta med hen i jämförelsen. Vad den verkställande sponsorn behöver av plattformen och leverantören tas upp i vad CX-chefer behöver av AI-röstagenter.
Vanliga frågor
Vad bör ett produktteam leta efter i en röst-AI-plattform?
Fyra saker, alla kontrollerade i praktiken: hur snabbt din egen utvecklare kan bygga en första fungerande agent, hur långt API:et, webhooks och arbetsflödesverktygen räcker, hur länge uppringare väntar på svar i dina egna samtal och hur gränser och felbeteende ser ut vid produktionsvolym. Kör samma kontroller på varje plattform i urvalet.
Hur jämför du röst-AI-plattformar i praktiken?
Välj en verklig samtalstyp, låt en utvecklare göra samma bygge på varje plattform och ring samma manusstyrda samtal på var och en. Notera timmar till ett första fungerande samtal, de steg som krävde en nödlösning, median och 95:e percentil för svarstiden samt standardgränserna. Håll varje leverantörs definitioner bredvid dess siffror.
Vad är en bra svarslatens för en AI-röstagent?
Det beror på modellen, prompten och inställningarna, så mät den i dina egna samtal. Dokumentationen från Retell anger en latens så låg som 600 ms, mätt från att användaren slutar prata till att agenten börjar svara, och rekommenderar att hålla den uppskattade latensen under 1,5 sekunder. Jämför percentiler mellan leverantörer bara när start- och stopppunkterna stämmer överens.
Behöver du utvecklare för att bygga en AI-röstagent?
Inte för en första agent. Snabbstarten från Retell tar dig från en mall till ett telefonsamtal i dashboarden. Utvecklare kommer in när agenten måste anropa ditt API under ett samtal, skicka samtalshändelser till dina system eller ansluta till din egen telefonoperatör via SIP. Det är de delarna som ett produktteam bör bygga under jämförelsen.
Hur många samtidiga samtal kan en röst-AI-plattform hantera?
Det beror på abonnemanget och leverantören. Hos Retell får en workspace med betala per användning 20 samtidiga samtal som standard, och gränsen kan höjas i dashboarden. Fråga varje leverantör vad som händer med ett inkommande och ett utgående samtal när gränsen är nådd.
Kör de fyra kontrollerna på dina egna samtal
Retell är en plattform för AI-röstagenter för kontaktcenter, med agenter med en enda prompt och med konversationsflöde, typade SDK:er, anpassade funktioner, webhooks, MCP, anpassad telefoni och latensdata per samtal. Över 4 000 kunder kör mer än 100 miljoner samtal i månaden på Retell, som nådde 100 miljoner USD i årlig intäktstakt i november 2026. Prissättningen är användningsbaserad, från 0,07 USD per minut enligt prissidan. Bygg samma agent som du byggde på andra ställen, kör den på dina egna samtal och jämför siffrorna innan du skriver på något.
See how much your business could save by switching to AI-powered voice agents.
ROI Result
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Estimate your monthly voice AI cost
Revolutionera din samtalsverksamhet med Retell


