Spezialisierte vs. universelle LLMs für Contact Center





Für die meisten Contact Center ist ein universelles LLM der sicherere Ausgangspunkt. Ein spezialisiertes LLM lohnt sich, wenn ein Anruftyp in hohem Volumen läuft und ein allgemeines Modell immer wieder auf dieselbe messbare Weise scheitert: langsame erste Worte, falsche Tool-Aufrufe oder Antworten, die klingen wie eine vorgelesene Webseite. Keine der beiden Kategorien gewinnt per se. Wählen Sie das Modell, das Ihre eigenen Anrufe besteht – Durchlauf für Durchlauf, zu Kosten pro Minute, die Sie planen können.
Dieser Leitfaden richtet sich an Führungskräfte, die für die Telefonleitung verantwortlich sind. Die Retell AI veröffentlicht diesen Leitfaden und hat auf beiden Seiten ein Interesse. Ihre Plattform bietet universelle Modelle von OpenAI, Anthropic und Google, und sie entwickelt eigene: Tell-1, das eigene LLM von Retell, gemacht für Contact-Center-Anrufe. Tell-1 belegt im öffentlichen Benchmark von Retell, dem Retell vCX Benchmark, insgesamt Platz 1 (Stand: 13. November 2026). Behandeln Sie ihn wie jeden Anbieter-Benchmark: als Grund für die Shortlist, den Sie anschließend an Ihren eigenen Anrufen überprüfen.
Was verlangt ein Contact-Center-Anruf von einem Sprachmodell?
Ein Contact-Center-Anruf verlangt von einem Modell bei jedem Gesprächszug fünf Dinge: einem langen Skript folgen, Tools korrekt aufrufen, gesprochen natürlich klingen, schnell antworten und auch bei hohem Volumen bezahlbar bleiben.
- Lange Skripte. Der Prompt des Agenten enthält die Schritte, Richtlinien und Ausnahmen für einen Anruftyp, und das Modell muss bei jedem Gesprächszug die richtige Regel anwenden. Im Multi-IF-Benchmark scheiterten alle 14 bewerteten Modelle mit jedem zusätzlichen Gesprächszug an mehr Anweisungen.
- Tool-Aufrufe. Buchungen, Abfragen und Weiterleitungen laufen über Tools, und ein falscher Aufruf verändert einen echten Datensatz. Das tau-bench-Paper von 2024 ergab, dass Function-Calling-Agenten auf Basis eines führenden universellen Modells bei weniger als 50 % der Kundenservice-Aufgaben erfolgreich waren und alle acht wiederholten Durchläufe einer Einzelhandelsaufgabe in weniger als 25 % der Fälle bestanden.
- Natürliche Sprache. Die Antwort wird gehört, nicht gelesen. Listen und Symbole, die auf einem Bildschirm funktionieren, klingen mit einer synthetischen Stimme falsch.
- Tempo. Menschen lassen zwischen den Gesprächszügen nur kurze Pausen. Ein Überblick über die Forschung zum Sprecherwechsel beziffert die typische Pause auf rund 200 Millisekunden. Das Modell ist eine Stufe zwischen dem letzten Wort des Anrufers und dem ersten Wort des Agenten – die Zeit, die es braucht, bevor es eine Antwort beginnt, ist als Stille zu hören.
- Kosten bei hohem Volumen. Bei jedem Gesprächszug werden das Skript und das bisherige Gespräch erneut an das Modell gesendet. Anbieter gewähren auf diesen wiederholten Input Rabatt (der Leitfaden zum Prompt Caching von OpenAI nennt bis zu 95 % Rabatt auf gecachten Input), doch beim Volumen eines Contact Centers wird ein kleiner Unterschied pro Minute zu einem eigenen Budgetposten.
Wo passen universelle LLMs ins Contact Center?
Universelle LLMs passen am besten dort, wo Anrufe variieren: viele Anruftypen, viele Sprachen und Fragen, die niemand im Skript vorgesehen hat. Sie werden breit trainiert und von mehreren Anbietern verkauft, sodass ein Team das Modell wechseln kann, wenn sich seine Anforderungen ändern.
Zudem erfordern sie weniger individuelle Arbeit, als viele Käufer annehmen. Der Leitfaden zur Modelloptimierung von OpenAI beschreibt einen Kreislauf aus Evals und Prompt Engineering, ergänzt um Fine-Tuning „für einige Anwendungsfälle“. Vieles, was einen Agenten am Skript hält, steckt im Prompt, im Gesprächsablauf und in den Tools – und diese Arbeit bleibt erhalten, wenn das Modell wechselt.
Die Grenzen zeigen sich am Telefon. Reasoning-Modi, die vor der Antwort nachdenken, verzögern das erste Wort. Modelle, die auf schriftlichen Chat abgestimmt sind, brauchen Prompting, damit die Antworten kurz und sprechbar bleiben. Und der Anbieter bestimmt den Zeitplan: Die Deprecation-Richtlinie von OpenAI sieht eine Vorankündigung von mindestens 6 Monaten vor, bevor ein allgemein verfügbares Modell eingestellt wird – danach muss der Agent mit dem Nachfolger erneut geprüft werden. Einen Vergleich Modell für Modell finden Sie unter welches LLM Ihren KI-Sprachagenten antreiben sollte.
Was ändert ein spezialisiertes oder feinabgestimmtes LLM?
Ein spezialisiertes LLM verlagert Verhalten aus dem Prompt in das Training des Modells. Statt ein allgemeines Modell anzuweisen, sich kurz zu fassen, Richtlinien zu befolgen und Tools im richtigen Moment aufzurufen, trainiert der Anbieter mit genau solchen Beispielen – oft auf einem kleineren Modell. Drei Begriffe werden dabei häufig verwechselt:
- Ein domänenspezifisches oder vertikales LLM wird von einem Anbieter für eine Branche oder Aufgabe trainiert oder abgestimmt und allen seinen Kunden angeboten.
- Ein feinabgestimmtes Modell ist ein Basismodell, das auf einem engeren Datensatz weitertrainiert wurde, oft auf Ihren eigenen Daten. Der Glossareintrag zu KI-Modell-Fine-Tuning erklärt die Mechanik.
- Ein benutzerdefiniertes LLM bezeichnet meist jedes Modell, das Sie selbst in eine Plattform einbringen – ob feinabgestimmt oder nicht.
Der Leitfaden zur LLM-Genauigkeit von OpenAI nennt zwei Gründe für Fine-Tuning: die Genauigkeit bei einer bestimmten Aufgabe zu verbessern und die Effizienz zu steigern, also dieselbe Genauigkeit mit weniger Tokens oder mit einem kleineren Modell zu erreichen. Bei Anrufen kann das eine zuverlässigere Skripttreue, kürzere Prompts und niedrigere Kosten pro Minute bedeuten.
Die Idee ist nicht neu. Observe.AI kündigte im Juni 2023 ein Contact Center LLM an, das das Unternehmen als Modell mit 30 Milliarden Parametern beschreibt, trainiert auf einem domänenspezifischen Datensatz aus Hunderten Millionen Kundeninteraktionen. Die in dieser Ankündigung genannten Genauigkeitsgewinne stammen aus den ersten eigenen Benchmarks des Anbieters. Das ist in dieser Kategorie üblich – und genau deshalb zählt Ihre eigene Evaluierung mehr als jede Ankündigung.
Welche Kompromisse bringen die beiden Ansätze mit sich?
Die Kompromisse betreffen Lock-in, Abdeckung und Evaluierungsaufwand – und jeder davon wirkt in beide Richtungen.
| Faktor | Universelles LLM | Spezialisiertes oder feinabgestimmtes LLM |
|---|---|---|
| Beste Eignung | Unterschiedliche Anruftypen, viele Sprachen, Fragen ohne Skript | Ein Anruftyp mit hohem Volumen und stabilen Regeln |
| Skript- und Tool-Verhalten | Festgelegt durch Prompt und Gesprächsablauf | Antrainiert, daher ist weniger Prompt nötig |
| Tempo und Kosten pro Minute | Abhängig von Modellgröße und Reasoning-Modus | Können niedriger sein, wenn das Modell kleiner ist |
| Lock-in | Mehrere Anbieter, die Modelle jeweils nach eigenem Zeitplan einstellen | Oft ein Anbieter oder eine Plattform |
| Abdeckung | Breit | Enger außerhalb der Trainingsdaten |
| Verfügbare Belege | Öffentliche Benchmarks, wenige davon zu Telefonanrufen | Oft der eigene Benchmark des Anbieters |
| Evaluierungsaufwand | Erneute Prüfung, sobald ein Modell eingestellt wird | Prüfung vor der Einführung und nach jedem Retraining |
Lock-in. Ein spezialisiertes Modell wird oft von einem einzigen Anbieter verkauft, manchmal innerhalb einer einzigen Plattform. Fragen Sie, ob Sie das Modell wechseln können, ohne den Agenten neu aufzubauen, und ob Prompts, Abläufe und Testfälle Ihnen gehören. Universelle Modelle bergen eine leisere Variante desselben Risikos, wenn ein Anbieter eine Version einstellt.
Abdeckung. Ein Modell, das auf englischsprachigen Terminanrufen trainiert wurde, kann auf Spanisch schwächer sein oder bei einem Abrechnungsstreit, den es nie gesehen hat. Fordern Sie Ergebnisse nach Sprache und nach Anruftyp an, nicht einen Durchschnitt.
Evaluierungsaufwand. Öffentliche Benchmarks messen selten Telefonanrufe, und ein Anbieter-Benchmark ist vom Verkäufer ausgewählte Evidenz. Wenn Sie Ihr eigenes Modell feinabstimmen, wächst der Aufwand. Der Genauigkeitsleitfaden von OpenAI besagt, dass Trainingsbeispiele „genau das abbilden müssen, was das Modell in der realen Welt sehen wird“, und empfiehlt einen Hold-out-Datensatz, um Overfitting zu erkennen.
Wie evaluieren Sie beide Modelle an Ihren eigenen Anrufen?
Evaluieren Sie beide auf dieselbe Weise: feste Szenarien aus Ihren eigenen Anrufen, bewertet anhand schriftlicher Bestehenskriterien, mehrfach ausgeführt, danach ein Split des Live-Traffics.
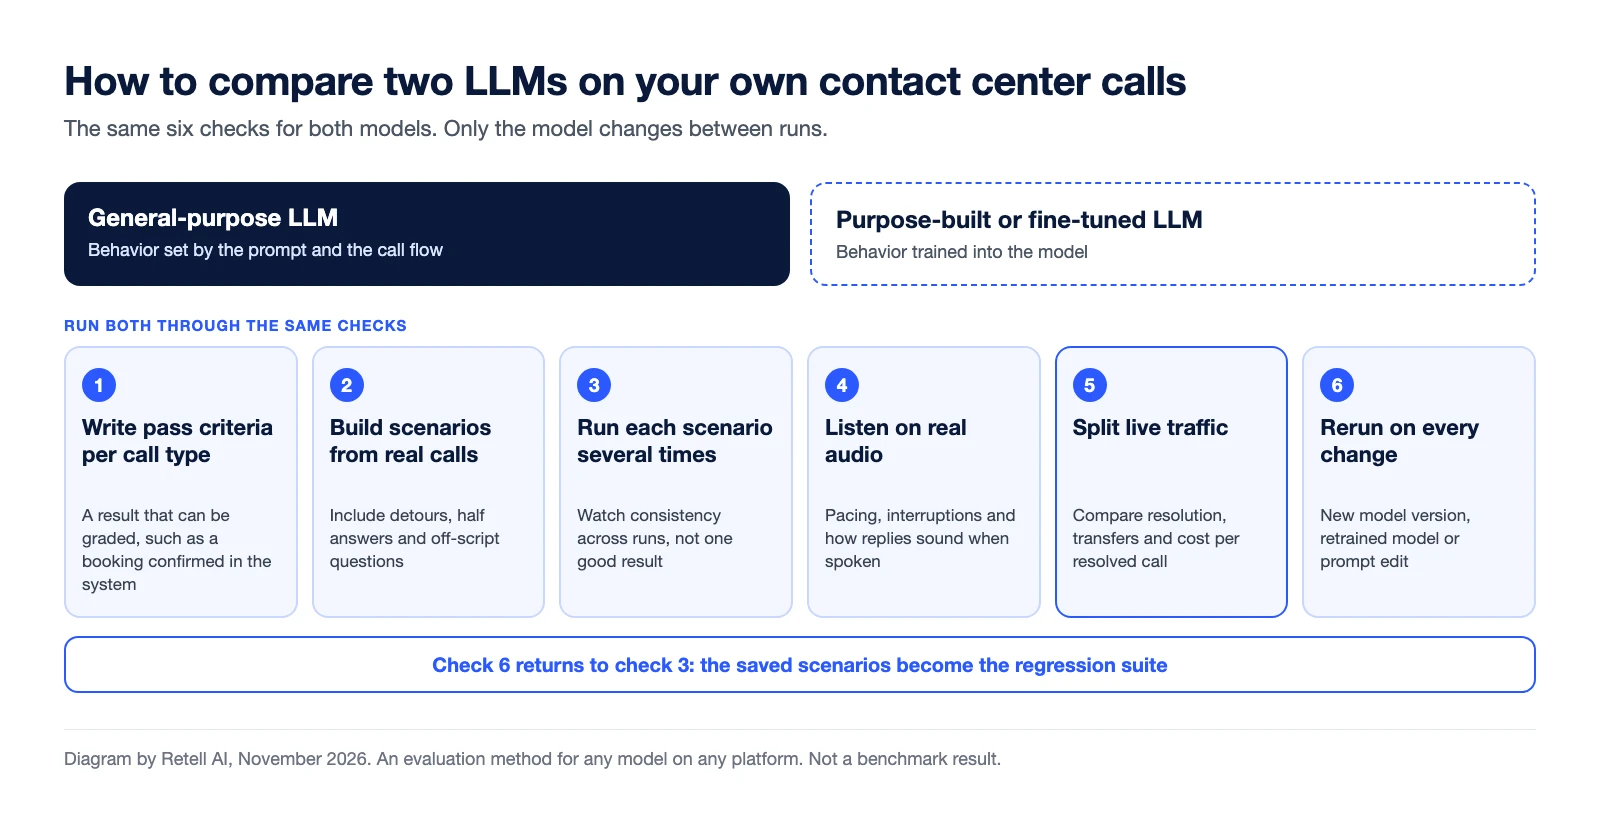
- Bestehenskriterien pro Anruftyp festlegen. „Termin im Planungssystem gebucht und dem Anrufer bestätigt“ lässt sich bewerten. „Klang gut“ nicht.
- Szenarien aus echten Anrufen erstellen. Beziehen Sie die Umwege ein: den Anrufer, der es sich anders überlegt, eine Frage abseits des Skripts stellt oder nur eine halbe Antwort gibt.
- Jedes Szenario mehrmals mit jedem Modell ausführen. Die Autoren von tau-bench schlugen eine pass^k-Metrik vor, um die Zuverlässigkeit über wiederholte Durchläufe zu messen.
- Mit echtem Audio anhören. Textergebnisse erfassen weder Tempo noch Unterbrechungen oder wie eine Antwort gesprochen klingt.
- Live-Traffic aufteilen. Leiten Sie einen Teil der Anrufe an jede Option und vergleichen Sie Lösungsquote, Weiterleitungen und Kosten pro gelöstem Anruf.
- Bei jeder Änderung erneut ausführen. Eine neue Modellversion, ein neu trainiertes Modell und eine Prompt-Änderung erfordern alle dieselbe Suite.
In Retell bewertet das Simulationstesting jeden Durchlauf anhand von Erfolgskriterien als bestanden oder nicht bestanden, Batch-Tests führen die gespeicherten Fälle erneut als Regressions-Suite aus, und A/B-Tests teilen den Anruf-Traffic prozentual zwischen Agenten auf. Laut Dokumentation können Sie das Modell später wechseln, ohne Ihren Prompt neu zu schreiben. Wenn Sie Ihr eigenes Modell einbinden, entfallen Simulations- und Batch-Tests; geprüft wird es dann über Web- und Telefonanrufe. Für den umfassenderen Pilotbetrieb lesen Sie, wie Sie eine KI-Sprachagent-Plattform vor dem Go-live evaluieren.
Wo steht Tell-1 in diesem Vergleich?
Tell-1, das eigene LLM von Retell, ist ein spezialisiertes Modell für Contact-Center-Anrufe – jeder Kompromiss in diesem Leitfaden gilt also auch dafür. So schneidet es in jedem Punkt ab, mit Quelle für jede Zahl.
- Skripte, Tools und Sprache. Im Retell vCX Benchmark erreicht Tell-1 einen Durchschnitt von 94,45 und belegt insgesamt Platz 1. Nach Testreihe erzielt es 88,6 % bei der Befolgung von Anweisungen (Platz 2), 97,2 % beim Grounding (Platz 2), 95,4 % bei Tool-Aufrufen (Platz 5) und 96,6 % bei umgangssprachlicher Sprache (Platz 1), jeweils Stand 13. November 2026. Die Retell AI betreibt diesen Benchmark selbst – nutzen Sie ihn also so, wie es dieser Leitfaden empfiehlt: als Grund für die Shortlist.
- Tempo. Es hat mit 76 ms die niedrigste mediane Latenz im Ranking (Stand 13. November 2026). Das ist der Wert des Modells im Benchmark, nicht die End-to-End-Antwortzeit eines Anrufs.
- Kosten. Der Benchmark führt es mit 3,5 Cent pro Minute. Das ist nur der LLM-Posten, nicht der Preis eines Anrufs, und einige universelle Konfigurationen im Ranking kosten weniger. Die Preise von Retell beginnen ab 0,07 $ pro Minute.
- Funktionsweise. Das Modell beginnt seine Antwort und denkt weiter, während die ersten Worte abgespielt werden. Der technische Beitrag Retell LLM: Interleaved Reasoning for Real-Time Voice Agents berichtet von durchschnittlich etwa 200 Reasoning-Tokens mitten in der Antwort und beschreibt die drei Trainingsphasen dahinter.
- Lock-in. Tell-1 wird innerhalb von Retell angeboten. Es steht in derselben Modellauswahl wie Modelle von OpenAI, Anthropic und Google, und laut der Dokumentation von Retell können Sie das Modell später wechseln, ohne Ihren Prompt neu zu schreiben – die Entscheidung dafür schließt die anderen also nicht aus.
- Abdeckung. Ein für Anrufe gebautes Modell ist bewusst enger ausgelegt. Testen Sie Tell-1 mit Ihren eigenen Sprachen und Anruftypen, bevor Sie sich darauf verlassen, und behalten Sie ein universelles Modell für jeden Anruftyp, bei dem es nur Zweiter wird.
- Evaluierung. Die sechs Prüfungen oben gelten unverändert. Da Tell-1 ein von Retell verwaltetes Modell ist, funktionieren Simulations- und Batch-Tests damit, und ein A/B-Split kann denselben Traffic an zwei Kopien eines Agenten senden, die sich nur im Modell unterscheiden.
Das faire Fazit: Tell-1 ist die spezialisierte Option für Ihre Shortlist, wenn Sie mit Retell arbeiten, und die universellen Modelle daneben sind die Kontrollgruppe. Details zum Produkt finden Sie unter Tell-1.
Häufig gestellte Fragen
Was ist ein spezialisiertes LLM?
Ein spezialisiertes LLM ist ein Sprachmodell, das für eine bestimmte Aufgabe trainiert oder abgestimmt wurde, etwa für die Bearbeitung von Contact-Center-Anrufen, statt für den allgemeinen Einsatz. Es wird auch domänenspezifisches oder vertikales LLM genannt. Ein universelles Large Language Model wird über Prompts und Tools an die Aufgabe angepasst.
Sind spezialisierte LLMs genauer als universelle LLMs?
Bei der Aufgabe, für die sie trainiert wurden, können sie es sein. Außerhalb davon oft nicht. Die meisten veröffentlichten Vergleiche stammen vom Anbieter, der das Modell entwickelt hat – testen Sie daher beide mit Ihren eigenen Szenarien.
Muss ein Contact Center sein eigenes LLM trainieren?
In der Regel nicht. Der Optimierungsleitfaden von OpenAI beginnt mit Evals und Prompt Engineering und ergänzt Fine-Tuning nur für einige Anwendungsfälle. Ein eigenes Training bedeutet zudem, dass Sie die Trainingsdaten und einen Hold-out-Datensatz verantworten.
Ist ein benutzerdefiniertes LLM dasselbe wie ein feinabgestimmtes Modell?
Nicht immer. Auf den meisten Sprachplattformen ist ein benutzerdefiniertes LLM jedes Modell, das Sie selbst hosten und anbinden – es kann feinabgestimmt sein oder nicht. Die Option für benutzerdefinierte LLMs von Retell verbindet Ihr eigenes Modell über einen WebSocket, während Retell Telefonie, Transkription und Sprecherwechsel übernimmt.
Kann ein Contact Center mehr als ein LLM nutzen?
Ja. In Retell hat jeder Agent seine eigene Modelleinstellung, und die Dokumentation zu den LLM-Einstellungen beschreibt einen schnellen Fallback, der ein Backup-Modell parallel zum primären Modell ausführt.
Ist Tell-1 ein spezialisiertes LLM?
Ja. Tell-1 ist das eigene LLM von Retell, entwickelt für Contact-Center-Anrufe. Es belegt im Retell vCX Benchmark mit einem Durchschnitt von 94,45 insgesamt Platz 1 (Stand 13. November 2026). Es ist eine Option in der Modellauswahl von Retell, neben universellen Modellen von OpenAI, Anthropic und Google.
Vergleichen Sie Modelle an Ihren eigenen Anrufen, bevor Sie sich festlegen
Die Retell AI ist eine KI-Sprachagent-Plattform für Contact Center. Jeder Agent verfügt über eine Modellauswahl, und die Preisseite listet Modelle von OpenAI, Anthropic und Google sowie eine benutzerdefinierte Option für ein selbst gehostetes Modell auf. Tell-1, das eigene LLM von Retell, befindet sich in derselben Auswahl. Die Mitarbeitenden, die Ihren Kunden am nächsten sind, können das Modell selbst wechseln, die Test-Suite erneut ausführen und den Traffic aufteilen. Anders als bei der Zusammenarbeit mit einem Managed-KI-Anbieter wird diese Änderung nicht zu einem Ticket, einer Warteschlange oder einem weiteren SOW. Die Abrechnung ist nutzungsbasiert, ab 0,07 $ pro Minute laut Preisseite. Bringen Sie einen Anruftyp und Ihre eigenen Bestehenskriterien mit und führen Sie ein Pilotprojekt mit echten Anrufen durch, bevor Sie etwas unterschreiben.
Sehen Sie, wie viel Ihr Unternehmen durch den Wechsel zu KI-gestützten Sprachagenten sparen könnte.
ROI-Ergebnis
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Estimate your monthly voice AI cost
Read Other Blogs


Revolutionieren Sie Ihren Anrufbetrieb mit Retell


