KI-Agent-Benchmarks für Sprachagenten erklärt





Ein KI-Agent-Benchmark ist ein fester Satz von Aufgaben mit einer Bewertungsregel, mit dem Modelle bei derselben Arbeit verglichen werden. Für KI-Sprachagenten lohnen sich vier: τ²-bench (tau2-bench) für Tool-Nutzung unter einer Richtlinie, Multi-IF für das Befolgen von Anweisungen über mehrere Gesprächsrunden, GPQA Diamond für anspruchsvolles Schlussfolgern und der Retell vCX Benchmark für Anrufe im Contact Center. Jeder misst nur einen Ausschnitt dessen, was in einem Telefonanruf passiert.
Dieser Leitfaden erklärt, was jeder Benchmark testet, wie er bewertet wird und was der Score Ihnen nicht verrät. Die Retell AI veröffentlicht diesen Leitfaden und zugleich einen der vier Benchmarks, den vCX Benchmark. Die Scores ändern sich mit jedem neuen Modell-Release, daher verweist jeder Abschnitt auf die Quelle mit den aktuellen Ergebnissen.
Was ist ein KI-Agent-Benchmark?
Ein KI-Agent-Benchmark stellt jedem Modell dieselben Aufgaben und denselben Bewerter und gibt an, wie oft das Modell die Aufgabe richtig löst. Was ein Score bedeutet, hängt von der Aufgabe ab, davon, wer oder was die Gegenseite des Gesprächs übernimmt, und davon, wie über ein Bestehen entschieden wird.
Es gibt drei Arten von Bewertern. Eine Zustandsprüfung vergleicht das Ergebnis der Aktionen des Agenten mit einem bekannten korrekten Ergebnis, etwa einer Datenbank nach einer Rückerstattung. Eine Regelprüfung lässt ein Skript gegen die Antwort laufen. Ein Judge-Modell bewertet die Antwort anhand eines Bewertungsrasters. Zustands- und Regelprüfungen sind reproduzierbar, aber eng gefasst. Judge-Modelle können Ton und Bedeutung bewerten, haben aber ihre eigenen blinden Flecken.
Was messen die vier Benchmarks im direkten Vergleich?
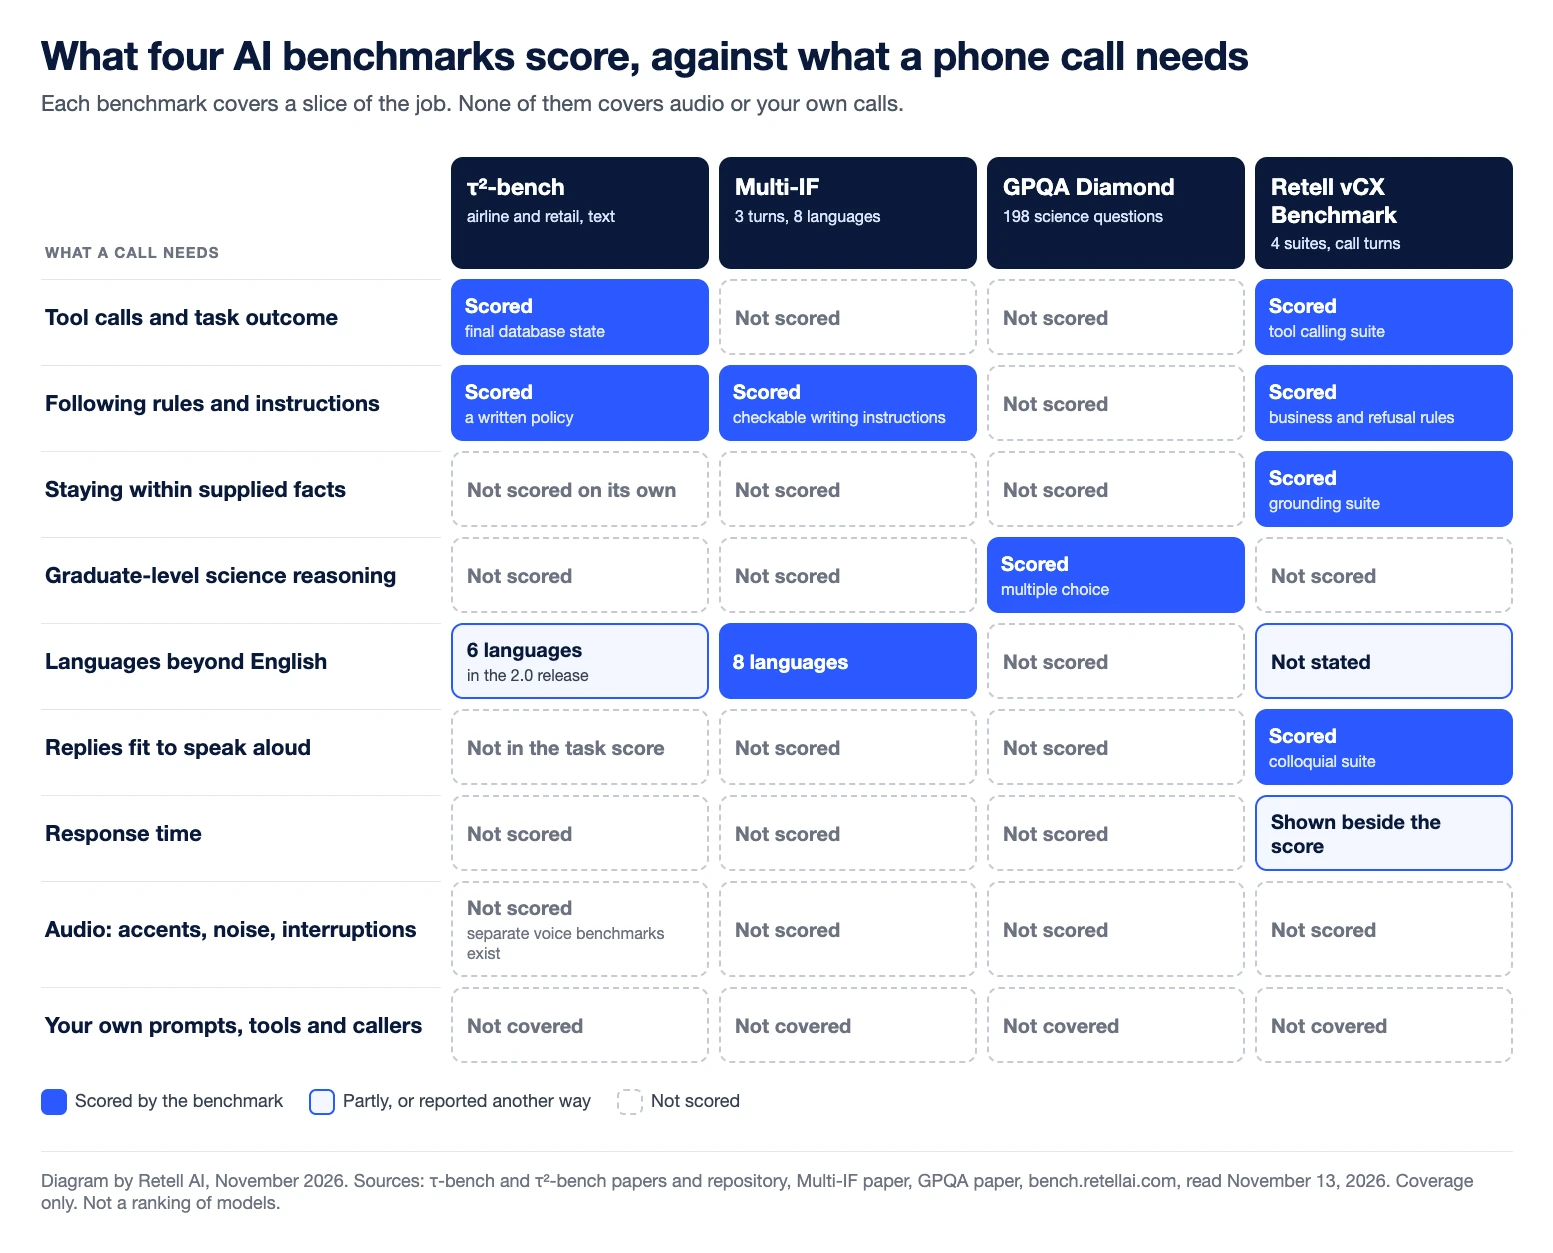
Sie decken unterschiedliche Fähigkeiten ab, und nur der vCX Benchmark basiert auf Telefonanrufen. Die Tabelle fasst jeden Benchmark anhand seines Papers, Repositorys oder Leaderboards zusammen, abgerufen am 13. November 2026.
| Benchmark | Veröffentlicht von | Worin die Aufgabe besteht | Wie bewertet wird | Was für Käufer von Sprachagenten fehlt |
|---|---|---|---|---|
| τ²-bench, Airline und Einzelhandel | Sierra | Einen simulierten Kunden in einem Textgespräch betreuen, mit Tools und nach einer schriftlichen Richtlinie | 0 oder 1 pro Gespräch: Die finale Datenbank muss dem Zielzustand entsprechen und erforderliche Informationen müssen genannt werden | Audio, Antwortzeit, Ihre eigene Richtlinie und Ihre eigenen Tools |
| Multi-IF | Meta | Überprüfbare Schreibanweisungen über drei Gesprächsrunden in acht Sprachen befolgen | Durchschnitt aus vier Genauigkeitswerten, pro Anweisung und pro Gespräch, strikt und locker | Tools, lange Skripte, gesprochene Wiedergabe |
| GPQA Diamond | Forschende der NYU, von Cohere und Anthropic | 198 von Fachleuten verfasste naturwissenschaftliche Multiple-Choice-Fragen beantworten | Anteil richtig beantworteter Fragen, Zufallsniveau 25 % | Gespräch, Tools, Anweisungen, Geschwindigkeit |
| Retell vCX Benchmark | Retell AI | Gesprächsrunden in Contact-Center-Anrufen über vier Testsuites hinweg bearbeiten | Bestehensquote pro Testsuite, gemittelt zu einem Gesamtscore | Audio, Ihre eigenen Anruftypen, Ergebnisse über einen vollständigen Anruf |
Was misst τ²-bench in den Domänen Airline und Einzelhandel?
τ²-bench misst, ob ein Agent eine Kundenservice-Aufgabe im Gespräch abschließen kann, während er eine schriftliche Richtlinie befolgt und die richtigen Tools aufruft. Ein Sprachmodell spielt den Kunden, und der Agent arbeitet mit einer simulierten Datenbank aus Bestellungen oder Reservierungen. Das ursprüngliche τ-bench-Paper baute die beiden Domänen mit 115 Einzelhandels- und 50 Airline-Aufgaben auf. Das τ²-bench-Paper verwendet verifizierte Versionen beider Domänen weiter und ergänzt eine Telekommunikationsdomäne.
Die Bewertung ist streng. Laut den Evaluierungshinweisen im Repository ist die Belohnung jeder Aufgabe das Produkt ihrer Prüfungen. Standardmäßig sind das eine Datenbankprüfung, die die finale Datenbank mit dem Zielzustand vergleicht, und eine Kommunikationsprüfung, die bestätigt, dass der Agent dem Kunden die erforderlichen Informationen gegeben hat. Jede Abfolge von Tool-Aufrufen, die den richtigen Endzustand erreicht, besteht.
Zwei gemeldete Kennzahlen sind wichtig. Pass^1 ist der Anteil der Aufgaben, die in einem einzigen Versuch gelöst werden. Pass^k ist der Anteil, der in allen k wiederholten Versuchen gelöst wird – eine Kennzahl, die das ursprüngliche Paper eingeführt hat, um Konsistenz zu erfassen. Dieses Paper von 2024 berichtete, dass selbst führende Function-Calling-Agenten der damaligen Zeit weniger als die Hälfte der Aufgaben lösten, mit pass^8 unter 25 % im Einzelhandel.
Was er Käufern von Sprachagenten nicht verrät: Die Text-Scores für Airline und Einzelhandel stammen aus getippten Gesprächen ohne Audio, ohne Unterbrechungen und ohne Zeitdruck. Richtlinien und Tools sind die des Benchmarks. Der simulierte Kunde ist ebenfalls ein Modell, und die Autoren von τ²-bench maßen Fehlerraten des Simulators von 40 % im Einzelhandel und 47 % bei Airline, wobei 12 % bzw. 13 % so schwerwiegend waren, dass sie die Aufgabe blockierten. Das gleiche Repository enthält inzwischen separate Sprach-Benchmarks, und sein Release 2.0 ergänzt sechs Sprachen und weist darauf hin, dass seine Scores nicht mit dem 1.x-Leaderboard vergleichbar sind. Prüfen Sie, aus welcher Version ein zitierter Score stammt.
Was misst Multi-IF?
Multi-IF misst, ob ein Modell Anweisungen im Gesprächsverlauf weiterhin befolgt und ob das auch außerhalb des Englischen gilt. Das Multi-IF-Paper von Meta erweitert einen früheren Single-Turn-Test, IFEval, auf 4.501 Gespräche mit je drei Gesprächsrunden in acht Sprachen: Englisch, Französisch, Russisch, Hindi, Italienisch, Portugiesisch, Spanisch und Chinesisch.
Die Anweisungen sind so formuliert, dass sie überprüfbar sind, etwa ein Kommaverbot oder die Regel, in Großbuchstaben zu antworten. Der Hauptscore mittelt vier Genauigkeitswerte. Die Genauigkeit auf Anweisungsebene zählt jede Anweisung für sich. Die Genauigkeit auf Gesprächsebene zählt ein Gespräch nur, wenn jede Anweisung bis zu dieser Runde befolgt wurde. Beide werden nach einem strikten und einem lockeren Kriterium angegeben.
Das zentrale Ergebnis des Papers ist der Grund, warum dieser Benchmark für Telefonagenten relevant ist: Jedes der 14 getesteten Modelle scheiterte mit jeder zusätzlichen Gesprächsrunde häufiger. Ein Modell fiel von 0,877 in der ersten Runde auf 0,707 in der dritten. Ein Agent, der eine Regel zu Beginn eines Anrufs befolgt und sie einige Wortwechsel später vergisst, scheitert auf dieselbe Weise.
Was er Käufern von Sprachagenten nicht verrät: Die Anweisungen sind Formatierungs- und Schreibvorgaben für Text, etwa zu Länge, Zeichensetzung und Schlüsselwörtern. Es sind keine Geschäftsregeln. Es gibt keine Tools, drei Gesprächsrunden sind im Vergleich zu einem echten Anruf kurz, und nichts wird laut gesprochen.
Was misst GPQA Diamond?
GPQA Diamond misst, ob ein Modell sehr schwierige naturwissenschaftliche Fragen beantworten kann, die sich nicht per Websuche lösen lassen. Das GPQA-Paper beschreibt 448 Multiple-Choice-Fragen aus Biologie, Physik und Chemie, verfasst und validiert von Personen, die promoviert sind oder promovieren. Diamond ist die Teilmenge von 198 Fragen, bei denen beide fachkundigen Validierenden richtig antworteten und die meisten Laien nicht.
Bewertet wird schlicht die Genauigkeit. Jede Frage hat vier Antwortoptionen, sodass zufälliges Raten 25 % erreicht. Auf dem vollständigen Datensatz erreichten Fachleute 65 % und versierte Laien mit uneingeschränktem Webzugang 34 %.
Was er Käufern von Sprachagenten nicht verrät: fast alles über einen Anruf. Es gibt kein Gespräch, keine zu befolgende Anweisung, kein Tool und kein Zeitlimit. Er ist ein Indikator für die Tiefe des Schlussfolgerns. Bei 198 Fragen sind kleine Abstände zwischen Modellen zudem ein schwacher Beleg, und die Autoren nennen die geringe Größe des Datensatzes selbst als Einschränkung.
Was misst der Retell vCX Benchmark?
Der Retell vCX Benchmark misst, wie Modelle Gesprächsrunden in Contact-Center-Anrufen über vier Testsuites hinweg bewältigen. Das Live-Leaderboard, abgerufen am 13. November 2026, beschreibt sie so:
- Befolgen von Anweisungen: ob das Modell Rollenvorgaben, Geschäftsregeln und Ablehnungsregeln einhält.
- Grounding: ob die Antworten innerhalb des Prompts, der Tools und des abgerufenen Kontexts bleiben.
- Tool-Aufrufe: ob das Modell die richtige Aktion wählt und gültige Argumente übergibt.
- Umgangssprache: ob die Antworten natürlich, prägnant und sicher zum lauten Aussprechen klingen.
Jede Testsuite meldet eine Bestehensquote über etwa 1.000 oder mehr Fälle, und der Gesamtscore ist der Durchschnitt der vier. Das Leaderboard führte an diesem Datum 62 Einträge über 45 Modelle und zeigt neben jedem Score die mediane Latenz und die Kosten pro Minute.
Die veröffentlichte Methodenbeschreibung ist der vCX-Hard-Beitrag, der die ersten beiden Testsets abdeckt: Grounding und Tool-Aufrufe. Die Fälle wurden aus Produktivanrufen gewonnen und über Organisationen hinweg gestichprobt, sodass kein einzelner Kunde dominiert. Ein Panel aus Judge-Modellen bewertet jeden Fall anhand eines Bewertungsrasters und einer Referenzlösung. Der Beitrag betrachtet eher die Rangfolge als den exakten Wert als das eigentliche Signal.
Was er Käufern von Sprachagenten nicht verrät: Es ist ein Anbieter-Benchmark, und der Anbieter hat selbst einen Eintrag. Tell-1, das eigene Modell von Retell, belegt im Retell vCX Benchmark insgesamt Platz 1 (Stand November 2026). Die Fälle stammen aus dem Anrufaufkommen von Retell, sodass Ihre Anruftypen unterrepräsentiert sein oder fehlen können. Die vier Testsuites bewerten Antworten und Tool-Aufrufe; Fehler bei der Spracherkennung, Unterbrechungen und die Frage, ob ein ganzer Anruf mit einer Lösung endet, liegen daher außerhalb ihres Rahmens. Auch Judge-Modelle können sich irren.
Wie schneidet Tell-1 bei diesen vier Benchmarks ab?
Tell-1, das eigene LLM von Retell, ist ein Praxisbeispiel dafür, wie man die vier zusammen liest. Retell veröffentlicht die unten stehenden öffentlichen Benchmark-Scores in seinem technischen Beitrag zum Retell LLM, und die vCX-Werte stammen aus dem Live-Leaderboard, abgerufen am 13. November 2026.
| Benchmark | Score von Tell-1 | Umfang des Durchlaufs | Durchgeführt von |
|---|---|---|---|
| τ²-bench Airline | 72,0 | 50 Aufgaben | Retell |
| τ²-bench Einzelhandel | 78,0 | 50 Aufgaben | Retell |
| Multi-IF | 82,1 | 504 Gespräche | Retell |
| GPQA Diamond | 83,5 | 198 Fragen × 3 | Retell |
| Retell vCX Benchmark | 94,45 im Durchschnitt, Platz 1 insgesamt von 62 Modellkonfigurationen | Vier Testsuites mit je etwa 1.000 Fällen | Retell |
Lesen Sie diese Werte so, wie es die obigen Abschnitte nahelegen. Jede Zeile ist ein eigener Durchlauf von Retell, bewertet auf einer Skala bis 100 mit jeweils demselben Greedy Decoding, und laut Retell wurde keiner der Benchmarks im Training verwendet. Der Multi-IF-Durchlauf umfasst 504 der 4.501 Gespräche des Benchmarks und die τ²-bench-Durchläufe 50 Aufgaben pro Domäne, sodass sie nicht direkt mit den Werten in den ursprünglichen Papers oder auf anderen Leaderboards vergleichbar sind.
Bei vCX unterscheiden sich die Scores der Testsuites: 96,6 % bei Umgangssprache (Rang 1), 97,2 % bei Grounding (Rang 2), 88,6 % beim Befolgen von Anweisungen (Rang 2) und 95,4 % bei Tool-Aufrufen (Rang 5). In drei der vier Testsuites liegen andere Modelle vorn. Hier gilt dieselbe Vorsicht wie bei jedem Modell: Diese Werte verschaffen Tell-1 einen Platz auf der Shortlist, und ein Test mit Ihren eigenen Anrufen entscheidet über den Rest.
Was verschweigen Benchmark-Scores Käufern von KI-Sprachagenten?
Benchmark-Scores lassen die Plattform rund um das Modell und die Bedingungen Ihrer eigenen Anrufe außen vor. Ein Telefonanruf bringt Spracherkennung, Sprecherwechsel, Sprachsynthese, Telefonie und Latenz in jeder Phase mit sich. Keiner der vier Benchmarks bewertet diese in der hier beschriebenen Form.
Ergebnisse können je nach Plattform variieren, selbst wenn der Agent identisch ist. In einer Studie des Testanbieters Cekura wurde ein Agent unverändert auf sechs Sprachplattformen bereitgestellt, und die Workflow-Scores lagen zwischen 65,2 % und 95,7 %. Die Zusammenfassung dieser Medicare-Studie von Retell erläutert die Methode und den dazugehörigen Offenlegungshinweis.
Wie sollten Käufer Benchmark-Scores nutzen?
Nutzen Sie Benchmark-Scores, um eine Shortlist zu erstellen, und entscheiden Sie dann anhand Ihrer eigenen Anrufe. Eine sinnvolle Reihenfolge:
- Wählen Sie den Benchmark passend zum Risiko: Ergebnisse zur Tool-Nutzung, wenn eine falsche Aktion der kostspielige Fehler ist, Befolgen von Anweisungen, wenn der Agent ein langes Skript einhalten muss.
- Prüfen Sie die Version, das Datum und wer den Test durchgeführt hat.
- Bevorzugen Sie Werte aus wiederholten Durchläufen wie pass^k, sofern sie angegeben sind.
- Bauen Sie den Test mit Ihren eigenen Szenarien nach und werten Sie ein Szenario nur dann als bestanden, wenn alle wiederholten Durchläufe bestehen.
Bei Retell lassen Simulationstests eine KI den Anrufer spielen, während Erfolgskriterien jeden Durchlauf als bestanden oder nicht bestanden bewerten, und Batch-Tests führen gespeicherte Fälle nach jeder Prompt-Änderung erneut aus. Nach dem Go-live bewertet KI-QA eine Stichprobe echter Anrufe anhand von Kriterien wie Halluzinationen und Tool-Nutzung, und A/B-Tests teilen den Live-Traffic auf zwei Agenten auf. Zur Modellwahl lesen Sie, welches LLM Ihren KI-Sprachagenten antreiben sollte. Zum Kaufprozess lesen Sie, wie Sie eine Plattform für KI-Sprachagenten bewerten.
Ein Benchmark zeigt Ihnen, welche Modelle einen Test verdienen. Ein Pilot mit echten Anrufen zeigt Ihnen, welches Sie einsetzen sollten. Die Retell AI ist eine Plattform für KI-Sprachagenten für Contact Center mit Preisen ab 0,07 $ pro Minute, sodass Sie sie mit Ihren eigenen Anrufen erproben können, bevor Sie etwas unterschreiben.
Häufig gestellte Fragen
Was ist der Unterschied zwischen pass^1 und pass^k?
Pass^1 ist der Anteil der Aufgaben, die ein Agent in einem einzigen Versuch löst. Pass^k ist der Anteil, den er in jedem von k wiederholten Versuchen bei derselben Aufgabe löst. Pass^k ist immer gleich oder niedriger als pass^1, und der Abstand zeigt, wie konsistent der Agent ist.
Ist τ-bench dasselbe wie τ²-bench?
Nein. τ-bench ist der ursprüngliche Benchmark von 2024 mit den Domänen Airline und Einzelhandel. τ²-bench ist der Nachfolger von 2025 derselben Gruppe, der verifizierte Versionen dieser beiden Domänen beibehält und eine Telekommunikationsdomäne ergänzt, in der auch der simulierte Kunde Tools nutzt.
Warum wird ein naturwissenschaftlicher Test wie GPQA Diamond genutzt, um Modelle für Kundengespräche zu vergleichen?
GPQA Diamond dient als allgemeines Maß für die Fähigkeit zum Schlussfolgern. Über Gespräche, Tools oder Sprache sagt er direkt nichts aus. Verstehen Sie ihn als Prüfung der Tiefe des Schlussfolgerns und verlassen Sie sich für alles Weitere auf aufgabenbezogene Benchmarks.
Welcher Benchmark ist für einen KI-Sprachagenten am wichtigsten?
Keiner für sich allein. Tool-Nutzung unter einer Richtlinie, das Befolgen von Anweisungen über mehrere Gesprächsrunden und Grounding entsprechen am ehesten der Arbeit im Contact Center, daher passen τ²-bench, Multi-IF und der vCX Benchmark am besten. Ein bewerteter Test mit Ihren eigenen Anrufszenarien ist wichtiger als jeder von ihnen.
Wie hat Tell-1 bei τ²-bench, Multi-IF und GPQA Diamond abgeschnitten?
Retell meldet für Tell-1 72,0 bei τ²-bench Airline, 78,0 bei τ²-bench Einzelhandel, 82,1 bei Multi-IF und 83,5 bei GPQA Diamond, jeweils von 100. Dies sind eigene Durchläufe von Retell mit 50 Aufgaben pro τ²-bench-Domäne, 504 Multi-IF-Gesprächen und den 198 Fragen von GPQA Diamond.
Sehen Sie, wie viel Ihr Unternehmen durch den Wechsel zu KI-gestützten Sprachagenten sparen könnte.
ROI-Ergebnis
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Estimate your monthly voice AI cost
Read Other Blogs


Revolutionieren Sie Ihren Anrufbetrieb mit Retell


