A régua de compra de IA de voz mudou: da fala natural à iteração rápida e segura




Critérios de avaliação de IA de voz são os testes que um comprador usa para decidir se uma plataforma de agentes de voz vai funcionar bem nas próprias linhas telefônicas. A fala com som natural costumava ser o teste decisivo. Agora é o requisito mínimo. Quando todos os fornecedores da lista final soam bem em uma chamada, a pergunta decisiva é a rapidez com que sua equipe consegue alterar o agente, e com que segurança.
Um padrão aparece nas conversas de compra. A primeira rodada de avaliação compara vozes, latência e interrupções. A segunda rodada pergunta o que acontece no dia 40, quando uma política muda, uma campanha ativa precisa de um novo roteiro ou um modelo mais novo é lançado. Um fornecedor que não consegue responder a essas perguntas com uma demonstração ao vivo do processo de mudança está vendendo o lançamento e deixando a operação para você.
A Retell AI publica este guia e vende uma plataforma de agentes de voz. As perguntas valem para qualquer fornecedor, inclusive nós, e indicamos onde nossas próprias respostas documentadas têm limites.
Por que a fala natural já não basta para escolher um fornecedor?
Porque a qualidade da voz decide a primeira semana de vida de um agente, e a capacidade de mudança decide o resto. Você ainda precisa verificar se o agente soa bem nas suas chamadas: como avaliar uma plataforma de agentes de voz antes de entrar em produção aborda latência, interrupções, transcrição e transferências em um piloto. Mas um agente de voz nunca está pronto. Quem liga formula as coisas de jeitos que seus roteiros não previam, preços e políticas mudam e surgem novos tipos de chamada.
Cada uma dessas mudanças é um lançamento em produção em uma linha telefônica, onde uma frase ruim chega a quem está ligando antes que alguém leia a transcrição. É por isso que a régua tem duas partes, velocidade e segurança, e por isso você deve pontuar as duas.
Equipes de software já medem a entrega dessa forma. O DORA, um programa de pesquisa conduzido pelo Google Cloud, divide o desempenho de entrega de software em vazão e instabilidade: com que rapidez as mudanças chegam à produção e com que frequência exigem rollback ou hotfix. O DORA relata que "velocidade e estabilidade não são trade-offs" e que as métricas são correlacionadas para a maioria das equipes. Um fornecedor não deveria pedir que você escolha entre alterar o agente rapidamente e alterá-lo com segurança.
Em quais mudanças você deve pontuar um fornecedor?
Pontue as mudanças que você realmente vai fazer, e não uma nota genérica de "facilidade de uso". Cada tipo de mudança traz um risco diferente, então pergunte sobre cada um separadamente.
| Mudança | Exemplo | Como é ser rápido | Como é ser seguro |
|---|---|---|---|
| Redação do prompt | Reescrever a política de reembolso | O responsável pelo agente edita sem precisar de um engenheiro | Uma versão numerada, um diff visível e uma execução de teste antes que quem liga ouça |
| Conteúdo de conhecimento | Nova tabela de preços ou horário de funcionamento | Atualizar a fonte uma única vez | Você sabe quando a atualização chega às respostas ao vivo |
| Fluxo de conversa | Adicionar uma ramificação para um novo motivo de chamada | Editar o fluxo no editor | Partes compartilhadas não alteram outros agentes de surpresa |
| Modelo | Migrar para um LLM mais novo ou mais barato | Sem reescrever o prompt | A mesma suíte de testes roda nos dois modelos antes da troca |
| Campanha ativa | Novo roteiro no meio da campanha | Trocar a versão do agente que a campanha usa | Um rascunho não chega às discagens ao vivo por acidente |
| Voz ou saudação | Nova voz ou frase de abertura | Alterar nas configurações | Alguém ouve em uma chamada antes do lançamento |
O restante deste guia transforma essa tabela em perguntas. Para o processo prático de lançamento depois de escolher uma plataforma, veja como testar e lançar mudanças em agentes de voz.
O que perguntar sobre a velocidade de iteração?
Pergunte quem pode fazer uma mudança e quanto tempo leva uma correção real; depois, peça ao fornecedor que mostre.
- Quem na nossa equipe pode alterar o agente, e essa pessoa precisa de um engenheiro? A resposta deve nomear uma função do seu lado, não a equipe de serviços do fornecedor. O controle de acesso da Retell separa as funções que podem criar, testar e editar agentes de uma função Member somente leitura.
- Quanto tempo leva de uma chamada com falha até uma correção nas chamadas ao vivo? Não aceite uma estimativa. Escolha uma chamada com falha do piloto, de preferência uma que mostre um modo de falha de agente de voz conhecido, e peça ao seu próprio responsável que a corrija, verifique e lance enquanto você observa.
- Podemos testar mais de uma correção ao mesmo tempo? As versões de agente da Retell permitem criar um rascunho a partir de qualquer versão anterior e manter vários rascunhos ao mesmo tempo para testar abordagens diferentes.
- Uma chamada com falha pode virar um caso de teste sem ser escrita à mão? Na Retell, o Conductor pode transformar uma chamada do Call History ou do AI QA em um caso de teste de simulação, redigindo a persona e os critérios de sucesso. A documentação alerta que você ainda deve revisar cada caso e simular (mock) qualquer função que acesse um endpoint real.
- A suíte de regressão pode rodar a partir do nosso próprio pipeline? A API de testes em lote da Retell inicia um lote e, quando consultada, retorna as contagens de aprovações, falhas e erros, para que um job de CI possa verificar os resultados antes de você implantar.
- Trocar de modelo significa reescrever? Para agentes de prompt único e multi-prompt, a documentação da Retell diz que você pode trocar de modelo depois sem reescrever o prompt.
- Quanto custa iterar? Na Retell, os testes são cobrados pelas tarifas de produção, por mensagem nos testes de texto e por minuto nos testes web e por telefone. Inclua isso no orçamento, porque uma suíte que você não pode pagar para rodar de novo não vai ser rodada de novo.
O que perguntar sobre a segurança da iteração?
Pergunte como uma mudança é contida antes do lançamento, como é exposta depois do lançamento e com que rapidez pode ser desfeita.
- Toda mudança é uma versão fixa à qual você pode voltar? Na Retell, publicar uma versão de agente em rascunho a torna somente leitura, "oferecendo uma configuração fixa à qual você pode voltar depois". O conceito é explicado em versionamento de prompts.
- Podemos ver exatamente o que mudou? A comparação de versões da Retell mostra duas versões lado a lado, com diffs palavra a palavra para textos longos de prompt e alterações em bases de conhecimento e funções vinculadas.
- Uma mudança pode chegar a alguns chamadores antes de chegar a todos? O SRE workbook do Google define canarying como "uma implantação parcial e por tempo limitado de uma mudança em um serviço e sua avaliação". Na Retell, o teste A/B divide o tráfego de entrada ou de saída de um número entre agentes por porcentagem. Cada agente também começa com as tags de ambiente prod e staging, para que você possa apontar staging para uma nova versão e ligar para ela primeiro em um número de teste.
- Como fazemos o rollback, e todos os números acompanham? Na Retell, você move a tag prod de volta para a versão anterior e os números vinculados à tag a acompanham. Números atribuídos diretamente a uma versão permanecem nessa versão, então pergunte como verificar quais números usam a tag.
- O que nos diz que uma mudança piorou as coisas? O painel de analytics da Retell detalha as métricas por versão do agente, as regras de alerta podem ser limitadas a tags de ambiente e comparadas com o ciclo anterior, e o AI QA pontua uma amostra de chamadas em busca de problemas como alucinações.
Depois, faça a pergunta que a maioria das avaliações pula: quais mudanças contornam o fluxo de lançamento? Toda plataforma tem algumas. Um fornecedor que nomeia as suas é mais fácil de operar com segurança do que um que afirma não ter nenhuma. Aqui estão as da Retell, segundo a documentação:
- Subfluxos compartilhados. Um subfluxo de biblioteca é compartilhado entre agentes, e uma edição chega a todos os agentes que o usam, incluindo versões publicadas. A documentação recomenda convertê-lo em um subfluxo local antes de publicar se você quiser evitar isso.
- Conhecimento com atualização automática. Com a atualização automática ativada, uma base de conhecimento busca novamente suas fontes de URL e ressincroniza os arquivos conectados alterados a cada 24 horas; assim, uma edição em uma página de origem pode chegar às respostas na próxima atualização, e não por meio de uma nova versão do agente.
- Campanhas configuradas para o rascunho mais recente. Uma etapa de campanha pode usar uma versão fixa, a versão publicada mais recente, uma tag ou a versão criada mais recentemente. A documentação do Dialer desaconselha o Latest Created, porque um rascunho que você ainda está editando chega às chamadas ao vivo na próxima discagem.
Campanhas ativas e trocas de modelo exigem perguntas diferentes?
Sim, porque ambas alteram chamadas ao vivo de maneiras que uma edição de prompt não altera.
Campanhas. Uma campanha ativa em andamento são muitas chamadas futuras enfileiradas para um mesmo agente. Pergunte qual versão cada discagem usa e o que você pode alterar quando a campanha já estiver rodando. O Dialer da Retell resolve a versão do agente a cada discagem, não no lançamento; assim, uma versão fixa mantém o agente estável durante toda a campanha, e o Latest Published incorpora a ela as mudanças publicadas. A sequência e a lista de contatos são travadas no lançamento, e alterá-las significa duplicar a campanha. Uma pausa interrompe novas discagens em cerca de um minuto, enquanto as chamadas já feitas são concluídas.
Modelos. Uma troca de modelo pode alterar redação, chamadas de ferramentas e tempo de resposta de uma só vez. Pergunte se a mesma suíte de testes pode rodar no modelo antigo e no novo, e se você pode usar um modelo de backup rápido. Para agentes de voz em modelos gerenciados pela Retell, as configurações de LLM da Retell oferecem um modelo de fallback rápido que roda em paralelo ao principal, e a documentação recomenda verificar se os dois modelos seguem as instruções e chamam as ferramentas corretamente antes de implantar. Ela também recomenda testar novamente as instruções e as chamadas de ferramentas depois de alterar a temperatura.
Como pontuar fornecedores em iteração rápida e segura?
Execute os mesmos quatro exercícios em cada plataforma da lista final durante o piloto, com a pessoa que será responsável pelo agente fazendo o trabalho, e cronometre cada um.
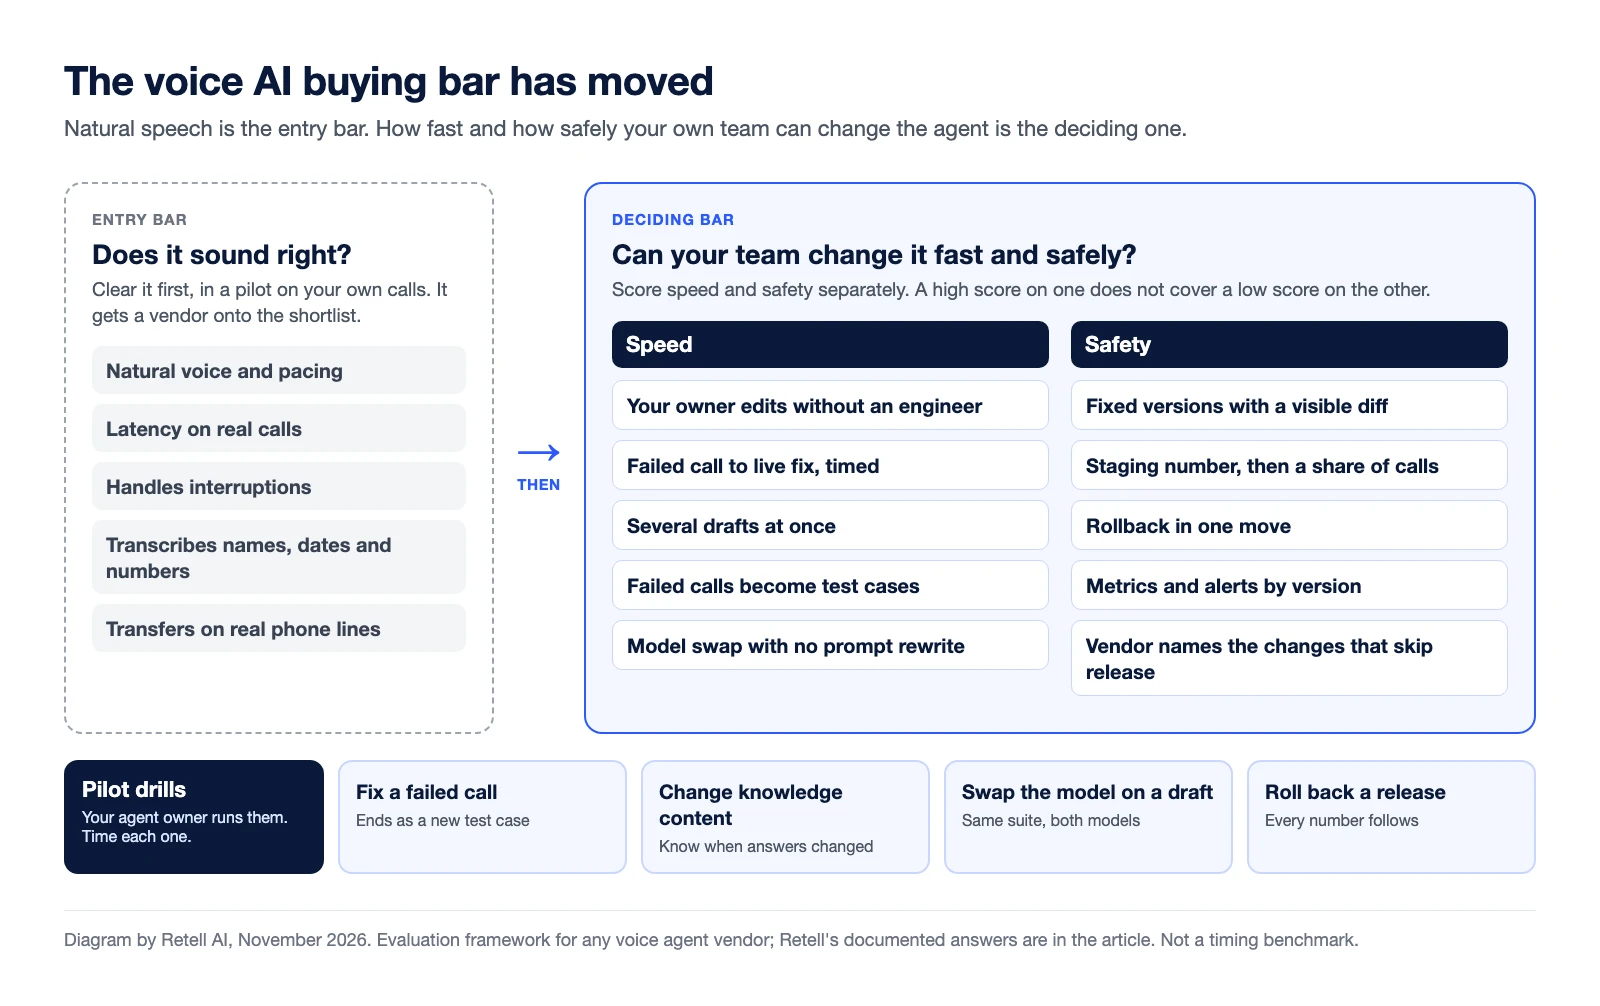
| Exercício | O que registrar | Um resultado aprovado |
|---|---|---|
| Corrigir uma chamada com falha | Tempo desde encontrar a chamada até a correção rodando em um número de staging | Seu responsável faz isso sem ajuda do fornecedor, e a chamada com falha agora é um caso de teste |
| Alterar conteúdo de conhecimento | Quando a mudança chegou às respostas ao vivo e como você confirmou | Você consegue dizer quais chamadas ouviram o conteúdo antigo e quais ouviram o novo |
| Trocar o modelo em um rascunho | Taxa de aprovação da mesma suíte de testes nos dois modelos | A suíte roda de novo sem reescrita, e o resultado decide a troca |
| Reverter um lançamento ruim | Tempo desde a decisão até todos os números de produção estarem na versão anterior | Um único movimento, e você consegue mostrar quais números acompanharam |
Pontue velocidade e segurança separadamente, de um a cinco cada, e não deixe que uma nota alta em uma esconda uma nota baixa na outra. Uma plataforma em que as correções são lançadas em uma hora, mas não podem ser revertidas, é reprovada. O mesmo vale para uma em que toda mudança é segura, mas exige abrir um chamado com o fornecedor. O próprio conselho do DORA para melhorar as duas ao mesmo tempo é manter cada mudança pequena: "Mudanças menores também são mais fáceis de recuperar se houver uma falha."
Duas outras páginas abordam decisões relacionadas. Desenvolver, comprar ou usar um serviço gerenciado define quem executa esses exercícios; veja desenvolver ou comprar agentes de voz com IA. O argumento financeiro para o programa está em o ROI dos agentes de voz com IA. Este scorecard pressupõe que ambos estão resolvidos e pergunta apenas se sua equipe consegue continuar melhorando o agente. Quais chamadas automatizar primeiro é uma decisão à parte, abordada em como escolher casos de uso de IA de voz.
Perguntas frequentes
Quais são os critérios mais importantes ao avaliar uma plataforma de IA de voz?
Comece verificando se ela conclui seu fluxo de trabalho nas suas próprias chamadas, se integra aos seus sistemas de telefonia e de dados e se soa natural. Quando os fornecedores da lista final passam nesses testes, o critério que os diferencia é a iteração: a rapidez com que sua equipe consegue alterar prompts, conhecimento, fluxos, campanhas e modelos, e a segurança com que essas mudanças chegam a quem liga.
Como testar a rapidez com que um fornecedor permite alterar um agente de voz?
Escolha uma chamada com falha do piloto e peça à pessoa que será responsável pelo agente que a corrija, verifique, lance em um número de teste e faça o rollback enquanto você cronometra. Repita com uma mudança de conhecimento e uma troca de modelo em um rascunho. Uma demonstração gravada pela equipe do próprio fornecedor não conta.
O que torna segura uma mudança em um agente de voz?
Uma mudança segura é uma versão fixa com um diff visível, passa por uma suíte de testes salva antes do lançamento, chega primeiro a uma pequena parcela das chamadas e pode ser revertida em um único movimento. Você também precisa saber quais mudanças pulam esse fluxo, como componentes compartilhados ou conhecimento com atualização automática.
Quem deve executar os exercícios de iteração durante um piloto?
A pessoa que será responsável pelo agente após o lançamento, não a equipe do fornecedor. Algumas equipes atribuem essa função a um engenheiro de automação de CX, o responsável interno que encontra chamadas mal conduzidas, cria correções, verifica e as implanta.
É possível trocar o modelo de linguagem por trás de um agente de voz sem reconstruí-lo?
Muitas plataformas permitem, mas você não deve trocar às cegas. Rode a mesma suíte de testes nos dois modelos, compare os resultados e lance o novo modelo primeiro para uma parcela das chamadas. Nos agentes de prompt único e multi-prompt da Retell, a documentação diz que você pode trocar de modelo depois sem reescrever o prompt, e recomenda verificar se um modelo de fallback segue suas instruções e testar novamente as chamadas de ferramentas depois de alterar a temperatura.
Coloque a iteração no seu scorecard de avaliação
A régua de compra de IA de voz passou de "soa humano?" para "conseguimos alterá-lo rapidamente sem quebrar chamadas?". A Retell é uma plataforma de agentes de voz com IA para centrais de atendimento, com versões em rascunho, comparação de versões, tags de ambiente, testes de simulação e em lote, divisão de tráfego A/B e AI QA, para que a pessoa responsável pelo agente possa testar, lançar e reverter uma mudança sem depender de um fornecedor. O preço é por pagamento conforme o uso, a partir de $0.07 por minuto, na página de preços. Leve sua mudança mais difícil para o piloto e cronometre.
Veja quanto seu negócio poderia economizar ao migrar para agentes de voz com IA.
Resultado do ROI
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Um número de telefone de demonstração do consultório da Retell Clinic
What results look like with Retell AI


Estimate your monthly voice AI cost
Read Other Blogs

Revolucione sua operação de chamadas com a Retell


