O raciocínio intercalado é uma forma de executar um modelo de raciocínio em que o modelo alterna entre o raciocínio privado e ações visíveis, como chamadas de ferramentas ou partes da resposta, em vez de concluir todo o raciocínio antes de responder.
Ele também é chamado de pensamento intercalado (interleaved thinking). A documentação dos fornecedores usa o termo principalmente para o raciocínio entre chamadas de ferramentas. Os artigos de pesquisa o usam para um modelo que alterna o pensamento com partes da resposta. Ambos descrevem a mesma mudança: o raciocínio deixa de ser um bloco único no início do turno.
O que é um modelo de raciocínio?
Um modelo de raciocínio é um grande modelo de linguagem que gera um raciocínio intermediário antes da resposta. O guia de raciocínio da OpenAI resume em uma linha: "Os modelos de raciocínio usam tokens de raciocínio internos antes de produzir uma resposta." A documentação do Gemini, do Google, diz que um modelo de pensamento "raciocina internamente antes de responder", e a documentação da DeepSeek diz que seu modo de pensamento produz um raciocínio em cadeia (chain-of-thought) "para melhorar a precisão da resposta final".
O que são tokens de raciocínio?
Tokens de raciocínio, também chamados de tokens de pensamento, são os tokens que um modelo gera enquanto trabalha em um problema. Eles não fazem parte da resposta. Três propriedades importam:
- Eles são cobrados. A OpenAI diz que os tokens de raciocínio "são cobrados como tokens de saída". A documentação de pensamento da Anthropic diz o mesmo sobre o Claude, "mesmo quando o texto do pensamento não é retornado a você". O Google precifica uma resposta como "a soma dos tokens de saída e dos tokens de pensamento".
- Eles costumam ficar ocultos. Os tokens de raciocínio da OpenAI "não são visíveis pela API". A Anthropic diz que o que você vê "nunca é a cadeia de pensamento bruta". Ambas podem retornar um resumo se você pedir.
- Eles consomem tempo e espaço. A OpenAI diz que um modelo pode gerar "de algumas centenas a dezenas de milhares de tokens de raciocínio" em uma única solicitação, e eles ocupam a janela de contexto.
Os desenvolvedores controlam a quantidade com uma configuração: reasoning effort na OpenAI, effort na Anthropic, thinking level no Google.
Qual é a diferença entre o raciocínio intercalado e o raciocínio prévio?
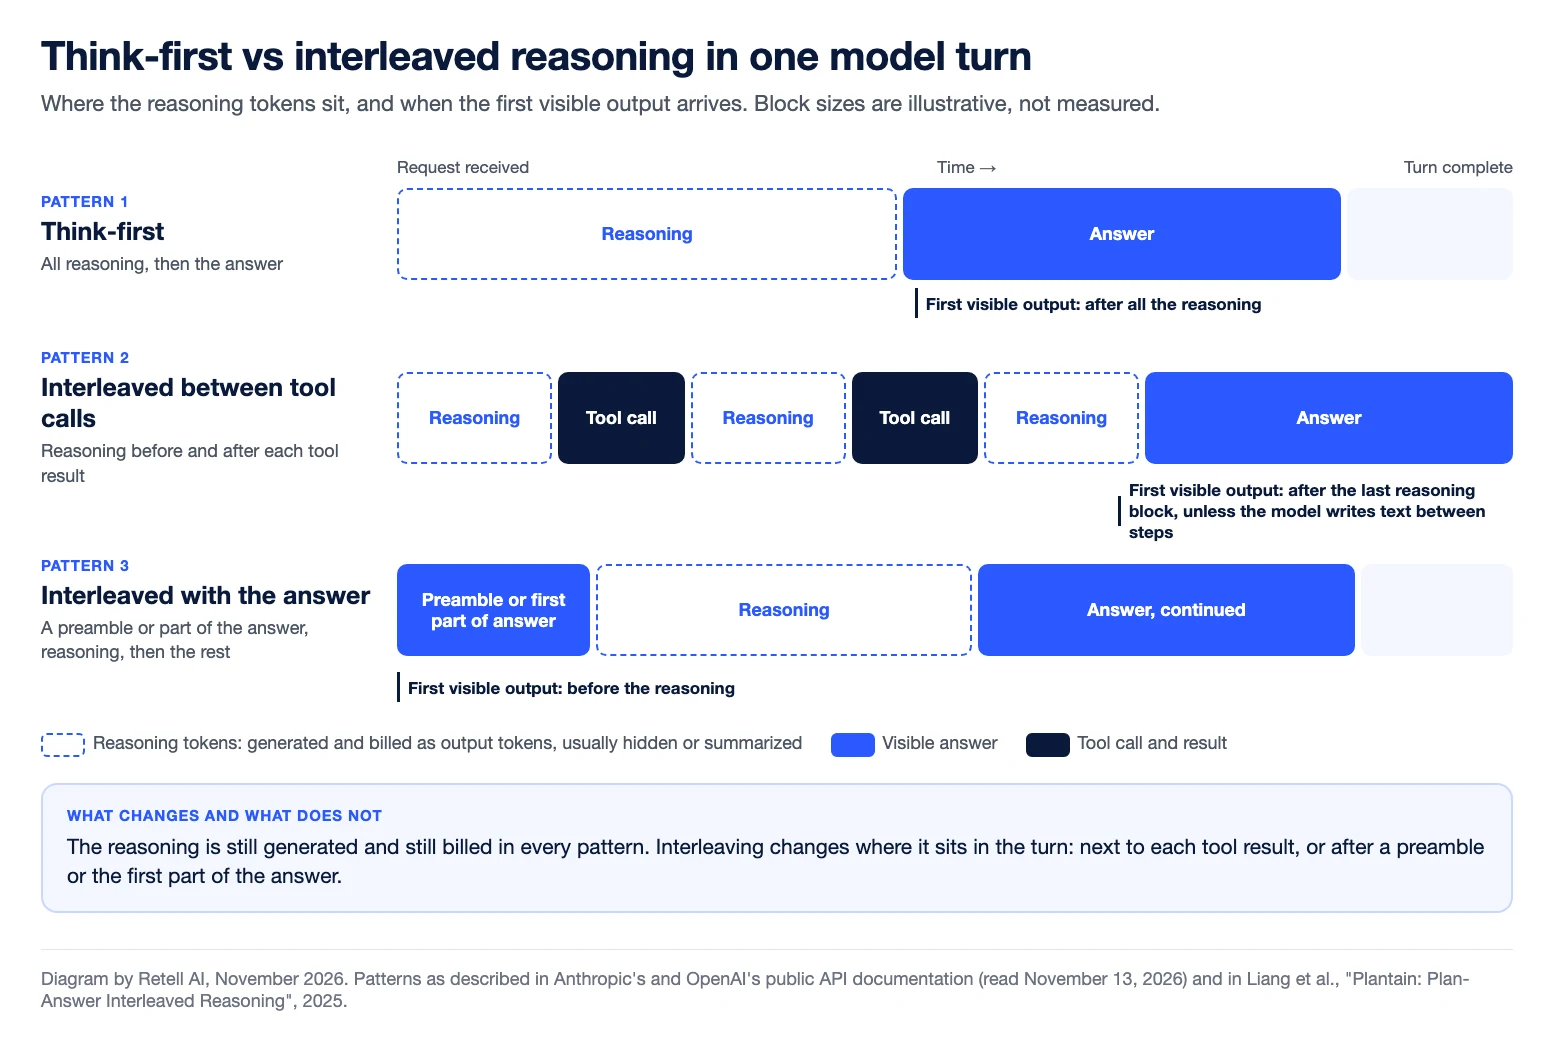
No raciocínio prévio (think-first), todo o raciocínio acontece antes do primeiro token visível. A Anthropic chama isso de pensamento antecipado (up-front thinking): os blocos de pensamento "chegam antes dos blocos de texto". O raciocínio intercalado divide o raciocínio em blocos menores e os posiciona onde são necessários.
| Padrão | Ordem do trabalho em um turno | Primeira coisa que o usuário vê | Descrito publicamente por |
|---|---|---|---|
| Sem raciocínio | Resposta | O início da resposta | Qualquer modelo com o raciocínio desativado |
| Raciocínio prévio | Todo o raciocínio, depois a resposta | Nada até o raciocínio terminar | Anthropic (pensamento antecipado), DeepSeek |
| Intercalado entre chamadas de ferramentas | Raciocinar, chamar uma ferramenta, ler o resultado, raciocinar de novo e então responder | Nada até o último bloco de raciocínio terminar, a menos que o modelo escreva texto entre as etapas | Anthropic, OpenAI, vLLM, DeepSeek (sem usar o termo) |
| Intercalado com a resposta | Um preâmbulo ou parte da resposta, raciocínio, mais da resposta | Um preâmbulo ou uma parte inicial da resposta | OpenAI, artigos de pesquisa |
| Intercalado com a fala | Primeira frase da resposta, raciocínio silencioso enquanto ela é reproduzida, depois o restante da resposta | A primeira frase da resposta | Tell-1, o LLM próprio da Retell |
O que os fornecedores documentam hoje?
Consultado em 13 de novembro de 2026:
- Anthropic. "O pensamento intercalado permite que o Claude pense entre chamadas de ferramentas, raciocinando sobre cada resultado de ferramenta antes de agir com base nele." Ele é automático nos modelos compatíveis com pensamento adaptativo. Modelos com pensamento estendido manual precisam de um cabeçalho beta.
- OpenAI. Modelos como o gpt-5.5 "suportam pensamento intercalado, em que o modelo consegue gerar tokens de saída visíveis antes e entre os pensamentos, e consegue pensar entre chamadas de ferramentas".
- Google. A página de pensamento do Gemini não usa o termo. Ela diz que as etapas de pensamento "aparecem cronologicamente junto com chamadas de função, entradas do usuário ou saídas do modelo", e que as assinaturas de pensamento são "necessárias para manter a continuidade do raciocínio em interações de vários turnos".
- vLLM. O servidor de inferência de código aberto suporta pensamento intercalado para duas séries de modelos e alerta que isso "aumenta o uso de tokens e a latência de resposta".
Na pesquisa, Xie et al. (2025) treinaram modelos "para intercalar pensamento e resposta" e relatam uma redução média de mais de 80% no tempo até o primeiro token. Liang et al. (2025) definem o raciocínio intercalado como um modelo que "alterna entre pensar e apresentar respostas intermediárias" e relatam que sua variante com planejamento prévio, Plantain, reduziu em mais de 60% o tempo até a primeira resposta. Ambos estudaram tarefas de texto.
Por que o raciocínio prévio gera silêncio em uma ligação?
Em uma ligação, a síntese de voz não pode começar até que o modelo produza as primeiras palavras da resposta. Cada token de raciocínio gerado antes dessas palavras é tempo em que quem ligou não ouve nada. Em uma janela de chat, a mesma espera é um indicador de progresso. Em uma ligação, é silêncio no ar e mais latência.
A documentação de solução de problemas de latência da Retell diz que modelos maiores e orientados a raciocínio "são mais lentos até o primeiro token" e "trocam latência por capacidade". A OpenAI lista voz como um caso de uso comum para executar com o reasoning effort definido como none, e sugere que aplicações sensíveis à latência "peçam ao modelo para gerar um breve preâmbulo antes de continuar com um raciocínio mais profundo". O guia sobre o melhor LLM para agentes de voz com IA aborda a escolha do modelo.
O que é raciocínio intercalado em um agente de voz?
Em um agente de voz, raciocínio intercalado significa que o modelo escreve a primeira frase da resposta imediatamente, raciocina em silêncio enquanto essa frase é falada e então continua a resposta com base nesse raciocínio. Quem ligou ouve uma resposta contínua, e o raciocínio nunca é falado.
O Tell-1 funciona assim. O artigo técnico da Retell, Retell LLM: Interleaved Reasoning for Real-Time Voice Agents, descreve o formato como "uma abertura falada, depois o raciocínio, depois o restante da resposta". O artigo relata, em média, 200 tokens de raciocínio no meio da resposta, e que 99,98% dos turnos fazem uma pausa de menos de 400 ms após a primeira frase.
Em comparação com o raciocínio prévio, quem ligou não espera em silêncio o raciocínio terminar. O artigo também aponta a contrapartida: "falar mais cedo significa se comprometer com a abertura antes de qualquer raciocínio acontecer". O Tell-1 ocupa o 1º lugar geral no Retell vCX Benchmark (em novembro de 2026).
Perguntas frequentes sobre raciocínio intercalado
Raciocínio intercalado é o mesmo que pensamento intercalado?
Sim, na maioria dos usos. A Anthropic e a OpenAI dizem interleaved thinking (pensamento intercalado); os artigos de pesquisa tendem a dizer interleaved reasoning (raciocínio intercalado).
Os tokens de raciocínio são cobrados?
Sim. OpenAI, Anthropic e Google os contabilizam como saída cobrada. A OpenAI e a Anthropic os cobram mesmo quando o texto do raciocínio não é retornado.
É possível ler os tokens de raciocínio de um modelo?
Normalmente não. A OpenAI e a Anthropic podem retornar um resumo se você pedir. Nenhuma das duas retorna o raciocínio bruto.
O raciocínio intercalado faz um modelo responder mais rápido?
Não por si só. Entre chamadas de ferramentas, ele adiciona tokens, e a documentação do vLLM alerta que isso aumenta a latência de resposta. A primeira saída visível só chega mais cedo quando a saída visível vem antes do raciocínio, ou entre blocos mais curtos dele.
O que é raciocínio intercalado em IA de voz?
É um modelo que começa a falar imediatamente, raciocina em silêncio enquanto sua primeira frase é reproduzida e então conclui a resposta usando esse raciocínio. O Tell-1, o LLM próprio da Retell, foi construído dessa forma.
Execute modelos de raciocínio em chamadas ao vivo
A Retell AI é uma plataforma de agentes de voz com IA para centrais de atendimento. Você escolhe o modelo por trás de cada agente. O Tell-1 é um deles. Fale com a equipe da Retell.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


