SSML (Speech Synthesis Markup Language, ou linguagem de marcação de síntese de fala) é uma linguagem de marcação baseada em XML que indica a um mecanismo de conversão de texto em fala (TTS) como dizer um trecho de texto: onde pausar, como pronunciar uma palavra, como ler um número ou uma data e com que velocidade, volume ou tom falar. O mecanismo lê as tags como instruções e não as pronuncia.
SSML é um padrão do World Wide Web Consortium (W3C). A versão atual, SSML 1.1, tornou-se uma Recomendação do W3C em 7 de setembro de 2010 e foi produzida pelo Voice Browser Working Group do W3C. A especificação define seu propósito como oferecer aos autores "uma forma padrão de controlar aspectos da fala, como pronúncia, volume, tom, velocidade etc., em diferentes plataformas com capacidade de síntese".
Como é o SSML na prática?
Um documento SSML é um XML com um único elemento raiz, <speak>. Este pequeno exemplo é SSML 1.1 válido:
<speak version="1.1" xmlns="http://www.w3.org/2001/10/synthesis" xml:lang="en-US">
  Your code is <say-as interpret-as="characters">B7X4</say-as>.
  <break time="400ms"/>
  It ships to <phoneme alphabet="ipa" ph="ˌmænɪˈtoʊbə">Manitoba</phoneme>
  on <say-as interpret-as="date" format="yyyymmdd" detail="1">2026-11-19</say-as>.
  Questions go to <sub alias="Doctor">Dr.</sub> Lee.
</speak>
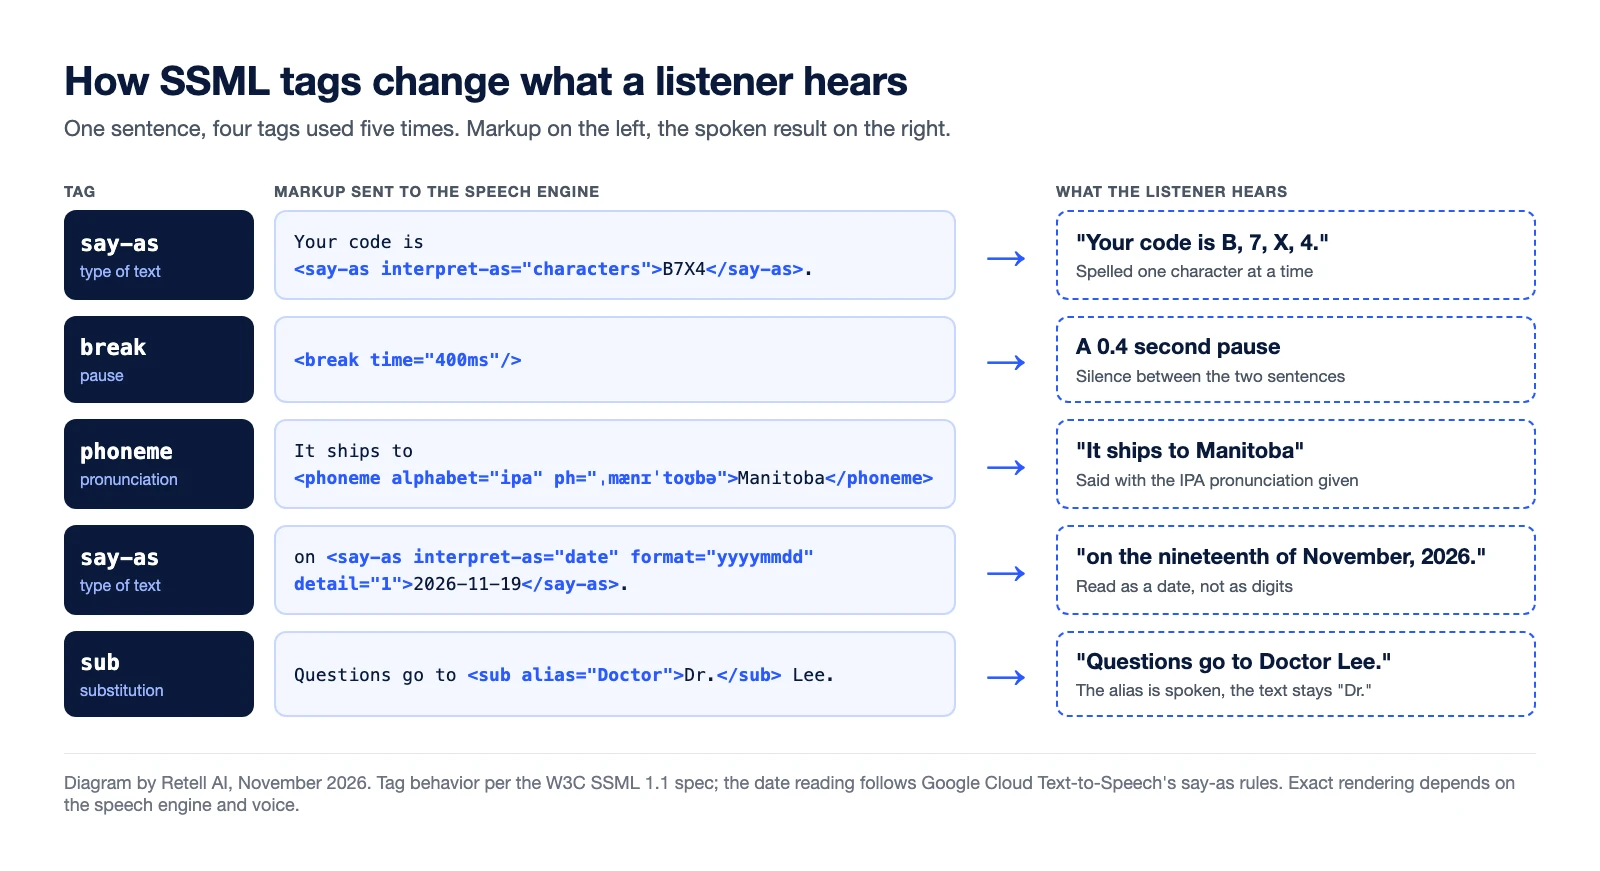
A figura mostra o que o ouvinte escuta para cada tag quando o mecanismo oferece suporte a ela.
Quais são as tags SSML mais comuns?
As descrições seguem a especificação do W3C.
| Tag | O que faz | Exemplo |
|---|---|---|
<speak> | Elemento raiz de todo documento SSML. No SSML 1.1, os atributos version e xml:lang são obrigatórios, além do namespace do SSML. | <speak version="1.1" xml:lang="en-US"> |
<break> | Adiciona uma pausa ou fronteira prosódica, definida por strength (de none a x-strong) ou por time. | <break time="400ms"/> |
<say-as> | Indica ao mecanismo que tipo de texto ele está lendo, como uma data, um horário, um número ou um valor monetário. | <say-as interpret-as="characters">B7X4</say-as> |
<phoneme> | Define uma pronúncia fonética para o texto delimitado. A especificação diz que os mecanismos devem oferecer suporte ao alfabeto ipa. | <phoneme alphabet="ipa" ph="..."> |
<sub> | Pronuncia o valor de alias no lugar do texto escrito. | <sub alias="Doctor">Dr.</sub> |
<prosody> | Altera o tom, a velocidade de fala e o volume do texto delimitado. | <prosody rate="slow"> |
<emphasis> | Solicita ênfase em uma palavra ou frase, com um level strong, moderate, none ou reduced. | <emphasis level="strong"> |
Dois detalhes da especificação explicam por que os resultados variam. Primeiro, ela define <say-as>, mas "não enumera os valores possíveis para os atributos", então a lista de valores de interpret-as é própria de cada fornecedor. Segundo, ela chama os valores de prosódia de "indicativos" e deixa o mecanismo decidir como renderizar a ênfase.
Onde o suporte a SSML difere entre os mecanismos de fala?
Cada mecanismo implementa seu próprio subconjunto, e modelos de voz mais novos costumam suportar menos marcação do que os mais antigos. Segundo a documentação de cada fornecedor, consultada em 13 de novembro de 2026:
- Google Cloud Text-to-Speech suporta "um subconjunto das tags SSML disponíveis". Suas vozes Chirp 3: HD aceitam dez tags, sem
<emphasis>; outras tags "serão ignoradas", e solicitações de streaming não aceitam SSML. - Amazon Polly lista o suporte a tags por tipo de voz.
<emphasis>não está disponível em vozes neurais, de formato longo ou generativas, e uma tag não suportada em vozes padrão, neurais ou de formato longo retorna um erro. - Azure AI Speech baseia sua implementação no SSML 1.0 e afirma que os elementos suportados "podem diferir do padrão do W3C". Ele adiciona seus próprios elementos
msttspara estilos de fala, e a ênfase no nível da palavra funciona em três vozes específicas em inglês. - ElevenLabs suporta duas tags SSML em alguns modelos:
<break>para pausas de até 3 segundos e<phoneme>apenas no Flash v2. Eleven v3 e v4 não suportam tags break. - Cartesia Sonic documenta suas próprias tags "semelhantes a SSML": speed, volume, emotion, break e spell.
O mesmo documento pode ser respeitado por um mecanismo, ignorado silenciosamente por outro e rejeitado por um terceiro. Teste a marcação exatamente na voz e no modelo que você vai usar.
Por que o SSML é importante para agentes de voz?
Quem liga não consegue ver o texto. Em IA de voz, uma leitura errada custa uma repetição ou um registro incorreto:
- Nomes. Pronúncias de marcas, medicamentos e sobrenomes que a voz adivinha errado.
- Números. Um código de confirmação lido como uma única palavra, ou um número de conta lido como uma quantidade.
- Datas e horários. Uma data como 11/19 lida como dois números separados.
- Pausas. Tempo para anotar cada grupo de um número de telefone.
O SSML é adequado para prompts roteirizados, em que um desenvolvedor marca cada linha uma única vez. Isso funciona bem para um menu de URA. Já para um agente de voz com IA ao vivo, funciona menos bem.
Como agentes de voz baseados em LLM lidam com a pronúncia sem SSML?
Em um agente baseado em LLM, um modelo de linguagem de grande porte escreve cada resposta durante a chamada, e o texto é enviado por streaming ao mecanismo de fala à medida que é gerado (como funciona o pipeline de STT, LLM e TTS). Ninguém marca frases manualmente, e o streaming traz um problema: a documentação da Cartesia alerta que uma tag de velocidade ou volume dividida entre tokens transmitidos acaba sendo lida em voz alta. Em vez disso, as equipes usam quatro métodos:
- Prompt para texto pronunciável. Instrua o modelo a escrever "quatro um cinco" em vez de "415".
- Normalização de texto. Uma etapa antes da síntese converte números, datas e valores monetários para a forma falada.
- Um dicionário de pronúncia. Uma lista de palavras com grafias fonéticas, aplicada a todas as respostas.
- Controles de fala da plataforma. Marcadores inline que a plataforma traduz para cada provedor de voz.
Como a Retell AI lida com pausas e pronúncia?
A documentação da Retell AI não descreve entrada de SSML bruto. Ela documenta estes controles:
- Pausas e soletração. Segundo a documentação de controles de fala, um travessão com um espaço de cada lado adiciona uma pausa, e as tags
<spell>leem um código ou número de conta um caractere por vez. A Retell converte a tag "para o formato que funciona melhor para a voz do seu agente". - Dicionário de pronúncia. As entradas recebem uma palavra e um fonema em IPA, CMU, Pinyin ou Jyutping. As vozes da plataforma da Retell aceitam IPA e CMU, e alguns modelos de provedores não aceitam nenhum.
- Speech Normalization. Um preset do Agent Handbook, desativado por padrão, que formata números, datas, valores monetários e números de telefone na forma falada.
Veja também como agentes de voz com IA funcionam em uma chamada.
Perguntas frequentes sobre SSML
Para que serve o SSML?
Ele controla como um mecanismo de conversão de texto em fala lê o texto em voz alta: pausas, pronúncia, leitura de números e datas, além de tom, velocidade e volume.
O SSML é igual em todos os mecanismos de conversão de texto em fala?
Não. Cada mecanismo suporta seu próprio subconjunto da especificação do W3C e adiciona suas próprias tags, por isso a marcação costuma precisar de ajustes de um mecanismo para outro.
A ElevenLabs suporta SSML?
Em parte. Sua documentação descreve tags break para pausas de até 3 segundos e tags phoneme no modelo Flash v2. Eleven v3 e v4 não suportam tags break (em novembro de 2026).
Qual é a diferença entre SSML e um dicionário de pronúncia?
As tags SSML ficam dentro de um trecho de texto e se aplicam apenas ali. Um dicionário de pronúncia é uma lista de palavras separada que o mecanismo ou a plataforma aplica a todas as palavras correspondentes.
Agentes de voz com IA usam SSML?
Alguns usam, quando o mecanismo de fala aceita. Muitos dependem de prompts, normalização de texto e dicionários de pronúncia, porque as respostas são geradas ao vivo e alguns modelos de voz mais novos aceitam pouco SSML.
Faça cada nome e número soar corretamente
A Retell AI é uma plataforma de agentes de voz com IA para centrais de atendimento. Você pode controlar pausas, soletração e pronúncia de cada agente e ouvir o resultado em um teste de chamada pela web. Fale com a equipe da Retell.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


