Afinidade de sessão, também chamada de sticky sessions ou persistência de sessão, é uma técnica de balanceamento de carga que envia todas as requisições de um mesmo cliente ou sessão para o mesmo servidor de backend, para que o estado mantido na memória desse servidor continue acessível.
Sem ela, cada requisição é distribuída de forma independente. A AWS afirma que um Application Load Balancer, por padrão, "roteia cada requisição de forma independente para um destino registrado" e que o recurso de sticky sessions permite "vincular a sessão de um usuário a um destino específico". Isso importa quando um servidor mantém localmente algo de que a próxima requisição precisa: uma sessão de login, um carrinho de compras ou um cache.
Como os balanceadores de carga implementam a afinidade de sessão?
Um balanceador de carga precisa de uma forma de reconhecer a sessão e de uma regra que a associe a um servidor. Três métodos cobrem a maioria dos produtos.
Cookie. O balanceador de carga define um cookie na primeira resposta e o lê nas requisições seguintes. A stickiness baseada em duração da AWS usa um cookie chamado AWSALB, com tempo de vida configurável entre 1 segundo e 7 dias. O HAProxy usa um cookie para "lembrar para qual servidor o cliente foi roteado antes". O cliente precisa ter suporte a cookies.
Hash de IP. O endereço IP do cliente define o servidor. O ip_hash do NGINX usa "os três primeiros octetos do endereço IPv4 do cliente, ou o endereço IPv6 inteiro" como chave de hash. Um Service do Kubernetes oferece a mesma ideia com sessionAffinity: ClientIP, com timeout padrão de 3 horas. Nenhum dos dois precisa de cookie, mas clientes atrás de um mesmo endereço compartilhado caem no mesmo servidor e, no NGINX, o mesmo vale para todos que compartilham esses três octetos.
Hash consistente. O balanceador de carga aplica hash a uma propriedade da requisição, como um header ou um ID de sessão, mapeando-a em um anel de servidores. O Envoy afirma que, com um anel bem particionado, adicionar ou remover um host de um conjunto de N "afetará apenas 1/N das requisições". A diretiva hash do NGINX tem uma opção consistent que, segundo a documentação, "ajuda a obter uma taxa de acerto de cache maior em servidores de cache".
| Método | O que identifica a sessão | Exemplo documentado | Principal limitação |
|---|---|---|---|
| Cookie | Um cookie definido pelo balanceador de carga ou pela aplicação | AWS Application Load Balancer, HAProxy | O cliente precisa ter suporte a cookies |
| Hash de IP | O endereço IP do cliente | NGINX ip_hash, Kubernetes ClientIP | Clientes atrás de um endereço compartilhado se acumulam em um único servidor |
| Hash consistente | Qualquer propriedade da requisição que você escolher | Ring hash e Maglev do Envoy, NGINX hash ... consistent | Toda requisição precisa carregar uma chave estável |
| Roteamento com reconhecimento de prefixo | Os tokens iniciais de um prompt de LLM | Prompt caching da OpenAI, Ray Serve | A carga ainda conta, então um servidor ocupado pode perder a requisição |
Quais são as desvantagens das sticky sessions?
A afinidade de sessão abre mão de parte do equilíbrio e da resiliência em troca de manter o estado por perto.
- A carga pode ficar desequilibrada. O Google Cloud afirma que a afinidade "funciona bem quando há uma distribuição razoavelmente grande de conexões únicas". Com poucas sessões ou sessões desiguais, alguns servidores ficam mais carregados, o que prejudica a escalabilidade.
- Uma falha no servidor encerra a afinidade. Na AWS, se um destino falha, o balanceador de carga "escolhe um novo destino íntegro" e mantém a sessão nele "mesmo que o destino com falha volte a funcionar". Tudo o que estava apenas na memória do servidor antigo precisa ser reconstruído.
- Funciona no modelo de melhor esforço. O Google Cloud oferece afinidade de sessão "com base no melhor esforço" e lista mudanças em health checks, backends adicionados ou removidos e a ocupação dos backends como eventos que podem quebrá-la.
A documentação do HAProxy dá o conselho padrão: "Muitas vezes, o ideal é evitar totalmente a persistência de sessão criando serviços stateless", por exemplo, armazenando o estado em um banco de dados compartilhado. A afinidade serve para o estado que você não consegue mover a baixo custo. Um cache é o caso mais comum.
Por que a afinidade de sessão importa para servir LLMs?
Porque o cache que torna barato um prompt repetido fica em uma única máquina. Um servidor de modelo mantém em memória o estado calculado de um prompt, o KV cache. O vLLM o reutiliza quando uma nova consulta "compartilha o mesmo prefixo com uma das consultas existentes, permitindo que a nova consulta pule o cálculo da parte compartilhada".
Isso só funciona se a próxima requisição chegar à mesma máquina. O guia de prompt caching da OpenAI diz isso diretamente: "Os estados em cache ficam em máquinas individuais" e "uma requisição só pode reutilizar um prefixo em cache se chegar a uma máquina que tenha uma entrada correspondente ainda não expirada". A OpenAI roteia com base na carga das máquinas, em um hash dos tokens iniciais do prompt e, em modelos mais antigos, em uma chave de cache fornecida por você. Para modelos auto-hospedados, o Ray Serve oferece um roteador que "roteia requisições com prefixos semelhantes para as mesmas réplicas, maximizando as taxas de acerto do KV cache", e recorre ao balanceamento de carga simples quando as filas estão desiguais.
Chamadas telefônicas se encaixam bem nesse padrão. A cada turno de uma conversa multiturno, um agente de voz envia ao modelo de linguagem de grande porte suas instruções mais a transcrição até o momento, porque o modelo não guarda a chamada entre uma requisição e outra. Cada requisição repete a maior parte da anterior. Assim, a chamada é a sessão, e o ID da chamada é uma chave natural. Um turno que cai em outro servidor processa o prompt inteiro novamente, o que aumenta a latência.
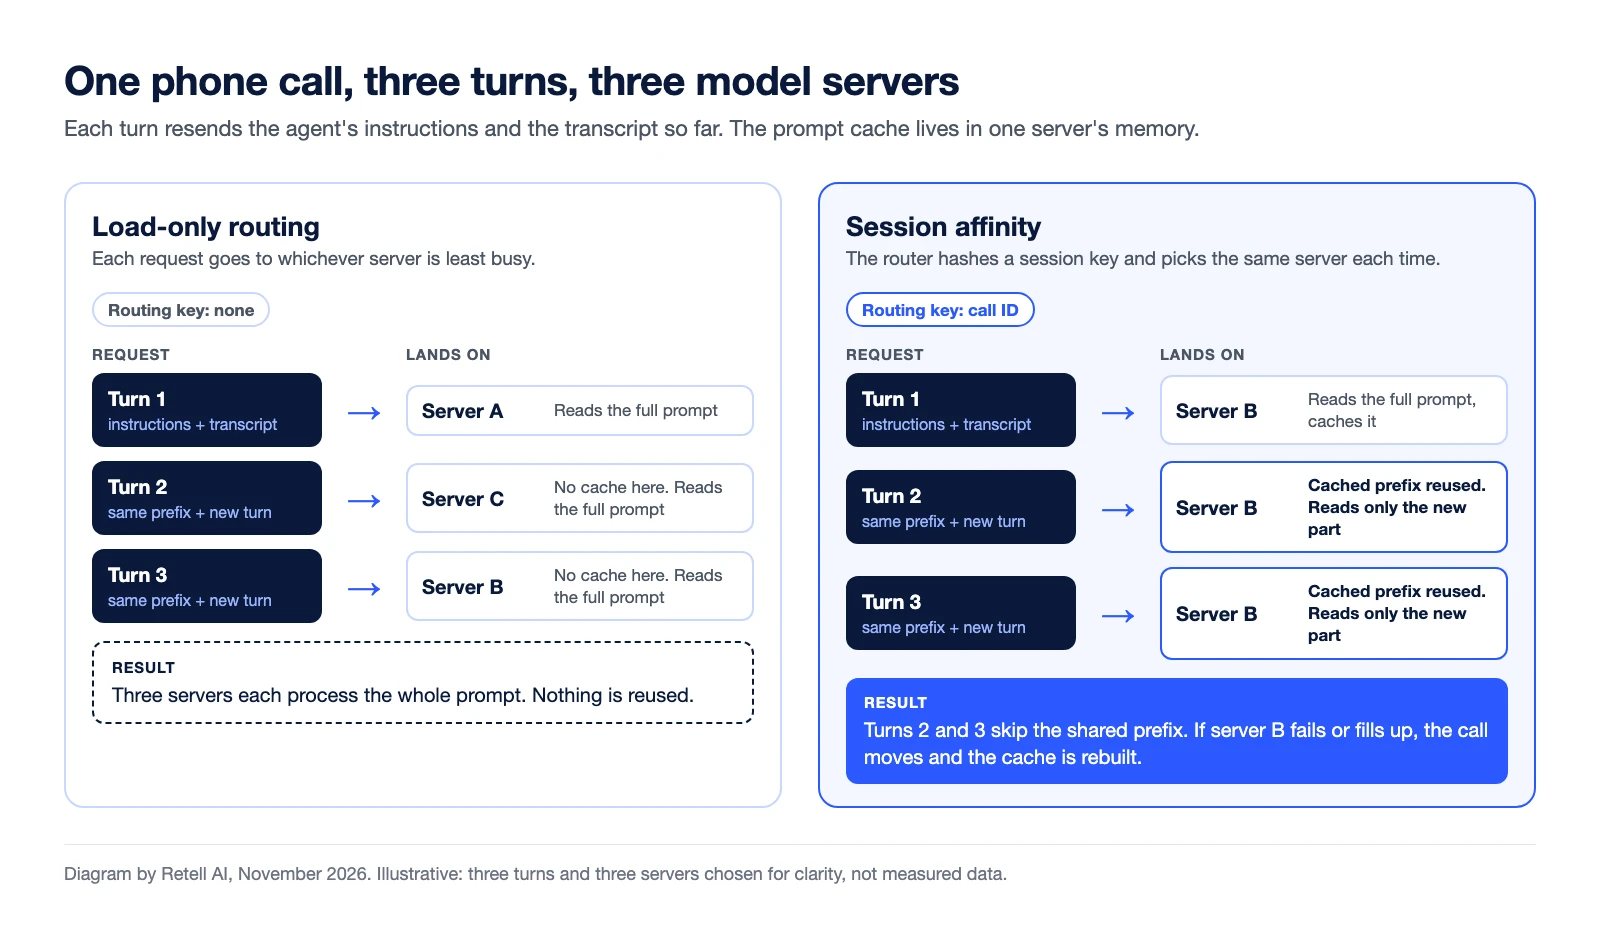
O Tell-1, LLM próprio da Retell, é servido dessa forma. O post técnico sobre o LLM da Retell chama isso de roteamento com reconhecimento de chamada: cada turno reenvia a conversa inteira, então cada chamada é mantida nas GPUs que já a têm em cache. Segundo o post, isso elevou a parcela de tokens de prompt servidos a partir do cache de 36% para 69%.
Onde a afinidade de sessão aparece na Retell
Ela aparece quando você roda seu próprio servidor de modelo. Com um LLM personalizado, a Retell "abre um WebSocket para o seu servidor a cada chamada", com o ID da chamada como último segmento do caminho da URL. A AWS observa que "conexões WebSocket são inerentemente sticky", então uma chamada permanece em um dos seus servidores enquanto o socket estiver aberto.
As boas práticas da Retell recomendam manter "um estado explícito por chamada no seu servidor, indexado pelo ID da chamada da URL do WebSocket". A Retell também restabelece uma conexão que cai no meio da chamada e, se você roda vários servidores atrás de um balanceador de carga, o novo socket pode chegar a outro servidor. Para manter o estado acessível, roteie pelo ID da chamada no caminho ou guarde esse estado em um armazenamento compartilhado. O hash de IP não vai distribuir a carga aqui: o guia de configuração lista um único endereço IP de saída para essa conexão, então todas as chamadas geram o mesmo hash e vão para o mesmo servidor.
Perguntas frequentes sobre afinidade de sessão
Afinidade de sessão é o mesmo que sticky sessions?
Sim. A AWS descreve seu recurso de sticky sessions como "também conhecido como afinidade de sessão". Persistência de sessão é um terceiro nome para a mesma coisa.
O que acontece com uma sticky session quando o servidor falha?
O balanceador de carga escolhe outro servidor íntegro e a sessão passa a ficar nele. O estado que existia apenas na memória do servidor com falha é perdido, a menos que também tenha sido armazenado em algum lugar compartilhado.
Conexões WebSocket precisam de sticky sessions?
Não enquanto a conexão estiver aberta, porque todas as mensagens trafegam pela mesma conexão até o mesmo servidor. A afinidade volta a importar quando o cliente se reconecta.
Por que a afinidade de sessão importa para o prompt caching?
Um cache de prompt fica na memória da máquina que o criou. Uma requisição seguinte só aproveita o prefixo em cache se for roteada para essa máquina.
Leve seu próprio modelo para chamadas ao vivo
A Retell AI é uma plataforma de agentes de voz com IA para centrais de atendimento. A Retell cuida da telefonia, da transcrição, da troca de turnos e da fala, e a integração de LLM personalizado conecta seu servidor de modelo por meio de um WebSocket por chamada.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


