O tempo até o primeiro token (TTFT) é o intervalo entre o envio de uma solicitação a um modelo de linguagem de grande porte (LLM) e o recebimento do primeiro token da resposta. Ele mede a rapidez com que um modelo começa a responder, e não quanto tempo a resposta leva.
O guia de benchmarking da NVIDIA o define como "o tempo desde o envio da consulta até o primeiro token recebido". Em uma chamada telefônica, o TTFT é uma parte da latência que quem liga percebe. Duas outras medidas se somam a ele: o tempo até a primeira frase e a latência de voz de ponta a ponta.
O que o TTFT inclui?
O TTFT abrange tudo o que acontece antes de o modelo transmitir seu primeiro token. A IBM lista quatro partes: atraso de fila, tempo de prefill (processamento do prompt), geração do primeiro token e overhead de rede e de API.
A IBM chama o prefill de "frequentemente o maior contribuinte para o TTFT, especialmente em prompts mais longos". O modelo lê o prompt inteiro antes de escrever qualquer coisa, então um prompt mais longo significa uma espera maior. A carga também importa. A documentação da Anyscale observa que um servidor sob uso intenso pode enfileirar as solicitações recebidas, e essa espera se soma ao TTFT.
Como medir o TTFT?
- TTFT = momento em que o primeiro token é recebido menos o momento em que a solicitação é enviada
Três escolhas alteram o resultado. Informe-as junto com qualquer número de TTFT:
- Onde o relógio fica. Medido no cliente, o TTFT inclui o tempo de rede. Medido dentro do servidor do modelo, não inclui.
- Qual percentil. A mediana (P50) mostra a solicitação típica. P90 e P99 mostram as lentas.
- Quanta carga. Uma solicitação em um servidor ocioso é o melhor cenário. Em produção, observa a NVIDIA, o prefill de uma solicitação pode se sobrepor à geração de outra.
Como o TTFT, o tempo até a primeira frase e a latência de ponta a ponta diferem em uma chamada telefônica?
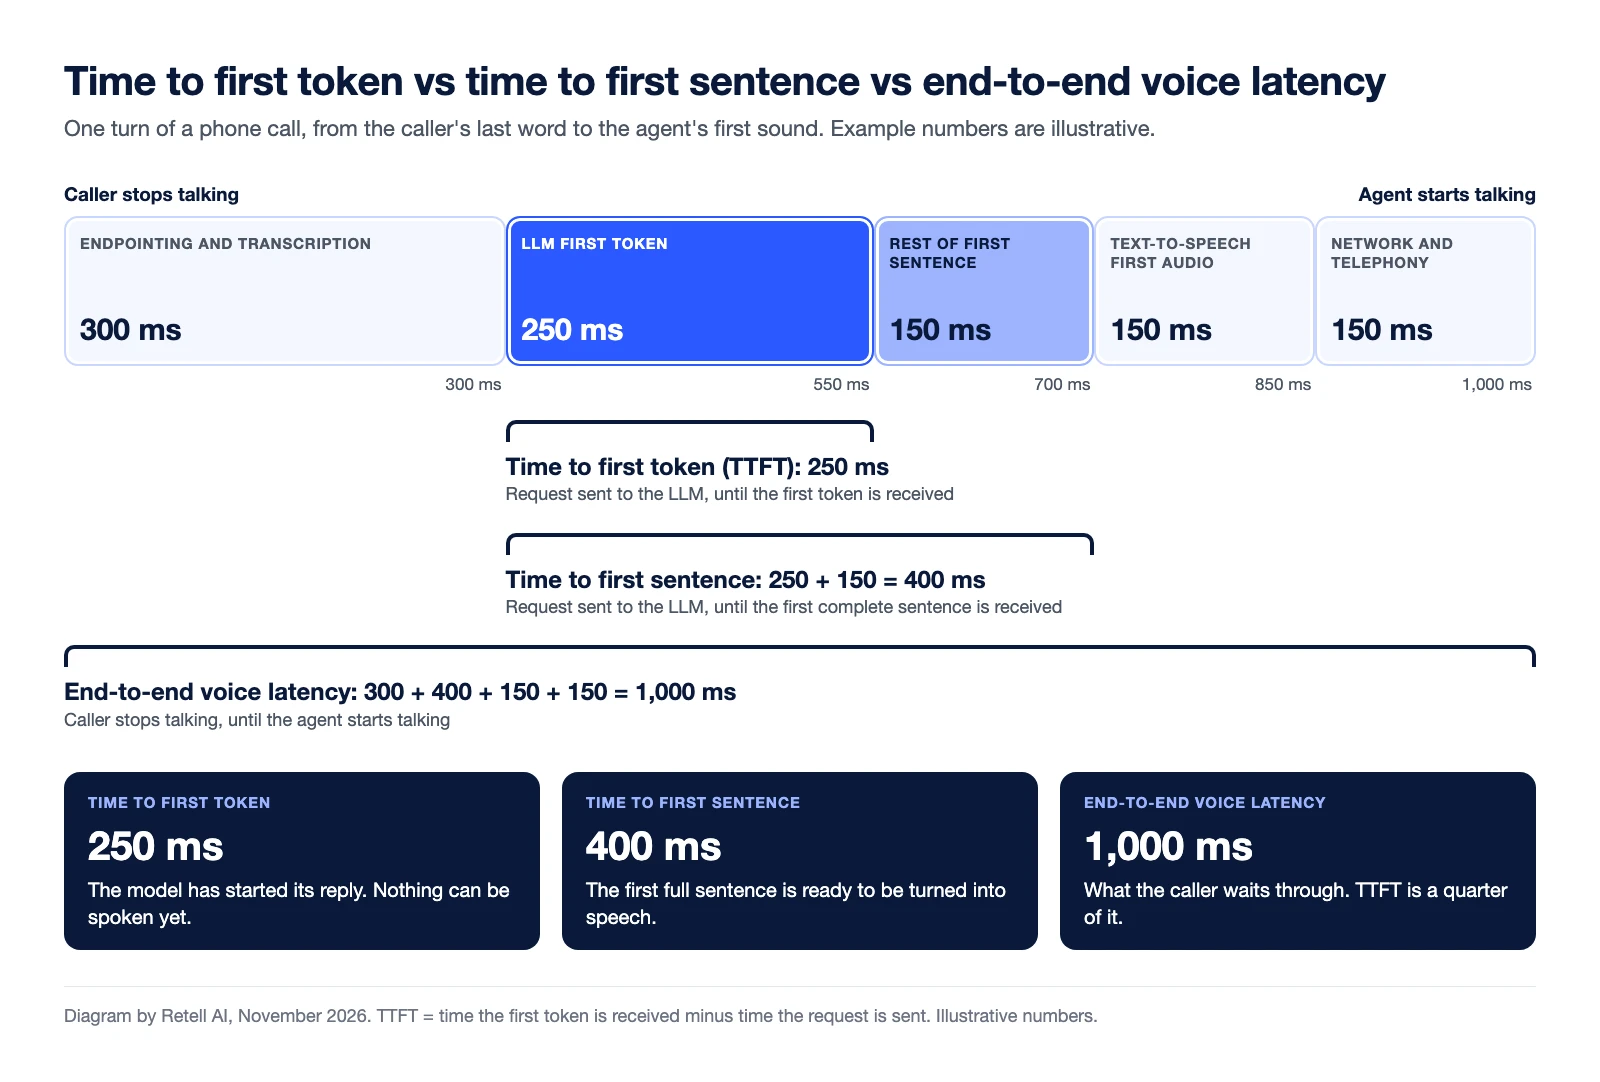
O TTFT para no primeiro token. O tempo até a primeira frase para quando uma frase completa chega. A latência de voz de ponta a ponta cobre todo o intervalo que quem liga percebe.
Quem liga nunca ouve um token. As boas práticas de LLM Personalizado da Retell dizem: "A Retell começa a falar assim que tem sua primeira frase completa." O número que importa ali é "o tempo até o primeiro token mais o tempo para concluir essa primeira frase".
A documentação de latência da Retell mede a latência de ponta a ponta "desde quando o usuário para de falar até quando o agente começa a falar".
| Medida | Início da contagem | Fim da contagem | O que fica de fora |
|---|---|---|---|
| Tempo até o primeiro token (TTFT) | Solicitação enviada ao LLM | Primeiro token recebido | O restante da primeira frase, reconhecimento de fala, síntese de fala |
| Tempo até a primeira frase | Solicitação enviada ao LLM | Primeira frase completa recebida | Reconhecimento de fala, síntese de fala, telefonia |
| Latência de voz de ponta a ponta | Quem liga para de falar | O agente começa a falar | Nada no pipeline. Verifique se o número inclui o trecho de rede até quem liga |
Uma armadilha de nomenclatura: no benchmarking de LLMs, a latência de ponta a ponta vai até o último token. A NVIDIA a define como "quanto tempo leva desde o envio de uma consulta até o recebimento da resposta completa".
Exemplo prático (números ilustrativos). Um turno de uma chamada:
- Detecção de fim de fala e transcrição: 300 ms
- Primeiro token do LLM: 250 ms
- Restante da primeira frase: 150 ms (mais 15 tokens a 10 ms cada)
- Primeiro áudio da conversão de texto em fala: 150 ms
- Rede e telefonia: 150 ms
O TTFT é de 250 ms. O tempo até a primeira frase é 250 + 150 = 400 ms. A latência de voz de ponta a ponta é 300 + 400 + 150 + 150 = 1.000 ms, então o TTFT corresponde a um quarto da espera de quem liga. Nosso guia de benchmarks de latência de IA de voz usa o mesmo orçamento.
Por que o TTFT pode enganar na comparação entre modelos?
Um número de TTFT só pode ser comparado com outro número de TTFT obtido da mesma forma. Compare o TTFT de um modelo com o tempo até a primeira frase de outro, e o primeiro sempre parecerá mais rápido. O mesmo vale para o tempo apenas do modelo versus o tempo medido em uma chamada real, e para uma mediana versus um P99.
Um modelo também pode enviar o primeiro token rapidamente e depois transmitir devagar, o que ainda deixa quem liga em silêncio.
Como reduzir o TTFT em um agente de voz?
O guia de solução de problemas de latência da Retell aponta a escolha do modelo e o tamanho do prompt como as duas causas mais comuns de latência alta.
- Escolha um modelo mais rápido. O Tell-1 é uma opção criada para chamadas. Segundo o guia, modelos maiores e voltados a raciocínio "são mais lentos até o primeiro token".
- Encurte o prompt. "Cada token no seu prompt aumenta o tempo até o primeiro token", em todo turno. Prompts acima de cerca de 8 mil tokens ficam visivelmente mais lentos.
- Transmita a resposta em streaming. Com um LLM Personalizado, enviar a resposta completa em um único evento "coloca toda a geração no silêncio de quem liga".
A Get Call API da Retell retorna as latências de ponta a ponta, do LLM e de conversão de texto em fala de cada chamada em P50, P90, P95 e P99. O número do LLM vai "até o primeiro trecho falável recebido", então mede texto falável, e não o primeiro token bruto.
Alguns modelos são construídos em torno dessa medida. O Tell-1, o LLM próprio da Retell, inicia a resposta e continua raciocinando enquanto a primeira frase é reproduzida. Ele tem a menor latência mediana no Retell vCX Benchmark, de 76 ms, uma mediana móvel de 24 horas do tempo até a primeira frase (consultada em 13 de novembro de 2026). O post técnico sobre o LLM da Retell explica como ele funciona, e o tempo do modelo é apenas uma parte da latência de voz de ponta a ponta.
Perguntas frequentes sobre o tempo até o primeiro token
O que é um bom tempo até o primeiro token?
Não existe um padrão único. Depende do modelo, do tamanho do prompt e da carga do servidor. Para um agente de voz, avalie-o dentro do número de ponta a ponta. A documentação da Retell sugere manter a latência estimada de um agente abaixo de 1,5 segundo.
TTFT é o mesmo que latência?
Não. O TTFT é o atraso do LLM até o primeiro token. A latência em uma chamada é todo o intervalo entre quem liga terminar de falar e o agente começar a falar.
O TTFT inclui o tempo de rede?
Depende de onde ele é medido. A NVIDIA diz que o TTFT "geralmente inclui o tempo de fila da solicitação, o tempo de prefill e a latência de rede". Um número apenas do modelo, medido dentro do servidor, deixa a rede de fora.
Qual é a diferença entre TTFT e tempo até a primeira frase?
O TTFT para no primeiro token. O tempo até a primeira frase para quando a primeira frase completa chega, que é quando um agente de voz pode começar a falar.
Meça a latência nas suas próprias chamadas
A Retell AI é uma plataforma de agentes de voz com IA para centrais de atendimento. O Call History mostra a latência de cada chamada, detalhada por componente na Get Call API. Fale com a equipe da Retell.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


