LLM como juiz é um método de avaliação em que um modelo de linguagem de grande porte pontua ou classifica a saída de outro sistema de IA com base em critérios escritos, no lugar de um avaliador humano. As equipes usam esse método para avaliar trabalhos abertos, como uma conversa por telefone, que não têm uma única resposta correta.
O nome vem de um artigo de 2023, Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. Os autores relataram que juízes fortes, como o GPT-4, coincidiram com as preferências humanas com "mais de 80% de concordância, o mesmo nível de concordância entre humanos". Eles também listaram suas limitações: vieses de posição, de verbosidade e de autopromoção.
Como um LLM juiz pontua uma conversa?
Um LLM juiz lê a conversa e um conjunto de instruções e, em seguida, retorna um veredito em uma de três formas.
| Método | O que o juiz faz | O que retorna | Onde se aplica |
|---|---|---|---|
| Avaliação por rubrica | Lê uma transcrição com base em critérios escritos | Aprovado ou reprovado, ou uma pontuação, com uma justificativa | QA em produção e testes de regressão |
| Ranking em pares | Compara duas ou mais respostas ao mesmo turno | Um vencedor ou uma ordem de classificação | Escolher entre prompts ou modelos |
| Painel de juízes | Vários modelos juízes avaliam o mesmo item e os vereditos são agregados | Uma pontuação agregada | Pontuações que o viés de um único modelo poderia distorcer |
Avaliação por rubrica. No artigo do G-Eval, o juiz raciocinava sobre os critérios e depois preenchia um formulário de pontuação. Em sumarização, suas pontuações se correlacionaram com as avaliações humanas melhor do que métodos anteriores.
Ranking em pares. Perguntar qual de duas respostas é melhor funciona bem para qualidades como o tom, em que uma diferença é mais fácil de perceber do que de pontuar.
Painéis de juízes. Em Replacing Judges with Juries, um painel de modelos menores de diferentes famílias "supera um único juiz grande, apresenta menos viés intramodelo" e foi "mais de sete vezes mais barato".
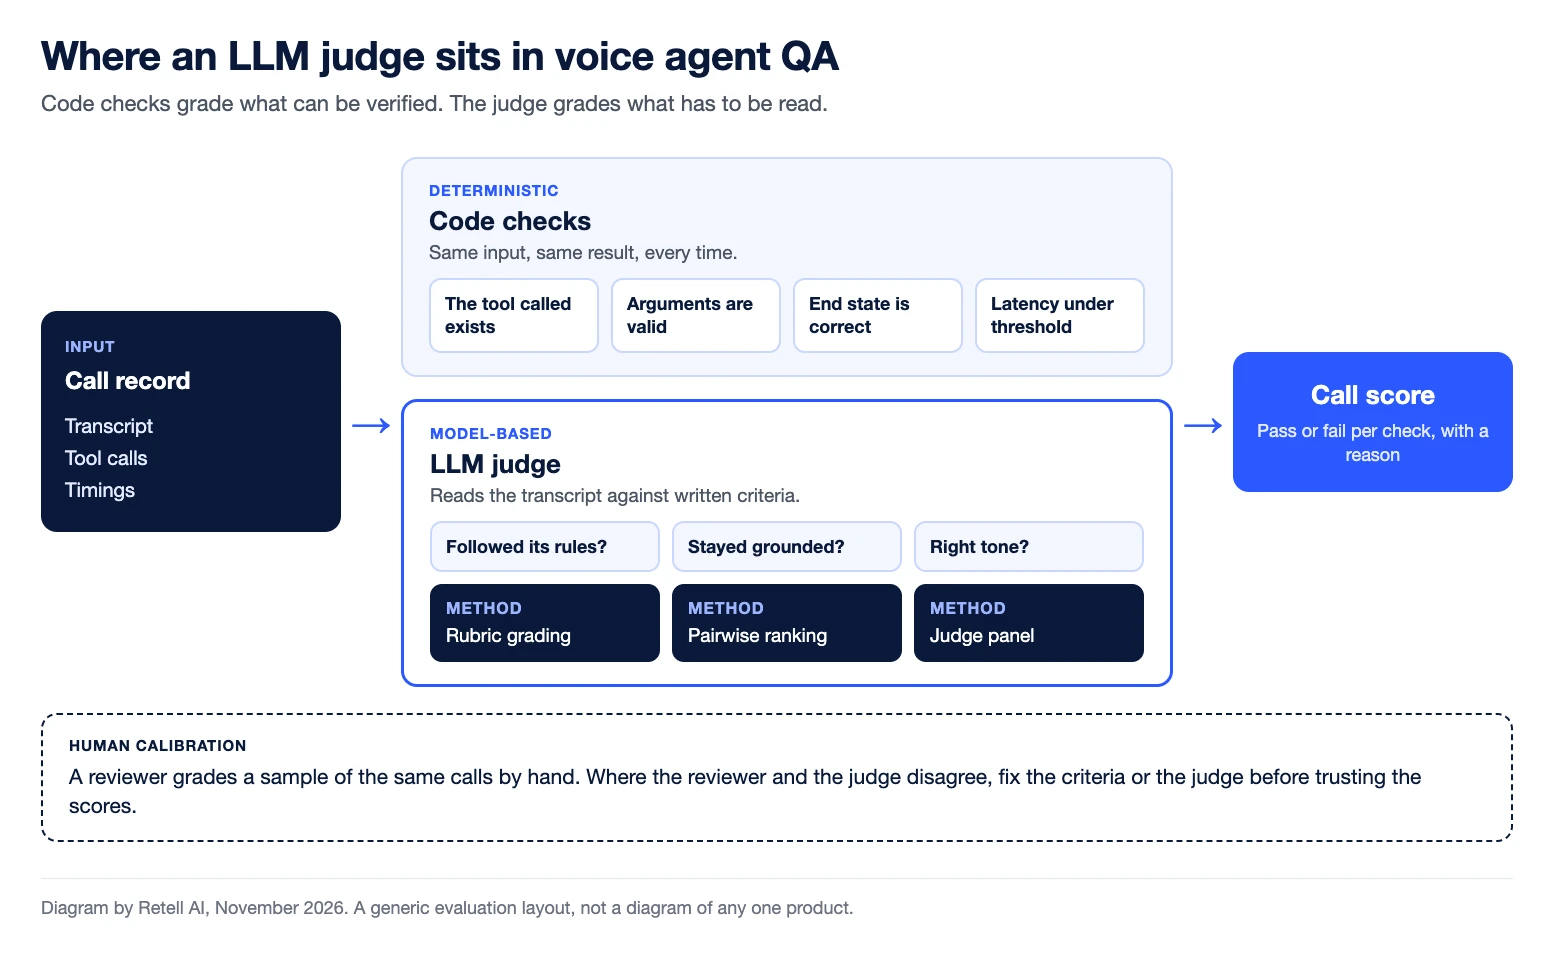
Como o LLM como juiz é usado no QA e em benchmarks de agentes de voz?
O QA de agentes de voz usa um LLM juiz para as partes de uma chamada que só a leitura da transcrição consegue resolver: se o agente seguiu suas regras, manteve-se dentro de suas fontes e resolveu a solicitação.
A documentação da Retell mostra as duas configurações mais comuns. No AI QA, uma condição avaliada por IA é "uma verificação qualitativa que a IA executa na transcrição e no contexto de cada chamada", escrita como "o prompt que a IA usa para julgar se a condição foi atendida". Nos testes de simulação, uma IA faz o papel de quem liga e "cada execução é avaliada como aprovada ou reprovada, com uma explicação escrita".
Os benchmarks relatam o mesmo tipo de veredito em escala. O Retell vCX Benchmark publica a pontuação de cada suíte como uma taxa de aprovação, "a porcentagem de cenários testados que ele tratou corretamente", abrangendo seguimento de instruções, fundamentação, chamadas de ferramentas e fala coloquial (consultado em 13 de novembro de 2026).
Para transformar vereditos em uma revisão semanal, veja o scorecard de QA para agentes de voz.
Quais são os modos de falha conhecidos de um LLM juiz?
Um LLM juiz falha de quatro formas documentadas. Cada uma tem uma verificação conhecida.
- Viés de posição. Em Large Language Models are not Fair Evaluators, inverter a ordem de duas respostas fez um modelo vencer "66 de 80 consultas testadas". Execute cada comparação nas duas ordens.
- Autopreferência. Um estudo de 2024 constatou que um avaliador "dá notas mais altas às próprias saídas do que às de outros, enquanto anotadores humanos as consideram de qualidade equivalente". Use um juiz de outra família de modelos, ou um painel.
- Baixa concordância com humanos. Judging the Judges testou treze modelos juízes e constatou que "apenas os melhores (e maiores) modelos alcançam um alinhamento razoável com humanos", com "uma tendência à leniência". Avalie uma amostra manualmente e compare.
- Deriva. O modelo por trás de uma API pode mudar: um estudo mediu a precisão do GPT-4 caindo de 84% para 51% na mesma tarefa em três meses. Os critérios também mudam. Who Validates the Validators? chama isso de deriva de critérios: "os usuários precisam de critérios para avaliar saídas, mas avaliar saídas ajuda os usuários a definir critérios". Fixe a versão do juiz e execute novamente um conjunto fixo, rotulado manualmente, após qualquer mudança.
Os juízes também não são determinísticos. A documentação de simulação da Retell orienta: "Julgue um cenário pela taxa de aprovação ao longo de várias execuções, não por uma única execução."
Quando as verificações por código superam um LLM juiz?
As verificações por código superam um LLM juiz sempre que a resposta pode ser verificada em vez de lida. O guia da Anthropic sobre avaliações de agentes recomenda "escolher avaliadores determinísticos sempre que possível e avaliadores LLM quando necessário". Ele descreve os avaliadores baseados em código como rápidos, baratos, objetivos e reproduzíveis, e os avaliadores baseados em modelos como não determinísticos.
Em uma chamada, o código pode verificar se a ferramenta chamada pelo agente existe, se seus argumentos são válidos e se o tempo de resposta ficou abaixo de um limite. O tau-bench avalia conversas inteiras dessa forma, comparando "o estado do banco de dados ao final de uma conversa com o estado-objetivo anotado".
O AI QA da Retell mantém os dois separados: as métricas de desempenho são limites quantitativos, e as condições avaliadas por IA cuidam das verificações qualitativas. Como testar e lançar mudanças em agentes de voz explica onde cada um é executado.
Como os painéis de juízes são usados para treinar um modelo de voz?
O Tell-1, o LLM próprio da Retell, usou LLMs juízes em duas de suas três etapas de treinamento, de acordo com o artigo técnico sobre o LLM da Retell. A etapa de ajuste por preferência aprendeu com "pares de preferência classificados por um painel de LLMs juízes".
Na etapa de aprendizado por reforço, segundo o artigo, "o modelo escreve oito respostas e cada uma delas é pontuada". O código é executado primeiro: chamadas a ferramentas fora do conjunto do agente, saídas malformadas e outros erros críticos "são detectados por código antes que qualquer juiz os veja". Para a correção, "vários modelos juízes avaliam a correção das chamadas de ferramentas, alucinações e o seguimento de instruções, e seus vereditos são agregados em um único sinal de recompensa". Para a naturalidade, um único juiz classifica as oito respostas lado a lado com base em uma rubrica, porque "a naturalidade é mais fácil de comparar do que de pontuar".
Esse é o padrão descrito nesta página: verificações por código para o que pode ser verificado, um painel de juízes para a correção e ranking para o tom.
Perguntas frequentes sobre LLM como juiz
O que um LLM juiz faz?
Ele lê uma saída, como a transcrição de uma chamada, junto com instruções de avaliação, e retorna um veredito: aprovado ou reprovado, uma pontuação ou uma preferência entre duas opções.
Quão confiável é o LLM como juiz?
Depende do modelo juiz e da tarefa. Um estudo encontrou mais de 80% de concordância com as preferências humanas; outro constatou que apenas os maiores juízes se alinharam razoavelmente com humanos. Primeiro, compare o juiz com chamadas avaliadas manualmente.
O que é um painel de juízes?
Um painel de juízes é formado por vários modelos juízes que avaliam a mesma saída, com seus vereditos agregados. Ele reduz o efeito do viés de qualquer modelo individual.
Qual é a diferença entre avaliação por rubrica e ranking em pares?
A avaliação por rubrica pontua uma saída com base em critérios escritos. O ranking em pares mostra duas saídas ao juiz e pergunta qual é a melhor.
Um LLM juiz consegue pontuar uma chamada de voz?
Sim, a partir da transcrição e das chamadas de ferramentas. Qualidades que estão no áudio também precisam do áudio: a documentação da Retell informa que o Agent Naturalness é "avaliado usando tanto o áudio quanto a transcrição".
Pontue suas próprias chamadas antes de escalar
A Retell AI é uma plataforma de agentes de voz com IA para centrais de atendimento. O AI QA avalia uma amostra das suas chamadas com base nas condições e limites que você define, com evidências da transcrição para cada resultado.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


