A decodificação especulativa é uma técnica para acelerar um modelo de linguagem de grande porte: um pequeno modelo de rascunho tenta adivinhar os próximos tokens, e o modelo grande verifica todos eles em uma única passada e mantém aqueles que ele mesmo teria produzido.
O método vem de dois artigos científicos. O Google Research deu o nome à técnica em Fast Inference from Transformers via Speculative Decoding (Leviathan, Kalman e Matias, publicado pela primeira vez em novembro de 2022). A DeepMind descreveu sua própria versão, desenvolvida de forma independente, em Accelerating Large Language Model Decoding with Speculative Sampling (Chen e colegas, fevereiro de 2023).
Por que a decodificação padrão é lenta?
A decodificação padrão é lenta porque um modelo de linguagem de grande porte escreve um token por vez, e cada token exige uma execução completa do modelo. O artigo do Google resume isso em uma linha: "decodificar K tokens exige K execuções sequenciais do modelo".
Muitos desses tokens são fáceis de prever. O mesmo artigo observa que "tarefas difíceis de modelagem de linguagem costumam incluir subtarefas mais fáceis, que podem ser bem aproximadas por modelos mais eficientes".
Como o modelo de rascunho e o modelo completo trabalham juntos?
Os dois modelos trabalham em rodadas, e cada rodada tem três etapas:
- Rascunho. O modelo pequeno escreve uma curta sequência de palpites, um token após o outro. O artigo do Google o chama de modelo de aproximação; a DeepMind o chama de modelo de rascunho.
- Verificação. O modelo grande, chamado de modelo-alvo, avalia todas as posições adivinhadas em paralelo, em uma única passada.
- Aceitar ou corrigir. Os palpites são aceitos da esquerda para a direita. No primeiro palpite rejeitado, o modelo grande fornece seu próprio token e os palpites seguintes são descartados. Se todos os palpites forem aceitos, o modelo grande acrescenta mais um token.
Cada passada do modelo grande gera pelo menos um token e no máximo o número de palpites mais um, então ele nunca precisa de mais passadas do que a decodificação padrão.
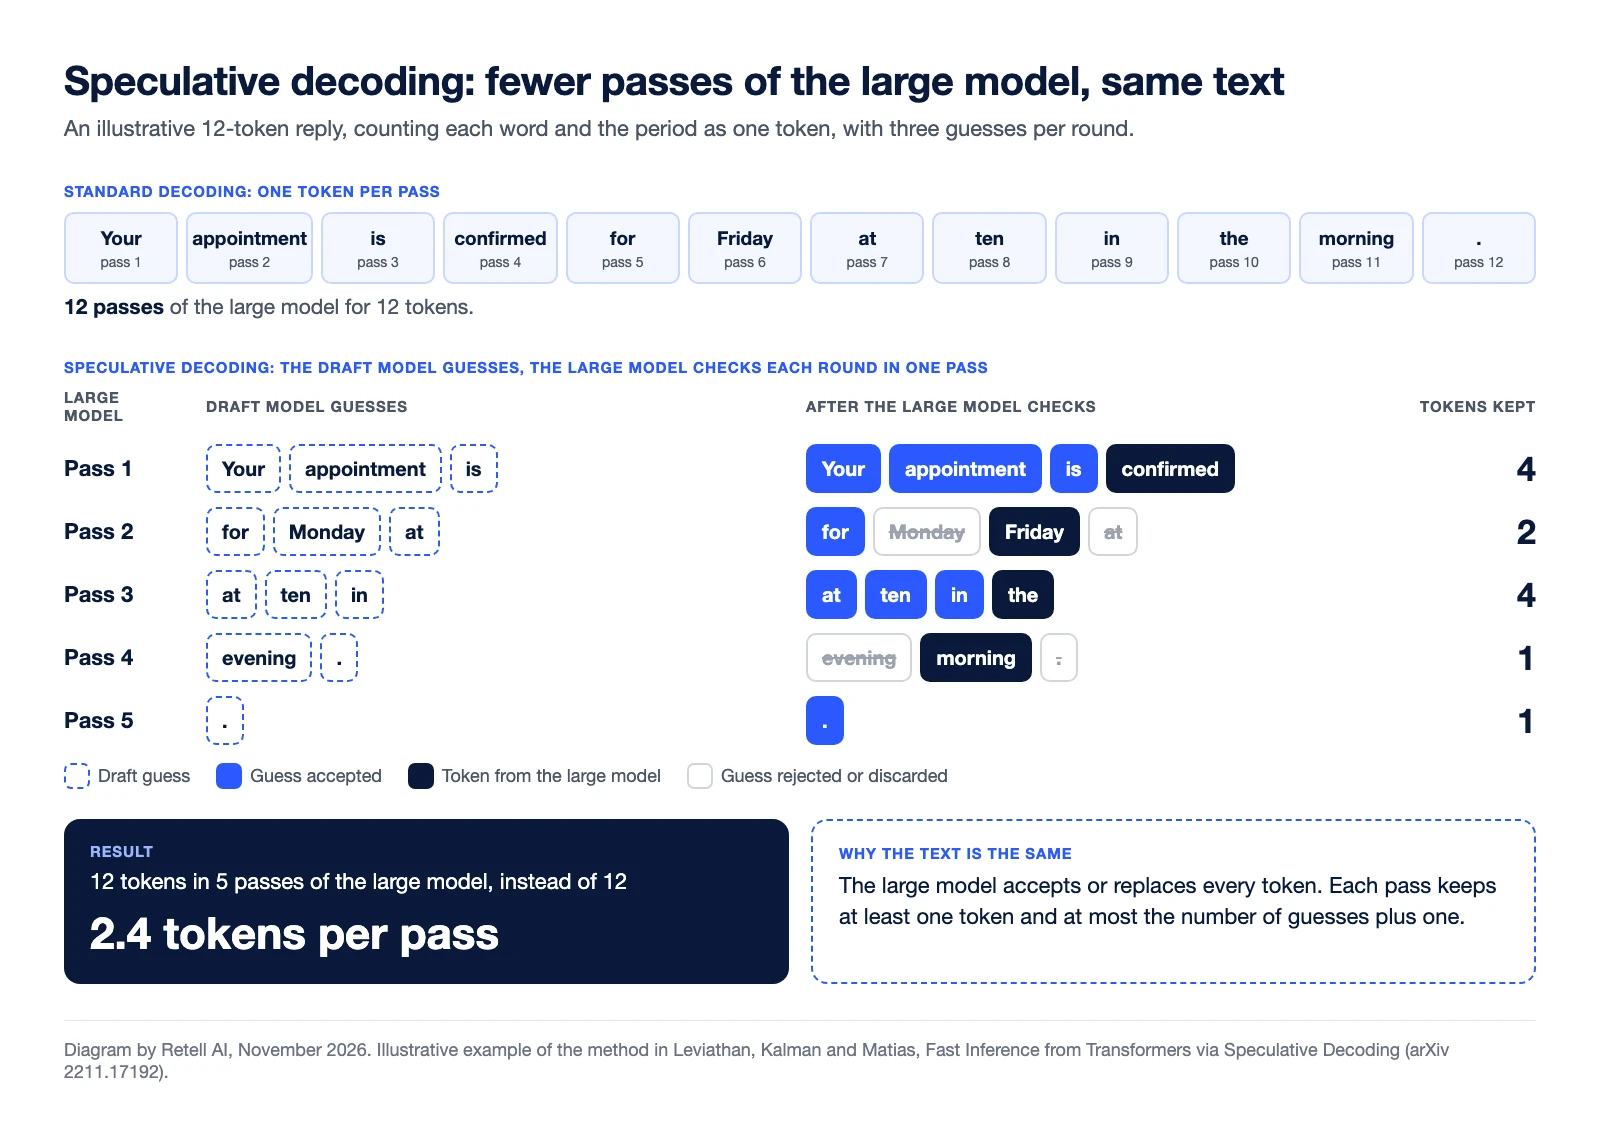
Exemplo prático (ilustrativo). Uma resposta de 12 tokens em inglês, contando cada palavra e o ponto final como um token, com três palpites por rodada:
| Passada do modelo grande | Palpites do modelo de rascunho | Veredito do modelo grande | Tokens mantidos |
|---|---|---|---|
| 1 | Your appointment is | Os três aceitos, acrescenta "confirmed" | 4 |
| 2 | for Monday at | "for" aceito. "Monday" rejeitado e substituído por "Friday". "at" descartado | 2 |
| 3 | at ten in | Os três aceitos, acrescenta "the" | 4 |
| 4 | evening . | "evening" rejeitado e substituído por "morning". O ponto final é descartado | 1 |
| 5 | . | Aceito, e a resposta termina | 1 |
| Total | 12 tokens em 5 passadas |
A decodificação padrão precisa de 12 passadas do modelo grande para essa frase. Aqui, ele é executado 5 vezes, uma média de 2,4 tokens por passada.
Por que a saída não muda?
A saída não muda porque o modelo grande tem a palavra final sobre cada token. Na decodificação gulosa (greedy), em que o modelo sempre escolhe sua opção principal, um palpite só é mantido se for o token que o modelo grande teria escolhido. A documentação do vLLM lista um teste exatamente para isso: a amostragem gulosa com decodificação especulativa "corresponde à amostragem gulosa sem ela".
Na amostragem aleatória, um palpite é aceito com uma probabilidade definida pela forma como os dois modelos o avaliam, e um palpite rejeitado é sorteado novamente a partir de uma distribuição ajustada. O artigo do Google prova que isso mantém a distribuição de saída inalterada. Nas palavras da DeepMind, o esquema "preserva a distribuição do modelo-alvo dentro dos limites numéricos do hardware".
Algumas variantes mais recentes relaxam a verificação de propósito para ganhar velocidade. O vLLM observa que um de seus métodos de verificação "não preserva a distribuição".
Quando a decodificação especulativa ajuda e quando não ajuda?
A decodificação especulativa ajuda quando o modelo de rascunho é barato e costuma acertar, e o servidor tem capacidade de processamento sobrando.
| Condição | Efeito na velocidade | Fonte |
|---|---|---|
| Os palpites costumam ser aceitos | Mais tokens por passada. Tokens esperados por passada = (1 − α^(γ+1)) ÷ (1 − α), em que α é a taxa de aceitação e γ o número de palpites por rodada | Artigo do Google |
| O modelo de rascunho é muito menor que o modelo-alvo | Baixo custo de rascunho. Um rascunho cerca de duas ordens de grandeza menor "geralmente teve o melhor desempenho" | Artigo do Google |
| Há capacidade de processamento sobrando | Obrigatório. O método pressupõe "recursos computacionais suficientes para suportar o aumento da concorrência" | Artigo do Google |
| Tráfego intenso no servidor | Ganho menor. O vLLM classifica um modelo de rascunho como "ganho alto" com taxas de requisição baixas e "ganho médio" com taxas altas | Documentação do vLLM |
| O rascunho erra com frequência demais para o que custa | Nenhum ganho. Só há aceleração quando a taxa de aceitação é maior que o custo do rascunho em relação ao modelo-alvo | Artigo do Google |
Como ilustração, uma taxa de aceitação de 0,6 com três palpites por rodada gera cerca de 2,2 tokens por passada.
Acelerações publicadas: o artigo do Google relata de 2X a 3X em um modelo T5-XXL de 11 bilhões de parâmetros. A DeepMind relata de 2 a 2,5 vezes no Chinchilla, de 70 bilhões de parâmetros, com um rascunho de 4 bilhões de parâmetros. Os resultados dependem dos modelos, da tarefa e do hardware.
Um exemplo de produção na área de voz: o Tell-1, LLM próprio da Retell, usa decodificação especulativa para obter cerca de quatro tokens a cada passada do modelo completo, segundo o post técnico da Retell sobre o Retell LLM.
Por que a decodificação especulativa é importante para voz em tempo real?
A decodificação especulativa é importante para voz em tempo real porque quem está na ligação percebe o tempo do modelo como silêncio. Em uma chamada, o modelo é uma das etapas do pipeline de fala para texto, LLM e texto para fala, e o atraso dele se soma à latência da chamada.
As boas práticas de LLM Personalizado da Retell explicam qual parte do tempo do modelo conta: a Retell "começa a falar assim que recebe sua primeira frase completa", então o número a acompanhar é o "tempo até o primeiro token mais o tempo para terminar essa primeira frase". A decodificação especulativa atua na segunda parte: depois que a geração começa, os tokens chegam em grupos. Ela não encurta a leitura do prompt que acontece antes do primeiro token. Para isso, o guia de solução de problemas de latência da Retell começa pela escolha do modelo e pelo tamanho do prompt.
O outro motivo é a precisão. Mudar para um modelo menor também reduz o atraso, mas o mesmo guia alerta que trocar de modelo "muda o comportamento do seu agente, não apenas a velocidade". A decodificação especulativa exata mantém a saída do modelo grande.
Quem serve o modelo é quem a aplica, então quem cria agentes a percebe como velocidade do modelo. Na Retell, o Tell-1 é servido dessa forma. Para comparar modelos em velocidade e qualidade de chamada, confira os melhores LLMs para agentes de voz com IA.
Perguntas frequentes sobre decodificação especulativa
A decodificação especulativa é sem perdas?
Na forma exata, sim. Os artigos originais provam que a distribuição de saída corresponde à do modelo grande, e o vLLM a descreve como "teoricamente sem perdas, até os limites de precisão numérica do hardware". As variantes que relaxam a verificação não são sem perdas.
Quem criou a decodificação especulativa?
Yaniv Leviathan, Matan Kalman e Yossi Matias, do Google Research, publicaram o artigo em novembro de 2022 e o apresentaram na ICML 2023. Uma equipe da DeepMind publicou sua própria versão, chamada de amostragem especulativa, em fevereiro de 2023.
O que é um modelo de rascunho?
Um modelo de rascunho é o modelo pequeno e rápido que escreve os palpites. A documentação da Hugging Face diz que o método funciona melhor quando ele "é significativamente menor que o modelo principal e usa o mesmo tokenizador".
A decodificação especulativa reduz custos?
Pode ser que sim, pode ser que não. O artigo do Google observa que o número total de operações aritméticas "pode ser maior que o do algoritmo de decodificação padrão", já que palpites rejeitados são trabalho desperdiçado. A retrospectiva de 2024 do Google acrescenta que resultados mais rápidos no mesmo hardware significam que "são necessárias menos máquinas para atender ao mesmo volume de tráfego".
A previsão de múltiplos tokens é o mesmo que decodificação especulativa?
Não. A previsão de múltiplos tokens (MTP) é uma das formas de produzir os palpites. A documentação do vLLM lista a MTP ao lado dos modelos de rascunho como um método de especulação.
Teste a velocidade do modelo nas suas próprias chamadas
A Retell AI é uma plataforma de agentes de voz com IA para centrais de atendimento. Fale com a equipe da Retell sobre um piloto com chamadas reais.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


