O cache de prompt (prompt caching) é uma técnica que permite que um modelo de linguagem de grande porte pule um trabalho que já fez: quando uma nova requisição começa com os mesmos tokens de uma anterior, o modelo reutiliza a computação salva para esse início compartilhado e processa apenas o que é novo. O resultado é um primeiro token mais rápido e, na maioria das APIs, um preço menor pelos tokens reutilizados.
A parte reutilizada é chamada de prefixo. O guia da OpenAI o define como "os tokens inalterados no início de um prompt". Instruções, definições de ferramentas e turnos anteriores da conversa costumam ficar ali.
Como funciona o cache de prompt?
A documentação da Anthropic descreve a sequência: o sistema verifica se o prefixo do prompt já está em cache de uma consulta recente, usa a versão em cache se estiver e, caso contrário, processa o prompt completo e armazena o prefixo em cache.
Três regras decorrem desse design:
- A correspondência é exata. A Anthropic afirma que acertos de cache exigem "segmentos de prompt 100% idênticos". Um único caractere alterado no início do prompt faz com que tudo depois dele seja processado novamente.
- A ordem importa. O conteúdo estável vem primeiro e o conteúdo que muda vem por último.
- As entradas expiram. O tempo de vida padrão do cache da Anthropic é de 5 minutos, renovado sempre que o conteúdo em cache é usado. Os tempos de vida da OpenAI dependem do modelo.
Qual é a relação entre cache de prompt, cache de prefixo e cache KV?
São três camadas da mesma ideia. O cache KV são os dados, o cache de prefixo é a reutilização desses dados entre requisições e o cache de prompt é o nome que os provedores de API dão ao recurso.
| Termo | O que é | Escopo | Onde você vê o termo |
|---|---|---|---|
| Cache KV | Os estados de chave e valor que um modelo calcula para cada token que leu, mantidos para não serem recalculados a cada novo token | Dentro de uma requisição | Funcionamento interno do modelo, motores de inferência |
| Cache de prefixo | Manter o cache KV após o fim de uma requisição e reutilizá-lo em uma requisição posterior que comece com os mesmos tokens | Entre requisições no mesmo servidor | Motores de inferência como o vLLM |
| Cache de prompt | Cache de prefixo oferecido como recurso de API, com regras de tempo de vida, tamanho mínimo e preço | Entre chamadas de API | Documentação e páginas de preços dos provedores de modelos |
Um texto explicativo da Hugging Face resume o cache KV de forma simples: "Em vez de recalcular tudo do zero, o modelo reutiliza o que já calculou". A documentação do vLLM diz que seu cache automático de prefixo "armazena em cache o cache KV de consultas existentes, para que uma nova consulta possa reutilizar diretamente o cache KV se compartilhar o mesmo prefixo". A OpenAI confirma a ligação do lado da API: "O cache de prompt armazena tensores de chave-valor (KV), não os próprios tokens."
Por que o cache de prompt importa em uma ligação telefônica com vários turnos?
Um agente de voz chama o modelo uma vez por turno, e cada requisição carrega as instruções, as definições de ferramentas e a conversa até ali. Em uma conversa com vários turnos, quase tudo isso é idêntico à requisição do turno anterior. Apenas a última troca é nova. Sem cache, o modelo lê as mesmas instruções de novo a cada turno.
Exemplo prático (números ilustrativos). Um agente tem 2.500 tokens de instruções e ferramentas, cada turno adiciona 100 tokens de conversa e todos os turnos após o primeiro encontram seu prefixo no cache:
| Turno | Tokens do prompt | Reutilizados do cache | Novos tokens a ler |
|---|---|---|---|
| 1 | 2.600 | 0 | 2.600 |
| 2 | 2.700 | 2.600 | 100 |
| 5 | 3.000 | 2.900 | 100 |
| 10 | 3.500 | 3.400 | 100 |
| Todos os 10 turnos | 30.500 | 27.000 | 3.500 |
Ao longo da chamada, 27.000 dos 30.500 tokens do prompt (cerca de 89%) vêm do cache. A partir do segundo turno, o modelo lê 100 tokens novos em vez de mais de 2.600.
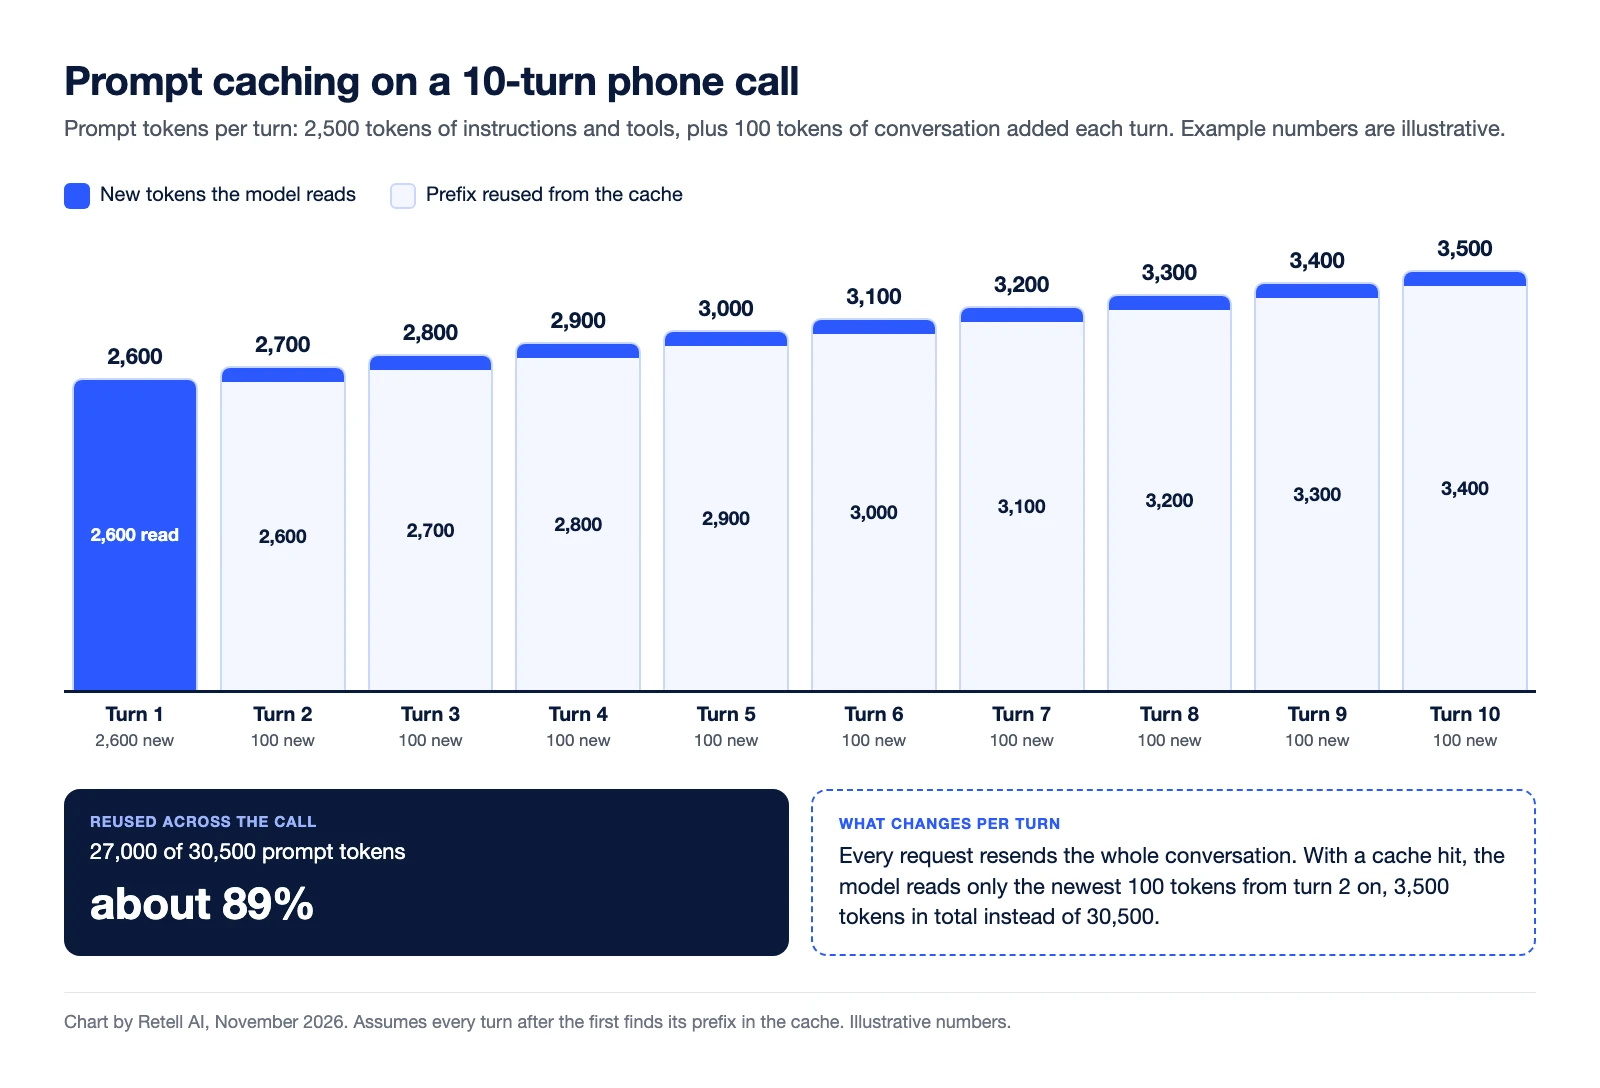
Isso importa por dois motivos. O tempo até o primeiro token faz parte da latência que quem liga ouve como silêncio, e ler um prompt longo leva tempo. O custo é o segundo: a Anthropic cobra leituras de cache a 0,1 vez o preço base do token de entrada, com gravações de cache a 1,25 vez para o tempo de vida de 5 minutos.
O que impede um acerto de cache?
- Um prefixo alterado. Um timestamp, o nome de quem liga ou uma lista de ferramentas reordenada perto do topo do prompt altera todos os tokens depois dele.
- Um intervalo maior que o tempo de vida do cache.
- A requisição chegar a outra máquina. O guia da OpenAI observa que "os estados em cache ficam em máquinas individuais" e que uma requisição só pode reutilizar um prefixo "se chegar a uma máquina que tenha uma entrada correspondente que não tenha expirado".
O roteamento pode fechar essa última lacuna. O Tell-1, o LLM próprio da Retell, mantém cada chamada nas GPUs que já a têm em cache, usando afinidade de sessão. Segundo o post técnico sobre o LLM da Retell, isso quase dobra a parcela de tokens do prompt servidos do cache, de 36% para 69%, de modo que cada turno tem menos para ler e as respostas começam mais cedo.
O cache não muda a resposta. As notas de design do vLLM dizem que o cache de prefixo "não altera as saídas do modelo".
Onde entram os agentes de voz com IA
O guia de solução de problemas de latência da Retell aponta diretamente o custo do tamanho do prompt: "Cada token no seu prompt aumenta o tempo até o primeiro token, e esse custo é pago em cada turno da conversa."
Se você conectar seu próprio modelo pelo LLM WebSocket da Retell, cada requisição de resposta chega com a "transcrição ao vivo completa coletada na chamada até o momento". Seu servidor monta o prompt, então o comportamento do cache depende de como você o monta e do seu provedor de modelo: mantenha as instruções e as ferramentas primeiro e sem alterações, e acrescente a transcrição depois delas. Para ver o caminho completo de um turno, confira como funciona a IA de voz em tempo real.
Perguntas frequentes sobre cache de prompt
Qual é a diferença entre o cache de prompt e o cache KV?
O cache KV é o estado de atenção armazenado que um modelo constrói enquanto lê tokens. O cache de prompt mantém esse estado após o fim de uma requisição, para que uma requisição posterior com os mesmos tokens iniciais possa reutilizá-lo.
Cache de prefixo é o mesmo que cache de prompt?
São o mesmo mecanismo. Cache de prefixo é o termo que os motores de inferência usam. Cache de prompt é o nome de produto que os provedores de modelos usam para ele em suas APIs.
O cache de prompt muda a resposta do modelo?
Não. Ele apenas evita recalcular o prefixo compartilhado.
Quanto tempo dura um cache de prompt?
Depende do provedor. O padrão da Anthropic é de 5 minutos, renovado a cada uso, com uma opção de 1 hora a um preço de gravação maior. Os tempos de vida da OpenAI dependem do modelo.
Por que o cache de prompt importa para agentes de voz?
Cada turno de uma chamada reenvia as instruções e a conversa até ali. Com um acerto de cache, o modelo lê apenas a troca mais recente.
Ouça a diferença nas suas próprias chamadas
A Retell AI é uma plataforma de agentes de voz com IA para centrais de atendimento. O Tell-1 é o LLM próprio dela, criado para ligações telefônicas. A documentação mostra como verificar a latência de cada chamada por componente, para que você veja quanto da espera vem do modelo. Fale com a equipe da Retell.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


