Bästa API:erna för tal-till-tal-AI i realtid för telefonsamtal (2026)



De bästa tjänsterna för tal-till-tal-AI i realtid för telefonsamtal 2026 är Retell AI, OpenAI Realtime API, OpenAI GPT-Live-1, Google Gemini Live API, Amazon Nova 2.5 Sonic, Deepgram Voice Agent API och AssemblyAI Voice Agent API.
Retell är rätt val när samtalen är telefonsamtal i produktion, eftersom plattformen omsluter en tal-till-tal-modell med den telefoni, de överföringar och de tester som en telefonlinje kräver. De övriga sex är modell- eller pipeline-API:er. De ger dig röstloopen och lämnar det mesta av telefonsystemet, överlämningen till en människa och QA åt dig.
Retell AI publicerar den här listan och är ett av alternativen som jämförs. Konkurrenternas priser och funktioner kommer från respektive leverantörs offentliga pris-, modell- eller dokumentationssida, lästa den 22 oktober 2026, och länkas där de citeras.
Så valde och jämförde vi alternativen. Vi tog med varje API som tar emot ljud live och returnerar tal i realtid och som ett team kan koppla till ett telefonnummer: nativa tal-till-tal-modeller från OpenAI, Google och Amazon, två paketerade röstagent-API:er från Deepgram och AssemblyAI, samt Retell som plattformslager. Vi jämförde dem utifrån fem kriterier (nedan) med enbart information som leverantörerna själva publicerat. Vi ringde inga testsamtal och körde inga latenstester, så artikeln innehåller inga poäng och inga latenssiffror.
Sammanfattning
- Nativa tal-till-tal-modeller: OpenAI gpt-realtime-2.1, OpenAI GPT-Live-1, Gemini 3.8 Live och Amazon Nova 2.5 Sonic tar emot ljud och returnerar ljud i en och samma modell.
- Paketerade röstagent-API:er: Deepgram och AssemblyAI kör tal-till-text, en LLM och text-till-tal bakom en WebSocket och ett minutpris.
- Lägsta publicerade minutpriser för ljud: Gemini 3.8 Live, med $0.005 per minut in och $0.018 per minut ut, vilket Google räknar om från $3 och $12 per 1M ljud-token.
- Fasta minutpriser: GPT-Live-1 för $0.05 per minut för röstlagret (backend-modellen debiteras separat), Deepgram från $0.075 per minut och AssemblyAI för $0.075 per minut allt inräknat.
- Direkt SIP: OpenAI tar emot SIP-samtal både i sitt Realtime API och i sina Live-sessioner, och AssemblyAI tar emot SIP via ditt eget Twilio-konto. För Gemini Live hänvisar Googles dokumentation till partnerintegrationer som LiveKit och Pipecat.
- AI-telefonagenter i produktion: Retell kör OpenAI:s realtidsmodeller, Grok Voice eller en standard-LLM-pipeline och lägger till förberedd överföring, IVR-navigering, simuleringstester och analys efter samtal.
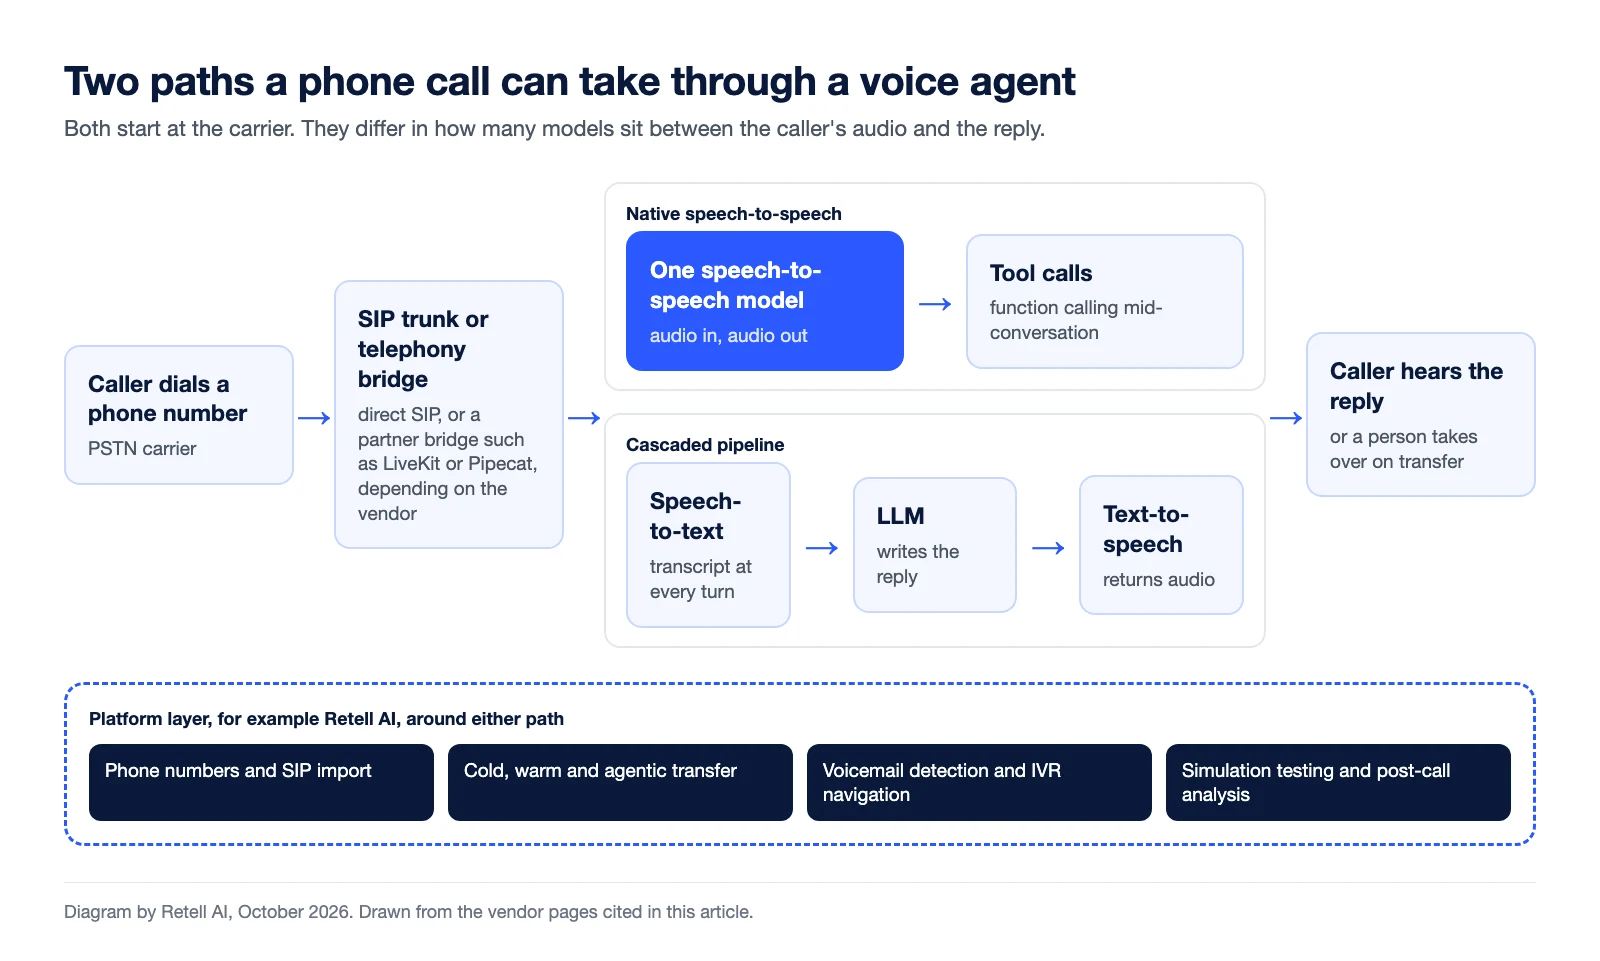
Hur står sig de 7 API:erna mot varandra?
Den avgörande skillnaden är om du köper en modell eller en AI-telefonagent. Tabellen visar vad varje alternativ är, hur ett telefonsamtal når det och dess publicerade pris den 22 oktober 2026.
| API | Vad det är | Hur ett telefonsamtal når det | Publicerat pris | Bäst för |
|---|---|---|---|---|
| Retell AI | Plattform för AI-telefonagenter som kör OpenAI:s realtidsmodeller, Grok Voice eller en standard-LLM-pipeline | Inbyggt: köp nummer i USA eller Kanada, eller importera dina egna via SIP, Twilio eller Vonage | Från $0.07 per minut, se Retells priser | AI-telefonagenter för inkommande och utgående samtal i produktion |
| OpenAI Realtime API | Nativ tal-till-tal-modell (gpt-realtime-2.1) med konfigurerbart resonerande och funktionsanrop | SIP-trunk som pekar på OpenAI:s SIP-endpoint | $32 per 1M ljud-token in, $64 ut | Team som bygger sin egen stack på GPT-resonerande |
| OpenAI GPT-Live-1 | Röstmodell med full duplex som lämnar över resonerandet till en backend-modell | Inkommande och utgående SIP i Live-sessioner (utgående måste aktiveras för din organisation) | $0.05 per minut, plus användning av backend-modellen | Naturlig turtagning med en separat resonerande modell |
| Gemini Live API | Nativa ljud-till-ljud-modeller (Gemini 3.8 Live, Gemini 3.8 Live Extended Thinking) | Partnerintegrationer som LiveKit och Pipecat; ingen SIP-väg på de sidor vi läste | $0.005 per minut ljud in, $0.018 ut | Låg publicerad ljudkostnad, grounding med Google Search |
| Amazon Nova 2.5 Sonic | Nativ tal-till-tal-modell på Amazon Bedrock | Tas inte upp i AWS-tillkännagivandet | Samma som Nova 2 Sonic, enligt AWS | Team som redan använder AWS Bedrock |
| Deepgram Voice Agent API | Kaskadkopplad STT, LLM och TTS bakom en WebSocket | Telefoniguider för Twilio och Plivo; du sköter anslutningen | $0.075 per minut på Standard, betala per användning | Team som vill ha Deepgrams taligenkänning med möjlighet att använda en egen LLM |
| AssemblyAI Voice Agent API | Kaskadkopplad STT, LLM och TTS bakom en WebSocket | SIP via ditt eget Twilio-konto | $4.50 per timme ($0.075 per minut), allt inräknat | Samtal där precision är avgörande, till fast pris |
Så jämförde vi varje API
Vi tittade på fem saker som ett telefonsamtal blottlägger men en webbläsardemo döljer:
- Telefoniväg. Kan ett PSTN-samtal nå modellen utan att du kör en egen mediaserver?
- Turtagning under verkliga förhållanden. Dokumenterar leverantören hur avbrott hanteras i livesamtal?
- Verktygsanrop medan agenten talar. Kan agenten slå upp en beställning medan den fortsätter prata?
- Överlämning till en människa. Är förberedd överföring inbyggd, eller är det din kod?
- Kostnad som går att förutse. Debiteras det per minut eller per token, och vad ligger utanför mätaren?
Leverantörernas påståenden om latens mäts på olika sätt och går inte att jämföra, så inga sådana tas med här.
Retell AI
Retell AI är det bästa valet när en tal-till-tal-modell ska klara riktiga telefonsamtal, eftersom plattformen hanterar allt runt modellen: nummer, överlämning, röstbrevlåda och tester.
Retells API listar tal-till-tal-alternativ, bland annat OpenAI:s gpt-realtime-familj (gpt-realtime-2.1, gpt-realtime-2 med flera) och Grok Voice 3.0, som ett val bland de modeller som stöds. Du kan också köra en agent på en standardpipeline med valfri LLM och behålla samma telefoni, överföringar och tester i båda fallen. Se modellalternativen i API-referensen.
Som belägg för svåra samtal körde Cekura ett benchmark med 414 samtal på sex röstplattformar (Retell, ElevenLabs, Pipecat, LiveKit, Synthflow och Vapi) i ett reglerat Medicare-arbetsflöde. Retell klarade 22 av 23 utvärderingar och ledde med 95.7% precision i arbetsflödet, där endast kontroller som godkändes i alla tre körningar räknades. De svåra fallen omfattade en uppringare som avbryter informationsupplysningen och kräver detaljer om planen, en familjemedlem som ringer för en förmånstagares räkning och en uppringare som ber agenten lova att en plan täcker deras läkemedel. Det är ett plattformsbenchmark för ett enda arbetsflöde, inte en jämförelse av tal-till-tal-modeller.
Det här får du utöver modellen:
- Telefoni: köp nummer i USA eller Kanada i dashboarden, eller importera dina egna via SIP-trunking, bland annat Twilio och Vonage.
- Överlämning: direkt, förberedd och agentisk samtalsöverföring till en person, med en kontextuell sammanfattning vid förberedd överföring.
- Utgående telefoni: identifiering av röstbrevlåda och IVR-navigering genom andra företags telefonmenyer.
- Tester och QA: simuleringstester före lansering, och därefter analys efter samtal och AI-kvalitetssäkring av samtal i produktion.
Pris: från $0.07 per minut enligt Retells prissida.
Tänk på: Retell är en plattform, inte en rå modell-endpoint. Om du själv vill äga varje ljudram i pipelinen bör du i stället börja med ett modell-API.
OpenAI Realtime API (gpt-realtime-2.1)
OpenAI Realtime API är rätt val för team som vill ha en rå tal-till-tal-modell med GPT-resonerande och som själva bygger resten av telefonstacken.
gpt-realtime-2.1 tar emot ljud och returnerar ljud, stöder konfigurerbar resonemangsnivå och funktionsanrop, och uppdaterar gpt-realtime-2 med bättre igenkänning av alfanumeriska tecken, bättre hantering av tystnad och brus samt bättre beteende vid avbrott. OpenAI anger samma priser för båda modellerna.
Modellen kan också besvara ett telefonsamtal utan separat brygga. Enligt OpenAI:s SIP-guide pekar du en SIP-trunk mot OpenAI:s SIP-endpoint, accepterar eller avvisar varje samtal med dess samtals-ID och kan överföra det med en SIP REFER.
Pris: $32 per 1M ljud-token in och $64 per 1M ljud-token ut, plus $4 och $24 per 1M text-token. Högre resonemangsnivå kan öka latensen och förbrukningen av utdata-token.
Tänk på: tokendebiteringen växer med samtalets längd eftersom kontexten ackumuleras. Inspelning, QA, nya försök och logik för eskalering till människa får du bygga själv.
OpenAI GPT-Live-1
GPT-Live-1 passar bäst när naturlig turtagning är viktigare än att ha resonerandet i själva röstmodellen. Det är en modell med full duplex som lyssnar och talar samtidigt och delegerar resonerande och verktygsanvändning till en backend-agent. Vår guide till GPT-Live-1 visar hur den uppdelningen fungerar i en AI-telefonagent.
Den körs på OpenAI:s endpoint för Live-sessioner, inte Realtime-endpointen, så den kan inte bara bytas in direkt mot gpt-realtime-2.1. Enligt OpenAI:s guide för röst och SIP kommer inkommande samtal via SIP, och utgående SIP-samtal är tillgängliga via Live API när funktionen har aktiverats för din organisation. Påringning är begränsad till 3 minuter och ett uppkopplat samtal till 2 timmar.
Pris: $0.05 per sessionsminut, debiterat per sekund, där backend-modell och verktygsanvändning debiteras separat.
Tänk på: antalet samtidiga sessioner är begränsat per nivå, till 50 sessioner på Build, 300 på Launch och 500 på Grow, och inkommande SIP kräver att stöd för GPT-Live SIP är aktiverat för ditt projekt.
Google Gemini Live API
Gemini Live API har de lägsta minutpriserna för ljud bland de publicerade priserna. Gemini 3.8 Live och Gemini 3.8 Live Extended Thinking blev allmänt tillgängliga den 15 september 2026, och båda anger $0.005 per minut för ljud in och $0.018 per minut för ljud ut på Googles prissida. Minutpriserna står bredvid $3 och $12 per 1M ljud-token, så de är en omräkning, inte en separat mätare.
Extended Thinking-modellen stöder resonerande i bakgrunden under samtalet, och grounding med Google Search stöds på den betalda nivån, med 5,000 kostnadsfria sökningar per månad och därefter $14 per 1,000.
Tänk på: Googles guide till Live API listar partnerintegrationer som LiveKit och Pipecat och beskriver ingen väg via SIP-trunk, så räkna med en brygga framför Live API. Priset för utdata inkluderar tanke-token, så minutpriset är ett golv.
Amazon Nova 2.5 Sonic
Amazon Nova 2.5 Sonic är standardvalet för team som redan bygger på AWS Bedrock. AWS gjorde den allmänt tillgänglig den 5 oktober 2026, med förbättrat resonerande, bättre instruktionsföljning och precision i verktygsanrop, lägre latens, uttrycksfulla röster på sju språk, styrbar turtagning, asynkrona verktygsanrop och ett kontextfönster på 256K.
AWS ramverk Strands Bidi Agents, som nu är allmänt tillgängligt, är AWS väg till att bygga en röstagent med några få rader kod.
Pris: AWS anger samma pris för Nova 2.5 Sonic som för Nova 2 Sonic. Se Amazon Novas prissida för aktuella priser per token, som laddas dynamiskt.
Tänk på: modellen finns i fyra Bedrock-regioner (N. Virginia, Oregon, Stockholm, Tokyo), och sju språk är ett smalare utbud än hos vissa andra alternativ här. Tillkännagivandet beskriver ingen telefoniväg, så bekräfta hur samtal når modellen innan du bestämmer dig.
Deepgram Voice Agent API
Deepgrams Voice Agent API är rätt val för team som vill ha Deepgrams taligenkänning med möjlighet att använda en egen LLM eller röst. Det kör tal-till-text, en LLM och text-till-tal bakom en WebSocket och en minutmätare, och Deepgrams dokumentation innehåller guider för telefoniagenter för inkommande och utgående samtal med Twilio och Plivo.
Pris: $0.075 per minut på nivån Standard med betala per användning och $0.163 på Advanced, med lägre priser om du använder din egen LLM eller TTS.
Tänk på: det är en kaskadpipeline, inte en nativ tal-till-tal-modell. Konton med betala per användning är begränsade till 45 samtidiga Voice Agent-anslutningar (60 på Growth), vilket spelar roll första gången en kampanj ringer ut.
AssemblyAI Voice Agent API
AssemblyAIs Voice Agent API är rätt val när transkriptionens precision avgör om agenten fungerar, till exempel för namn, kontonummer och adresser. Det kör AssemblyAIs talmodell Universal-3.6 Pro Realtime, en LLM och TTS bakom en WebSocket.
Pris: fast $4.50 per timme ($0.075 per minut) som täcker tal-till-text, LLM och TTS, debiterat per sessionsminut, enligt AssemblyAIs prisreferens. För telefonsamtal anger AssemblyAIs dokumentation att Twilio skickar samtalen vidare till AssemblyAI via SIP, så du behöver inte köra någon mediaserver eller webhook. SIP-trunken och numret finns i ditt eget Twilio-konto.
Tänk på: precis som Deepgram är det kaskadkopplat, inte nativt ljud-till-ljud, så du får en transkription vid varje tur men ingen modell som uppfattar tonläget direkt.
Ska du använda en nativ tal-till-tal-modell eller en kaskadpipeline?
Använd en nativ tal-till-tal-modell när tonläge och snabb turtagning är viktigare än kontroll över varje steg, och en kaskadpipeline när du behöver se och korrigera vad agenten uppfattade. En nativ modell tar emot ljud och returnerar ljud, utan något separat transkriptionssteg. En kaskadpipeline ger dig en transkription vid varje tur, vilket gör det enklare att felsöka ett felaktigt kontonummer eller upprätthålla ett compliance-manus.
Oavsett vilket tillför en telefonlinje arbete som modellen inte gör: hantering av avbrott, återhämtning vid överföringar och tester mot samtal som avviker från manus. Läs mer om hur de två upplägget skiljer sig åt i så fungerar röst-AI i realtid. Om du väljer den resonerande modellen bakom en kaskadagent kan du läsa om de bästa LLM:erna för AI-röstagenter och de bästa tal-till-text-modellerna.
Hur väljer du rätt API för dina samtal?
Utgå från var samtalet landar och vem som äger felet. Fyra frågor avgör saken:
- Kommer samtalen från telefonnätet? Om ja, uteslut allt som kräver en brygga du inte vill driva, eller välj en plattform som inkluderar telefoni. Vår guide till SIP-trunking och modern telefoni tar upp operatörssidan.
- Vad händer när agenten inte vet? Om en person måste ta över med kontext behöver du förberedd överföring, inte bara en endpoint som lägger på.
- Kan du förutse kostnaden? Minutpriser (GPT-Live-1, Deepgram, AssemblyAI) är enklare att budgetera än tokenpriser, där långa samtal kostar mer per minut.
- Vem åtgärdar ett misslyckat samtal? Om ditt driftteam, inte dina utvecklare, ska finjustera prompts och flöden, välj en plattform med inbyggda tester och versionshantering.
Vanliga frågor
Vad är ett tal-till-tal-AI-API?
Ett tal-till-tal-AI-API tar emot ljud från den som ringer och returnerar talat ljud från en enda modell, utan separata steg för transkription och röst. OpenAI gpt-realtime-2.1, GPT-Live-1, Gemini 3.8 Live och Amazon Nova 2.5 Sonic fungerar på det sättet.
Vilket tal-till-tal-API är billigast för telefonsamtal?
Gemini 3.8 Live anger de lägsta minutpriserna för ljud, med $0.005 per minut för ljud in och $0.018 per minut för ljud ut, omräknat av Google från $3 och $12 per 1M ljud-token. Din faktiska kostnad tillkommer för telefoni, eventuell brygga du kör och tanke-token, som debiteras som utdata. AWS anger samma pris för Nova 2.5 Sonic som för Nova 2 Sonic, och OpenAI debiterar Realtime API per token, så jämför utifrån din egen samtalslängd.
Kan jag koppla OpenAI Realtime API till ett telefonnummer?
Ja. Peka en SIP-trunk från en operatör som Twilio mot OpenAI:s SIP-endpoint och acceptera sedan varje samtal med dess samtals-ID. Överföringar använder en SIP REFER.
Stöder Retell tal-till-tal-modeller?
Ja. Retells API listar tal-till-tal-alternativ, bland annat OpenAI:s gpt-realtime-familj och Grok Voice 3.0, och en Retell-agent kan i stället köras på en standardpipeline med valfri LLM. Funktionerna för telefoni och överföring är desamma i båda fallen.
Vad händer när AI-agenten inte kan svara?
Med ett modell-API skriver du eskaleringslogiken själv. Med Retell kan agenten göra en direkt, förberedd eller agentisk samtalsöverföring till en person, och vid en förberedd överföring skickas en kontextuell sammanfattning med så att den som ringer inte behöver upprepa sig.
Kan jag behålla mitt befintliga telefonnummer?
Med Retell, ja: du kan importera ett befintligt nummer via SIP-trunking i stället för att köpa ett nytt. Med modell-API:erna beror det på vilken SIP-trunk eller brygga du kör.
Testa på dina egna samtal
Ett demomanus visar inte skillnaden mellan de här API:erna; dina egna samtal gör det. Bygg en Retell-agent gratis, välj en tal-till-tal-modell eller en standardmodell och kör den mot de samtal ditt team tycker är svårast.
See how much your business could save by switching to AI-powered voice agents.
ROI Result
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Ett demonummer från Retell Clinic Office
What results look like with Retell AI


Estimate your monthly voice AI cost
Read Other Blogs

Revolutionera din samtalsverksamhet med Retell


