GPT-Live-1: cómo funciona en llamadas telefónicas el modelo de voz full duplex de OpenAI




GPT-Live-1 es el modelo de voz full duplex de OpenAI. Escucha y habla al mismo tiempo, gestiona las interrupciones por sí mismo y delega el razonamiento y el uso de herramientas en un modelo de backend independiente. OpenAI lo lanzó en la API el 10 de septiembre de 2026, tras su debut en el modo de voz de ChatGPT, y está disponible en los agentes telefónicos de Retell AI desde el 2 de noviembre de 2026. Esta guía explica cómo funciona, cuánto cuesta en la API, en qué casos encaja en las llamadas telefónicas y cómo configurarlo en un agente de Retell.
Retell AI publica esta guía y ofrece GPT-Live-1 como uno de los modelos de su plataforma de agentes de voz.
GPT-Live-1 de un vistazo
| GPT-Live-1 | |
|---|---|
| Desarrollador | OpenAI |
| ID del modelo | gpt-live-1 |
| Tipo | Modelo de voz full duplex que delega el razonamiento y el uso de herramientas en un modelo o agente de backend |
| Entrada y salida | Entrada de audio y texto, salida de audio y texto |
| Endpoint de la API | Sesiones Live (v1/live/sessions), a través de WebRTC, WebSockets o telefonía y SIP |
| Precio en la API | 0,05 $ por minuto de sesión de voz, facturado por segundo. El modelo de backend y el uso de herramientas se facturan aparte. |
| Concurrencia | 50 sesiones en el nivel Build, 300 en Launch y 500 en Grow. No disponible en el nivel Free. |
| Ventana de contexto | 128.000 tokens |
| Versión más reciente | GPT-Live-1.1 se lanzó en ChatGPT, Codex y dots el 15 de octubre de 2026, con su llegada a la API anunciada como próxima. No está en la API a 5 de noviembre. |
Fuentes: página del modelo GPT-Live-1, guía de Live, guía de conversaciones Live, changelog de la API y artículo de lanzamiento de OpenAI; datos de GPT-Live-1.1 a partir de una publicación en el foro de desarrolladores de OpenAI. Consultado el 5 de noviembre de 2026.
Cómo funciona el full duplex
La mayoría de los agentes de voz gestionan los turnos de una de dos formas. Un agente en cascada transcribe al interlocutor, envía el texto a un modelo de lenguaje y luego convierte la respuesta en voz. Un modelo speech-to-speech, como gpt-realtime-2.1 de OpenAI, hace los tres pasos dentro de un solo modelo.
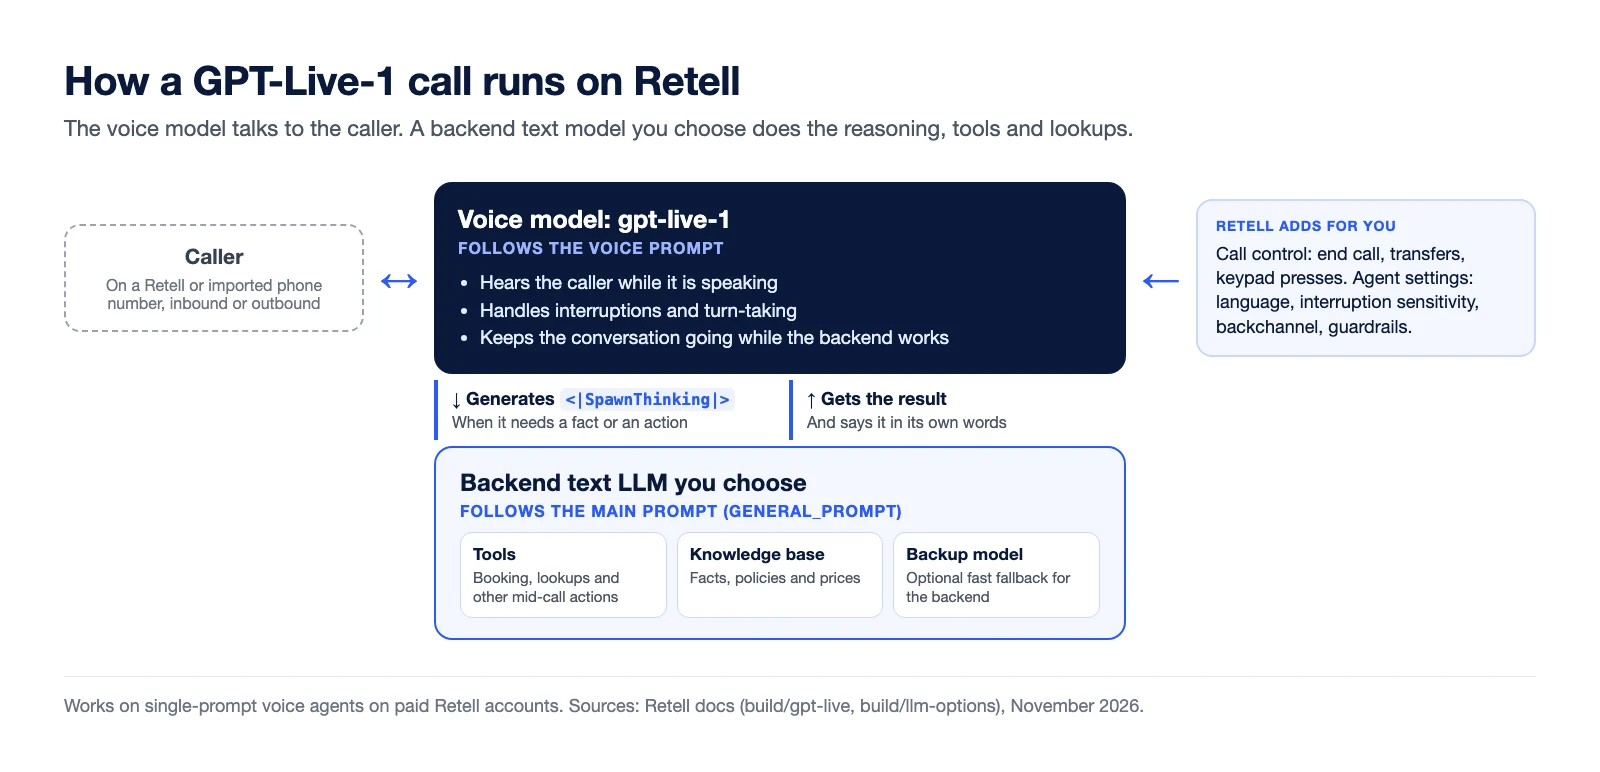
GPT-Live-1 reparte el trabajo de otra manera. El modelo de voz lleva la conversación: oye al interlocutor mientras habla, gestiona las interrupciones y las pausas, y decide qué decir a continuación. Cuando necesita un dato o una acción, solicita trabajo al backend generando un token especial, <|SpawnThinking|>. El backend puede ser un modelo, un agente o un servicio; en Retell es un modelo de texto que tú eliges y que ejecuta las herramientas y la base de conocimiento del agente. El backend devuelve el resultado y el modelo de voz lo comunica con sus propias palabras. El trabajo del backend puede seguir ejecutándose aunque el interlocutor interrumpa.
Las propias cifras de OpenAI respaldan esta división. En los gráficos de su artículo de lanzamiento en la API, GPT-Live-1 con GPT-6 Astra como backend, con esfuerzo de razonamiento medio, supera el 86,2 % de las tareas de voz de Tau3 (atención al cliente en aerolíneas, retail y telecomunicaciones) al primer intento, frente al 45,7 % de GPT-Realtime-2.1. En Full Duplex Bench, OpenAI indica una latencia de toma de turno de 0,798 segundos para GPT-Live-1, frente a 1,41 segundos para GPT-Realtime-2.1. Son resultados de OpenAI, no mediciones de Retell.
¿En cascada, speech-to-speech o full duplex?
Retell admite las tres formas de ejecutar un agente de voz. Cada una encaja con un tipo de llamada distinto.
| En cascada | Speech-to-speech | Full duplex (GPT-Live-1) | |
|---|---|---|---|
| Cómo funciona un turno | Transcripción, luego un LLM de texto y después texto a voz | Un solo modelo oye el audio y responde en audio | Un modelo de voz habla mientras un LLM de texto de backend se encarga del razonamiento y las herramientas |
| Ejemplos en Retell | GPT 5.6 Terra, Claude 5 Sonnet, Gemini 3.5 Flash | gpt-realtime-2.1, grok-voice-3.0 | gpt-live-1 con un LLM de texto de backend |
| Prompts | Uno | Uno | Dos: un prompt de voz y el prompt del backend |
| Modelo de respaldo con fallback rápido | Compatible | No compatible | Se aplica al modelo de backend |
| Ideal para | Flujos de conversación y lógica estricta de varios pasos | Llamadas rápidas y naturales que siguen principalmente un único prompt | Llamadas naturales que además ejecutan acciones durante la llamada |
Para la opción speech-to-speech de xAI, consulta cómo ejecutar un agente telefónico con Grok Voice. Para ver el panorama general de modelos, consulta nuestra comparativa de API de IA speech-to-speech para llamadas telefónicas.
En qué casos encaja GPT-Live-1 en las llamadas telefónicas
GPT-Live-1 rinde mejor en agentes de prompt único que ejecutan acciones durante la llamada, como concertar una cita o consultar un pedido, donde el tiempo de respuesta de un agente en cascada se nota. Mientras el backend hace la reserva o la consulta, el modelo de voz mantiene la conversación en lugar de detenerse con una frase de relleno.
En Retell tiene límites claros:
- Solo agentes de voz de prompt único. No está disponible para flujos de conversación, agentes multiprompt, agentes de transferencia ni agentes de chat. Para esos casos, usa un modelo en cascada o speech-to-speech.
- Algunas herramientas no son compatibles. El cambio de agente, la transferencia asistida (con puente) y la cancelación de transferencia se rechazan al guardar. La transferencia de llamadas simple, finalizar llamada y pulsar dígito funcionan sin problema.
- Solo cuentas de pago. Al igual que los modelos speech-to-speech, GPT-Live-1 no forma parte de la prueba gratuita.
- Sin cambio por llamada. Una sustitución de agente en una llamada concreta no puede pasar un agente a GPT-Live-1.
Cómo configurar GPT-Live-1 en un agente telefónico de Retell
GPT-Live-1 se configura a través de la API de Retell, en un Retell LLM.
- Crea un Retell LLM con model_config de tipo duplex, gpt-live-1 como modelo principal y el modelo de texto que quieras como backend.
- Escribe dos prompts. general_prompt es el prompt del backend: la tarea, las herramientas y los guardrails. voice_prompt indica al modelo de voz cómo hablar y cuándo delegar trabajo en el backend. Puede tener hasta 15.000 tokens.
- Vincula el LLM a un agente de voz como motor de respuesta, igual que cualquier otro Retell LLM.
- Conecta un número de teléfono y recibe llamadas entrantes o realiza llamadas salientes.
Este es un ejemplo de solicitud adaptado de la documentación de Retell, para el agente de una clínica dental:
curl --request POST "https://api.retellai.com/create-retell-llm" \
  --header "Authorization: Bearer $RETELL_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "general_prompt": "You are the backend for a dental clinic phone agent. Collect the caller name and date of birth, then use the booking tool to find and confirm an appointment. Keep names, numbers, and dates exact.",
    "voice_prompt": "You are a warm, efficient front-desk agent for Bright Smile Dental. Keep replies short and natural, and ask one question at a time.\n\nDelegation policy:\nBackend tools:\n- Appointments: find open times and book, change, or cancel appointments.\n\nGenerate <|SpawnThinking|> when:\n- The caller wants to book, change, or cancel an appointment.\n\nDo not generate <|SpawnThinking|> when:\n- You need a brief clarification to understand the request.",
    "model_config": {
      "type": "duplex",
      "primary": { "model": "gpt-live-1" },
      "backend": { "model": "gpt-4.1" }
    }
  }'
Encontrarás todos los detalles de los campos en la guía de configuración de GPT Live.
Cómo escribir el prompt de voz
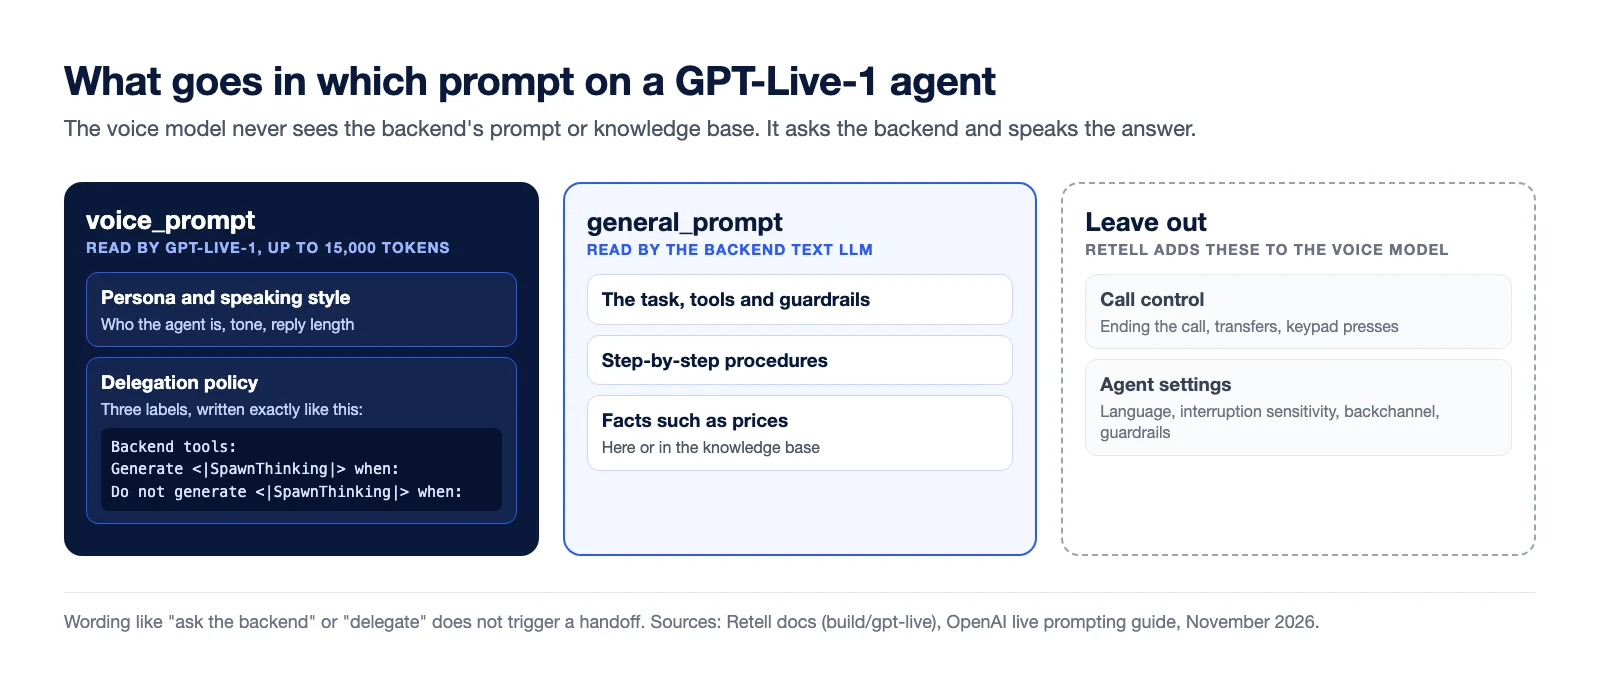
El prompt de voz es donde fallan la mayoría de los agentes con GPT-Live-1. El modelo solo delega trabajo en el backend cuando genera <|SpawnThinking|>, así que las reglas de delegación deben usar esa expresión exacta. Fórmulas como "pregunta al backend" o "delega" no activan la delegación. La guía de prompting de OpenAI también advierte de que una promesa hablada como "Lo estoy comprobando" no significa que el trabajo del backend haya empezado.
Escribe el prompt de voz en dos partes:
- Personalidad y estilo de habla. Quién es el agente y cómo habla, por ejemplo, el tono y la longitud de las respuestas.
- Una política de delegación con tres etiquetas, escritas exactamente así: "Backend tools:" enumera lo que puede hacer el backend, una capacidad por línea. "Generate <|SpawnThinking|> when:" enumera cuándo delegar. "Do not generate <|SpawnThinking|> when:" enumera lo que se responde directamente.
Mantén las definiciones de herramientas, los procedimientos paso a paso y datos como los precios en el prompt del backend y en la base de conocimiento. El modelo de voz no los ve: pregunta al backend y comunica la respuesta con sus propias palabras. Además, Retell añade por ti al modelo de voz las instrucciones de control de la llamada (finalizar la llamada, transferencias, pulsaciones de teclado) y los ajustes del agente, así que no los incluyas.
Qué se mantiene de los ajustes de tu agente
La mayoría de los ajustes de agente de Retell siguen aplicándose. El modelo de voz respeta el idioma del agente, la sensibilidad a interrupciones, la capacidad de respuesta, el backchannel, la velocidad de voz, la pronunciación, las palabras clave potenciadas y los guardrails. La detección de buzón de voz, IVR, lista de no llamar y devolución de llamada se ejecuta a través del backend, y el ajuste del mensaje de bienvenida sigue determinando quién habla primero.
Hay dos cosas que funcionan de otra manera. Se ignora el ajuste "hablar durante la ejecución" de cada herramienta, porque el modelo de voz sigue hablando mientras se ejecuta el backend, y el agente siempre habla cuando termina una herramienta. Las variables dinámicas del prompt de voz se rellenan una sola vez, al inicio de la llamada.
Cuánto cuesta GPT-Live-1
En la API de OpenAI, una sesión de voz de GPT-Live-1 cuesta 0,05 $ por minuto, facturada por segundo y sin redondear al minuto siguiente. El modelo de backend y sus herramientas se facturan aparte a sus tarifas habituales.
En Retell, el modelo de voz se factura por minuto de llamada y el LLM de texto de backend se factura aparte según su propio uso. Las tarifas actuales están en la página de precios. Hay un detalle importante para las llamadas largas: Retell reduce los cargos del modelo durante los periodos largos de silencio, pero los modelos de voz full duplex se siguen facturando durante esos periodos.
Preguntas frecuentes
¿Qué es GPT-Live-1?
GPT-Live-1 es el modelo de voz full duplex de OpenAI para conversaciones en tiempo real. Escucha y habla al mismo tiempo, gestiona las interrupciones y delega el razonamiento y el uso de herramientas en un modelo o agente de backend que tú eliges.
¿GPT-Live-1 está disponible en la API?
Sí. GPT-Live-1 pasó a estar disponible de forma general en la API de OpenAI el 10 de septiembre de 2026, en el endpoint de sesiones Live. GPT-Live-1.1, una versión más reciente con más voces y mejor rendimiento en idiomas distintos del inglés, se lanzó en ChatGPT, Codex y dots el 15 de octubre de 2026, y su llegada a la API se anunció como próxima.
¿Cuánto cuesta GPT-Live-1?
OpenAI cobra 0,05 $ por minuto por una sesión de voz de GPT-Live-1, facturada por segundo. El modelo de backend y el uso de herramientas se facturan aparte a sus tarifas habituales.
¿Puede GPT-Live-1 gestionar llamadas telefónicas?
Sí. OpenAI admite conexiones de telefonía y SIP para las sesiones Live. En Retell, un agente con GPT-Live-1 es un agente de voz como cualquier otro, así que puedes conectarlo a un número de teléfono para llamadas entrantes y salientes, y tanto la transferencia de llamadas simple como pulsar dígito funcionan.
¿En qué se diferencia GPT-Live-1 de gpt-realtime?
Los modelos gpt-realtime son speech-to-speech: un solo modelo escucha, razona, llama a herramientas y habla, en la Realtime API de OpenAI. GPT-Live-1 se ejecuta en un endpoint independiente de sesiones Live, mantiene la voz en su propio modelo y envía el razonamiento y las herramientas a un backend. OpenAI indica una mayor tasa de finalización de tareas para GPT-Live-1 combinado con un backend potente, además de una toma de turnos más rápida.
¿GPT-Live-1 funciona con flujos de conversación en Retell?
No. En Retell, GPT-Live-1 solo funciona en agentes de voz de prompt único. Los flujos de conversación y los agentes multiprompt necesitan un modelo en cascada o speech-to-speech.
Prueba GPT-Live-1 en tus propias llamadas
Si tu agente ejecuta acciones durante la llamada y las pausas te molestan, merece la pena hacer un piloto con GPT-Live-1. Sigue la guía de configuración, conecta un número en Retell y compáralo con tu modelo actual en llamadas reales antes de cambiar.
Descubre cuánto podría ahorrar tu empresa al pasar a agentes de voz impulsados por IA.
Resultado del ROI
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Un número de teléfono de demostración de Retell Clinic Office
What results look like with Retell AI


Estimate your monthly voice AI cost
Read Other Blogs
Revoluciona tu operación de llamadas con Retell


