Qué buscan los equipos de producto en una plataforma de IA de voz




Una plataforma de IA de voz es el software que usa un equipo de producto para crear, conectar, probar y ejecutar agentes de voz con IA en llamadas telefónicas y web. Los responsables de producto e ingeniería rara vez eligen una a partir de una demo. Crean el mismo agente en cada plataforma preseleccionada y comprueban cuatro cosas por sí mismos: lo rápido que se consigue el primer agente funcional, hasta dónde llegan la API y las herramientas de flujos de trabajo, cuánto esperan los interlocutores una respuesta y qué cambia cuando un piloto pasa a tráfico de producción.
Esta guía es un plan para esa comparación práctica. Retell AI publica esta guía y es una de las plataformas que comparan los equipos de producto, junto con Vapi, ElevenLabs y Bland. Lo que decimos sobre las otras tres procede de la propia documentación de cada proveedor, consultada el 10 de noviembre de 2026 y enlazada. No hicimos llamadas de prueba para esta guía, así que no incluye puntuaciones ni clasificación. Lo que decimos sobre Retell procede de la documentación pública de Retell, incluidos los límites que esa documentación indica.
¿Qué comprueba un equipo de producto que una demo no muestra?
Una demo muestra una buena llamada. Una comparación práctica muestra lo que tus propios ingenieros pueden crear, conectar y medir. Asigna a un ingeniero el mismo tipo de llamada en cada plataforma, uno real como concertar una cita contra tu API de agenda, y registra los mismos cuatro resultados en cada una.
| Qué comprobar | Qué hace tu equipo | Qué anotar |
|---|---|---|
| Facilidad de desarrollo | Crear el agente desde una cuenta vacía hasta una primera llamada, sin ayuda del proveedor | Horas hasta la primera llamada funcional y cada punto en el que te atascaste |
| Profundidad de la API y los flujos de trabajo | Llamar a tu propia API durante una llamada, recibir eventos de llamada, crear el agente desde código | Qué pasos necesitaron una solución alternativa |
| Latencia de respuesta | Hacer al menos 20 llamadas y extraer los tiempos de cada turno | Mediana y percentil 95, con la definición que usa el proveedor |
| Del piloto a escala | Leer los límites, el comportamiento ante fallos y los controles de publicación antes de necesitarlos | Límites por defecto, qué ocurre al alcanzarlos y qué determina el coste |
¿Con qué rapidez puede tu equipo crear el primer agente funcional?
Mide el tiempo desde una cuenta vacía hasta una llamada que tu ingeniero enseñaría a un compañero, y anota cada punto en el que tuvo que pedir ayuda al proveedor. Una respuesta encontrada en la documentación cuenta como autoservicio.
En la mayoría de las plataformas, dos factores determinan ese tiempo. El primero es cuánta estructura debes diseñar antes de que el agente pueda hablar. La documentación de Retell recomienda empezar con un agente de prompt único y pasar a un flujo de conversación, que divide la tarea en nodos con sus propias instrucciones, solo cuando un único prompt ya no cubra tus requisitos. La misma página es clara sobre la contrapartida: «El flujo de conversación no es automáticamente más fiable».
El segundo es lo pronto que puedes escuchar al agente y detectar sus errores. La visión general de pruebas de Retell enumera cuatro métodos: chat de texto en el LLM Playground, casos de prueba de simulación guardados, llamadas desde el navegador «sin número de teléfono» y llamadas telefónicas reales. Presupuesta las llamadas de prueba. En Retell, las pruebas se facturan con las mismas tarifas que producción. Para ver paso a paso una primera creación, consulta cómo crear un agente de voz con IA.
La facilidad de desarrollo también depende de lo que la plataforma gestiona por ti. Según la documentación de Retell, la plataforma «gestiona las capas de telefonía, voz y modelo de lenguaje, de modo que configuras el agente en lugar de conectar proveedores». Tu equipo controla el comportamiento del agente sin mantener la infraestructura que hay debajo. Si ese intercambio te conviene es otra decisión, que se trata en desarrollar o comprar agentes de voz con IA.
¿Hasta dónde llegan la API y las herramientas de flujos de trabajo?
Llegar lo bastante lejos significa dos cosas: tus ingenieros pueden hacer desde código lo mismo que hacían en el panel, y el agente puede acceder a tus sistemas durante una llamada sin un proyecto de middleware. Comprueba cinco áreas en cada plataforma.
- SDK y cobertura de la API. Pregunta si cada acción del panel tiene un endpoint. Retell publica SDK oficiales para Node.js y Python, descritos como clientes tipados con cobertura completa de los endpoints de voz y chat.
- Llamar a tu API durante una llamada. Una función personalizada de Retell envía una solicitud GET, POST, PUT, PATCH o DELETE a tu endpoint y espera la respuesta. El tiempo de espera va de 1 a 600 segundos y por defecto es de 120. Las solicitudes no se reintentan salvo que configures un número de reintentos. Pregunta a cada proveedor qué oye el interlocutor mientras se ejecuta una solicitud lenta.
- Eventos de llamada. Los webhooks de Retell envían los eventos call_started, call_ended y call_analyzed a tu servidor. Cada uno tiene un tiempo de espera de 10 segundos y se reintenta hasta 3 veces. Una cabecera de firma te permite verificar el remitente.
- MCP en ambas direcciones. Un agente de Retell puede llamar a las herramientas de un servidor MCP remoto durante una llamada en directo. El propio servidor MCP de Retell permite que clientes como Cursor y Claude Code creen y gestionen agentes a través de la API.
- Tu propio modelo y tu propio operador. Con un LLM personalizado, Retell gestiona la llamada y abre un WebSocket a tu servidor en cada llamada. La documentación recomienda los tipos de agente integrados para la mayoría de los agentes e indica que, con un LLM personalizado, asumes la latencia, la disponibilidad y la gestión de reconexiones. Para las líneas telefónicas, la telefonía personalizada se conecta mediante elastic SIP trunking o marcando una URI SIP.
Comprueba también las conexiones prediseñadas. La visión general de integraciones de Retell enumera 11 proveedores de CRM, soporte, calendario y base de conocimiento. Todo lo que quede fuera de esa lista pasa por una función personalizada, MCP o un webhook.
¿Cómo deberías medir la latencia de respuesta?
Mídela en tus propias llamadas, turno a turno, e informa de percentiles junto con la definición. Una cifra de latencia sin punto de inicio y fin no se puede comparar con la cifra de otro proveedor.
La documentación de Retell define la latencia de extremo a extremo como el tiempo que transcurre desde que el usuario deja de hablar hasta que el agente empieza a responder. Con esa definición, la documentación afirma que la plataforma «alcanza latencias de tan solo 600 ms». Interpreta «de tan solo» como un mínimo. Tu cifra depende del modelo, el prompt y la configuración que elijas.
Para obtener tus propias cifras, extráelas por llamada. La Get Call API de Retell devuelve un objeto de latencia con los percentiles 50, 90, 95 y 99 de la cifra de extremo a extremo y de la transcripción, el LLM, la conversión de texto a voz y la recuperación de la base de conocimiento. La misma página indica un límite: la cifra de extremo a extremo no incluye el trayecto de red desde el servidor de Retell hasta el dispositivo del usuario. En las llamadas web y desde aplicaciones, mide también la respuesta en el cliente.
Cuando una cifra sea alta, revisa la configuración antes de culpar a la plataforma. La guía de resolución de problemas de latencia de Retell señala la elección del modelo LLM y la longitud del prompt como las dos causas más habituales, indica que los prompts de más de unos 8.000 tokens se vuelven notablemente más lentos y aconseja mantener la latencia estimada por debajo de 1,5 segundos. Pide a cada proveedor el mismo desglose por componentes.
La velocidad es solo un factor de una buena llamada. Latencia en IA de voz: causas, medición e impacto en el interlocutor explica de dónde viene el retraso y cuándo una respuesta más rápida empeora una llamada. Para ver resultados de benchmarks publicados de estas cuatro plataformas, consulta Retell AI frente a Bland AI, Vapi y ElevenLabs.
¿Qué cambia entre un piloto y la producción a escala?
Cambian tres cosas: los límites con los que te encuentras, lo que viven los interlocutores cuando algo falla y cómo llegan los cambios a las llamadas en directo. Lee las respuestas de cada proveedor antes de que termine el piloto.
- Concurrencia. Pregunta por el límite por defecto y qué ocurre al alcanzarlo. En Retell, un espacio de trabajo de pago por uso tiene 20 llamadas simultáneas por defecto, y puedes ampliar el límite desde el panel. Al alcanzar el límite, una nueva llamada entrante espera un hueco. Tras unos 40 segundos, se transfiere a un número de respaldo si lo has configurado; si no, la llamada termina. Una llamada saliente que supera el límite se rechaza, salvo que actives el concurrency burst, que añade un recargo por minuto.
- Disponibilidad y mecanismos de respaldo. La visión general de fiabilidad de Retell garantiza una disponibilidad superior al 99,9 % y enlaza a una página de estado pública. Incluye de serie el fallback de LLM y los reintentos, además de un modo Backup que desvía las nuevas llamadas entrantes a un número de respaldo mientras investigas un problema.
- Control de publicación. Las versiones, las etiquetas de staging, las ejecuciones por lotes desde tu pipeline de CI y el reparto de tráfico por porcentajes determinan la seguridad con la que se publica un cambio. Ese tema tiene su propia guía: el listón de compra de la IA de voz.
- Revisión de seguridad. Empiézala durante el piloto. La página de seguridad y cumplimiento de Retell indica que cumple con HIPAA y el RGPD, que cuenta con las certificaciones SOC 2 Tipo 1 y Tipo 2, y ofrece un BAA en autoservicio.
- Factores de coste. Los precios de Retell se basan en el uso, desde 0,07 $ por minuto según la página de precios. La tarifa depende de la voz, el modelo y la telefonía que elijas, y algunas opciones de latencia cuestan más que la tarifa estándar del modelo. Cómo funcionan los precios basados en el uso explica cada componente.
Para diseñar el piloto, cómo evaluar una plataforma de agentes de voz antes de salir a producción explica qué llamadas incluir y qué medir, y de la demo de IA de voz a producción cubre los primeros 30 días.
¿Cómo se describen Vapi, ElevenLabs, Bland y Retell?
La documentación de cada proveedor describe una plataforma para crear, desplegar y supervisar agentes de voz, con una forma de empezar basada en prompts y una opción más estructurada. La tabla cita la propia documentación de cada proveedor, consultada el 10 de noviembre de 2026.
| Plataforma | Cómo la describe su propia documentación | Opciones de creación que menciona la documentación |
|---|---|---|
| Retell AI | «Una plataforma para crear, probar, desplegar y supervisar agentes de voz y chat con IA, con telefonía, prompts, herramientas y analítica integrados» (documentación de Retell) | Agentes de prompt único y agentes de flujo de conversación |
| Vapi | «La plataforma para desarrolladores para crear agentes de IA de voz» (documentación de Vapi) | Assistants, que usan un único prompt de sistema más herramientas y salidas estructuradas, y Squads, que ejecutan varios asistentes con transferencias que conservan el contexto. Tú eliges los proveedores de voz a texto, LLM y texto a voz |
| ElevenLabs | ElevenAgents ofrece «modelos expresivos y ricos en voz, herramientas para desarrolladores para crear agentes multimodales y herramientas para supervisar y evaluar el rendimiento de los agentes a escala» (documentación de ElevenLabs) | Un kit de herramientas para desarrolladores, un panel o un creador visual de flujos de trabajo, con SDK para React, Swift, Kotlin, React Native y Unity |
| Bland | «Todo lo que necesitas para crear, supervisar y mejorar agentes de IA de voz en Bland» (documentación de Bland) | Un creador de agentes en el que «la mayoría de los agentes empiezan como un único prompt» y los pathways añaden estructura donde la conversación lo necesita |
Las descripciones se parecen, así que leerlas no tomará la decisión por ti. Las cuatro comprobaciones se hacen sobre tu tipo de llamada y tus sistemas. Para ver más detalle lado a lado, Retell publica comparativas con Vapi, ElevenLabs y Bland, y una guía de alternativas a Vapi.
¿Cómo se hace una comparación justa?
Mantén todo constante salvo la plataforma. Usa un tipo de llamada, un ingeniero, un guion de comportamiento del interlocutor y una tabla de evaluación, y rellena los mismos campos para cada proveedor.
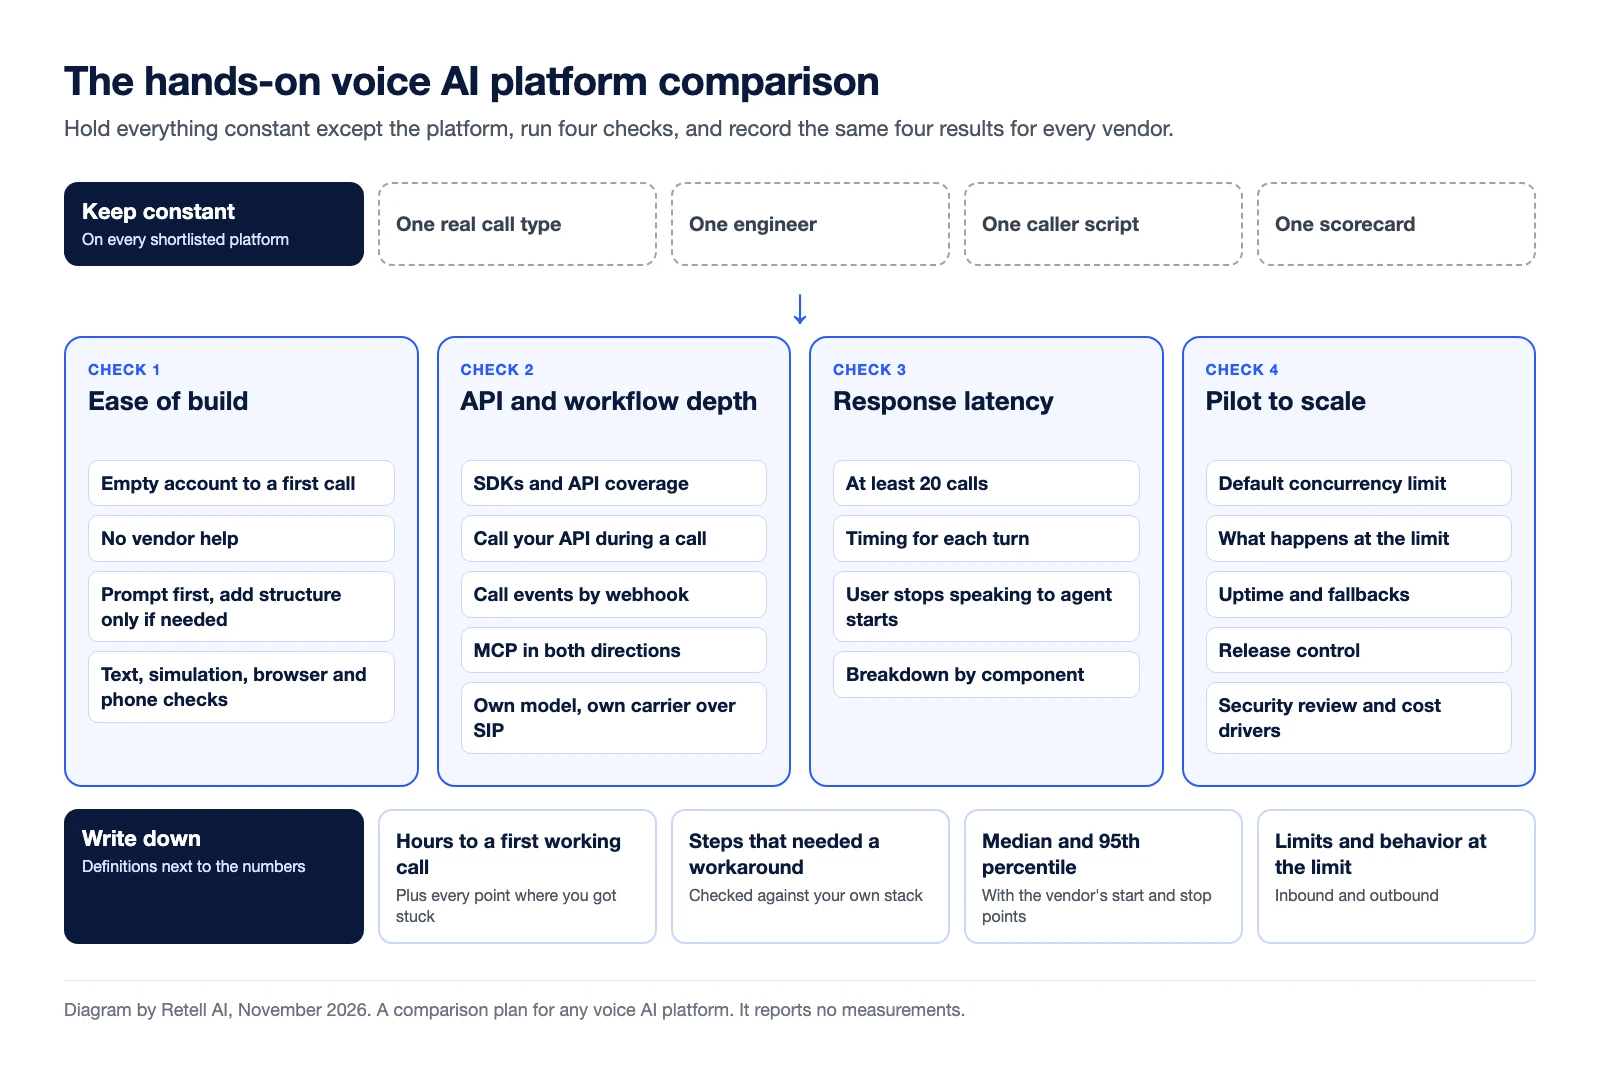
Escribe el guion del interlocutor antes de que nadie empiece a crear. Incluye una interrupción, una corrección, una pregunta que el agente debería rechazar y una solicitud que necesite tu API. Después compara los cuatro resultados lado a lado, con las definiciones de cada proveedor junto a sus cifras.
Alguien tiene que responsabilizarse del agente una vez tomada la decisión. Muchos equipos asignan esa tarea a un ingeniero de CX, también llamado ingeniero de automatización de CX o ingeniero desplegado interno: el responsable interno que detecta las llamadas mal gestionadas, crea correcciones, las comprueba y las despliega. Si ya tienes a esa persona, inclúyela en la comparación. Lo que el patrocinador ejecutivo necesita de la plataforma y del proveedor se trata en qué necesitan los líderes de CX de los agentes de voz con IA.
Preguntas frecuentes
¿Qué debería buscar un equipo de producto en una plataforma de IA de voz?
Cuatro cosas, todas comprobadas en la práctica: lo rápido que tu propio ingeniero puede crear un primer agente funcional, hasta dónde llegan la API, los webhooks y las herramientas de flujos de trabajo, cuánto esperan los interlocutores una respuesta en tus propias llamadas y cómo son los límites y el comportamiento ante fallos con volumen de producción. Haz las mismas comprobaciones en cada plataforma preseleccionada.
¿Cómo se comparan plataformas de IA de voz en la práctica?
Elige un tipo de llamada real, asigna a un ingeniero la misma creación en cada plataforma y haz las mismas llamadas con guion en cada una. Registra las horas hasta la primera llamada funcional, los pasos que necesitaron una solución alternativa, la mediana y el percentil 95 del tiempo de respuesta y los límites por defecto. Mantén las definiciones de cada proveedor junto a sus cifras.
¿Cuál es una buena latencia de respuesta para un agente de voz con IA?
Depende del modelo, el prompt y la configuración, así que mídela en tus propias llamadas. La documentación de Retell indica latencias de tan solo 600 ms, medidas desde que el usuario deja de hablar hasta que el agente empieza a responder, y aconseja mantener la latencia estimada por debajo de 1,5 segundos. Compara percentiles entre proveedores solo cuando coincidan los puntos de inicio y fin.
¿Necesitas ingenieros para crear un agente de voz con IA?
No para un primer agente. La guía de inicio rápido de Retell lleva de una plantilla a una llamada telefónica desde el panel. Los ingenieros entran en juego cuando el agente tiene que llamar a tu API durante una llamada, enviar eventos de llamada a tus sistemas o conectarse a tu propio operador telefónico por SIP. Esas son las partes que un equipo de producto debería crear durante la comparación.
¿Cuántas llamadas simultáneas puede gestionar una plataforma de IA de voz?
Depende del plan y del proveedor. En Retell, un espacio de trabajo de pago por uso tiene 20 llamadas simultáneas por defecto, y el límite se puede ampliar desde el panel. Pregunta a cada proveedor qué ocurre con una llamada entrante y con una saliente una vez alcanzado el límite.
Haz las cuatro comprobaciones en tus propias llamadas
Retell es una plataforma de agentes de voz con IA para centros de contacto, con agentes de prompt único y de flujo de conversación, SDK tipados, funciones personalizadas, webhooks, MCP, telefonía personalizada y datos de latencia por llamada. Más de 4.000 clientes realizan más de 100 millones de llamadas al mes con Retell, que alcanzó 100 M$ de ingresos anualizados en noviembre de 2026. Los precios se basan en el uso, desde 0,07 $ por minuto según la página de precios. Crea el mismo agente que creaste en otras plataformas, ejecútalo en tus propias llamadas y compara las cifras antes de firmar nada.
Descubre cuánto podría ahorrar tu empresa al pasar a agentes de voz impulsados por IA.
Resultado del ROI
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Estimate your monthly voice AI cost
Read Other Blogs
Revoluciona tu operación de llamadas con Retell


