Migliori API di IA speech-to-speech in tempo reale per le telefonate (2026)



I migliori servizi di IA speech-to-speech in tempo reale per le telefonate nel 2026 sono Retell AI, OpenAI Realtime API, OpenAI GPT-Live-1, Google Gemini Live API, Amazon Nova 2.5 Sonic, Deepgram Voice Agent API e AssemblyAI Voice Agent API.
Retell è la scelta giusta quando si tratta di telefonate in produzione, perché integra un modello speech-to-speech con la telefonia, i trasferimenti e i test di cui una linea telefonica ha bisogno. Le altre sei sono API di modelli o di pipeline. Ti offrono il ciclo vocale e lasciano a te gran parte del sistema telefonico, il passaggio a un operatore umano e il QA.
Retell AI pubblica questa lista ed è una delle opzioni a confronto. Prezzi e funzionalità dei concorrenti provengono dalle pagine pubbliche di prezzi, modelli o documentazione di ciascun fornitore, consultate il 22 ottobre 2026, e sono linkati dove citati.
Come abbiamo scelto e confrontato le opzioni. Abbiamo incluso ogni API che accetta audio dal vivo, restituisce voce in tempo reale e che un team potrebbe collegare a un numero di telefono: modelli speech-to-speech nativi di OpenAI, Google e Amazon, due API per agenti vocali integrate di Deepgram e AssemblyAI, e Retell come livello di piattaforma. Le abbiamo confrontate secondo cinque criteri (indicati sotto) usando solo informazioni pubblicate dai fornitori. Non abbiamo effettuato chiamate di prova né test di latenza, quindi l'articolo non riporta punteggi né dati di latenza.
In breve
- Modelli speech-to-speech nativi: OpenAI gpt-realtime-2.1, OpenAI GPT-Live-1, Gemini 3.8 Live e Amazon Nova 2.5 Sonic ricevono audio in ingresso e restituiscono audio in uscita con un unico modello.
- API per agenti vocali integrate: Deepgram e AssemblyAI eseguono speech-to-text, un LLM e text-to-speech dietro un unico WebSocket e un'unica tariffa al minuto.
- Costi audio al minuto pubblicati più bassi: Gemini 3.8 Live, a $0,005 al minuto in ingresso e $0,018 al minuto in uscita, che Google converte da $3 e $12 per 1M di token audio.
- Tariffe fisse al minuto: GPT-Live-1 a $0,05 al minuto per il livello vocale (modello di backend fatturato a parte), Deepgram da $0,075 al minuto e AssemblyAI a $0,075 al minuto tutto incluso.
- SIP diretto: OpenAI accetta chiamate SIP sia sulla Realtime API sia sulle sessioni Live, e AssemblyAI riceve SIP tramite il tuo account Twilio. Per Gemini Live, la documentazione di Google rimanda a integrazioni di partner come LiveKit e Pipecat.
- Agenti telefonici in produzione: Retell esegue i modelli realtime di OpenAI, Grok Voice o una pipeline LLM standard, e aggiunge trasferimento assistito, navigazione IVR, test di simulazione e analisi post-chiamata.
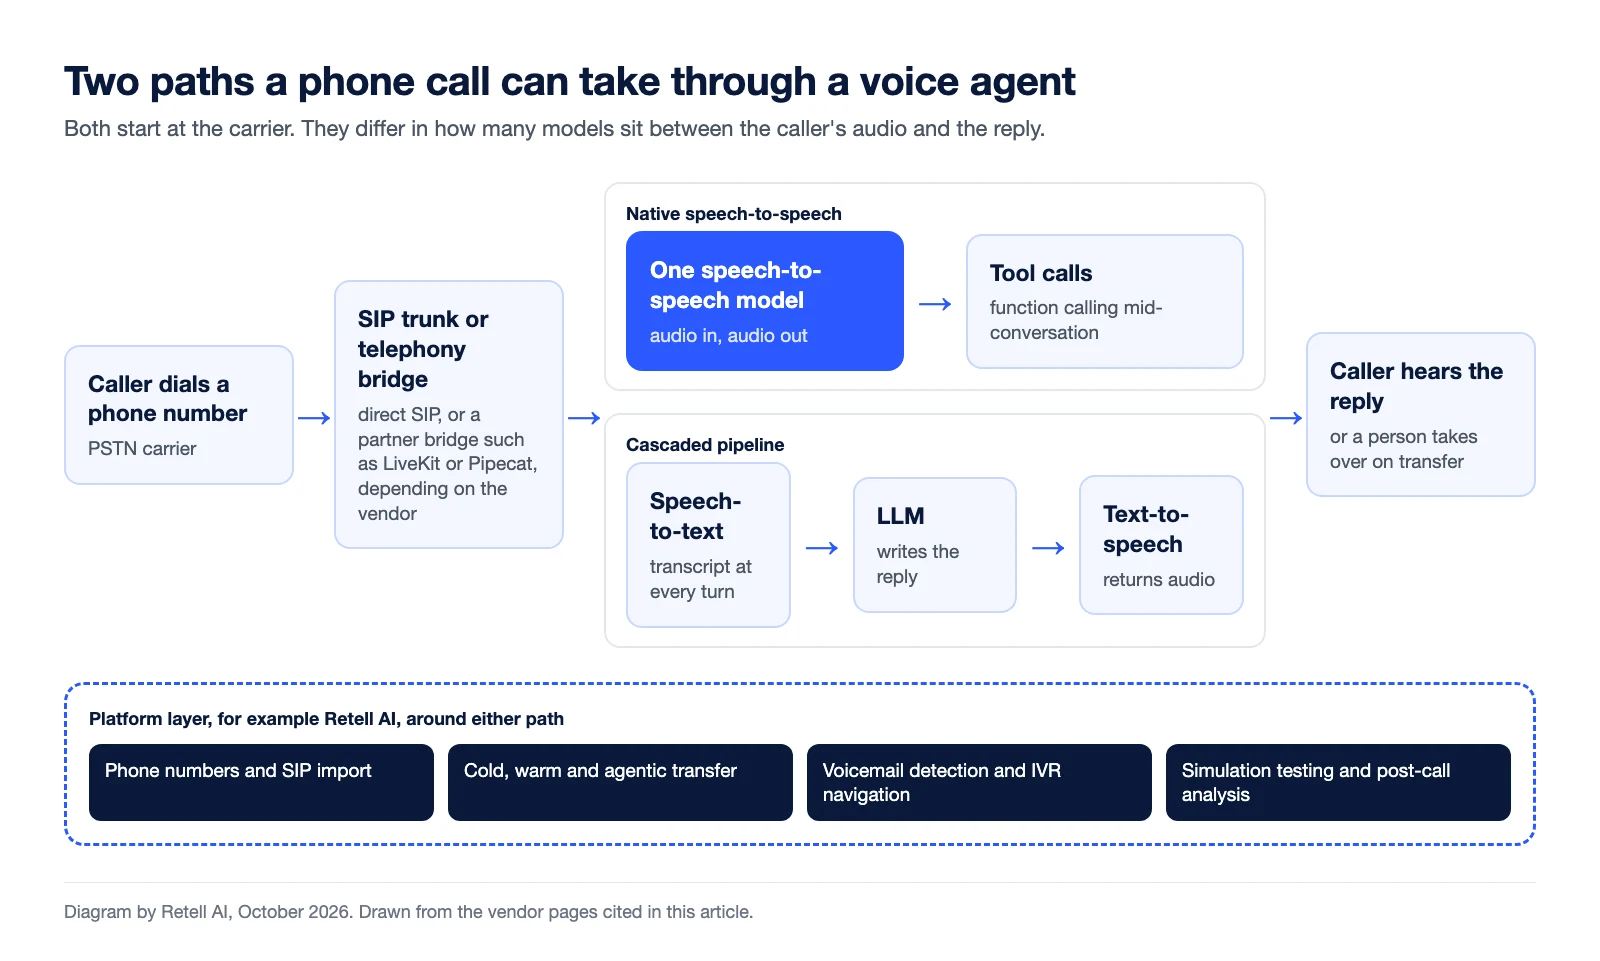
Come si confrontano le 7 API?
La distinzione che conta è se stai acquistando un modello o un agente telefonico. La tabella mostra cos'è ciascuna opzione, come le arriva una telefonata e il prezzo pubblicato al 22 ottobre 2026.
| API | Cos'è | Come arriva la telefonata | Prezzo pubblicato | Ideale per |
|---|---|---|---|---|
| Retell AI | Piattaforma per agenti telefonici che esegue i modelli realtime di OpenAI, Grok Voice o una pipeline LLM standard | Integrata: acquista numeri USA o Canada, oppure importa i tuoi tramite SIP, Twilio o Vonage | Da $0,07 al minuto, vedi prezzi di Retell | Agenti telefonici in produzione per chiamate in entrata e in uscita |
| OpenAI Realtime API | Modello speech-to-speech nativo (gpt-realtime-2.1) con ragionamento configurabile e function calling | SIP trunk indirizzato all'endpoint SIP di OpenAI | $32 per 1M di token audio in ingresso, $64 in uscita | Team che costruiscono il proprio stack sul ragionamento GPT |
| OpenAI GPT-Live-1 | Modello vocale full-duplex che delega il ragionamento a un modello di backend | SIP in entrata e in uscita sulle sessioni Live (le chiamate in uscita devono essere abilitate per la tua organizzazione) | $0,05 al minuto, più l'uso del modello di backend | Alternanza dei turni naturale con un modello di ragionamento separato |
| Gemini Live API | Modelli audio-to-audio nativi (Gemini 3.8 Live, Gemini 3.8 Live Extended Thinking) | Integrazioni di partner come LiveKit e Pipecat; nessun percorso SIP nelle pagine consultate | $0,005 al minuto per l'audio in ingresso, $0,018 in uscita | Basso costo audio pubblicato, grounding con Google Search |
| Amazon Nova 2.5 Sonic | Modello speech-to-speech nativo su Amazon Bedrock | Non trattato nell'annuncio di AWS | Uguale a Nova 2 Sonic, secondo AWS | Team già su AWS Bedrock |
| Deepgram Voice Agent API | STT, LLM e TTS a cascata dietro un unico WebSocket | Guide di telefonia per Twilio e Plivo; la connessione la gestisci tu | $0,075 al minuto Standard, pagamento a consumo | Team che vogliono la voce di Deepgram con la possibilità di usare il proprio LLM |
| AssemblyAI Voice Agent API | STT, LLM e TTS a cascata dietro un unico WebSocket | SIP tramite il tuo account Twilio | $4,50 l'ora ($0,075 al minuto), tutto incluso | Chiamate in cui la precisione è critica, a tariffa fissa |
Come abbiamo confrontato ciascuna API
Abbiamo esaminato cinque aspetti che una telefonata mette in luce e che una demo nel browser nasconde:
- Percorso telefonico. Una chiamata PSTN può raggiungere il modello senza che tu debba gestire un media server?
- Alternanza dei turni in condizioni reali. Il fornitore documenta la gestione delle interruzioni nelle chiamate dal vivo?
- Chiamate agli strumenti durante il parlato. L'agente può cercare un ordine mentre continua a parlare?
- Passaggio a un operatore umano. Il trasferimento assistito è integrato o devi scriverlo tu?
- Costi prevedibili. La fatturazione è al minuto o a token, e cosa resta fuori dal contatore?
Le dichiarazioni dei fornitori sulla latenza sono misurate in modi diversi e non sono confrontabili, quindi qui non compaiono.
Retell AI
Retell AI è la scelta migliore quando un modello speech-to-speech deve reggere vere telefonate, perché gestisce tutto ciò che sta intorno al modello: numeri, passaggio a un operatore, segreteria e test.
L'API di Retell elenca opzioni speech-to-speech tra cui la famiglia gpt-realtime di OpenAI (gpt-realtime-2.1, gpt-realtime-2 e altri) e Grok Voice 3.0, come una delle scelte tra i modelli supportati. Puoi anche eseguire un agente su una pipeline standard con l'LLM che preferisci, mantenendo in ogni caso la stessa telefonia, gli stessi trasferimenti e gli stessi test. Consulta le opzioni dei modelli nel riferimento API.
Come prova sulle chiamate difficili, Cekura ha eseguito un benchmark di 414 chiamate su sei piattaforme vocali (Retell, ElevenLabs, Pipecat, LiveKit, Synthflow e Vapi) su un flusso di lavoro Medicare regolamentato. Retell ha superato 22 valutatori su 23 ed è risultata prima con il 95,7% di accuratezza del flusso di lavoro, contando solo i controlli superati in tutte e tre le esecuzioni. I casi difficili includevano un chiamante che interrompe l'informativa e chiede dettagli sul piano, un familiare che chiama per conto di un beneficiario e un chiamante che chiede all'agente di promettere che un piano copre il suo farmaco. Si tratta di un benchmark di piattaforme su un solo flusso di lavoro, non di un confronto tra modelli speech-to-speech.
Cosa ottieni oltre al modello:
- Telefonia: acquista numeri USA o Canada dalla dashboard, oppure importa i tuoi tramite SIP trunking, inclusi Twilio e Vonage.
- Passaggio a un operatore: trasferimento di chiamata a freddo, assistito e agentico verso una persona, con un briefing contestuale nei trasferimenti assistiti.
- Telefonia in uscita: rilevamento della segreteria e navigazione IVR nei menu telefonici di altre aziende.
- Test e QA: test di simulazione prima del lancio, poi analisi post-chiamata e controllo qualità con IA sulle chiamate in produzione.
Prezzi: da $0,07 al minuto sulla pagina dei prezzi di Retell.
Attenzione a: Retell è una piattaforma, non un endpoint di modello grezzo. Se vuoi controllare tu ogni frame della pipeline audio, parti piuttosto da un'API di modello.
OpenAI Realtime API (gpt-realtime-2.1)
OpenAI Realtime API è la scelta per i team che vogliono un modello speech-to-speech grezzo con ragionamento GPT e che costruiranno da soli il resto dello stack telefonico.
gpt-realtime-2.1 riceve audio in ingresso e restituisce audio in uscita, supporta un livello di ragionamento configurabile e il function calling, e aggiorna gpt-realtime-2 con un migliore riconoscimento alfanumerico, una migliore gestione di silenzi e rumore e un comportamento migliore nelle interruzioni. OpenAI indica gli stessi prezzi per entrambi i modelli.
Risponde anche a una telefonata senza un bridge separato. Secondo la guida SIP di OpenAI, indirizzi un SIP trunk all'endpoint SIP di OpenAI, accetti o rifiuti ogni chiamata tramite il suo call ID e puoi trasferirla con un SIP REFER.
Prezzi: $32 per 1M di token audio in ingresso e $64 per 1M di token audio in uscita, più $4 e $24 per 1M di token di testo. Un livello di ragionamento più alto può aumentare la latenza e l'uso di token in uscita.
Attenzione a: la fatturazione a token cresce con la durata della conversazione perché il contesto si accumula. Registrazione, QA, nuovi tentativi e logica di escalation verso un operatore umano restano da costruire a te.
OpenAI GPT-Live-1
GPT-Live-1 è la soluzione ideale quando un'alternanza dei turni naturale conta più dell'avere il ragionamento all'interno del modello vocale. È un modello full-duplex che ascolta e parla contemporaneamente, e delega il ragionamento e l'uso degli strumenti a un agente di backend. La nostra guida a GPT-Live-1 mostra come funziona questa suddivisione su un agente telefonico.
Funziona sull'endpoint delle sessioni Live di OpenAI, non sull'endpoint Realtime, quindi non è un sostituto diretto di gpt-realtime-2.1. Secondo la guida voce e SIP di OpenAI, le chiamate in entrata arrivano tramite SIP e le chiamate SIP in uscita sono disponibili tramite la Live API una volta abilitate per la tua organizzazione. Lo squillo è limitato a 3 minuti e una chiamata connessa a 2 ore.
Prezzi: $0,05 per minuto di sessione, fatturati al secondo, con l'uso del modello di backend e degli strumenti fatturato a parte.
Attenzione a: la concorrenza è limitata in base al piano, con 50 sessioni su Build, 300 su Launch e 500 su Grow, e il SIP in entrata richiede che il supporto SIP di GPT-Live sia abilitato per il tuo progetto.
Google Gemini Live API
Gemini Live API ha i costi audio al minuto più bassi tra i prezzi pubblicati. Gemini 3.8 Live e Gemini 3.8 Live Extended Thinking sono disponibili a livello generale dal 15 settembre 2026, ed entrambi indicano $0,005 al minuto per l'audio in ingresso e $0,018 al minuto per l'audio in uscita sulla pagina dei prezzi di Google. Questi valori al minuto sono affiancati a $3 e $12 per 1M di token audio, quindi sono una conversione, non un contatore separato.
Il modello Extended Thinking supporta il ragionamento in background durante la chiamata, e il grounding con Google Search è supportato nel piano a pagamento, con 5.000 richieste di ricerca gratuite al mese e poi $14 ogni 1.000.
Attenzione a: la guida alla Live API di Google elenca integrazioni di partner come LiveKit e Pipecat e non descrive alcun percorso tramite SIP trunk, quindi prevedi un bridge davanti alla Live API. Il prezzo in uscita include i token di ragionamento, quindi il valore al minuto è un minimo.
Amazon Nova 2.5 Sonic
Amazon Nova 2.5 Sonic è la scelta predefinita per i team che già sviluppano su AWS Bedrock. AWS l'ha reso disponibile a livello generale il 5 ottobre 2026, con ragionamento, rispetto delle istruzioni e precisione nelle chiamate agli strumenti migliorati, latenza inferiore, voci espressive in sette lingue, alternanza dei turni controllabile, chiamate asincrone agli strumenti e una finestra di contesto di 256K.
Il framework Strands Bidi Agents di AWS, ora disponibile a livello generale, è la sua soluzione per creare un agente vocale con poche righe di codice.
Prezzi: AWS indica per Nova 2.5 Sonic lo stesso prezzo di Nova 2 Sonic. Consulta la pagina dei prezzi di Amazon Nova per le tariffe attuali per token, che vengono caricate dinamicamente.
Attenzione a: è disponibile in quattro regioni Bedrock (N. Virginia, Oregon, Stoccolma, Tokyo), e sette lingue sono meno di quelle offerte da alcune altre opzioni qui. L'annuncio non descrive un percorso telefonico, quindi verifica come le chiamate raggiungono il modello prima di impegnarti.
Deepgram Voice Agent API
Deepgram Voice Agent API è la scelta per i team che vogliono il riconoscimento vocale di Deepgram con la possibilità di usare il proprio LLM o la propria voce. Esegue speech-to-text, un LLM e text-to-speech dietro un unico WebSocket e un unico contatore al minuto, e la documentazione di Deepgram include guide per agenti telefonici in entrata e in uscita per Twilio e Plivo.
Prezzi: $0,075 al minuto sul piano Standard a pagamento a consumo e $0,163 su Advanced, con tariffe più basse se usi il tuo LLM o TTS.
Attenzione a: è una pipeline a cascata, non un modello speech-to-speech nativo. Gli account a pagamento a consumo sono limitati a 45 connessioni Voice Agent simultanee (60 su Growth), un limite che si fa sentire la prima volta che una campagna avvia chiamate in uscita.
AssemblyAI Voice Agent API
AssemblyAI Voice Agent API è la scelta quando la precisione della trascrizione determina se l'agente funziona, ad esempio su nomi, numeri di conto e indirizzi. Esegue il modello vocale Universal-3.6 Pro Realtime di AssemblyAI, un LLM e TTS dietro un unico WebSocket.
Prezzi: una tariffa fissa di $4,50 l'ora ($0,075 al minuto) che copre speech-to-text, LLM e TTS, fatturata per minuto di sessione, secondo il riferimento prezzi di AssemblyAI. Per le telefonate, la documentazione di AssemblyAI indica che Twilio inoltra le chiamate ad AssemblyAI tramite SIP, quindi non c'è alcun media server o webhook da gestire. Il SIP trunk e il numero restano nel tuo account Twilio.
Attenzione a: come Deepgram è a cascata, non audio-to-audio nativo, quindi ottieni una trascrizione a ogni turno ma non un modello che percepisce direttamente il tono.
Meglio un modello speech-to-speech nativo o una pipeline a cascata?
Usa un modello speech-to-speech nativo quando il tono e la rapidità nell'alternanza dei turni contano più del controllo su ogni passaggio, e una pipeline a cascata quando devi vedere e correggere ciò che l'agente ha sentito. Un modello nativo riceve audio e restituisce audio, senza un passaggio di trascrizione separato. Una pipeline a cascata ti fornisce una trascrizione a ogni turno, il che rende più facile correggere un numero di conto errato o far rispettare uno script di conformità.
In entrambi i casi, una linea telefonica aggiunge lavoro che il modello non fa: gestione delle interruzioni, recupero dei trasferimenti e test su chiamate che escono dal copione. Per approfondire le differenze tra i due approcci, leggi come funziona l'IA vocale in tempo reale. Se stai scegliendo il modello di ragionamento dietro un agente a cascata, consulta i migliori LLM per agenti vocali con IA e i migliori modelli speech-to-text.
Come scegliere l'API giusta per le tue chiamate?
Parti da dove arriva la chiamata e da chi è responsabile in caso di errore. Quattro domande chiariscono tutto:
- Le chiamate arrivano dalla rete telefonica? Se sì, escludi tutto ciò che richiede un bridge che non vuoi gestire, oppure scegli una piattaforma che includa la telefonia. La nostra guida a SIP trunking e telefonia moderna copre il lato operatore.
- Cosa succede quando l'agente non sa rispondere? Se una persona deve subentrare con il contesto, ti serve il trasferimento assistito, non solo un endpoint che riaggancia.
- Riesci a prevedere la spesa? I prezzi al minuto (GPT-Live-1, Deepgram, AssemblyAI) sono più facili da mettere a budget rispetto ai prezzi a token, dove le chiamate lunghe costano di più al minuto.
- Chi sistema una chiamata non riuscita? Se sarà il tuo team operativo, e non i tuoi ingegneri, a ottimizzare prompt e flussi, scegli una piattaforma con test e versioning integrati.
Domande frequenti
Cos'è un'API di IA speech-to-speech?
Un'API di IA speech-to-speech riceve l'audio di chi chiama e restituisce audio parlato da un unico modello, senza passaggi separati di trascrizione e sintesi vocale. OpenAI gpt-realtime-2.1, GPT-Live-1, Gemini 3.8 Live e Amazon Nova 2.5 Sonic funzionano in questo modo.
Qual è l'API speech-to-speech più economica per le telefonate?
Gemini 3.8 Live indica i costi audio al minuto più bassi, $0,005 al minuto per l'audio in ingresso e $0,018 al minuto per l'audio in uscita, convertiti da Google a partire da $3 e $12 per 1M di token audio. Al costo reale si aggiungono la telefonia, l'eventuale bridge che gestisci e i token di ragionamento, fatturati come output. AWS indica per Nova 2.5 Sonic lo stesso prezzo di Nova 2 Sonic, e OpenAI fattura la Realtime API a token, quindi fai il confronto sulla durata delle tue chiamate.
Posso collegare OpenAI Realtime API a un numero di telefono?
Sì. Indirizza un SIP trunk di un operatore come Twilio all'endpoint SIP di OpenAI, poi accetta ogni chiamata tramite il suo call ID. I trasferimenti usano un SIP REFER.
Retell supporta i modelli speech-to-speech?
Sì. L'API di Retell elenca opzioni speech-to-speech tra cui la famiglia gpt-realtime di OpenAI e Grok Voice 3.0, e un agente Retell può in alternativa funzionare su una pipeline standard con l'LLM che scegli. Le funzionalità di telefonia e trasferimento sono le stesse in entrambi i casi.
Cosa succede quando l'agente IA non sa rispondere?
Con un'API di modello, la logica di escalation la scrivi tu. Con Retell, l'agente può effettuare un trasferimento di chiamata a freddo, assistito o agentico verso una persona, e il trasferimento assistito passa un briefing contestuale così chi chiama non deve ripetersi.
Posso mantenere il mio numero di telefono attuale?
Con Retell, sì: puoi importare un numero esistente tramite SIP trunking invece di acquistarne uno nuovo. Con le API di modello, dipende dal SIP trunk o dal bridge che gestisci.
Provalo sulle tue chiamate
Uno script demo non ti farà distinguere queste API; le tue chiamate sì. Crea gratis un agente Retell, scegli un modello speech-to-speech o standard e mettilo alla prova con le chiamate che il tuo team trova più difficili.
See how much your business could save by switching to AI-powered voice agents.
ROI Result
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Un numero di telefono demo di Retell Clinic Office
What results look like with Retell AI


Estimate your monthly voice AI cost

Rivoluziona le tue operazioni di chiamata con Retell


