Beste realtime speech-to-speech AI-API's voor telefoongesprekken (2026)



De beste realtime speech-to-speech AI-diensten voor telefoongesprekken in 2026 zijn Retell AI, de OpenAI Realtime API, OpenAI GPT-Live-1, de Google Gemini Live API, Amazon Nova 2.5 Sonic, de Deepgram Voice Agent API en de AssemblyAI Voice Agent API.
Retell is de beste keuze als het om telefoongesprekken in productie gaat, omdat het een speech-to-speech-model omringt met de telefonie, doorverbindingen en tests die een telefoonlijn nodig heeft. De andere zes zijn model- of pipeline-API's. Ze leveren je de spraaklus en laten het grootste deel van het telefoonsysteem, de overdracht aan een mens en de QA aan jou over.
Retell AI publiceert deze lijst en is een van de vergeleken opties. Prijzen en functies van concurrenten komen van de openbare prijs-, model- of documentatiepagina van elke leverancier, geraadpleegd op 22 oktober 2026, en zijn gelinkt waar ze worden aangehaald.
Hoe we de opties hebben gekozen en vergeleken. We hebben elke API opgenomen die live audio accepteert, in realtime spraak teruggeeft en die een team achter een telefoonnummer kan zetten: native speech-to-speech-modellen van OpenAI, Google en Amazon, twee gebundelde stemagent-API's van Deepgram en AssemblyAI, en Retell als platformlaag. We hebben ze vergeleken op vijf criteria (zie hieronder) en daarbij alleen informatie gebruikt die de leveranciers zelf publiceren. We hebben geen testgesprekken gevoerd en geen latencytest gedaan, dus dit artikel bevat geen scores en geen latencycijfers.
Samengevat
- Native speech-to-speech-modellen: OpenAI gpt-realtime-2.1, OpenAI GPT-Live-1, Gemini 3.8 Live en Amazon Nova 2.5 Sonic nemen audio op en geven audio terug in één model.
- Gebundelde stemagent-API's: Deepgram en AssemblyAI draaien speech-to-text, een LLM en text-to-speech achter één WebSocket en één tarief per minuut.
- Laagste gepubliceerde audiocijfers per minuut: Gemini 3.8 Live, met $0,005 per minuut voor invoer en $0,018 per minuut voor uitvoer, door Google omgerekend van $3 en $12 per 1 miljoen audiotokens.
- Vaste tarieven per minuut: GPT-Live-1 voor $0,05 per minuut voor de spraaklaag (backendmodel apart gefactureerd), Deepgram vanaf $0,075 per minuut en AssemblyAI voor $0,075 per minuut all-in.
- Directe SIP: OpenAI accepteert SIP-gesprekken op zowel de Realtime API als de Live-sessies, en AssemblyAI ontvangt SIP via je eigen Twilio-account. Voor Gemini Live verwijst de documentatie van Google naar partnerintegraties zoals LiveKit en Pipecat.
- Telefoonagents in productie: Retell draait de realtime modellen van OpenAI, Grok Voice of een standaard LLM-pipeline, en voegt warme doorverbinding, IVR-navigatie, simulatietests en analyse na het gesprek toe.
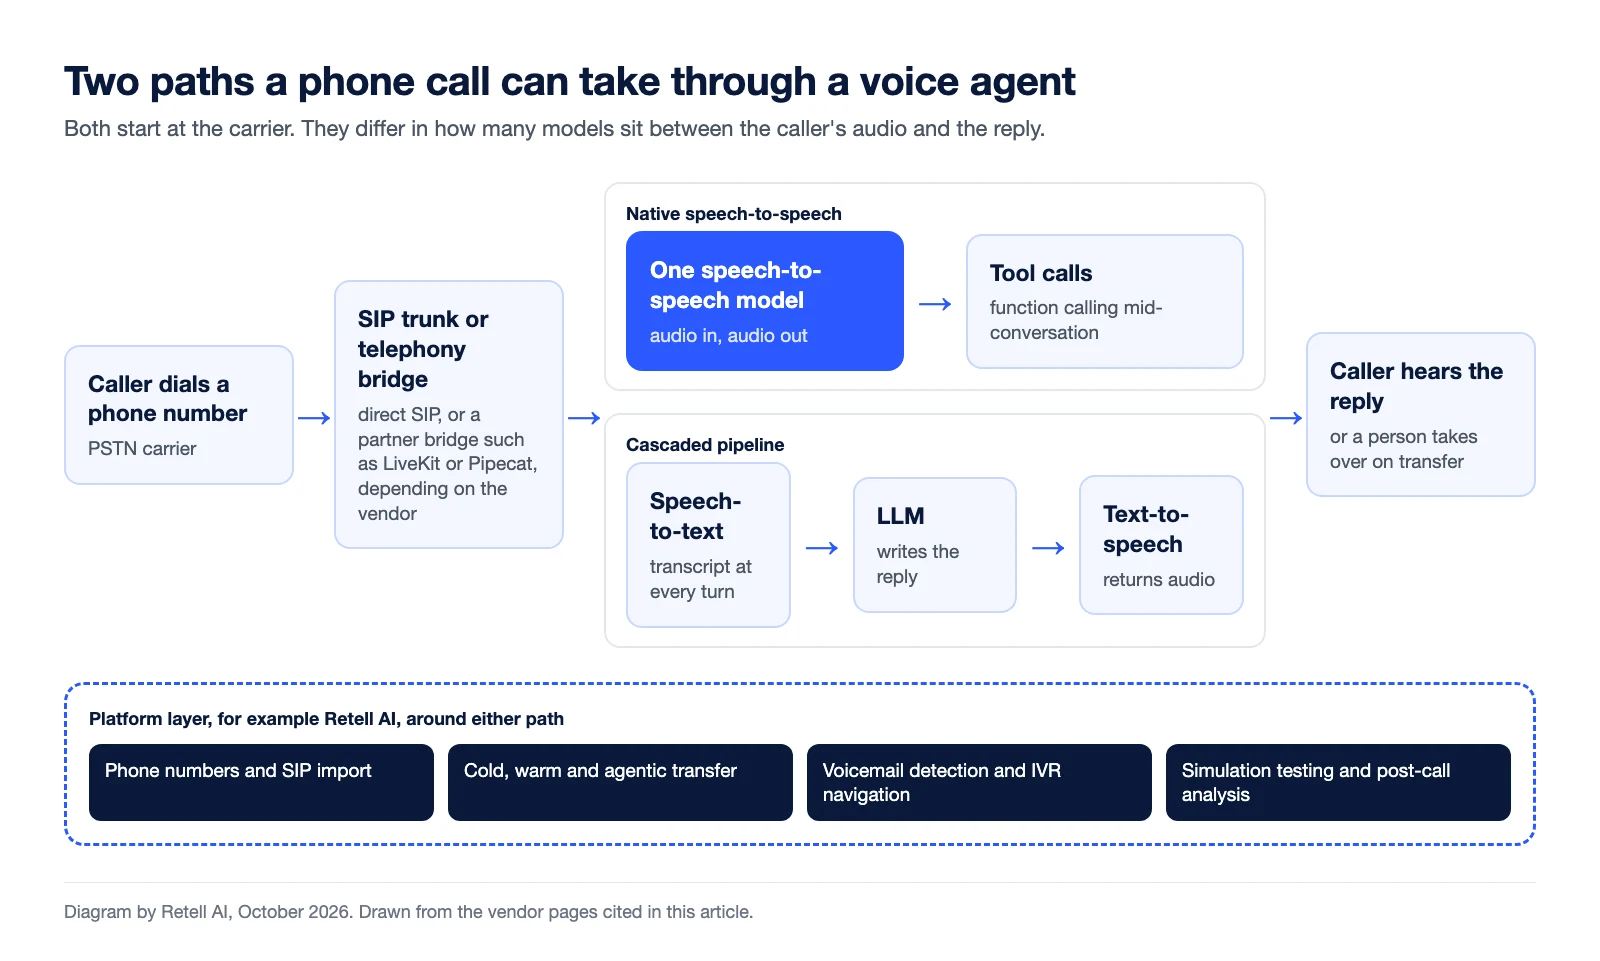
Hoe verhouden de 7 API's zich tot elkaar?
Het onderscheid dat telt, is of je een model koopt of een telefoonagent. De tabel laat zien wat elke optie is, hoe een telefoongesprek haar bereikt en wat de gepubliceerde prijs was op 22 oktober 2026.
| API | Wat het is | Hoe een telefoongesprek het bereikt | Gepubliceerde prijs | Het meest geschikt voor |
|---|---|---|---|---|
| Retell AI | Platform voor telefoonagents dat realtime modellen van OpenAI, Grok Voice of een standaard LLM-pipeline draait | Ingebouwd: koop nummers uit de VS of Canada, of importeer je eigen nummers via SIP, Twilio of Vonage | Vanaf $0,07 per minuut, zie prijzen van Retell | Inkomende en uitgaande telefoonagents in productie |
| OpenAI Realtime API | Native speech-to-speech-model (gpt-realtime-2.1) met configureerbare reasoning en function calling | SIP-trunk die naar het SIP-endpoint van OpenAI wijst | $32 per 1 miljoen audiotokens invoer, $64 uitvoer | Teams die hun eigen stack bouwen op GPT-reasoning |
| OpenAI GPT-Live-1 | Full-duplex spraakmodel dat reasoning overdraagt aan een backendmodel | Inkomende en uitgaande SIP op Live-sessies (uitgaand moet voor je organisatie zijn ingeschakeld) | $0,05 per minuut, plus gebruik van het backendmodel | Natuurlijke beurtwisseling met een apart reasoningmodel |
| Gemini Live API | Native audio-naar-audiomodellen (Gemini 3.8 Live, Gemini 3.8 Live Extended Thinking) | Partnerintegraties zoals LiveKit en Pipecat; geen SIP-route op de pagina's die we hebben gelezen | $0,005 per minuut audio-invoer, $0,018 uitvoer | Lage gepubliceerde audiokosten, Google Search-grounding |
| Amazon Nova 2.5 Sonic | Native speech-to-speech-model op Amazon Bedrock | Niet behandeld in de aankondiging van AWS | Gelijk aan Nova 2 Sonic, volgens AWS | Teams die al op AWS Bedrock zitten |
| Deepgram Voice Agent API | STT, LLM en TTS in cascade achter één WebSocket | Telefoniehandleidingen voor Twilio en Plivo; je beheert de verbinding zelf | $0,075 per minuut Standard, betalen naar gebruik | Teams die spraakherkenning van Deepgram willen met optioneel een eigen LLM |
| AssemblyAI Voice Agent API | STT, LLM en TTS in cascade achter één WebSocket | SIP via je eigen Twilio-account | $4,50 per uur ($0,075 per minuut), all-in | Nauwkeurigheidsgevoelige gesprekken tegen een vast tarief |
Hoe we elke API hebben vergeleken
We keken naar vijf dingen die een telefoongesprek blootlegt en een browserdemo verbergt:
- Telefonieroute. Kan een PSTN-gesprek het model bereiken zonder dat je zelf een mediaserver draait?
- Beurtwisseling onder echte omstandigheden. Documenteert de leverancier hoe onderbrekingen bij live gesprekken worden afgehandeld?
- Toolcalls tijdens het spreken. Kan de agent een bestelling opzoeken terwijl hij blijft praten?
- Overdracht aan een mens. Is warme doorverbinding ingebouwd, of moet je die zelf programmeren?
- Kosten die je kunt voorspellen. Wordt er per minuut of per token gefactureerd, en wat valt buiten de meter?
Leveranciers meten hun latencyclaims op verschillende manieren en die zijn niet vergelijkbaar, dus die staan hier niet.
Retell AI
Retell AI is de beste keuze wanneer een speech-to-speech-model echte telefoongesprekken moet doorstaan, omdat het alles rond het model afhandelt: nummers, overdracht, voicemail en tests.
De API van Retell biedt speech-to-speech-opties, waaronder de gpt-realtime-familie van OpenAI (gpt-realtime-2.1, gpt-realtime-2 en andere) en Grok Voice 3.0, als één keuze tussen de ondersteunde modellen. Je kunt een agent ook draaien op een standaard pipeline met de LLM van je keuze, en in beide gevallen dezelfde telefonie, doorverbindingen en tests behouden. Bekijk de modelopties in de API-referentie.
Als bewijs voor lastige gesprekken voerde Cekura een benchmark van 414 gesprekken uit met zes stemplatforms (Retell, ElevenLabs, Pipecat, LiveKit, Synthflow en Vapi) op één gereguleerde Medicare-workflow. Retell slaagde voor 22 van de 23 evaluatoren en lag op kop met 95,7% workflownauwkeurigheid, waarbij alleen controles telden die in alle drie de runs slaagden. Tot de lastige gevallen behoorden een beller die de disclosure onderbreekt en plandetails eist, een familielid dat namens een begunstigde belt, en een beller die de agent vraagt te beloven dat een plan zijn medicatie dekt. Het is een platformbenchmark op één workflow, geen vergelijking van speech-to-speech-modellen.
Wat je krijgt bovenop het model:
- Telefonie: koop nummers uit de VS of Canada in het dashboard, of importeer je eigen nummers via SIP-trunking, onder meer via Twilio en Vonage.
- Overdracht: koude, warme en agentische gespreksoverdracht naar een persoon, met een contextuele briefing bij warme doorverbindingen.
- Uitgaande telefonie: voicemaildetectie en IVR-navigatie door de telefoonmenu's van andere bedrijven.
- Tests en QA: simulatietests vóór de lancering, daarna analyse na het gesprek en AI-kwaliteitsborging op gesprekken in productie.
Prijzen: vanaf $0,07 per minuut op de prijzenpagina van Retell.
Let op: Retell is een platform, geen kaal model-endpoint. Wil je elk frame van de audiopipeline zelf in handen hebben, begin dan met een model-API.
OpenAI Realtime API (gpt-realtime-2.1)
De OpenAI Realtime API is de keuze voor teams die een kaal speech-to-speech-model met GPT-reasoning willen en de rest van de telefoniestack zelf bouwen.
gpt-realtime-2.1 neemt audio op en geeft audio terug, ondersteunt configureerbare reasoning-inspanning en function calling, en verbetert gpt-realtime-2 met betere herkenning van alfanumerieke tekens, betere afhandeling van stilte en ruis, en beter gedrag bij onderbrekingen. OpenAI hanteert voor beide modellen dezelfde prijzen.
Het neemt ook een telefoongesprek aan zonder aparte bridge. Volgens de SIP-handleiding van OpenAI laat je een SIP-trunk naar het SIP-endpoint van OpenAI wijzen, accepteer of weiger je elk gesprek met zijn call-ID, en kun je het doorverbinden met een SIP REFER.
Prijzen: $32 per 1 miljoen audio-invoertokens en $64 per 1 miljoen audio-uitvoertokens, plus $4 en $24 per 1 miljoen teksttokens. Een hogere reasoning-inspanning kan de latency en het verbruik van uitvoertokens verhogen.
Let op: tokenfacturering groeit mee met de gespreksduur, omdat de context zich opstapelt. Opname, QA, herhaalpogingen en logica voor escalatie naar een mens moet je zelf bouwen.
OpenAI GPT-Live-1
GPT-Live-1 past het best wanneer natuurlijke beurtwisseling belangrijker is dan reasoning binnen het spraakmodel. Het is een full-duplex model dat tegelijk luistert en spreekt, en reasoning en toolgebruik delegeert aan een backendagent. Onze GPT-Live-1-handleiding laat zien hoe die verdeling werkt bij een telefoonagent.
Het draait op het Live-sessies-endpoint van OpenAI, niet op het Realtime-endpoint, dus je kunt het niet zomaar inwisselen voor gpt-realtime-2.1. Volgens de voice- en SIP-handleiding van OpenAI komen inkomende gesprekken binnen via SIP en is uitgaand bellen via SIP beschikbaar via de Live API zodra dat voor je organisatie is ingeschakeld. Overgaan is beperkt tot 3 minuten en een verbonden gesprek tot 2 uur.
Prijzen: $0,05 per sessieminuut, per seconde gefactureerd, met gebruik van het backendmodel en tools apart gefactureerd.
Let op: het aantal gelijktijdige sessies is per tier begrensd, op 50 sessies bij Build, 300 bij Launch en 500 bij Grow, en voor inkomende SIP moet GPT-Live SIP-ondersteuning voor je project zijn ingeschakeld.
Google Gemini Live API
De Gemini Live API heeft op basis van gepubliceerde prijzen de laagste audiocijfers per minuut. Gemini 3.8 Live en Gemini 3.8 Live Extended Thinking werden op 15 september 2026 algemeen beschikbaar, en voor beide staat $0,005 per minuut voor audio-invoer en $0,018 per minuut voor audio-uitvoer op de prijzenpagina van Google. Die bedragen per minuut staan naast $3 en $12 per 1 miljoen audiotokens, dus het is een omrekening, geen aparte meter.
Het Extended Thinking-model ondersteunt reasoning op de achtergrond tijdens het gesprek, en Google Search-grounding wordt ondersteund in de betaalde tier, met 5.000 gratis zoekopdrachten per maand en daarna $14 per 1.000.
Let op: de Live API-handleiding van Google noemt partnerintegraties zoals LiveKit en Pipecat en beschrijft geen SIP-trunkroute, dus reken op een bridge vóór de Live API. De uitvoerprijs omvat thinking-tokens, dus het bedrag per minuut is een ondergrens.
Amazon Nova 2.5 Sonic
Amazon Nova 2.5 Sonic is de standaardkeuze voor teams die al op AWS Bedrock bouwen. AWS maakte het op 5 oktober 2026 algemeen beschikbaar, met verbeterde reasoning, betere opvolging van instructies en nauwkeurigere toolcalls, lagere latency, expressieve stemmen in zeven talen, regelbare beurtwisseling, asynchrone toolcalls en een contextvenster van 256K.
Het Strands Bidi Agents-framework van AWS, inmiddels algemeen beschikbaar, is de route om in een paar regels code een stemagent te bouwen.
Prijzen: AWS hanteert voor Nova 2.5 Sonic dezelfde prijs als voor Nova 2 Sonic. Bekijk de prijzenpagina van Amazon Nova voor de actuele tarieven per token, die dynamisch worden geladen.
Let op: het is beschikbaar in vier Bedrock-regio's (N. Virginia, Oregon, Stockholm, Tokio), en zeven talen is beperkter dan bij sommige andere opties hier. De aankondiging beschrijft geen telefonieroute, dus controleer hoe gesprekken het model bereiken voordat je je vastlegt.
Deepgram Voice Agent API
De Voice Agent API van Deepgram is de keuze voor teams die de spraakherkenning van Deepgram willen, met de mogelijkheid om hun eigen LLM of stem mee te brengen. Hij draait speech-to-text, een LLM en text-to-speech achter één WebSocket en één meter per minuut, en de documentatie van Deepgram bevat handleidingen voor inkomende en uitgaande telefonieagents met Twilio en Plivo.
Prijzen: $0,075 per minuut in de Standard-tier met betalen naar gebruik en $0,163 bij Advanced, met lagere tarieven als je je eigen LLM of TTS meebrengt.
Let op: het is een cascadepipeline, geen native speech-to-speech-model. Accounts met betalen naar gebruik zijn beperkt tot 45 gelijktijdige Voice Agent-verbindingen (60 bij Growth), wat er direct toe doet zodra een campagne voor het eerst uitbelt.
AssemblyAI Voice Agent API
De Voice Agent API van AssemblyAI is de keuze wanneer de nauwkeurigheid van de transcriptie bepaalt of de agent werkt, bijvoorbeeld bij namen, rekeningnummers en adressen. Hij draait het Universal-3.6 Pro Realtime-spraakmodel van AssemblyAI, een LLM en TTS achter één WebSocket.
Prijzen: een vast tarief van $4,50 per uur ($0,075 per minuut) voor speech-to-text, de LLM en TTS, gefactureerd per sessieminuut, volgens de prijsreferentie van AssemblyAI. Voor telefoongesprekken staat in de documentatie van AssemblyAI dat Twilio gesprekken via SIP aan AssemblyAI doorgeeft, zodat je geen mediaserver of webhook hoeft te draaien. De SIP-trunk en het nummer staan in je eigen Twilio-account.
Let op: net als Deepgram werkt het in cascade, niet native audio-naar-audio, dus je krijgt bij elke beurt een transcript, maar geen model dat de toon rechtstreeks hoort.
Kies je een native speech-to-speech-model of een cascadepipeline?
Gebruik een native speech-to-speech-model wanneer toon en snelle beurtwisseling belangrijker zijn dan controle over elke stap, en een cascadepipeline wanneer je wilt zien en corrigeren wat de agent heeft gehoord. Een native model neemt audio op en geeft audio terug, zonder aparte transcriptiestap. Een cascadepipeline geeft je bij elke beurt een transcript, waardoor je makkelijker een verkeerd rekeningnummer kunt debuggen of een compliancescript kunt afdwingen.
Hoe dan ook brengt een telefoonlijn werk met zich mee dat het model niet doet: onderbrekingen afhandelen, herstel bij mislukte doorverbindingen en testen tegen gesprekken die van het script afwijken. Lees hoe realtime voice-AI werkt voor meer detail over de verschillen tussen beide ontwerpen. Kies je het reasoningmodel achter een cascade-agent, bekijk dan de beste LLM's voor voice-AI-agents en de beste speech-to-text-modellen.
Hoe kies je de juiste API voor jouw gesprekken?
Begin bij waar het gesprek binnenkomt en wie verantwoordelijk is als het misgaat. Vier vragen geven de doorslag:
- Komen de gesprekken via het telefoonnetwerk binnen? Zo ja, sluit dan alles uit wat een bridge nodig heeft die je niet wilt draaien, of kies een platform met ingebouwde telefonie. Onze handleiding over SIP-trunking en moderne telefonie behandelt de kant van de provider.
- Wat gebeurt er als de agent het antwoord niet weet? Als een persoon het met context moet overnemen, heb je warme doorverbinding nodig, niet alleen een endpoint om op te hangen.
- Kun je de rekening voorspellen? Prijzen per minuut (GPT-Live-1, Deepgram, AssemblyAI) zijn makkelijker te budgetteren dan prijzen per token, waarbij lange gesprekken per minuut meer kosten.
- Wie lost een mislukt gesprek op? Als je operationele team, en niet je engineers, de prompts en flows gaat finetunen, kies dan een platform met ingebouwde tests en versiebeheer.
Veelgestelde vragen
Wat is een speech-to-speech AI-API?
Een speech-to-speech AI-API neemt de audio van een beller op en geeft gesproken audio terug vanuit één model, zonder aparte transcriptie- en spraakstap. OpenAI gpt-realtime-2.1, GPT-Live-1, Gemini 3.8 Live en Amazon Nova 2.5 Sonic werken zo.
Welke speech-to-speech-API is het goedkoopst voor telefoongesprekken?
Gemini 3.8 Live heeft de laagste audiocijfers per minuut, met $0,005 per minuut voor audio-invoer en $0,018 per minuut voor audio-uitvoer, door Google omgerekend van $3 en $12 per 1 miljoen audiotokens. Je werkelijke kosten omvatten daarnaast telefonie, een eventuele bridge die je draait en thinking-tokens, die als uitvoer worden gefactureerd. AWS hanteert voor Nova 2.5 Sonic dezelfde prijs als voor Nova 2 Sonic, en OpenAI factureert de Realtime API per token, dus vergelijk op basis van je eigen gespreksduur.
Kan ik de OpenAI Realtime API koppelen aan een telefoonnummer?
Ja. Laat een SIP-trunk van een provider zoals Twilio naar het SIP-endpoint van OpenAI wijzen en accepteer vervolgens elk gesprek met zijn call-ID. Doorverbindingen gebruiken een SIP REFER.
Ondersteunt Retell speech-to-speech-modellen?
Ja. De API van Retell biedt speech-to-speech-opties, waaronder de gpt-realtime-familie van OpenAI en Grok Voice 3.0, en een Retell-agent kan in plaats daarvan ook op een standaard pipeline draaien met de LLM van je keuze. De telefonie- en doorverbindingsfuncties zijn in beide gevallen hetzelfde.
Wat gebeurt er als de AI-agent geen antwoord heeft?
Bij een model-API schrijf je de escalatielogica zelf. Bij Retell kan de agent een koude, warme of agentische gespreksoverdracht naar een persoon uitvoeren, en bij een warme doorverbinding wordt een contextuele briefing meegegeven, zodat de beller zichzelf niet hoeft te herhalen.
Kan ik mijn bestaande telefoonnummer behouden?
Bij Retell wel: je kunt een bestaand nummer importeren via SIP-trunking in plaats van een nieuw nummer te kopen. Bij de model-API's hangt het af van de SIP-trunk of bridge die je draait.
Probeer het op je eigen gesprekken
Een demoscript laat het verschil tussen deze API's niet zien; je eigen gesprekken wel. Bouw gratis een Retell-agent, kies een speech-to-speech- of standaardmodel en test het op de gesprekken die je team het lastigst vindt.
See how much your business could save by switching to AI-powered voice agents.
ROI Result
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Een demodemonummer van Retell Clinic Office
What results look like with Retell AI


Estimate your monthly voice AI cost
Read Other Blogs

Revolutioneer je belactiviteiten met Retell


