Customer Effort Score (CES)
Hvad Customer Effort Score (CES) måler, spørgsmål og skalaer, hvordan du beregner den, hvad en god score er, og hvordan opkald øger indsatsen.
Customer Effort Score (CES) er et mål for kundeoplevelsen, der måler, hvor let eller svært det var for en kunde at få noget gjort hos en virksomhed, fx at få løst en supportsag. Den indsamles som regel med ét enkelt spørgsmål i en undersøgelse lige efter interaktionen, og resultatet rapporteres som en gennemsnitsscore eller som andelen af kunder, der syntes, det var let.
CES stammer fra forskning hos CEB, et firma, som senere blev opkøbt af Gartner. Det blev introduceret i Harvard Business Review-artiklen Stop Trying to Delight Your Customers af Matthew Dixon, Karen Freeman og Nick Toman (juli 2010), som argumenterede for, at det gør mere for loyaliteten at mindske kundens indsats end at forsøge at begejstre kunderne. Qualtrics henviser til CEB-forskningen i bogen The Effortless Experience og rapporterer, at 96 % af kunderne med en serviceinteraktion, der krævede stor indsats, blev mere illoyale, sammenlignet med 9 % af dem med en interaktion, der krævede lille indsats.
Hvordan beregner man Customer Effort Score?
Der findes to almindelige metoder, og begge tager udgangspunkt i de samme svar fra undersøgelsen.
- Gennemsnitsscore. Læg alle svar sammen, og del med antallet af svar. På en skala fra 1 til 7 bliver resultatet et tal mellem 1 og 7.
- Procentdel, der syntes, det var let. Tæl svarene i den »lette« ende af skalaen, del med antallet af svar, og gang med 100. På en enighedsskala fra 1 til 7 tæller mange teams 5, 6 og 7 med. Nogle tæller kun 6 og 7.
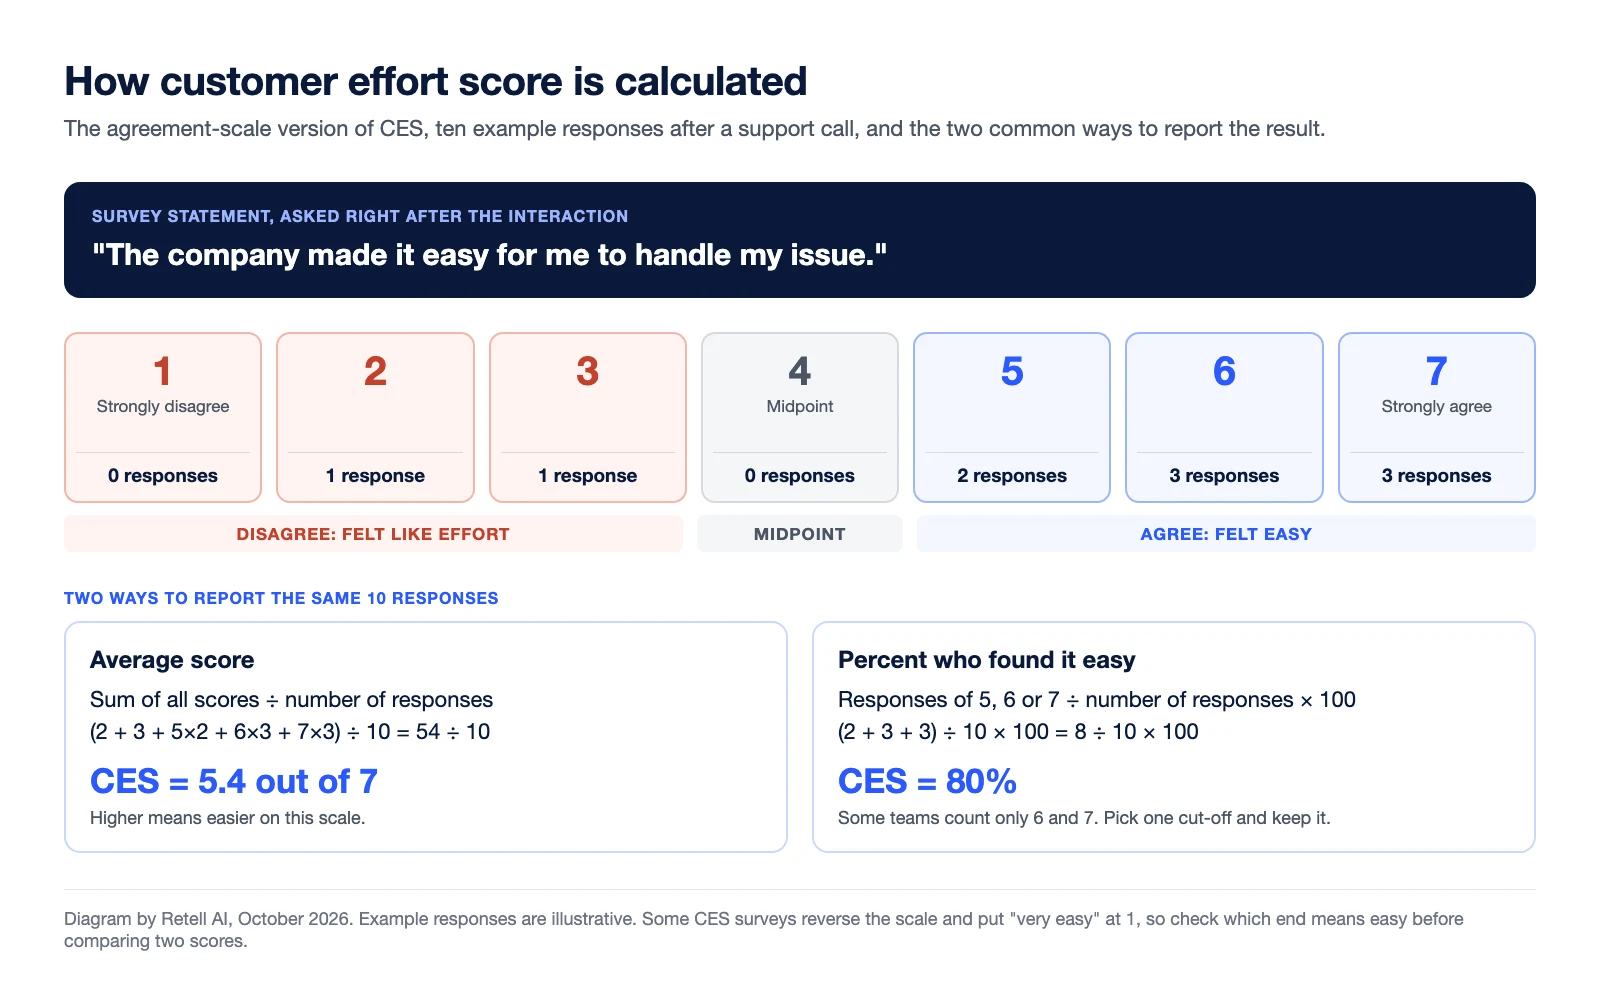
De to metoder kan fortælle forskellige historier om de samme data. I eksemplet ovenfor er gennemsnittet 5,4, og procentmetoden giver 80 %. Målt mod de mål, Salesforce offentliggør (se nedenfor), rammer gennemsnittet ikke målet på 5,5, mens procentdelen når målet på 80 %. Vælg én metode, skriv grænseværdien ned, og hold begge fast, så din udvikling betyder noget.
Hvilke spørgsmål og skalaer kan man bruge i en CES-undersøgelse?
De fleste CES-undersøgelser bruger en variant af ét udsagn, »Virksomheden gjorde det let for mig at håndtere min sag«, ifølge Salesforce. Teams stiller også spørgsmålet som en vurdering af, hvor let noget var. Det format, du vælger, afgør, hvilken ende af skalaen der er god.
| Format | Eksempel på formulering | Skala | Den lette ende | Kilde |
|---|---|---|---|---|
| Enighedsudsagn | »Virksomheden gjorde det let for mig at håndtere min sag.« | 1 til 7, meget uenig til meget enig | 7 | Salesforce |
| Vurdering af lethed i ord | »På en skala fra 'meget let' til 'meget svært', hvor let var det at interagere med [virksomhedens navn]?« | Meget svært, svært, neutral, let, meget let | Meget let | Qualtrics, IBM |
| Vurdering af lethed i tal, let først | »På en skala fra 1 til 5, hvor let var det at få løst din sag?« | 1 (meget let) til 5 (meget svært) | 1 | SurveyMonkey |
| Vurdering af lethed i tal, let sidst | Vurder, hvor stor en indsats interaktionen krævede | 1 (meget svært) til 9 (meget let) | 9 | IBM |
| To spørgsmål | Et hvilket som helst af ovenstående plus »Hvorfor gav du den score?« | Skala plus fritekst | Afhænger af skalaen | IBM, Salesforce |
Det er værd at tilføje opfølgningen med fritekst til ethvert format. En score fortæller dig, at et trin var svært. Begrundelsen fortæller dig, hvilket trin.
Hvad er en god Customer Effort Score?
Der findes ikke ét benchmark, fordi en god CES afhænger af skalaen og af, hvilken ende af den der betyder let. De grænseværdier, leverandørerne offentliggør, er vejledende og ikke målte branchegennemsnit, og ingen af de tre nedenfor henviser til et datasæt for dem.
| Kilde | Skala | God score | Bør undersøges |
|---|---|---|---|
| Salesforce | Lethedsskala fra 1 til 5 | 4,0 eller højere | Under 3,5 |
| Salesforce | Enighedsskala fra 1 til 7 | 5,5 eller højere | Under 5,0 |
| Salesforce | Enighedsprocent | 80 % eller højere | Under 70 % |
| IBM | Enhver skala | De øverste 20 % af din skala, fx mindst 4 på en skala fra 1 til 5 | Ikke angivet |
| SurveyMonkey | 1 til 5 eller 1 til 7, hvor 1 er meget let | Under 3 | 4 til 5 kræver forbedring; over 5 er stor indsats |
Bemærk, at SurveyMonkey kalder en score under 3 god, mens Salesforce kalder 4,0 eller højere god på en femtrinsskala. Begge har ret i forhold til deres egen skalaretning. Før du sammenligner din CES med andres, skal du bekræfte spørgsmålet, skalaens længde, og hvilken ende der betyder let. Sammenlign derefter først med dine egne tidligere måneder.
Hvordan adskiller CES sig fra CSAT og NPS?
CES måler, hvor let én interaktion var. CSAT måler, hvor tilfreds kunden var med den. NPS måler den samlede relation.
| Måling | Spørgsmål, den besvarer | Typisk skala | Hvornår man spørger |
|---|---|---|---|
| CES | Hvor let var det at få det her gjort? | 1 til 5 eller 1 til 7 | Lige efter interaktionen |
| CSAT | Hvor tilfreds er du med denne interaktion? | 1 til 3, 1 til 5 eller 1 til 10 | Lige efter et køb eller et supportforløb |
| NPS | Hvor sandsynligt er det, at du vil anbefale os? | 0 til 10 | Periodisk, ofte kvartalsvis eller årligt |
Kilde: Salesforce. For benchmarks for kunderelationen, se hvad en god NPS-score er og vores guide til Net Promoter Score.
Hvad gør et telefonopkald krævende?
CEB-forskningen bag CES viste, at oplevelser med stor indsats bl.a. omfatter at skulle skifte kanal for at få løst et problem, at gentage oplysninger, standardiseret service og at blive viderestillet til en anden medarbejder, ifølge Qualtrics. Salesforce beskriver det samme mønster som for mange trin, for mange viderestillinger og for mange gentagne forklaringer.
På en supportlinje viser det sig som menutræer, før den, der ringer, får hjælp, en viderestilling, hvor den, der ringer, skal forklare sagen igen, kontooplysninger, der bliver spurgt om to gange, og et løfte om at ringe tilbage, der ender som et ekstra opkald. Løsning ved første kontakt er den tilhørende måling: Et opkald, der slutter uden løsning, betyder som regel endnu en kontakt, og endnu en kontakt betyder mere indsats.
Hvordan påvirker AI-stemmeagenter kundens indsats?
En AI-stemmeagent kan fjerne nogle af de trin, der øger indsatsen, eller tilføje nye, hvis den er sat dårligt op. Med Retell AI er de dokumenterede funktioner, der har betydning for indsatsen:
- Kontekst, før agenten taler. Ved indgående opkald lader webhooken for indgående opkald dit system angive dynamiske variabler og anden kontekst pr. opkald, fx oplysninger slået op ud fra den opkaldendes nummer, før opkaldet håndteres.
- Hukommelse på tværs af opkald. Med kontakthukommelse kan en agent huske gemt kontekst fra tidligere telefonopkald og SMS-chats med samme nummer og kun spørge efter de oplysninger, der mangler.
- Viderestillinger, der orienterer den, der tager telefonen. Ved en assisteret viderestilling bliver agenten på linjen, kan vente på, at et rigtigt menneske tager telefonen, og kan afspille en hviskebesked, som kun modtageren hører, eller præsentere den, der ringer, i et trevejsopkald.
Risikoen går også den anden vej. Hvis en agent ikke kan løse henvendelsen og overdrager uden kontekst, må den, der ringer, forklare alt to gange, hvilket netop er den faktor med gentagne oplysninger, som CEB-forskningen nævner. Følg CES separat for opkald, agenten løste, og opkald, den viderestillede.
Hvordan måler man CES i telefonopkald?
Du kan stille CES-spørgsmålet i slutningen af opkaldet og gemme svaret som data:
- Spørg, før opkaldet slutter. Tilføj enighedsudsagnet og skalaen fra 1 til 7 til agentens afslutning plus ét åbent spørgsmål om hvorfor.
- Gem scoren som et felt. I Retell læser Post Call Extraction transskriptionen efter opkaldet og skriver resultaterne til opkaldets
call_analysis-objekt. Tilføj et talfelt til scoren og et tekstfelt til begrundelsen. - Send den til dine systemer.
call_analyzed-webhooken leverer alle opkaldsdata, inklusivecall_analysis, til dit endpoint. - Vis udviklingen i et diagram. Analysedashboardet kan vise ethvert brugerdefineret Post Call Extraction-felt over tid.
Der er to begrænsninger, du skal planlægge efter. Retell udfylder ikke brugerdefinerede udtræksfelter for opkald, der ikke blev forbundet eller ikke indeholdt en samtale, så de opkald falder ud af din CES-stikprøve. Og det indbyggede felt for brugerens stemning udledes af transskriptionen, ikke af tonefaldet, så det kan ikke erstatte at stille spørgsmålet. Se vores guide til at spore NPS og CSAT fra opkaldssamtaler for en komplet opsætning; de samme trin virker for CES.
Ofte stillede spørgsmål om Customer Effort Score
Hvad betyder CES?
CES står for Customer Effort Score. Den måler, hvor let det var for en kunde at gennemføre en opgave hos en virksomhed, fx at få løst en supportsag, som regel via ét spørgsmål i en undersøgelse lige efter interaktionen.
Er en højere Customer Effort Score bedre?
Det afhænger af skalaen. På enighedsskalaen, hvor 7 betyder, at kunden er meget enig i, at virksomheden gjorde det let, er højere bedre. På lethedsskalaer, der placerer »meget let« ved 1, er lavere bedre. Tjek, hvilken ende der betyder let, før du sammenligner scorer.
Hvad er en god Customer Effort Score?
Der findes ikke noget universelt benchmark. Salesforce foreslår at sigte efter 5,5 eller højere på en enighedsskala fra 1 til 7, 4,0 eller højere på en lethedsskala fra 1 til 5 eller 80 % eller højere som enighedsprocent. IBM foreslår at ligge i de øverste 20 % af den skala, du bruger.
Hvordan adskiller CES sig fra CSAT?
CES spørger, hvor let en interaktion var, mens CSAT spørger, hvor tilfreds kunden var med den. Begge stilles lige efter en interaktion. CES peger på det trin, der gjorde noget svært, hvilket gør det lettere at handle på.
Hvornår skal man sende en CES-undersøgelse?
Send den umiddelbart efter den interaktion, du vil måle, fx et supportopkald, en lukket sag eller et gennemført køb, mens oplevelsen stadig er frisk. I et telefonopkald kan agenten stille spørgsmålet, før opkaldet slutter.
Mål og mindsk indsatsen i dine opkald med Retell AI
Retell AI er en platform for AI-stemmeagenter, der besvarer og foretager opkald, tager kontekst om den, der ringer, med ind i samtalen, orienterer en medarbejder før en assisteret viderestilling og omdanner hvert opkald til strukturerede data, du kan vise i diagrammer. Priserne starter fra $0,07 pr. minut; se Retell AI-priser for aktuelle detaljer.