Mejores API de IA de voz a voz en tiempo real para llamadas telefónicas (2026)



Los mejores servicios de IA de voz a voz en tiempo real para llamadas telefónicas en 2026 son Retell AI, la OpenAI Realtime API, OpenAI GPT-Live-1, la Google Gemini Live API, Amazon Nova 2.5 Sonic, la Deepgram Voice Agent API y la AssemblyAI Voice Agent API.
Retell es la opción adecuada cuando las llamadas son llamadas telefónicas en producción, porque envuelve un modelo de voz a voz con la telefonía, las transferencias y las pruebas que necesita una línea telefónica. Las otras seis son API de modelos o de pipelines. Te dan el bucle de voz y dejan en tus manos la mayor parte del sistema telefónico, el traspaso a una persona y el QA.
Retell AI publica esta lista y es una de las opciones comparadas. Los precios y las funciones de la competencia proceden de la página pública de precios, del modelo o de la documentación de cada proveedor, consultadas el 22 de octubre de 2026, y se enlazan donde se citan.
Cómo elegimos y comparamos las opciones. Incluimos todas las API que aceptan audio en directo y devuelven voz en tiempo real y que un equipo podría poner detrás de un número de teléfono: modelos nativos de voz a voz de OpenAI, Google y Amazon, dos API integradas de agentes de voz de Deepgram y AssemblyAI, y Retell como capa de plataforma. Las comparamos según cinco criterios (más abajo) usando solo información publicada por los proveedores. No hicimos llamadas de prueba ni medimos la latencia, así que el artículo no incluye puntuaciones ni cifras de latencia.
En resumen
- Modelos nativos de voz a voz: OpenAI gpt-realtime-2.1, OpenAI GPT-Live-1, Gemini 3.8 Live y Amazon Nova 2.5 Sonic reciben audio y devuelven audio en un solo modelo.
- API integradas de agentes de voz: Deepgram y AssemblyAI ejecutan voz a texto, un LLM y texto a voz detrás de un único WebSocket y una única tarifa por minuto.
- Cifras de audio por minuto más bajas publicadas: Gemini 3.8 Live, a 0,005 $ por minuto de entrada y 0,018 $ por minuto de salida, que Google convierte a partir de 3 $ y 12 $ por 1 M de tokens de audio.
- Tarifas planas por minuto: GPT-Live-1 a 0,05 $ por minuto para la capa de voz (el modelo de backend se factura aparte), Deepgram desde 0,075 $ por minuto y AssemblyAI a 0,075 $ por minuto todo incluido.
- SIP directo: OpenAI acepta llamadas SIP tanto en su Realtime API como en sus sesiones Live, y AssemblyAI recibe SIP a través de tu propia cuenta de Twilio. Para Gemini Live, la documentación de Google remite a integraciones de socios como LiveKit y Pipecat.
- Agentes telefónicos en producción: Retell ejecuta los modelos en tiempo real de OpenAI, Grok Voice o un pipeline de LLM estándar, y añade transferencia asistida, navegación de IVR, pruebas de simulación y análisis posterior a la llamada.
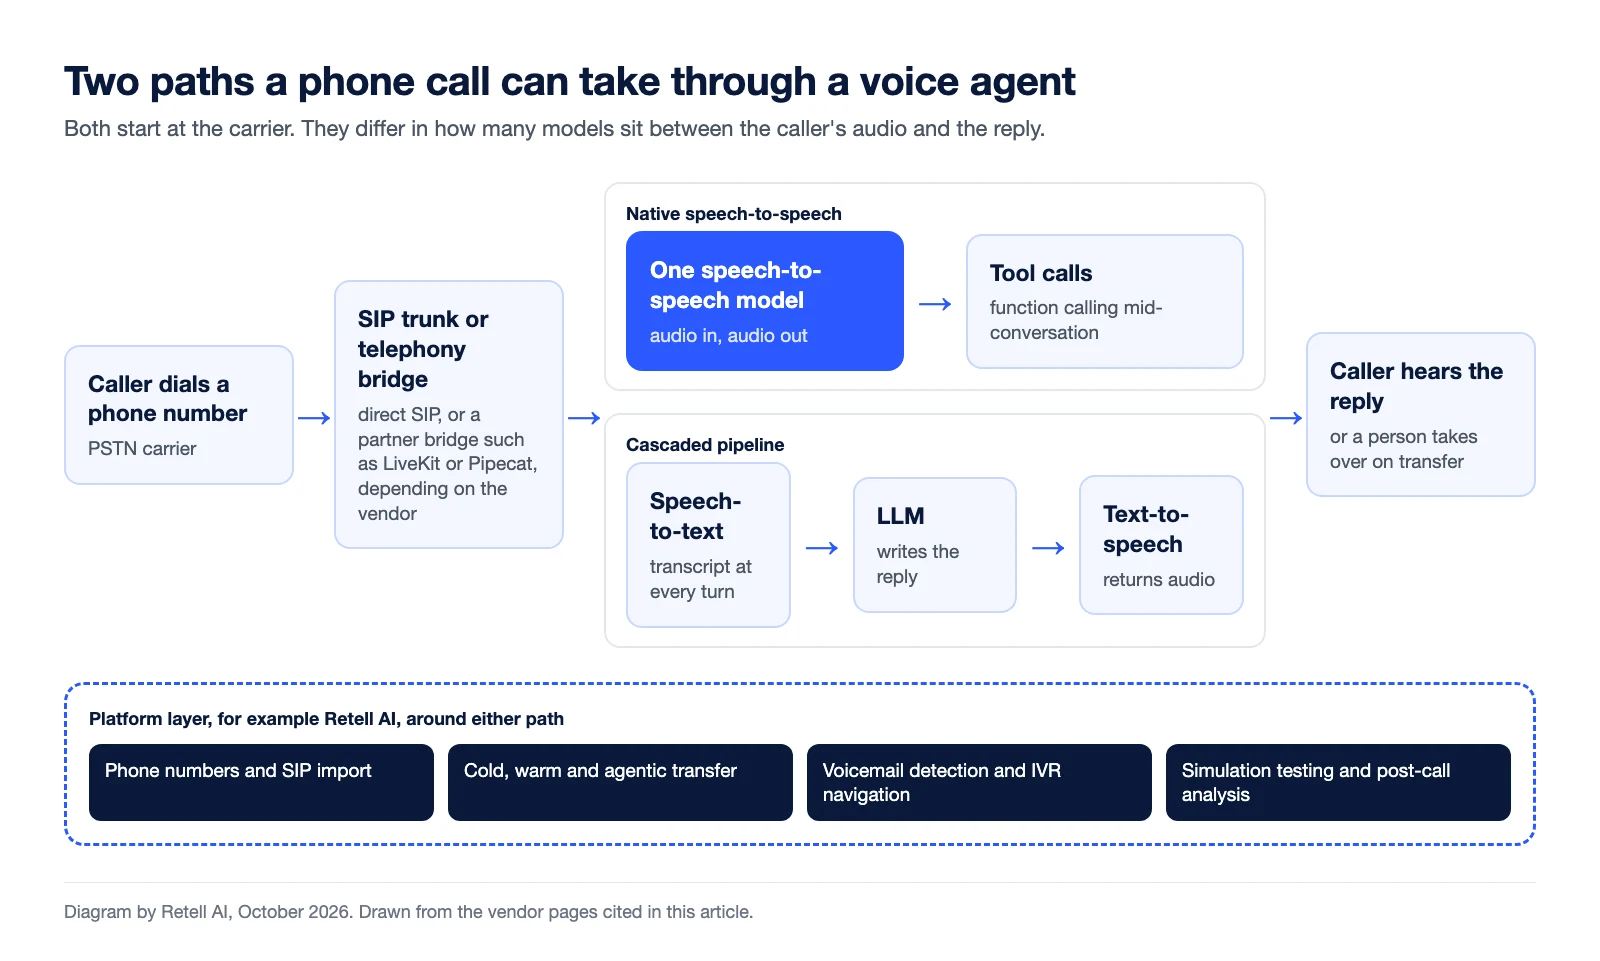
¿Cómo se comparan las 7 API?
La distinción que importa es si estás comprando un modelo o un agente telefónico. La tabla muestra qué es cada opción, cómo le llega una llamada telefónica y su precio publicado a 22 de octubre de 2026.
| API | Qué es | Cómo le llega una llamada telefónica | Precio publicado | Ideal para |
|---|---|---|---|---|
| Retell AI | Plataforma de agentes telefónicos que ejecuta modelos en tiempo real de OpenAI, Grok Voice o un pipeline de LLM estándar | Integrada: compra números de EE. UU. o Canadá, o importa los tuyos mediante SIP, Twilio o Vonage | Desde 0,07 $ por minuto, consulta los precios de Retell | Agentes telefónicos entrantes y salientes en producción |
| OpenAI Realtime API | Modelo nativo de voz a voz (gpt-realtime-2.1) con razonamiento configurable y llamadas a funciones | Trunk SIP dirigido al endpoint SIP de OpenAI | 32 $ por 1 M de tokens de audio de entrada, 64 $ de salida | Equipos que construyen su propio stack sobre el razonamiento de GPT |
| OpenAI GPT-Live-1 | Modelo de voz full-duplex que delega el razonamiento en un modelo de backend | SIP entrante y saliente en sesiones Live (el saliente debe estar habilitado para tu organización) | 0,05 $ por minuto, más el uso del modelo de backend | Turnos de palabra naturales con un modelo de razonamiento independiente |
| Gemini Live API | Modelos nativos de audio a audio (Gemini 3.8 Live, Gemini 3.8 Live Extended Thinking) | Integraciones de socios como LiveKit y Pipecat; sin ruta SIP en las páginas que consultamos | 0,005 $ por minuto de audio de entrada, 0,018 $ de salida | Bajo coste de audio publicado, grounding con Google Search |
| Amazon Nova 2.5 Sonic | Modelo nativo de voz a voz en Amazon Bedrock | No se trata en el anuncio de AWS | Igual que Nova 2 Sonic, según AWS | Equipos que ya usan AWS Bedrock |
| Deepgram Voice Agent API | STT, LLM y TTS en cascada detrás de un único WebSocket | Guías de telefonía para Twilio y Plivo; tú gestionas la conexión | 0,075 $ por minuto en Standard, pago por uso | Equipos que quieren la voz de Deepgram con la opción de usar su propio LLM |
| AssemblyAI Voice Agent API | STT, LLM y TTS en cascada detrás de un único WebSocket | SIP a través de tu propia cuenta de Twilio | 4,50 $ por hora (0,075 $ por minuto), todo incluido | Llamadas en las que la precisión es crítica, con tarifa plana |
Cómo comparamos cada API
Analizamos cinco aspectos que una llamada telefónica deja al descubierto y que una demo en el navegador oculta:
- Ruta de telefonía. ¿Puede una llamada PSTN llegar al modelo sin que tengas que gestionar un servidor multimedia?
- Turnos de palabra en condiciones reales. ¿Documenta el proveedor cómo gestiona las interrupciones en llamadas en directo?
- Llamadas a herramientas mientras habla. ¿Puede el agente consultar un pedido sin dejar de hablar?
- Traspaso a una persona. ¿La transferencia asistida viene integrada o la tienes que programar tú?
- Coste previsible. ¿Se factura por minuto o por token, y qué queda fuera del contador?
Las cifras de latencia que declaran los proveedores se miden de formas distintas y no son comparables, así que no aparecen aquí.
Retell AI
Retell AI es la mejor opción cuando un modelo de voz a voz tiene que superar llamadas telefónicas reales, porque gestiona todo lo que rodea al modelo en la llamada: números, traspaso a una persona, buzón de voz y pruebas.
La API de Retell incluye opciones de voz a voz como la familia gpt-realtime de OpenAI (gpt-realtime-2.1, gpt-realtime-2 y otros) y Grok Voice 3.0, como una opción más entre sus modelos compatibles. También puedes ejecutar un agente sobre un pipeline estándar con el LLM que elijas y mantener la misma telefonía, transferencias y pruebas en ambos casos. Consulta las opciones de modelo en la referencia de la API.
Como prueba en llamadas difíciles, Cekura realizó un benchmark de 414 llamadas con seis plataformas de voz (Retell, ElevenLabs, Pipecat, LiveKit, Synthflow y Vapi) sobre un flujo de trabajo regulado de Medicare. Retell superó 22 de 23 evaluadores y lideró con un 95,7 % de precisión en el flujo de trabajo, contando solo las comprobaciones superadas en las tres ejecuciones. Entre los casos difíciles había una persona que interrumpe el aviso legal y exige detalles del plan, un familiar que llama en nombre de un beneficiario y alguien que pide al agente que prometa que un plan cubre su medicación. Es un benchmark de plataformas sobre un único flujo de trabajo, no una comparación de modelos de voz a voz.
Lo que obtienes además del modelo:
- Telefonía: compra números de EE. UU. o Canadá en el panel, o importa los tuyos mediante SIP trunking, incluidos Twilio y Vonage.
- Traspaso a una persona: transferencia de llamadas en frío, asistida y agéntica a una persona, con un resumen contextual en las transferencias asistidas.
- Telefonía saliente: detección de buzón de voz y navegación de IVR por los menús telefónicos de otras empresas.
- Pruebas y QA: pruebas de simulación antes del lanzamiento y, después, análisis posterior a la llamada y control de calidad con IA en las llamadas en producción.
Precios: desde 0,07 $ por minuto en la página de precios de Retell.
Ten en cuenta: Retell es una plataforma, no un endpoint de modelo en bruto. Si quieres controlar tú mismo cada fotograma del pipeline de audio, empieza mejor con una API de modelo.
OpenAI Realtime API (gpt-realtime-2.1)
La OpenAI Realtime API es la opción para equipos que quieren un modelo de voz a voz en bruto con razonamiento de GPT y que construirán por su cuenta el resto del stack telefónico.
gpt-realtime-2.1 recibe audio y devuelve audio, admite un nivel de razonamiento configurable y llamadas a funciones, y mejora gpt-realtime-2 con un mejor reconocimiento alfanumérico, una mejor gestión del silencio y el ruido, y un mejor comportamiento ante interrupciones. OpenAI indica los mismos precios para ambos modelos.
Además, responde a una llamada telefónica sin un puente aparte. Según la guía de SIP de OpenAI, diriges un trunk SIP al endpoint SIP de OpenAI, aceptas o rechazas cada llamada con su ID de llamada y puedes transferirla con un SIP REFER.
Precios: 32 $ por 1 M de tokens de audio de entrada y 64 $ por 1 M de tokens de audio de salida, más 4 $ y 24 $ por 1 M de tokens de texto. Un mayor nivel de razonamiento puede aumentar la latencia y el uso de tokens de salida.
Ten en cuenta: la facturación por tokens crece con la duración de la conversación porque el contexto se acumula. La grabación, el QA, los reintentos y la lógica de escalado a una persona los tienes que construir tú.
OpenAI GPT-Live-1
GPT-Live-1 es la mejor opción cuando los turnos de palabra naturales importan más que tener el razonamiento dentro del modelo de voz. Es un modelo full-duplex que escucha y habla a la vez, y delega el razonamiento y el uso de herramientas en un agente de backend. Nuestra guía de GPT-Live-1 muestra cómo funciona esa división en un agente telefónico.
Se ejecuta en el endpoint de sesiones Live de OpenAI, no en el endpoint Realtime, así que no es un sustituto directo de gpt-realtime-2.1. Según la guía de voz y SIP de OpenAI, las llamadas entrantes llegan por SIP y las llamadas SIP salientes están disponibles a través de la Live API una vez habilitadas para tu organización. El tono de llamada está limitado a 3 minutos y una llamada conectada a 2 horas.
Precios: 0,05 $ por minuto de sesión, facturado por segundo, con el uso del modelo de backend y de las herramientas facturado aparte.
Ten en cuenta: la concurrencia está limitada por nivel, con 50 sesiones en Build, 300 en Launch y 500 en Grow, y el SIP entrante requiere que el soporte SIP de GPT-Live esté habilitado para tu proyecto.
Google Gemini Live API
La Gemini Live API tiene las cifras de audio por minuto más bajas entre los precios publicados. Gemini 3.8 Live y Gemini 3.8 Live Extended Thinking pasaron a estar disponibles de forma general el 15 de septiembre de 2026, y ambos indican 0,005 $ por minuto de audio de entrada y 0,018 $ por minuto de audio de salida en la página de precios de Google. Esas cifras por minuto aparecen junto a 3 $ y 12 $ por 1 M de tokens de audio, así que son una conversión, no un contador aparte.
El modelo Extended Thinking admite razonamiento en segundo plano durante la llamada, y el grounding con Google Search está disponible en el nivel de pago, con 5.000 búsquedas gratuitas al mes y después 14 $ por cada 1.000.
Ten en cuenta: la guía de la Live API de Google enumera integraciones de socios como LiveKit y Pipecat y no describe ninguna ruta de trunk SIP, así que cuenta con poner un puente delante de la Live API. El precio de salida incluye los tokens de razonamiento, por lo que la cifra por minuto es un mínimo.
Amazon Nova 2.5 Sonic
Amazon Nova 2.5 Sonic es la opción por defecto para equipos que ya construyen sobre AWS Bedrock. AWS lo lanzó de forma general el 5 de octubre de 2026, con mejoras en el razonamiento, el seguimiento de instrucciones y la precisión de las llamadas a herramientas, menor latencia, voces expresivas en siete idiomas, turnos de palabra controlables, llamadas asíncronas a herramientas y una ventana de contexto de 256K.
El framework Strands Bidi Agents de AWS, ya disponible de forma general, es su vía para crear un agente de voz con unas pocas líneas de código.
Precios: AWS indica que Nova 2.5 Sonic tiene el mismo precio que Nova 2 Sonic. Consulta la página de precios de Amazon Nova para ver las tarifas actuales por token, que se cargan de forma dinámica.
Ten en cuenta: está disponible en cuatro regiones de Bedrock (N. Virginia, Oregón, Estocolmo, Tokio), y siete idiomas son menos que en otras opciones de esta lista. El anuncio no describe ninguna ruta telefónica, así que confirma cómo llegan las llamadas al modelo antes de comprometerte.
Deepgram Voice Agent API
La Voice Agent API de Deepgram es la opción para equipos que quieren el reconocimiento de voz de Deepgram con la posibilidad de usar su propio LLM o su propia voz. Ejecuta voz a texto, un LLM y texto a voz detrás de un único WebSocket y un único contador por minuto, y la documentación de Deepgram incluye guías de agentes de telefonía entrante y saliente para Twilio y Plivo.
Precios: 0,075 $ por minuto en el nivel Standard de pago por uso y 0,163 $ en Advanced, con tarifas más bajas si usas tu propio LLM o TTS.
Ten en cuenta: es un pipeline en cascada, no un modelo nativo de voz a voz. Las cuentas de pago por uso están limitadas a 45 conexiones simultáneas de Voice Agent (60 en Growth), algo que importa la primera vez que una campaña hace llamadas salientes.
AssemblyAI Voice Agent API
La Voice Agent API de AssemblyAI es la opción cuando la precisión de la transcripción decide si el agente funciona, por ejemplo con nombres, números de cuenta y direcciones. Ejecuta el modelo de voz Universal-3.6 Pro Realtime de AssemblyAI, un LLM y TTS detrás de un único WebSocket.
Precios: una tarifa plana de 4,50 $ por hora (0,075 $ por minuto) que cubre voz a texto, el LLM y TTS, facturada por minuto de sesión, según la referencia de precios de AssemblyAI. Para llamadas telefónicas, la documentación de AssemblyAI indica que Twilio pasa las llamadas a AssemblyAI por SIP, así que no hay que gestionar ningún servidor multimedia ni webhook. El trunk SIP y el número están en tu propia cuenta de Twilio.
Ten en cuenta: igual que Deepgram, funciona en cascada, no de audio a audio de forma nativa, así que obtienes una transcripción en cada turno, pero no un modelo que capte el tono directamente.
¿Deberías usar un modelo nativo de voz a voz o un pipeline en cascada?
Usa un modelo nativo de voz a voz cuando el tono y la rapidez en los turnos de palabra importen más que el control sobre cada paso, y un pipeline en cascada cuando necesites ver y corregir lo que ha oído el agente. Un modelo nativo recibe audio y devuelve audio, sin un paso de transcripción aparte. Un pipeline en cascada te da una transcripción en cada turno, lo que facilita depurar un número de cuenta erróneo o hacer cumplir un guion normativo.
En cualquier caso, una línea telefónica añade trabajo que el modelo no hace: gestión de interrupciones, recuperación de transferencias y pruebas con llamadas que se salen del guion. Para ver con más detalle en qué se diferencian ambos diseños, lee cómo funciona la IA de voz en tiempo real. Si estás eligiendo el modelo de razonamiento de un agente en cascada, consulta los mejores LLM para agentes de voz con IA y los mejores modelos de voz a texto.
¿Cómo eliges la API adecuada para tus llamadas?
Parte de dónde llega la llamada y de quién se responsabiliza cuando falla. Cuatro preguntas lo resuelven:
- ¿Las llamadas vienen de la red telefónica? Si es así, descarta todo lo que necesite un puente que no quieras gestionar, o elige una plataforma que incluya telefonía. Nuestra guía sobre SIP trunking y telefonía moderna cubre la parte del operador.
- ¿Qué pasa cuando el agente no sabe la respuesta? Si una persona tiene que tomar el relevo con contexto, necesitas transferencia asistida, no solo un endpoint para colgar.
- ¿Puedes prever la factura? El precio por minuto (GPT-Live-1, Deepgram, AssemblyAI) es más fácil de presupuestar que el precio por token, en el que las llamadas largas cuestan más por minuto.
- ¿Quién arregla una llamada fallida? Si va a ser tu equipo de operaciones, y no tus ingenieros, quien ajuste los prompts y los flujos, elige una plataforma con pruebas y control de versiones integrados.
Preguntas frecuentes
¿Qué es una API de IA de voz a voz?
Una API de IA de voz a voz recibe el audio de quien llama y devuelve audio hablado desde un único modelo, sin pasos separados de transcripción y de voz. OpenAI gpt-realtime-2.1, GPT-Live-1, Gemini 3.8 Live y Amazon Nova 2.5 Sonic funcionan así.
¿Qué API de voz a voz es la más barata para llamadas telefónicas?
Gemini 3.8 Live indica las cifras de audio por minuto más bajas, con 0,005 $ por minuto de audio de entrada y 0,018 $ por minuto de audio de salida, convertidas por Google a partir de 3 $ y 12 $ por 1 M de tokens de audio. Tu coste real suma la telefonía, cualquier puente que gestiones y los tokens de razonamiento, que se facturan como salida. AWS indica que Nova 2.5 Sonic cuesta lo mismo que Nova 2 Sonic, y OpenAI factura la Realtime API por token, así que compara según la duración de tus propias llamadas.
¿Puedo conectar la OpenAI Realtime API a un número de teléfono?
Sí. Dirige un trunk SIP de un operador como Twilio al endpoint SIP de OpenAI y, después, acepta cada llamada con su ID de llamada. Las transferencias usan un SIP REFER.
¿Retell es compatible con modelos de voz a voz?
Sí. La API de Retell incluye opciones de voz a voz como la familia gpt-realtime de OpenAI y Grok Voice 3.0, y un agente de Retell también puede ejecutarse sobre un pipeline estándar con el LLM que elijas. Las funciones de telefonía y transferencia son las mismas en ambos casos.
¿Qué pasa cuando el agente de IA no puede responder?
Con una API de modelo, tú escribes la lógica de escalado. Con Retell, el agente puede hacer una transferencia de llamadas en frío, asistida o agéntica a una persona, y una transferencia asistida pasa un resumen contextual para que quien llama no tenga que repetirse.
¿Puedo conservar mi número de teléfono actual?
Con Retell, sí: puedes importar un número existente mediante SIP trunking en lugar de comprar uno nuevo. Con las API de modelos, depende del trunk SIP o del puente que gestiones.
Pruébalo con tus propias llamadas
Un guion de demo no te permitirá distinguir estas API; tus propias llamadas, sí. Crea gratis un agente de Retell, elige un modelo de voz a voz o uno estándar y ponlo a prueba con las llamadas que a tu equipo le resultan más difíciles.
Descubre cuánto podría ahorrar tu empresa al pasar a agentes de voz impulsados por IA.
Resultado del ROI
Total Human Agent Cost
AI Agent Cost
Estimated Savings
Un número de teléfono de demostración de Retell Clinic Office
What results look like with Retell AI


Estimate your monthly voice AI cost
Read Other Blogs

Revoluciona tu operación de llamadas con Retell


