Sammenflettet ræsonnement (interleaved reasoning) er en måde at køre en ræsonnementsmodel på, hvor modellen skifter mellem privat ræsonnement og synlige handlinger, såsom værktøjskald eller dele af sit svar, i stedet for at afslutte hele sit ræsonnement, før den svarer.
Det kaldes også sammenflettet tænkning (interleaved thinking). Leverandørdokumentation bruger mest begrebet om ræsonnement mellem værktøjskald. Forskningsartikler bruger det om en model, der skifter mellem tænkning og dele af sit svar. Begge beskriver den samme ændring: Ræsonnementet er ikke længere én samlet blok i starten af turen.
Hvad er en ræsonnementsmodel?
En ræsonnementsmodel er en stor sprogmodel, der genererer mellemliggende ræsonnement før sit svar. OpenAI's guide til ræsonnement siger det på én linje: "Ræsonnementsmodeller bruger interne ræsonnementstokens, før de producerer et svar." Googles Gemini-dokumentation siger, at en tænkende model "ræsonnerer internt, før den svarer", og DeepSeeks dokumentation siger, at dens tænketilstand producerer chain-of-thought-ræsonnement "for at forbedre nøjagtigheden af det endelige svar".
Hvad er ræsonnementstokens?
Ræsonnementstokens, også kaldet tænketokens, er de tokens, en model genererer, mens den arbejder sig igennem et problem. De er ikke en del af svaret. Tre egenskaber er vigtige:
- De faktureres. OpenAI siger, at ræsonnementstokens "faktureres som output-tokens". Anthropics dokumentation om tænkning siger det samme om Claude, "selv når tænketeksten ikke returneres til dig". Google prissætter et svar som "summen af output-tokens og tænketokens".
- De er ofte skjulte. OpenAI's ræsonnementstokens "er ikke synlige via API'en". Anthropic siger, at det, du ser, "aldrig er den rå tankekæde". Begge kan returnere et resumé, hvis du beder om et.
- De tager tid og plads. OpenAI siger, at en model kan generere "alt fra nogle få hundrede til titusindvis af ræsonnementstokens" på én forespørgsel, og de optager kontekstvinduet.
Udviklere styrer mængden med en indstilling: reasoning effort hos OpenAI, effort hos Anthropic og thinking level hos Google.
Hvordan adskiller sammenflettet ræsonnement sig fra tænk-først-ræsonnement?
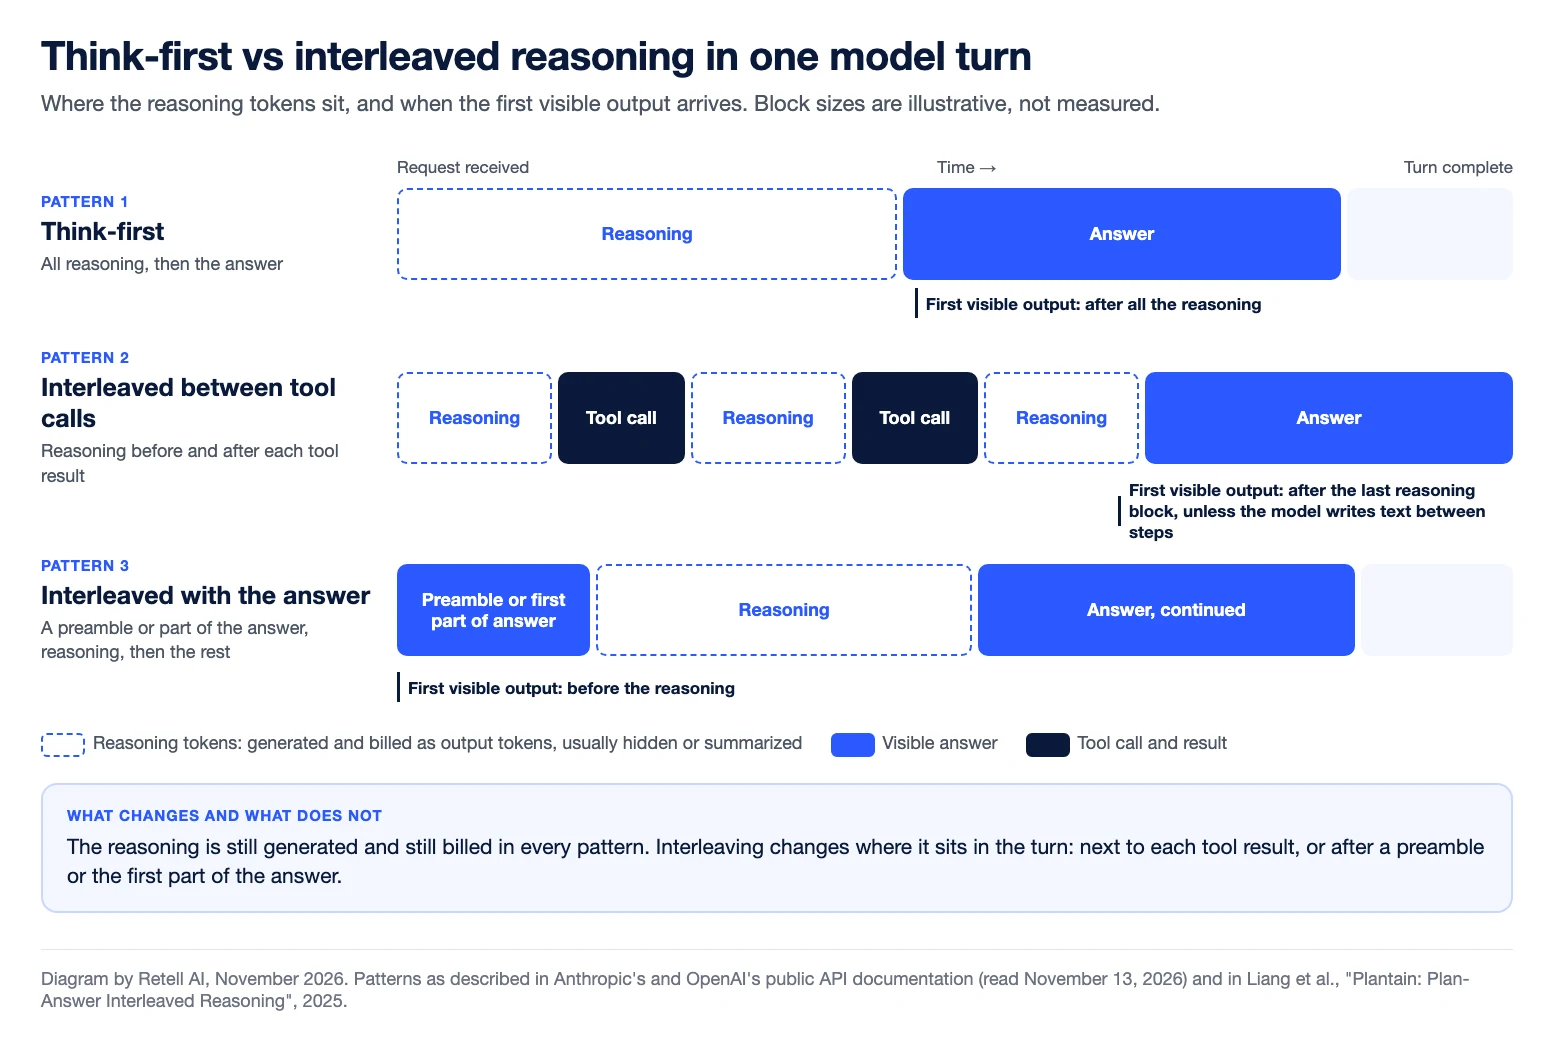
Ved tænk-først-ræsonnement sker alt ræsonnementet før det første synlige token. Anthropic kalder det up-front thinking: Tænkeblokke "kommer før tekstblokkene". Sammenflettet ræsonnement deler ræsonnementet op i mindre blokke og placerer dem, hvor der er brug for dem.
| Mønster | Arbejdsrækkefølge i én tur | Det første, brugeren ser | Offentligt beskrevet af |
|---|---|---|---|
| Intet ræsonnement | Svar | Starten af svaret | Enhver model med ræsonnement slået fra |
| Tænk først | Alt ræsonnement, derefter svaret | Intet, før ræsonnementet slutter | Anthropic (up-front thinking), DeepSeek |
| Sammenflettet mellem værktøjskald | Ræsonnér, kald et værktøj, læs resultatet, ræsonnér igen, og svar derefter | Intet, før den sidste ræsonnementsblok slutter, medmindre modellen skriver tekst mellem trinnene | Anthropic, OpenAI, vLLM, DeepSeek (uden begrebet) |
| Sammenflettet med svaret | En indledning eller del af svaret, ræsonnement, mere af svaret | En indledning eller en tidlig del af svaret | OpenAI, forskningsartikler |
| Sammenflettet med tale | Første sætning af svaret, lydløst ræsonnement, mens den afspilles, derefter resten af svaret | Den første sætning af svaret | Tell-1, den egenudviklede LLM fra Retell |
Hvad dokumenterer leverandørerne i dag?
Læst den 13. november 2026:
- Anthropic. "Interleaved thinking lader Claude tænke mellem værktøjskald og ræsonnere om hvert værktøjsresultat, før den handler på det." Det er automatisk på modeller, der understøtter adaptive thinking. Modeller på manuel extended thinking kræver en beta-header.
- OpenAI. Modeller som gpt-5.5 "understøtter interleaved thinking, hvor modellen kan generere synlige output-tokens før og mellem tænkning og kan tænke mellem værktøjskald".
- Google. Gemini-siden om tænkning bruger ikke begrebet. Den siger, at tænketrin "vises kronologisk sammen med funktionskald, brugerinput eller modeloutput", og at thought signatures er "nødvendige for at bevare kontinuiteten i ræsonnementet på tværs af interaktioner med flere ture".
- vLLM. Open source-inferensserveren understøtter interleaved thinking for to modelserier og advarer om, at det "øger tokenforbruget og svarlatensen".
I forskningen trænede Xie et al. (2025) modeller "til at sammenflette tænkning og svar" og rapporterer, at tiden til første token faldt med over 80 % i gennemsnit. Liang et al. (2025) definerer sammenflettet ræsonnement som en model, der "skifter mellem at tænke og vise mellemliggende svar", og rapporterer, at deres plan-først-variant, Plantain, reducerede tiden til første svar med over 60 %. Begge undersøgte tekstopgaver.
Hvorfor koster tænk-først-ræsonnement stilhed i et opkald?
I et telefonopkald kan talesyntesen ikke starte, før modellen producerer de første ord i sit svar. Hvert ræsonnementstoken, der genereres før de ord, er tid, hvor den, der ringer, intet hører. I et chatvindue er den samme ventetid en fremskridtsindikator. I et opkald er det død luft og ekstra latens.
I Retell-dokumentationen om fejlfinding af latens står der, at større, ræsonnementsorienterede modeller "er langsommere til første token" og "bytter latens for kapacitet". OpenAI nævner stemme som et almindeligt anvendelsestilfælde for at køre med reasoning effort sat til none og foreslår, at latensfølsomme applikationer "beder modellen generere en kort indledning, før den fortsætter med dybere ræsonnement". Guiden til den bedste LLM til AI-stemmeagenter dækker valget af model.
Hvad er sammenflettet ræsonnement i en stemmeagent?
I en stemmeagent betyder sammenflettet ræsonnement, at modellen skriver den første sætning af sit svar med det samme, ræsonnerer lydløst, mens sætningen bliver udtalt, og derefter fortsætter svaret med udgangspunkt i det ræsonnement. Den, der ringer, hører ét sammenhængende svar, og ræsonnementet bliver aldrig udtalt.
Tell-1 fungerer på denne måde. I det tekniske indlæg fra Retell, Retell LLM: Interleaved Reasoning for Real-Time Voice Agents, beskrives formatet som "en talt indledning, derefter ræsonnement, derefter resten af svaret". Indlægget rapporterer i gennemsnit 200 ræsonnementstokens midt i svaret, og at 99,98 % af turene holder pause i mindre end 400 ms efter den første sætning.
Sammenlignet med tænk-først-ræsonnement venter den, der ringer, ikke i stilhed på, at ræsonnementet bliver færdigt. Indlægget nævner også afvejningen: "at tale hurtigere betyder at forpligte sig til indledningen, før der er sket noget ræsonnement". Tell-1 ligger samlet nr. 1 på Retell vCX Benchmark (pr. november 2026).
Ofte stillede spørgsmål om sammenflettet ræsonnement
Er sammenflettet ræsonnement det samme som sammenflettet tænkning?
Ja, i de fleste sammenhænge. Anthropic og OpenAI siger interleaved thinking; forskningsartikler siger typisk interleaved reasoning.
Faktureres ræsonnementstokens?
Ja. OpenAI, Anthropic og Google medregner dem alle i det fakturerede output. OpenAI og Anthropic fakturerer dem, selv når ræsonnementsteksten ikke returneres.
Kan du læse en models ræsonnementstokens?
Som regel ikke. OpenAI og Anthropic kan returnere et resumé, hvis du beder om et. Ingen af dem returnerer det rå ræsonnement.
Får sammenflettet ræsonnement en model til at svare hurtigere?
Ikke i sig selv. Mellem værktøjskald tilføjer det tokens, og vLLM's dokumentation advarer om, at det øger svarlatensen. Det første synlige output kommer kun hurtigere, når synligt output kommer før ræsonnementet eller mellem kortere blokke af det.
Hvad er sammenflettet ræsonnement i stemme-AI?
Det er en model, der begynder at tale med det samme, ræsonnerer lydløst, mens dens første sætning afspilles, og derefter afslutter svaret ved hjælp af det ræsonnement. Tell-1, den egenudviklede LLM fra Retell, er bygget på denne måde.
Kør ræsonnementsmodeller i live-opkald
Retell AI er en platform til AI-stemmeagenter for kontaktcentre. Du vælger modellen bag hver agent. Tell-1 er en af dem. Tal med Retell-teamet.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


