LLM som dommer (LLM as a judge) er en evalueringsmetode, hvor én stor sprogmodel scorer eller rangerer outputtet fra et andet AI-system ud fra skriftlige kriterier i stedet for en menneskelig bedømmer. Teams bruger metoden til at bedømme åbne opgaver, fx en telefonsamtale, hvor der ikke findes ét korrekt svar.
Navnet stammer fra en artikel fra 2023, Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. Forfatterne rapporterede, at stærke dommere som GPT-4 matchede menneskelige præferencer med "over 80% enighed, samme niveau af enighed som mellem mennesker". De beskrev også metodens begrænsninger: positionsbias, ordrigdomsbias og selvforstærkningsbias.
Hvordan scorer en LLM-dommer en samtale?
En LLM-dommer læser samtalen og et sæt instruktioner og returnerer derefter en vurdering i én af tre former.
| Metode | Hvad dommeren gør | Resultat | Anvendelse |
|---|---|---|---|
| Rubrikbedømmelse | Læser én transskription ud fra skriftlige kriterier | Bestået eller ikke bestået, eller en score, med en begrundelse | QA i produktion og regressionstest |
| Parvis rangering | Sammenligner to eller flere svar på samme replik | En vinder eller en rangeret rækkefølge | Valg mellem prompts eller modeller |
| Dommerpanel | Flere dommermodeller bedømmer det samme element, og vurderingerne samles | Én samlet score | Scores, som én models bias kunne skævvride |
Rubrikbedømmelse. I G-Eval-artiklen ræsonnerede dommeren sig gennem kriterierne og udfyldte derefter en scoringsformular. Ved opsummering korrelerede dens scores bedre med menneskelige vurderinger end tidligere metoder.
Parvis rangering. At spørge, hvilket af to svar der er bedst, passer til egenskaber som tone, hvor en forskel er lettere at se end at score.
Dommerpaneler. I Replacing Judges with Juries "overgår" et panel af mindre modeller fra forskellige modelfamilier "en enkelt stor dommer og udviser mindre intra-model-bias" og var "over syv gange billigere".
Hvordan bruges LLM som dommer i QA og benchmarks for stemmeagenter?
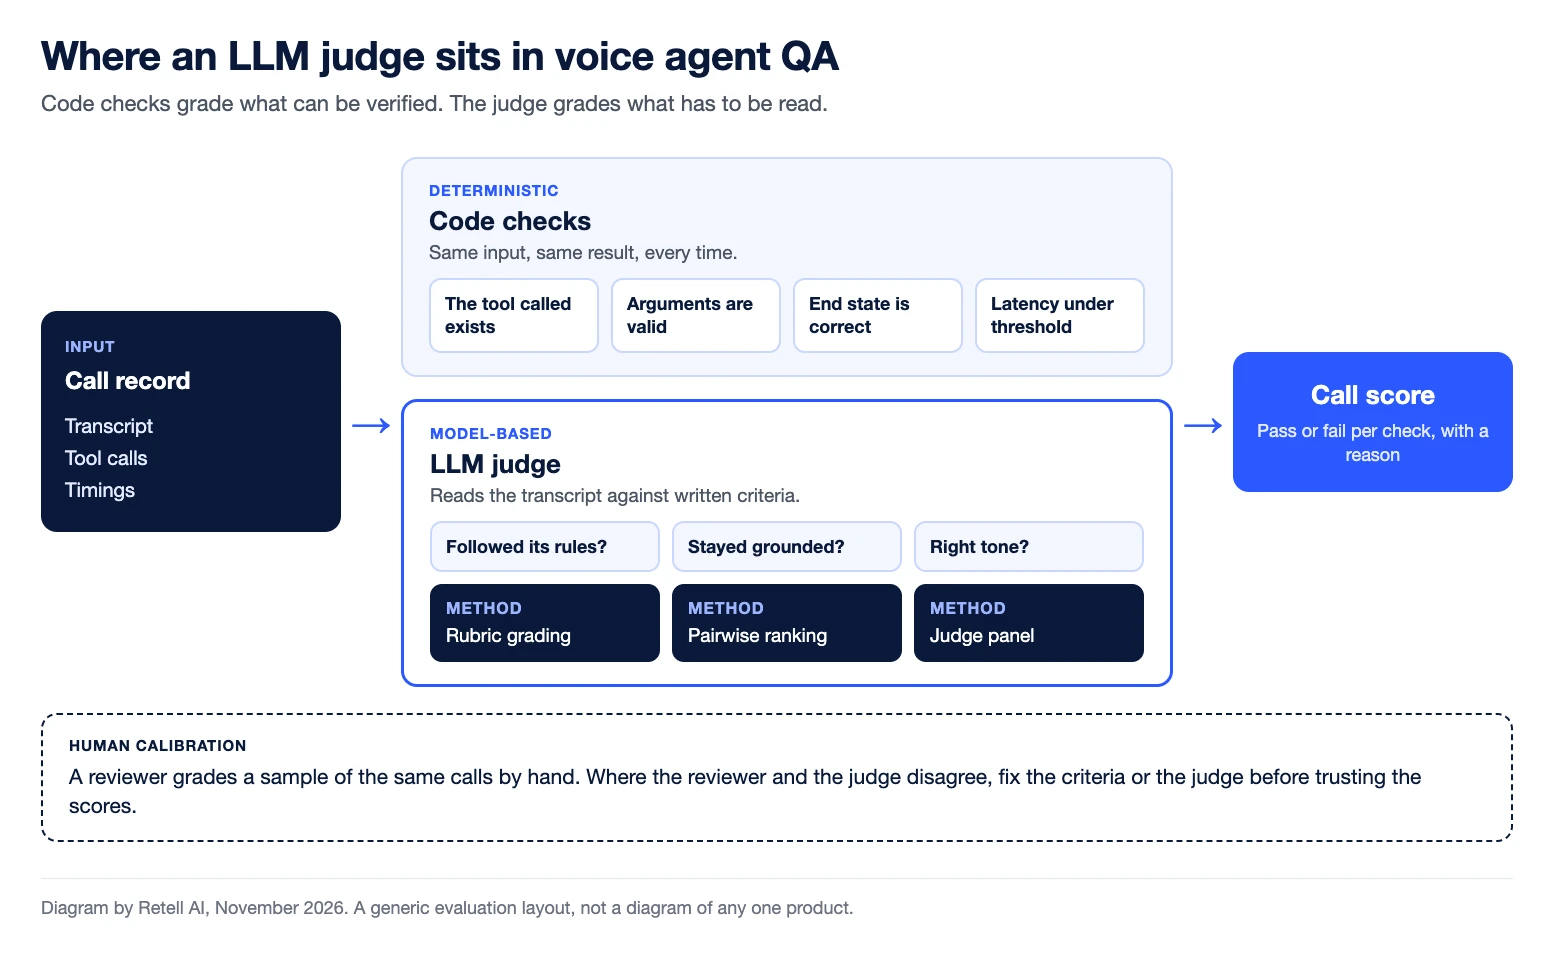
QA af stemmeagenter bruger en LLM-dommer til de dele af et opkald, som kun en læsning af transskriptionen kan afgøre: om agenten fulgte sine regler, holdt sig til sine kilder og løste henvendelsen.
Dokumentationen fra Retell viser begge de almindelige opsætninger. I AI QA er en AI-evalueret betingelse "et kvalitativt tjek, som AI'en kører mod hvert opkalds transskription og kontekst", skrevet som "den prompt, AI'en bruger til at vurdere, om betingelsen er opfyldt". I simulationstest spiller en AI den, der ringer, og "hver kørsel bedømmes som bestået eller ikke bestået med en skriftlig forklaring".
Benchmarks rapporterer samme type vurdering i stor skala. Retell vCX Benchmark offentliggør hver testsuites score som en beståelsesrate, "procentdelen af testede scenarier, den håndterede korrekt", på tværs af instruktionsfølgning, forankring, værktøjskald og dagligt talesprog (læst 13. november 2026).
Vil du gøre vurderingerne til en ugentlig gennemgang, så se QA-scorekortet for stemmeagenter.
Hvad er de kendte fejltyper for en LLM-dommer?
En LLM-dommer fejler på fire dokumenterede måder. Hver af dem har et kendt modtræk.
- Positionsbias. I Large Language Models are not Fair Evaluators kunne én model vinde "66 ud af 80 testede forespørgsler", blot ved at rækkefølgen af to svar blev byttet om. Kør hver sammenligning i begge rækkefølger.
- Selvpræference. En undersøgelse fra 2024 fandt, at en evaluator "giver sine egne outputs højere score end andres, mens menneskelige annotatorer vurderer dem som lige gode". Brug en dommer fra en anden modelfamilie eller et panel.
- Svag enighed med mennesker. Judging the Judges testede 13 dommermodeller og fandt, at "kun de bedste (og største) modeller opnår rimelig overensstemmelse med mennesker", med "en tendens til mildhed". Bedøm en stikprøve manuelt, og sammenlign.
- Drift. Modellen bag en API kan ændre sig: én undersøgelse målte, at GPT-4 faldt fra 84% til 51% nøjagtighed på den samme opgave på tre måneder. Kriterierne flytter sig også. Who Validates the Validators? kalder dette kriteriedrift: "brugere har brug for kriterier for at bedømme outputs, men bedømmelse af outputs hjælper brugerne med at definere kriterier". Lås dommerversionen, og kør et fast, manuelt mærket datasæt igen efter enhver ændring.
Dommere er heller ikke deterministiske. Retell-dokumentationen om simulering anbefaler: "Bedøm et scenarie ud fra dets beståelsesrate på tværs af kørsler, ikke ud fra én kørsel."
Hvornår slår kodetjek en LLM-dommer?
Kodetjek slår en LLM-dommer, når svaret kan verificeres i stedet for at skulle læses. Anthropics guide til agentevalueringer anbefaler at "vælge deterministiske bedømmere, hvor det er muligt, og LLM-bedømmere, hvor det er nødvendigt". Guiden beskriver kodebaserede bedømmere som hurtige, billige, objektive og reproducerbare, og modelbaserede bedømmere som ikke-deterministiske.
I et opkald kan kode tjekke, at det værktøj, agenten kaldte, findes, at dets argumenter er gyldige, og at svartiden holdt sig under en tærskel. tau-bench bedømmer hele samtaler på denne måde ved at sammenligne "databasens tilstand ved slutningen af en samtale med den annoterede måltilstand".
AI QA fra Retell holder de to adskilt: performancemålinger er kvantitative tærskler, og AI-evaluerede betingelser står for de kvalitative tjek. Sådan tester og udgiver du ændringer i stemmeagenter beskriver, hvor hver af dem kører.
Hvordan bruges dommerpaneler til at træne en stemmemodel?
Tell-1, den LLM som Retell selv har udviklet, brugte LLM-dommere i to af sine tre træningsfaser ifølge det tekniske indlæg om Retell LLM. Fasen med præferencetuning lærte af "præferencepar rangeret af et panel af LLM-dommere".
I fasen med reinforcement learning skriver "modellen otte svar, og hvert eneste bliver scoret", ifølge indlægget. Koden kører først: kald til værktøjer uden for agentens værktøjskasse, fejlformateret output og andre kritiske fejl "fanges i kode, før nogen dommer ser dem". For korrekthed gælder: "Flere dommermodeller bedømmer korrekthed i værktøjskald, hallucinationer og instruktionsfølgning, og deres vurderinger samles i ét belønningssignal". For naturlighed rangerer én dommer alle otte svar side om side ud fra en rubrik, fordi "naturlighed er lettere at sammenligne end at score".
Det er det mønster, denne side beskriver: kodetjek for det, der kan verificeres, et dommerpanel for korrekthed og rangering for tone.
Ofte stillede spørgsmål om LLM som dommer
Hvad gør en LLM-dommer?
Den læser et output, fx en opkaldstransskription, sammen med bedømmelsesinstruktioner og returnerer en vurdering: bestået eller ikke bestået, en score eller en præference mellem to muligheder.
Hvor pålidelig er LLM som dommer?
Det afhænger af dommermodellen og opgaven. Én undersøgelse fandt over 80% enighed med menneskelige præferencer; en anden fandt, at kun de største dommere stemte rimeligt overens med mennesker. Tjek først en dommer mod manuelt bedømte opkald.
Hvad er et dommerpanel?
Et dommerpanel er flere dommermodeller, der bedømmer det samme output, hvorefter deres vurderinger samles. Det mindsker effekten af én enkelt models bias.
Hvad er forskellen på rubrikbedømmelse og parvis rangering?
Rubrikbedømmelse scorer ét output ud fra skriftlige kriterier. Parvis rangering viser dommeren to outputs og spørger, hvilket der er bedst.
Kan en LLM-dommer score et taleopkald?
Ja, ud fra transskriptionen og værktøjskaldene. Egenskaber, der ligger i lyden, kræver også lyden: Ifølge dokumentationen fra Retell bliver Agent Naturalness "evalueret ud fra både lyden og transskriptionen".
Scor dine egne opkald, før du skalerer
Retell AI er en platform for AI-stemmeagenter til kontaktcentre. AI QA evaluerer en stikprøve af dine opkald ud fra de betingelser og tærskler, du fastsætter, med dokumentation fra transskriptionen for hvert resultat.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


