Session affinity, også kaldet sticky sessions eller session persistence, er en load balancing-teknik, der sender alle forespørgsler fra samme klient eller session til samme backend-server, så den tilstand, der ligger i serverens hukommelse, forbliver tilgængelig.
Uden den bliver hver forespørgsel placeret for sig. AWS skriver, at en Application Load Balancer som standard "dirigerer hver forespørgsel uafhængigt til et registreret mål", og at funktionen sticky sessions gør det muligt at "binde en brugers session til et bestemt mål". Det har betydning, når en server gemmer noget lokalt, som den næste forespørgsel skal bruge: en login-session, en indkøbskurv eller en cache.
Hvordan implementerer load balancere session affinity?
En load balancer skal kunne genkende sessionen og have en regel, der knytter den til en server. Tre metoder dækker de fleste produkter.
Cookie. Load balanceren sætter en cookie i det første svar og læser den ved senere forespørgsler. AWS' varighedsbaserede stickiness bruger en cookie ved navn AWSALB med en levetid, du selv sætter mellem 1 sekund og 7 dage. HAProxy bruger en cookie til at "huske, hvilken server klienten blev dirigeret til tidligere". Klienten skal understøtte cookies.
IP-hash. Klientens IP-adresse vælger serveren. NGINX' ip_hash bruger "de første tre oktetter af klientens IPv4-adresse eller hele IPv6-adressen" som hashnøgle. En Kubernetes Service tilbyder samme idé som sessionAffinity: ClientIP med en standard-timeout på 3 timer. Ingen af dem kræver en cookie, men klienter bag én delt adresse lander på samme server, og med NGINX gør alle, der deler de tre oktetter, det også.
Konsistent hashing. Load balanceren hasher en egenskab ved forespørgslen, fx en header eller et sessions-ID, ind på en ring af servere. Envoy skriver, at med en velopdelt ring vil tilføjelse eller fjernelse af én host fra et sæt på N "kun påvirke 1/N forespørgsler". NGINX' hash-direktiv har en consistent-indstilling, der ifølge dokumentationen "hjælper med at opnå en højere cache-hitrate for cacheservere".
| Metode | Hvad identificerer sessionen | Dokumenteret eksempel | Største begrænsning |
|---|---|---|---|
| Cookie | En cookie sat af load balanceren eller applikationen | AWS Application Load Balancer, HAProxy | Klienten skal understøtte cookies |
| IP-hash | Klientens IP-adresse | NGINX ip_hash, Kubernetes ClientIP | Klienter bag en delt adresse hober sig op på én server |
| Konsistent hashing | En hvilken som helst egenskab ved forespørgslen, du vælger | Envoy ring hash og Maglev, NGINX hash ... consistent | Hver forespørgsel skal have en stabil nøgle |
| Præfiksbevidst routing | De første tokens i en LLM-prompt | OpenAI prompt caching, Ray Serve | Belastningen tæller stadig, så en travl server kan miste forespørgslen |
Hvilke afvejninger er der ved sticky sessions?
Session affinity ofrer noget balance og robusthed til gengæld for at holde tilstanden tæt på.
- Belastningen kan blive skæv. Google Cloud skriver, at affinity "fungerer godt, når der er en rimeligt stor fordeling af unikke forbindelser". Med få eller ujævne sessioner bærer nogle servere mere, hvilket modarbejder skalerbarhed.
- En fejlet server afslutter affinity. På AWS "vælger load balanceren et nyt sundt mål", hvis et mål fejler, og holder sessionen der "selv hvis det fejlede mål kommer tilbage". Alt, der kun lå i den gamle servers hukommelse, skal genopbygges.
- Det er best effort. Google Cloud leverer session affinity "på best effort-basis" og nævner ændringer i health checks, tilføjede eller fjernede backends og fyldte backends som hændelser, der kan bryde den.
HAProxys dokumentation giver standardrådet: "Ofte er det optimalt helt at undgå session persistence ved at bygge dine tjenester stateless", fx ved at gemme tilstanden i en delt database. Affinity er til den tilstand, du ikke billigt kan flytte. En cache er det typiske eksempel.
Hvorfor er session affinity vigtig for LLM-serving?
Det er vigtigt, fordi den cache, der gør en gentaget prompt billig, ligger på én maskine. En modelserver gemmer den beregnede tilstand af en prompt, KV-cachen, i hukommelsen. vLLM genbruger den, når en ny forespørgsel "deler samme præfiks med en af de eksisterende forespørgsler, så den nye forespørgsel kan springe beregningen af den delte del over".
Det virker kun, hvis den næste forespørgsel når frem til samme maskine. OpenAI's guide til prompt caching siger det direkte: "Cachede tilstande ligger på individuelle maskiner", og "en forespørgsel kan kun genbruge et cachet præfiks, hvis den når en maskine med en matchende post, der ikke er udløbet". OpenAI dirigerer efter maskinbelastning, en hash af promptens første tokens og, på ældre modeller, en cachenøgle, du selv angiver. Til selvhostede modeller leverer Ray Serve en router, der "dirigerer forespørgsler med lignende præfikser til de samme replikaer og maksimerer KV-cache-hitraten", og som falder tilbage til almindelig load balancing, når køerne er ujævne.
Opkald passer godt til dette mønster. Ved hver tur i en samtale med flere ture sender en stemmeagent sine instruktioner plus transskriptionen indtil nu til den store sprogmodel, fordi modellen ikke husker opkaldet mellem forespørgsler. Hver forespørgsel gentager det meste af den foregående. Opkaldet er altså sessionen, og opkalds-ID'et er en naturlig nøgle. En tur, der lander på en anden server, behandler hele prompten igen, hvilket øger latensen.
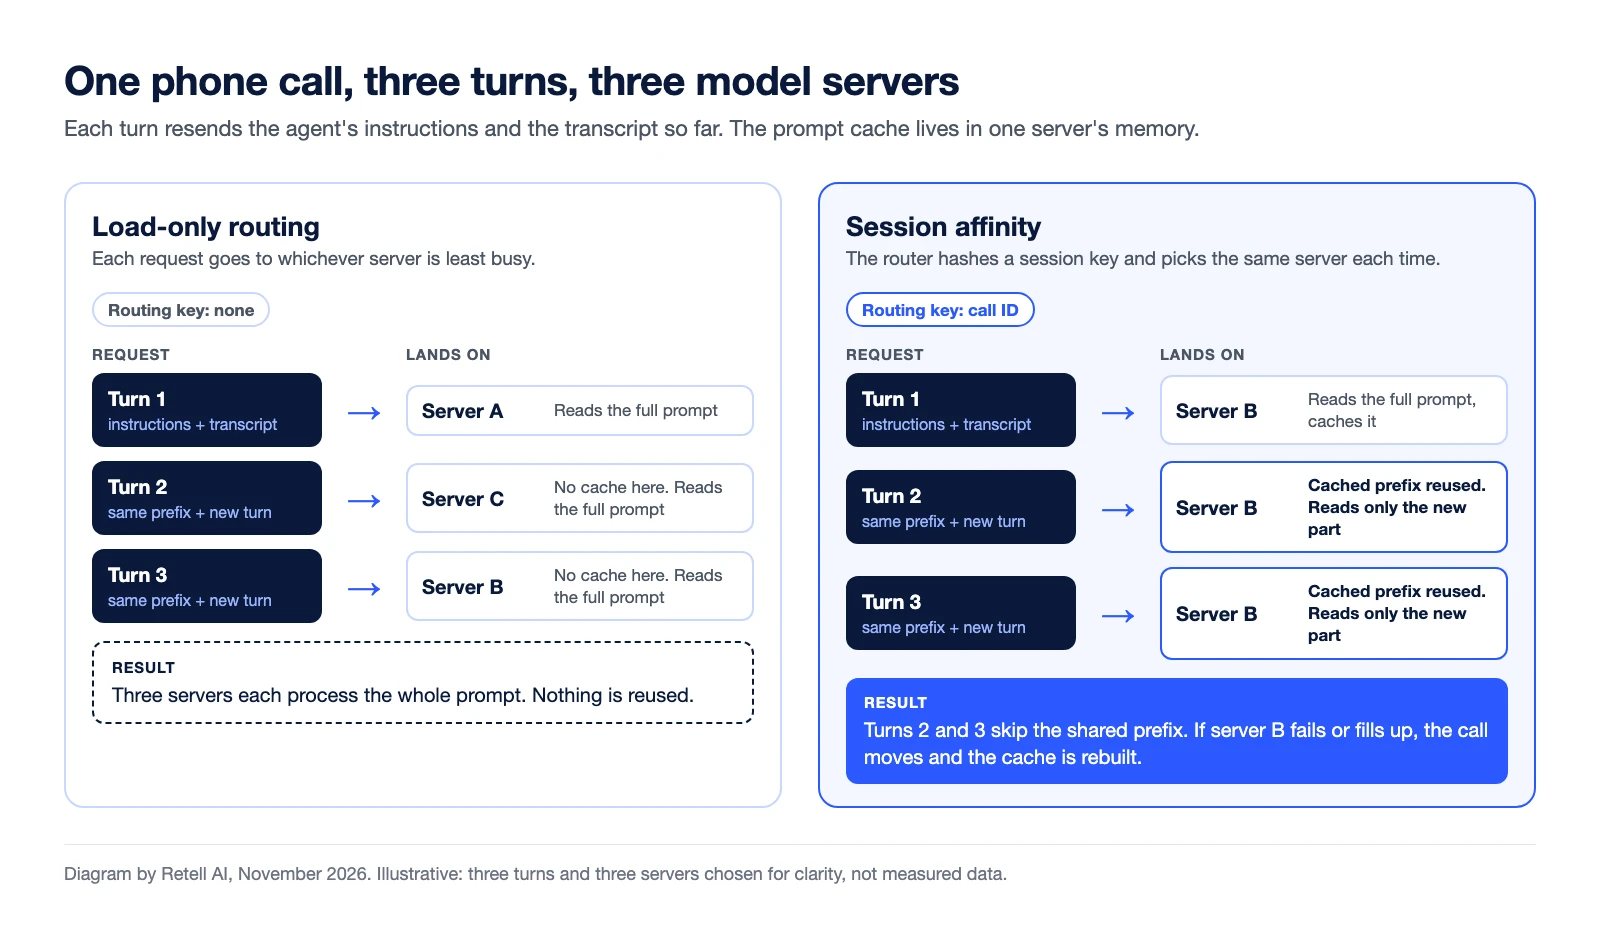
Tell-1, LLM'en fra Retell, serveres på denne måde. Det tekniske indlæg om Retell LLM kalder det opkaldsbevidst routing: hver tur gensender hele samtalen, så hvert opkald holdes på de GPU'er, der allerede har det i cachen. Ifølge indlægget øgede det andelen af prompt-tokens leveret fra cachen fra 36 % til 69 %.
Hvor session affinity optræder hos Retell
Den optræder, når du kører din egen modelserver. Med en tilpasset LLM "åbner Retell en WebSocket til din server for hvert opkald" med opkalds-ID'et som sidste segment i URL'ens sti. AWS bemærker, at "WebSocket-forbindelser i sagens natur er sticky", så et opkald bliver på én af dine servere, mens dets socket er åben.
Retells bedste praksis anbefaler at holde "eksplicit tilstand pr. opkald på din server, nøglet på opkalds-ID'et fra WebSocket-URL'en". Retell genopbygger også en forbindelse, der falder ud midt i et opkald, og hvis du kører flere servere bag en load balancer, kan den nye socket nå en anden server. For at holde tilstanden tilgængelig skal du dirigere efter opkalds-ID'et i stien eller gemme tilstanden i et delt lager. IP-hash fordeler ikke belastningen her: opsætningsguiden angiver én udgående IP-adresse for denne forbindelse, så alle opkald hashes til samme server.
Ofte stillede spørgsmål om session affinity
Er session affinity det samme som sticky sessions?
Ja. AWS beskriver sin sticky sessions-funktion som "også kendt som session affinity". Session persistence er et tredje navn for det samme.
Hvad sker der med en sticky session, når serveren fejler?
Load balanceren vælger en anden sund server, og sessionen bliver der. Tilstand, der kun lå i den fejlede servers hukommelse, går tabt, medmindre den også var gemt et delt sted.
Har WebSocket-forbindelser brug for sticky sessions?
Ikke mens forbindelsen er åben, fordi alle beskeder går over den samme forbindelse til den samme server. Affinity bliver vigtig igen, når klienten genopretter forbindelsen.
Hvorfor er session affinity vigtig for prompt caching?
En prompt-cache ligger i hukommelsen på den maskine, der byggede den. En opfølgende forespørgsel får kun det cachede præfiks, hvis den dirigeres til den maskine.
Brug din egen model i live-opkald
Retell AI er en platform til AI-stemmeagenter for kontaktcentre. Retell håndterer telefoni, transskription, turtagning og tale, og integrationen med tilpasset LLM forbinder din modelserver via én WebSocket pr. opkald.
Security & compliance for regulated deployments
How Retell handles audits, data retention and access control.
Further Reading
Related terms
Table of contents


